Zwei Ausfälle innerhalb von 48 Stunden legten diese Woche die Arbeit und den Verkehr in den gesamten Vereinigten Staaten lahm. Keiner der beiden war ein Angriff. Beide waren selbstverschuldet.
Am Donnerstag führte eine Netzwerkänderung dazu, dass Microsoft 365 in mehr als 70 Ländern ausfiel; es dauerte etwa anderthalb Tage, bis der volle Betrieb wiederhergestellt war. Eine erste Schätzung beziffert den Produktivitätsverlust auf fast 7 Milliarden Dollar. Am Freitag überlastete neue Ausrüstung die veralteten Telekommunikationssysteme der FAA, und jeder abfliegende Flug im Land musste mehr als vier Stunden am Boden bleiben. Mehr als 9.000 Flüge wurden am Freitag gestrichen, weitere 4.100 am Samstag.
Wenn schon routinemäßige Änderungen in derselben Woche das weltweite E-Mail-System und den amerikanischen Luftraum lahmlegen können, stellen Sie sich einmal vor, was jemand mit böswilligen Absichten anrichten könnte. Ausfallsicherheit ist kein Notfallplan mehr. Sie ist eine Vorgabe auf Vorstandsebene.
Große Ausfälle werden immer größer und treten immer häufiger auf
Ausfälle kommen ständig vor. ThousandEyes verzeichnete Anfang 2026 weltweit zwischen 200 und 400 Netzwerkausfälle pro Woche, und fast niemand hat davon etwas mitbekommen. Nach einigen Maßstäben nehmen die üblichen Ausfälle sogar ab: Laut dem Uptime Institute sinken die Ausfallraten pro Standort seit fünf Jahren in Folge.
Das Problem liegt im oberen Bereich, wo sich zwei Dinge gleichzeitig entwickeln.
Die großen Ausfälle treten häufiger auf. Kritische Ausfälle bei den drei größten Cloud-Anbietern stiegen zwischen 2022 und 2024 um 52 %, und die verlorenen Stunden stiegen um 51 % auf 221 pro Jahr. Das Jahr 2025 verlief ruhiger. Im Jahr 2026 war dies jedoch nicht der Fall: Es gab drei größere Ausfälle bei Microsoft 365 und einen landesweiten Betriebsstillstand, wobei noch sechs Wochen verbleiben.
Und sie sind schwerwiegender. Früher kostete ein schlechter Tag Millionen. Das fehlerhafte Update von CrowdStrike im Juli 2024 kostete die Fortune-500-Unternehmen schätzungsweise 5,4 Milliarden US-Dollar. Der Microsoft-Ausfall dieser Woche könnte allein durch Produktivitätsverluste 7 Milliarden US-Dollar kosten.
Hier sind fünf Beispiele aus den letzten 13 Monaten. Bei keinem davon konnte ein Angriff als Ursache festgestellt werden.
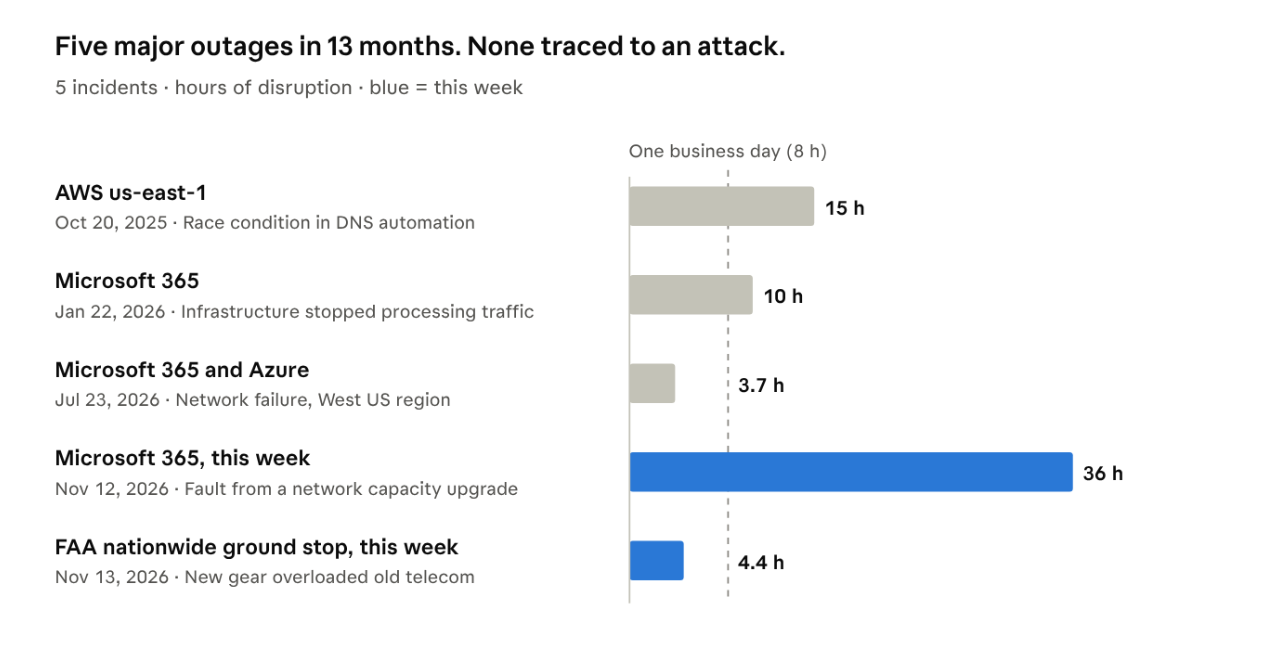
Der Microsoft-Ausfall in dieser Woche war der längste der fünf. Der Ausfall bei der FAA war der längste landesweite Flugstopp seit 25 Jahren und erst der zweite seit dem 11. September.
Hier sind die Kosten, sofern sie beziffert wurden. Für die Microsoft-Ausfälle im Januar und Juli hat niemand eine Schätzung veröffentlicht.
| Ausfall | Geschätzter wirtschaftlicher Schaden | Versicherter Schaden | Geschätzt von |
|---|---|---|---|
| Microsoft 365, November 2026 | ~7 Mrd. US-Dollar an Produktivitätsverlusten (vorläufig) | 300–500 Mio. $ | Anderson Economic Group;Morningstar DBRS |
| Flugverbot der FAA, November 2026 | Noch nicht beziffert; allein die Rückerstattungen könnten die Fluggesellschaften Milliarden kosten | Noch nicht bewertet | Morningstar DBRS |
| AWS us-east-1, Okt. 2025 | 500–650 Mio. $ für US-Unternehmen | 38–581 Mio. $ | Parametrix;CyberCube |
| CrowdStrike-Update, Juli 2024 | 5,4 Mrd. $ für die Fortune-500-Unternehmen | 0,54–1,08 Mrd. US-Dollar | Parametrix |
Versicherungen decken nur einen Bruchteil davon ab. Nach dem CrowdStrike-Vorfall deckten die Policen schätzungsweise 10–20 % der Verluste der Fortune-500-Unternehmen ab. Der Rest ging zu Lasten der Unternehmen, die keinen Einfluss auf den Ausfall hatten. Für die Global-2000-Unternehmen bezifferten Splunk und Oxford Economics in einer Studie aus dem Jahr 2024 die jährlichen Kosten durch Ausfallzeiten auf 400 Mrd. $, was etwa 9 % der Gewinne entspricht.
Warum das immer wieder passiert
Drei Faktoren verstärken sich gegenseitig, und keiner von ihnen wird verschwinden.
- Konzentration.AWS, Microsoft und Google halten einen Anteil von 61 % an einem Cloud-Markt, der mittlerweile ein Quartalsvolumen von 168 Milliarden US-Dollar aufweist. Drittanbieter sind für etwa zwei Drittel der öffentlich gemeldeten Ausfälle der letzten neun Jahre verantwortlich. Wenn einer von ihnen einen schlechten Tag hat, haben Tausende von Unternehmen zur selben Stunde denselben schlechten Tag.
- Das Tempo des Wandels.Beide Ausfälle dieser Woche gingen auf eine Änderung zurück, die jemand absichtlich vorgenommen hatte: ein Netzwerk-Upgrade bei Microsoft, neue Geräte bei der FAA. Das Uptime Institute stellt fest, dass Fehler beim Konfigurations- und Änderungsmanagement die Hauptursache für Netzwerkausfälle sind. Wir verändern komplexe Systeme schneller, als wir begreifen können, welche Auswirkungen diese Änderungen haben werden.
- KI.Die Cloud-Ausgaben stiegen im letzten Quartal um 55 %, wobei KI mittlerweile etwa ein Drittel davon ausmacht. Dies bedeutet eine höhere Belastung für dieselbe gemeinsam genutzte Infrastruktur. Zudem handelt es sich um eine neue Art von Arbeitslast: Agenten, die eigenmächtig auf Produktionssystemen agieren. Zusammen ergeben sie das, was wir als KI-Schwachstelle bezeichnen. Gartner geht davon aus, dass eine falsch konfigurierte KI in cyber-physischen Systemen bis 2028 die kritische nationale Infrastruktur eines G20-Landes lahmlegen wird.
Die Ausfälle dieser Woche waren Unfälle. Menschen, die beruflich kritische Infrastrukturen angreifen, haben gerade gesehen, wie weit sich ein einziger Ausfall ausbreiten kann. Die Abwehrstrategie ist in beiden Fällen dieselbe: Eine Architektur, die sich von einem fehlerhaften Update erholen kann, kann sich auch von einem Angriff erholen.
Ihre Daten dürfen nicht nur an einem Ort gespeichert sein
Stellen Sie Ihrem Team am Montag eine Frage: Wenn unsere primäre Cloud morgen ausfallen würde, von wo würden wir die Daten wiederherstellen und wohin würden wir sie wiederherstellen? Für viele Unternehmen lautet die ehrliche Antwort „in derselben Cloud“. Ihre Daten, Ihre Backups und Ihr Recovery-Pfad befinden sich alle bei einem einzigen Anbieter. Wenn dieser Anbieter ausfällt, bleibt nichts anderes übrig, als abzuwarten.
Wir haben die Commvault Cloud so konzipiert, dass es immer einen anderen Ort gibt, von dem aus eine Wiederherstellung erfolgen kann, und einen anderen Ort, an dem die Daten wiederhergestellt werden können: über verschiedene Clouds hinweg, von der lokalen Infrastruktur in die Cloud und von der Cloud zurück in die lokale Infrastruktur.
| Wenn diese ausfällt | Single-Cloud-Ansatz | Mit Commvault |
|---|---|---|
| Eine Cloud (Azure oder AWS) | Warten, bis der Anbieter wieder verfügbar ist | Stellen Sie die Daten aus der Kopie in der anderen Cloud oder aus der lokalen Umgebung wieder her und verlagern Sie die Workloads dorthin |
| Das Rechenzentrum des Kunden | Die Wiederherstellung hängt davon ab, was vor Ort noch vorhanden ist | Wiederherstellung aus der Kopie in der Cloud und Betrieb dort, bis der Standort wieder verfügbar ist |
| Beide Clouds | Keine Wiederherstellungsmöglichkeit, bis wieder einer verfügbar ist | Kunden, die eine Kopie außerhalb der öffentlichen Cloud aufbewahren, können von dieser wiederherstellen und Recovery in ihrem eigenen Rechenzentrum durchführen |
Ich möchte offen über den Kompromiss sprechen. Jede zusätzliche Kopie kostet Geld, und jede zusätzliche Umgebung erhöht die Komplexität. Ichhabe bei BCG darüber geschrieben: Die meisten Unternehmen, die sich als Multi-Cloud-Unternehmen bezeichneten, führten in Wirklichkeit lediglich unterschiedliche Workloads in verschiedenen Clouds aus, und echte Portabilität war selten und teuer. Das war im Jahr 2021 die richtige Vorsicht. Seitdem hat sich die Argumentation verschoben.
Die Cloud-native Architektur hat die Spielregeln verändert. Workloads, die auf Containern und Kubernetes basieren, bei denen die Infrastruktur per Code definiert und die Daten von der zugrunde liegenden Plattform entkoppelt sind, lassen sich in einer zweiten Cloud oder in einem Rechenzentrum bereitstellen, ohne dass sie neu aufgebaut werden müssen. Nicht jede Workload ist diesen Aufwand wert. Aber für die wenigen Dienste, auf die ein Unternehmen nicht verzichten kann, ist Multi-Cloud-Resilienz heute leichter zu erreichen als je zuvor, und nach dieser Woche lassen sich die Kosten, die entstehen, wenn man sie nicht hat, viel einfacher beziffern.
Für uns ist dies kein Punkt auf der Roadmap. Commvault-Kunden konvertieren heute im Rahmen einer Wiederherstellung virtuelle Maschinen zwischen Hypervisoren und Clouds und richten durch Automatisierung eine saubere, isolierte Recovery-Umgebung ein – vor Ort oder in der Cloud. Zahlreiche Kunden führen diese Automatisierung routinemäßig durch, nicht nur in Krisenfällen.
Zwei weitere Aspekte sind ebenso wichtig wie die Möglichkeit, auf eine alternative Umgebung ausweichen zu können.
- Transparenz.Was man nicht sieht, kann man nicht wiederherstellen. Zu viele Unternehmen erfahren erst mitten in einem Ausfall, wo sich ihre kritischen Daten befinden und was nie geschützt war. Commvault bietet Kunden einen kontinuierlichen Überblick darüber, wo sich ihre Daten befinden, was geschützt ist und was ungeschützt ist – noch bevor es zu einem Ausfall kommt.
- KI-Agenten.Agenten verfügen mittlerweile über Geschäftslogik, was sie zu Produktionsanwendungen macht. Sie benötigen dieselben Garantien wie jede andere kritische Arbeitslast, und die meisten Unternehmen sind noch nicht so weit. Mit AgentRecover, das derzeit im Early Access für Microsoft Foundry verfügbar ist und im Dezember für Amazon Bedrock AgentCore erscheint, können wir überprüfen, was ein Agent getan hat, und sowohl den Agenten als auch die von ihm geänderten Anwendungen wiederherstellen.
Drei Maßnahmen, die CISOs und Vorstände diese Woche ergreifen sollten
- Finden Sie heraus, was gemeinsam ausfällt.Nehmen Sie Ihre zehn kritischsten Geschäftsdienste und verfolgen Sie jeden einzelnen bis hin zur Cloud-Region und zum Identitätsanbieter zurück, von denen er abhängt. Sie suchen nach gemeinsamen Abhängigkeiten, und der erste Ort, an dem Sie suchen sollten, sind Ihre eigenen Backups: Befinden sie sich in derselben Cloud wie die Systeme, die sie schützen, und können Sie sie an einem anderen Ort wiederherstellen? Der Vorstand sollte eine klare Antwort auf folgende Frage erhalten können: Welcher Ausfall eines einzelnen Anbieters legt uns lahm, und für wie lange?
- Messen Sie Ihre Recovery-Zeit in einem Praxistest.Legen Sie fest, welche Dienste am ersten Tag laufen müssen und welche Kosten pro Stunde entstehen, wenn diese ausfallen. Schalten Sie dann im Rahmen einer unangekündigten Übung – mindestens einmal pro Quartal – einen Anbieter ab und messen Sie, wie lange es dauert, bis wieder ein einwandfreier Zustand erreicht ist. Eine theoretische Simulation zählt nicht. Die Zahl, die Sie dem Vorstand vorlegen sollten, ist die gemessene durchschnittliche Zeit bis zur vollständigen Recovery.
- Unterwerfen Sie KI-Agenten denselben Regeln wie Produktionssysteme.Sie müssen jeden Agenten kennen, den Sie einsetzen, wissen, auf welche Daten er zugreifen kann und was er ändern darf. Verlangen Sie einen Prüfpfad und die Möglichkeit, sowohl den Agenten als auch alles, womit er in Berührung gekommen ist, zurückzusetzen. Wenn Ihnen niemand sagen kann, was ein Agent am vergangenen Dienstag getan hat und wie man dies rückgängig machen kann, ist er nicht bereit für weitere Befugnisse.
Vor dem nächsten Vorfall
Diese Woche fand eine Generalprobe statt. Niemand hat versucht, uns zu schaden, und dennoch hat es Milliarden gekostet. Das nächste Mal könnte es jemand versuchen, oder ein KI-Agent könnte die Änderung vornehmen. Bereiten Sie sich schon jetzt darauf vor. Das bedeutet kontinuierliche Recovery: bereits vor dem nächsten Vorfall eingerichtet, nicht erst währenddessen zusammengestellt.
Quellen
- Microsoft-Ausfall 2026 – Wikipedia
- Was den Microsoft 365-Ausfall vom 12. November 2026 verursachte – Control Plane
- Behörden machen veraltete Telekommunikationsausrüstung der FAA verantwortlich – GeekWire
- FAA hebt landesweites Flugverbot auf – CBS News
- In DFW gestrandete Reisende geraten in Aufruhr – CBS Texas
- FAA-Flugverbot und Microsoft-Ausfall: Spielte KI eine Rolle? – KingyAI
- Landesweite Störungen offenbaren Risiken der Technologieabhängigkeit – The National Desk
- Jährliche Ausfallanalyse 2026 – Uptime Institute
- Cloud-Markt im 3. Quartal 2026 – Synergy Research via TechInsights
- Rückblick auf den AWS-Ausfall in der Region us-east-1 — BleepingComputer
- Microsoft 365-Ausfall dauert fast 10 Stunden — The Register
- Ausfall der Microsoft 365-Dienste am 23. Juli 2026 – Cybersecurity-Nachrichten
- Der Ausfall von CrowdStrike kostete die Fortune-500-Unternehmen 5,4 Mrd. US-Dollar — Axios / Parametrix
- Die versteckten Kosten von Ausfallzeiten — Splunk und Oxford Economics
- Gartner: Eine falsch konfigurierte KI wird bis 2028 die kritische Infrastruktur eines G20-Landes lahmlegen
- Microsoft-Ausfall könnte Produktivitätsverluste in Höhe von 7 Milliarden US-Dollar verursachen — CNN
- Microsoft-Dienste nach 38-stündigem Ausfall wieder verfügbar; versicherte Schäden belaufen sich auf 300–500 Millionen US-Dollar — NewsDrum / Reuters
- Microsoft 365 nach weltweitem Ausfall wiederhergestellt — Bright Defense
- Live-Updates zum FAA-Flugverbot; Morningstar und DBRS zu Rückerstattungen — The Globe and Mail
- Das FAA-Flugverbot dauerte 4 Stunden und 21 Minuten – Deutlich kommuniziert
- AWS-Ausfall in der Region us-east-1: Verluste in den USA in Höhe von 500–650 Mio. US-Dollar — Parametrix
- Geschätzte versicherte Schäden durch AWS-Ausfall: 38–581 Mio. US-Dollar — Risk & Insurance / CyberCube
- Kritische Cloud-Ausfälle seit 2022 um 52 % gestiegen — CXOToday / Parametrix
- Rückgang kritischer Cloud-Ausfälle im Jahr 2025 — Parametrix
- Wöchentliche Ausfallzahlen von ThousandEyes für das 1. Quartal 2026 — DEV