Duas falhas em 48 horas interromperam o trabalho e as viagens nos Estados Unidos nesta semana. Nenhuma delas foi um ataque. Ambas foram causadas pela própria empresa.
Na quinta-feira, uma falha na rede deixou o Microsoft 365 fora do ar em mais de 70 países, e levou cerca de um dia e meio para que o serviço fosse totalmente restabelecido. Uma estimativa inicial aponta que a perda de produtividade foi de cerca de US$ 7 bilhões. Na sexta-feira, novos equipamentos sobrecarregaram os sistemas de telecomunicações obsoletos da FAA, e todos os voos com partida do país ficaram retidos no solo por mais de quatro horas. Mais de 9.000 voos foram cancelados na sexta-feira e outros 4.100 no sábado.
Se mudanças na rotina podem paralisar o sistema mundial de e-mail e o espaço aéreo dos Estados Unidos na mesma semana, imagine o que alguém com intenções maliciosas poderia fazer. A resiliência não é mais um plano de contingência. É uma exigência da diretoria.
As grandes interrupções estão se tornando mais graves e mais frequentes
Interrupções acontecem o tempo todo. A ThousandEyes registrou entre 200 e 400 interrupções de rede por semana em todo o mundo no início de 2026, e quase ninguém percebeu. De acordo com alguns indicadores, as interrupções comuns estão até melhorando: o Uptime Institute aponta que as taxas de interrupção por local vêm caindo há cinco anos consecutivos.O problema está na parte superior, onde duas coisas estão acontecendo ao mesmo tempo.
As grandes interrupções estão se tornando mais frequentes. As interrupções críticas nos três maiores provedores de nuvem aumentaram 52% entre 2022 e 2024, e as horas perdidas aumentaram 51%, chegando a 221 por ano. O ano de 2025 foi mais tranquilo. 2026 não tem sido assim: três grandes interrupções do Microsoft 365 e uma paralisação nacional, faltando ainda seis semanas para o fim do ano.
E os prejuízos estão ficando cada vez maiores. Um dia ruim costumava custar milhões. A atualização defeituosa da CrowdStrike, em julho de 2024, custou às empresas da Fortune 500 cerca de US$ 5,4 bilhões. A interrupção da Microsoft nesta semana pode custar US$ 7 bilhões apenas em perda de produtividade.
Aqui estão cinco casos ocorridos nos últimos 13 meses. Nenhum deles foi atribuído a um ataque.
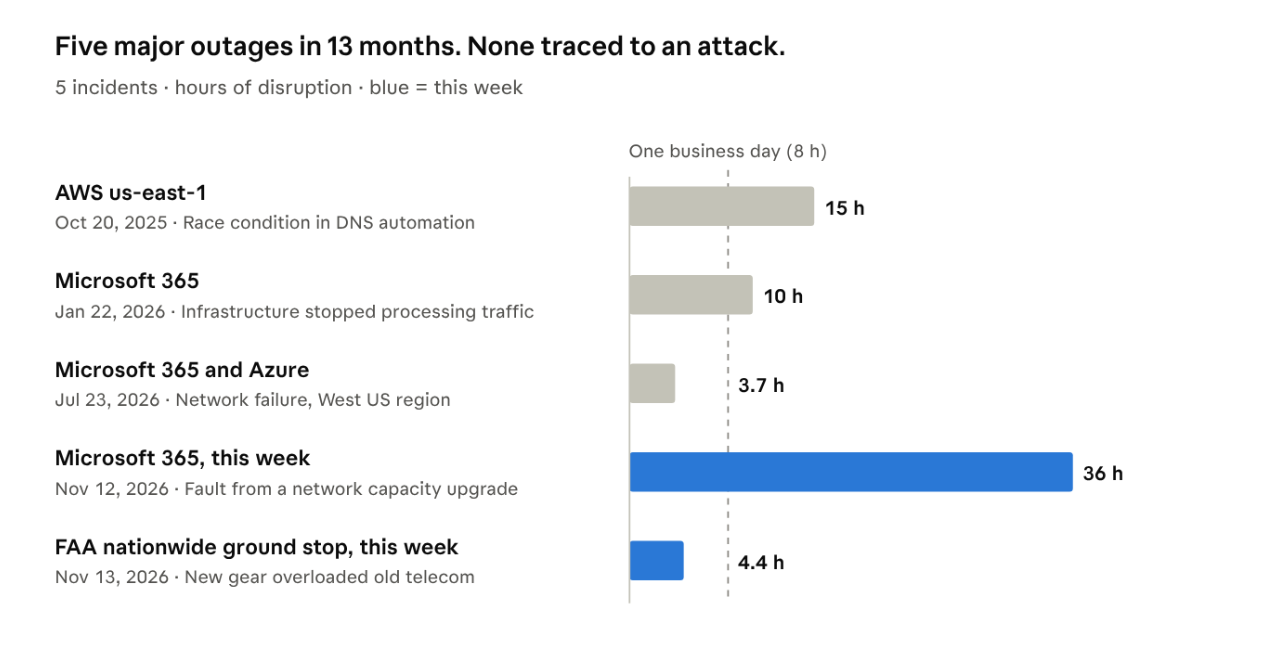
A interrupção da Microsoft nesta semana foi a mais longa das cinco. A da FAA foi a mais longa paralisação de voos em todo o país nos últimos 25 anos e apenas a segunda desde o 11 de setembro.
Aqui está quanto custaram, nos casos em que foi possível quantificar. Ninguém publicou uma estimativa para as interrupções da Microsoft em janeiro e julho.
| Interrupção | Prejuízo econômico estimado | Prejuízo coberto pelo seguro | Estimada por |
|---|---|---|---|
| Microsoft 365, novembro de 2026 | ~US$ 7 bilhões em perda de produtividade (estimativa preliminar) | US$ 300 a 500 milhões | Anderson Economic Group;Morningstar DBRS |
| Suspensão de voos pela FAA, novembro de 2026 | Ainda não foi estimado; somente os reembolsos poderiam custar bilhões às companhias aéreas | Ainda não estimado | Morningstar DBRS |
| AWS us-east-1, outubro de 2025 | US$ 500 a 650 milhões para empresas americanas | US$ 38–581 milhões | Parametrix;CyberCube |
| Atualização da CrowdStrike, julho de 2024 | US$ 5,4 bilhões para as empresas da Fortune 500 | US$ 0,54–1,08 bilhão | Parametrix |
O seguro cobre apenas uma fração disso. Após o caso da CrowdStrike, as apólices cobriam cerca de 10% a 20% das perdas das empresas da Fortune 500. O restante recaiu sobre empresas que não tiveram qualquer influência na falha. Entre as empresas da Global 2000, a Splunk e a Oxford Economics estimaram, em um estudo de 2024, que o custo anual do tempo de inatividade era de US$ 400 bilhões, cerca de 9% dos lucros.
Por que isso continua acontecendo?
Três fatores estão se somando, e nenhum deles vai desaparecer.
- Concentração.A AWS, a Microsoft e o Google Cloud detêm 61% de um mercado de nuvem que hoje movimenta US$ 168 bilhões por trimestre. Provedores terceirizados são responsáveis por cerca de dois terços das interrupções divulgadas publicamente nos últimos nove anos. Quando um deles tem um dia ruim, milhares de empresas passam pelo mesmo dia ruim ao mesmo tempo.
- O ritmo das mudanças.Ambas as falhas desta semana tiveram origem em uma alteração feita propositalmente por alguém: uma atualização de rede na Microsoft e novos equipamentos na FAA. O Uptime Institute constata que falhas na configuração e no gerenciamento de mudanças são a principal causa de interrupções na rede. Estamos alterando sistemas complexos mais rapidamente do que conseguimos compreender quais serão os efeitos dessas mudanças.
- IA.Os gastos com nuvem cresceram 55% no último trimestre, e a IA agora representa cerca de um terço desse total. Isso significa mais carga sobre a mesma infraestrutura compartilhada. Trata-se também de um novo tipo de carga de trabalho: agentes que atuam de forma autônoma em sistemas de produção. Juntos, eles resultam no que chamamos de vulnerabilidade de IA. A Gartner prevê que uma IA mal configurada em sistemas ciberfísicos possa paralisar a infraestrutura crítica nacional de um país do G20 até 2028.
As falhas desta semana foram acidentes. Pessoas que atacam infraestruturas críticas profissionalmente acabaram de constatar até onde uma única falha pode se propagar. A defesa é a mesma em ambos os casos: uma arquitetura capaz de se recuperar de uma atualização incorreta também é capaz de se recuperar de um ataque.
Seus dados não podem ficar em apenas um lugar
Faça uma pergunta à sua equipe na segunda-feira: se nossa nuvem principal parasse de funcionar amanhã, de onde faríamos a restauração e para onde restauraríamos? Para muitas empresas, a resposta sincera é “na mesma nuvem”. Seus dados, seus backups e seu plano de recuperação ficam todos com um único provedor. Quando esse provedor falha, não há nada a fazer a não ser esperar.
Criamos o Commvault Cloud para que haja sempre outro local de onde restaurar e outro local para onde restaurar: entre nuvens, do ambiente local para a nuvem e da nuvem de volta para o ambiente local.
| Se isso não der certo | Abordagem de nuvem única | Com a Commvault |
|---|---|---|
| Uma única nuvem (Azure ou AWS) | Aguarde até que o provedor volte a funcionar | Recupere a partir da cópia armazenada em outra nuvem ou no ambiente local e transfira as cargas de trabalho para lá |
| O data center do cliente | Como as restaurações dependem do que restar no local | Restaurar a partir da cópia na nuvem e operar por lá até que o local volte a funcionar |
| Ambas as nuvens | Não há como recuperar até que uma delas volte a funcionar | Os clientes que mantêm uma cópia fora da nuvem pública podem restaurar a partir dela e executar o Recovery em seu próprio data center |
Vou ser sincero sobre essa contradição. Cada cópia a mais custa dinheiro, e cada ambiente a mais aumenta a complexidade.Escrevi sobre isso na BCG: a maioria das empresas que se autodenominavam “multinuvem” na verdade executava cargas de trabalho diferentes em nuvens diferentes, e a verdadeira portabilidade era rara e cara. Essa era a advertência correta em 2021. O argumento mudou desde então.
A arquitetura nativa da nuvem mudou o jogo. Cargas de trabalho desenvolvidas em contêineres e no Kubernetes, com infraestrutura definida por código e dados desacoplados da plataforma subjacente, podem ser ativadas em uma segunda nuvem ou em um data center sem a necessidade de serem reconstruídas. Nem toda carga de trabalho vale a pena. Mas, para os poucos serviços sem os quais uma empresa não pode operar, a resiliência multicloud é mais viável hoje do que nunca e, após esta semana, o custo de não tê-la é muito mais fácil de quantificar.
Isso não é apenas um item do nosso plano de ação. Atualmente, os clientes da Commvault convertem máquinas virtuais entre hipervisores e nuvens como parte de uma restauração e criam um ambiente de recuperação limpo e isolado, no local ou na nuvem, por meio de automação. Vários clientes executam essa automação rotineiramente, não apenas em situações de crise.
Há outras duas coisas tão importantes quanto ter um lugar alternativo para onde ir.
- Visibilidade.Não é possível recuperar o que não se vê. Muitas empresas só descobrem onde seus dados críticos estão armazenados — e o que nunca foi protegido — no meio de uma interrupção. A Commvault oferece aos clientes uma visão contínua de onde seus dados estão, o que está protegido e o que está exposto, antes que algo dê errado.
- Agentes de IA.Os agentes agora incorporam lógica de negócios, o que os torna aplicativos de produção. Eles precisam das mesmas garantias que qualquer outra carga de trabalho crítica, e a maioria das organizações ainda não chegou a esse ponto. Com o AgentRecover, agora em acesso antecipado para o Microsoft Foundry e com lançamento previsto para o Amazon Bedrock AgentCore em dezembro, podemos auditar o que um agente fez e recuperar tanto o agente quanto os aplicativos que ele alterou.
Três coisas que os CISOs e os conselhos de administração devem fazer esta semana
- Descubra o que está dando errado no conjunto.Selecione seus dez serviços de negócios mais críticos e rastreie cada um deles até a região de nuvem e o provedor de identidade dos quais dependem. Você está procurando por destinos compartilhados, e o primeiro lugar a verificar são seus próprios backups: eles ficam na mesma nuvem que os sistemas que protegem, e você consegue restaurá-los em qualquer outro lugar? O conselho de administração deve ser capaz de obter uma resposta clara para uma pergunta: qual falha de um único fornecedor nos derruba, e por quanto tempo?
- Avalie seu tempo de recuperação em um teste real.Decida quais serviços precisam estar em operação no primeiro dia e quanto custa cada hora sem eles. Em seguida, retire um provedor de serviço em um exercício sem aviso prévio, pelo menos a cada trimestre, e cronometre quanto tempo leva para retornar ao estado normal. Um exercício simulado não conta. O número a ser apresentado ao conselho é o tempo médio para uma recuperação completa, conforme medido.
- Sujeitem os agentes de IA às mesmas regras que os sistemas de produção.Conheça cada agente que você executa, quais dados ele pode acessar e o que pode alterar. Exija um registro de auditoria e uma maneira de reverter tanto o agente quanto tudo o que ele alterou. Se ninguém souber dizer o que um agente fez na última terça-feira e como desfazer isso, ele não está pronto para receber mais autoridade.
Antes do próximo
Esta semana foi um ensaio geral. Ninguém estava tentando nos prejudicar, e mesmo assim custou bilhões. Da próxima vez, alguém pode estar tentando, ou um agente de IA pode fazer a alteração. Prepare-se para isso agora. Isso significa Recovery contínua: pronta antes do próximo incidente, não montada durante ele.
Fontes
- Interrupção da Microsoft em 2026 — Wikipédia
- O que causou a interrupção do Microsoft 365 em 12 de novembro de 2026 — Control Plane
- Autoridades atribuem a culpa aos equipamentos de telecomunicações obsoletos da FAA — GeekWire
- A FAA suspende a proibição de decolagens em todo o país — CBS News
- Viajantes retidos no aeroporto DFW entram em pânico — CBS Texas
- Suspensão de voos pela FAA e interrupção dos serviços da Microsoft: a IA teve algum papel nisso? — KingyAI
- Interrupções em todo o país revelam os riscos da dependência tecnológica — The National Desk
- Análise Anual de Interrupções 2026 — Uptime Institute
- Mercado de nuvem no 3º trimestre de 2026 — Synergy Research via TechInsights
- Análise pós-falha da AWS us-east-1 — BleepingComputer
- Interrupção do Microsoft 365 se estende por quase 10 horas — The Register
- Interrupção nos serviços do Microsoft 365, 23 de julho de 2026 — Notícias sobre segurança cibernética
- A interrupção da CrowdStrike custou US$ 5,4 bilhões às empresas da Fortune 500 — Axios / Parametrix
- Os custos ocultos do tempo de inatividade — Splunk e Oxford Economics
- Gartner: IA mal configurada paralisará infraestrutura crítica em um país do G20 até 2028
- Interrupção da Microsoft pode causar perda de produtividade de US$ 7 bilhões — CNN
- Serviços da Microsoft voltam a funcionar após interrupção de 38 horas; perdas estimadas entre US$ 300 e 500 milhões — NewsDrum / Reuters
- Microsoft 365 restaurado após interrupção global — Bright Defense
- Atualizações em tempo real sobre a suspensão de voos pela FAA; Morningstar e DBRS sobre reembolsos — The Globe and Mail
- A suspensão dos voos pela FAA durou 4 horas e 21 minutos — Informed Clearly
- Interrupção na AWS us-east-1: prejuízos nos EUA de US$ 500 a 650 milhões — Parametrix
- Estimativa das perdas cobertas pelo seguro decorrentes da interrupção da AWS: US$ 38–581 milhões — Risk & Insurance / CyberCube
- As interrupções críticas na nuvem aumentaram 52% desde 2022 — CXOToday / Parametrix
- Os incidentes críticos na nuvem diminuem em 2025 — Parametrix
- Contagem semanal de interrupções da ThousandEyes no 1º trimestre de 2026 — DEV