Cette semaine, deux pannes survenues en l’espace de 48 heures ont paralysé le travail et les déplacements à travers les États-Unis. Aucune de ces deux pannes n’était due à une cyberattaque. Elles étaient toutes deux le résultat d’erreurs internes.
Jeudi, une modification du réseau a provoqué une panne de Microsoft 365 dans plus de 70 pays, et il a fallu environ un jour et demi pour que le service soit entièrement rétabli. Selon une première estimation, la perte de productivité s’élèverait à près de 7 milliards de dollars. Vendredi, de nouveaux équipements ont surchargé les infrastructures de télécommunications vieillissantes de la FAA, et tous les vols au départ du pays ont été cloués au sol pendant plus de quatre heures. Plus de 9 000 vols ont été annulés vendredi et 4 100 autres samedi.
Si de simples changements dans les habitudes peuvent paralyser le système mondial de messagerie électronique et l’espace aérien américain au cours de la même semaine, imaginez ce qu’une personne mal intentionnée pourrait faire. La résilience n’est plus un simple plan d’urgence. C’est une priorité au plus haut niveau de l’entreprise.
Les pannes majeures prennent de l’ampleur et sont de plus en plus fréquentes
Les pannes sont monnaie courante. Au début de l’année 2026, ThousandEyes a recensé entre 200 et 400 pannes de réseau par semaine à l’échelle mondiale, et presque personne ne s’en est aperçu. Selon certains indicateurs, la situation en matière de pannes courantes serait même en voie d’amélioration : l’Uptime Institute constate une baisse des taux de panne par site depuis cinq années consécutives.
Le problème se situe au plus haut niveau, où deux phénomènes se produisent simultanément.
Les pannes majeures sont plus fréquentes. Les pannes critiques chez les trois plus grands fournisseurs de cloud ont augmenté de 52 % entre 2022 et 2024, et le nombre d’heures perdues a augmenté de 51 %, pour atteindre 221 par an. L’année 2025 a été plus calme. Ce n’est pas le cas de 2026 : trois pannes majeures de Microsoft 365 et une interruption généralisée à l’échelle nationale, alors qu’il reste encore six semaines avant la fin de l’année.
Et elles sont plus importantes. Auparavant, une mauvaise journée coûtait des millions. La mise à jour défectueuse de CrowdStrike en juillet 2024 a coûté aux entreprises du Fortune 500 environ 5,4 milliards de dollars. La panne de Microsoft survenue cette semaine pourrait coûter 7 milliards de dollars rien qu’en perte de productivité.
En voici cinq qui se sont produites au cours des 13 derniers mois. Aucune n’a été attribuée à une attaque.
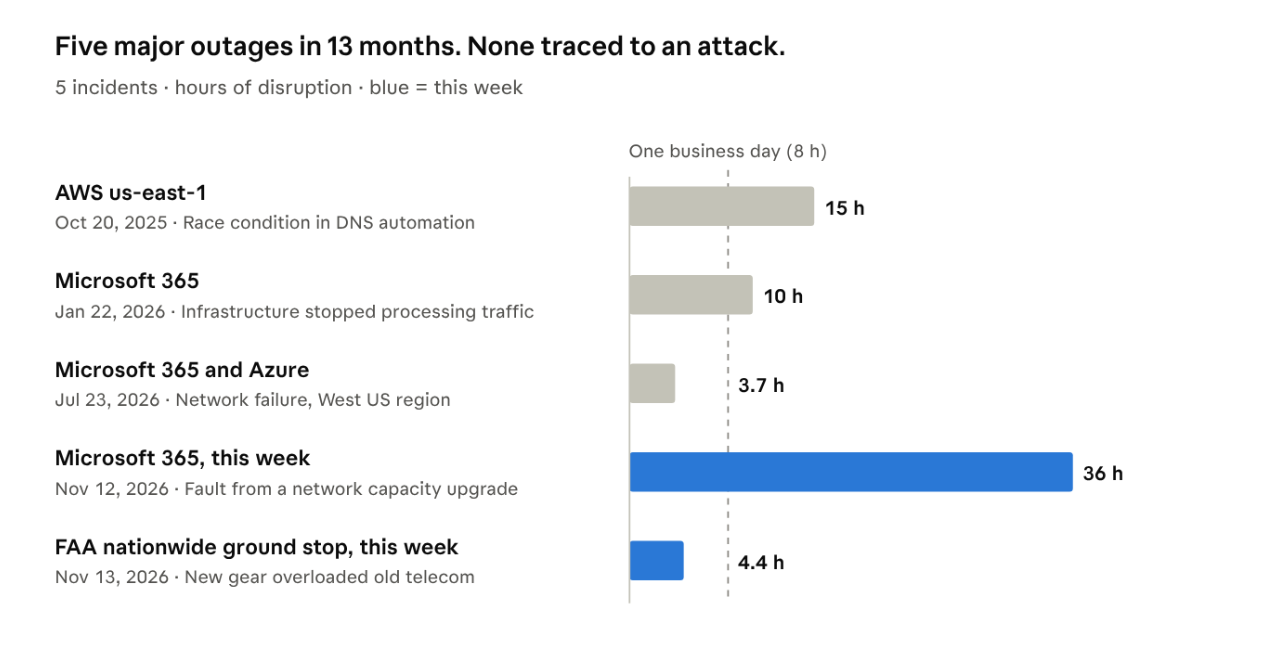
La panne de Microsoft de cette semaine a été la plus longue des cinq. Celle de la FAA a entraîné la plus longue interruption des vols à l’échelle nationale depuis 25 ans, et seulement la deuxième depuis le 11 septembre.
Voici ce qu’elles ont coûté, lorsque leur coût a pu être chiffré. Personne n’a publié d’estimation concernant les pannes de Microsoft survenues en janvier et en juillet.
| Panne | Perte économique estimée | Perte couverte par l’assurance | Estimée par |
|---|---|---|---|
| Microsoft 365, novembre 2026 | Environ 7 milliards de dollars de perte de productivité (chiffre provisoire) | 300 à 500 millions de dollars | Anderson Economic Group;Morningstar DBRS |
| Interdiction de décollage décrétée par la FAA, novembre 2026 | Chiffre non encore estimé ; les remboursements pourraient à eux seuls coûter des milliards aux compagnies aériennes | Pas encore évalué | Morningstar DBRS |
| AWS us-east-1, octobre 2025 | Entre 500 et 650 millions de dollars pour les entreprises américaines | 38 à 581 millions de dollars | Parametrix;CyberCube |
| Mise à jour CrowdStrike, juillet 2024 | 5,4 milliards de dollars pour les entreprises du Fortune 500 | entre 0,54 et 1,08 milliard de dollars | Parametrix |
L’assurance ne couvre qu’une fraction de ce montant. Après l’affaire CrowdStrike, les polices d’assurance couvraient environ 10 à 20 % des pertes subies par les entreprises du Fortune 500. Le reste a été pris en charge par des entreprises qui n’avaient pourtant aucune responsabilité dans cette défaillance. Pour l’ensemble du Global 2000, Splunk et Oxford Economics ont estimé, dans une étude de 2024, le coût annuel des temps d’arrêt à 400 milliards de dollars, soit environ 9 % des bénéfices.
Pourquoi cela continue-t-il à se produire ?
Trois facteurs se combinent, et aucun d’entre eux n’est près de disparaître.
- La concentration.AWS, Microsoft et Google détiennent 61 % d’un marché du cloud qui représente désormais 168 milliards de dollars par trimestre. Les fournisseurs tiers sont à l’origine d’environ deux tiers des pannes rendues publiques au cours des neuf dernières années. Lorsqu’un d’entre eux connaît une mauvaise journée, des milliers d’entreprises connaissent la même mauvaise journée au même moment.
- Le rythme du changement.Les deux pannes de cette semaine ont toutes deux été déclenchées par une modification apportée intentionnellement : une mise à niveau du réseau chez Microsoft, l’installation de nouveaux équipements à la FAA. L’Uptime Institute constate que les défaillances liées à la configuration et à la gestion du changement constituent la principale cause des pannes de réseau. Nous modifions des systèmes complexes plus rapidement que nous ne pouvons en comprendre les conséquences.
- L’IA.Les dépenses liées au cloud ont augmenté de 55 % au cours du dernier trimestre, et l’IA en représente désormais environ un tiers. Cela se traduit par une charge supplémentaire sur la même infrastructure partagée. Il s’agit également d’un nouveau type de charge de travail : des agents qui agissent de leur propre chef sur les systèmes de production. Ensemble, ces éléments constituent ce que nous appelons la vulnérabilité de l’IA. Gartner prévoit que, d’ici 2028, une IA mal configurée dans des systèmes cyber-physiques provoquera la paralysie d’une infrastructure critique nationale dans un pays du G20.
Les défaillances de cette semaine étaient des accidents. Ceux qui s’attaquent aux infrastructures critiques pour gagner leur vie viennent de constater à quel point une seule défaillance peut avoir des répercussions. La défense est la même dans les deux cas : une architecture capable de se remettre d’une mise à jour défectueuse peut se remettre d’une attaque.
Vos données ne peuvent pas être stockées à un seul endroit
Posez une question à votre équipe lundi : si notre cloud principal tombait en panne demain, d’où restaurerions-nous nos données, et vers où les restaurerions-nous ? Pour de nombreuses entreprises, la réponse honnête est « le même cloud ». Leurs données, leurs sauvegardes et leur chemin de restauration se trouvent tous chez un seul fournisseur. Lorsque ce fournisseur tombe en panne, il n’y a rien d’autre à faire qu’attendre.
Nous avons conçu Commvault Cloud de manière à ce qu’il y ait toujours un autre emplacement à partir duquel restaurer et un autre emplacement vers lequel restaurer : d’un cloud à l’autre, d’un environnement sur site vers le cloud, et du cloud vers l’environnement sur site.
| En cas de panne | Approche « mono-cloud » | Avec Commvault |
|---|---|---|
| Un seul cloud (Azure ou AWS) | Attendre que le fournisseur soit à nouveau opérationnel | Restaurer à partir de la copie stockée dans l’autre cloud ou sur site, puis y déployer les charges de travail |
| Le centre de données du client | Les restaurations dépendent de ce qui reste sur place | Restaurer à partir de la copie stockée dans le cloud et y exécuter les tâches jusqu’à ce que le site soit à nouveau opérationnel |
| Les deux nuages | Il est impossible de récupérer les données tant que l’un des deux n’est pas rétabli | Les clients qui conservent une copie en dehors du cloud public peuvent effectuer la restauration à partir de celle-ci et mener Recovery dans leur propre centre de données. |
Je vais être franc au sujet de ce compromis. Chaque copie supplémentaire coûte de l’argent, et chaque environnement supplémentaire ajoute à la complexité. Jeai a écrit à ce sujet chez BCG : la plupart des entreprises qui se qualifiaient de « multicloud » exécutaient en réalité différentes charges de travail dans différents clouds, et la véritable portabilité était rare et coûteuse. C’était la mise en garde qui s’imposait en 2021. Le débat a évolué depuis.
L’architecture cloud native a changé la donne. Les charges de travail reposant sur des conteneurs et Kubernetes, avec une infrastructure définie par code et des données découplées de la plateforme sous-jacente, peuvent être déployées dans un deuxième cloud ou dans un centre de données sans avoir à être reconstruites. Toutes les charges de travail ne le justifient pas. Mais pour la poignée de services dont une entreprise ne peut se passer, la résilience multicloud est aujourd’hui plus accessible que jamais, et depuis cette semaine, le coût de ne pas en disposer est beaucoup plus facile à chiffrer.
Pour nous, ce n’est pas simplement un élément d’une feuille de route. Aujourd’hui, les clients de Commvault transfèrent des machines virtuelles d’un hyperviseur à un autre et d’un cloud à un autre dans le cadre d’une restauration, et mettent en place un environnement de reprise propre et isolé, sur site ou dans le cloud, grâce à l’automatisation. De nombreux clients recourent à cette automatisation de manière systématique, et pas seulement en cas de crise.
Deux autres éléments sont tout aussi importants que le fait de disposer d’un autre endroit où se réfugier.
- La visibilité.On ne peut pas restaurer ce qu’on ne voit pas. Trop d’entreprises ne découvrent où se trouvent leurs données critiques, et ce qui n’a jamais été protégé, qu’au moment où une panne survient. Commvault offre à ses clients une vue d’ensemble en temps réel de l’emplacement de leurs données, de ce qui est protégé et de ce qui est exposé, avant même qu’un incident ne se produise.
- Les agents IA.Les agents intègrent désormais une logique métier, ce qui en fait des applications de production. Ils nécessitent les mêmes garanties que n’importe quelle autre charge de travail critique, et la plupart des entreprises n’en sont pas encore là. Grâce à AgentRecover, actuellement en accès anticipé pour Microsoft Foundry et disponible sur Amazon Bedrock AgentCore dès décembre, nous pouvons auditer les actions d’un agent et restaurer à la fois l’agent et les applications qu’il a modifiées.
Trois mesures que les RSSI et les conseils d’administration devraient prendre cette semaine
- Identifiez les éléments qui tombent en panne en même temps.Sélectionnez vos dix services métier les plus critiques et remontez la piste de chacun d’entre eux jusqu’à la région cloud et au fournisseur d’identité dont il dépend. Vous recherchez les éléments dont le sort est lié, et le premier endroit où chercher est vos propres sauvegardes : se trouvent-elles dans le même cloud que les systèmes qu’elles protègent, et pouvez-vous les restaurer ailleurs ? Le conseil d’administration doit pouvoir obtenir une réponse claire à une question : quelle défaillance d’un seul fournisseur nous mettrait hors service, et pour combien de temps ?
- Mesurez votre temps de reprise lors d’un test en conditions réelles.Déterminez quels services doivent être opérationnels dès le premier jour et quel est le coût de chaque heure d’indisponibilité. Ensuite, dans le cadre d’un exercice inopiné, au moins une fois par trimestre, retirez un fournisseur du système et chronométrez le temps nécessaire pour revenir à un état de fonctionnement normal. Une simulation sur papier ne suffit pas. Le chiffre à présenter au conseil d’administration est le temps moyen de reprise complète, tel qu’il a été mesuré.
- Appliquez aux agents d’IA les mêmes règles qu’aux systèmes de production.Connaissez chaque agent que vous mettez en œuvre, les données auxquelles il a accès et ce qu’il est autorisé à modifier. Exigez une piste d’audit et un moyen de revenir en arrière, tant pour l’agent que pour toutes les modifications qu’il a apportées. Si personne n’est en mesure de vous dire ce qu’un agent a fait mardi dernier et comment annuler cette action, il n’est pas prêt à se voir confier davantage de responsabilités.
À la prochaine fois
Cette semaine, c’était une répétition générale. Personne n’essayait de nous nuire, et cela a tout de même coûté des milliards. La prochaine fois, quelqu’un pourrait bien en avoir l’intention, ou un agent IA pourrait provoquer le changement. Préparez-vous dès maintenant à cette éventualité. Cela implique une Recovery continue : à mettre en place avant le prochain incident, et non pendant celui-ci.
Sources
- Panne de Microsoft de 2026 — Wikipédia
- Quelles sont les causes de la panne de Microsoft 365 survenue le 12 novembre 2026 — Control Plane
- Les autorités attribuent cette panne au vieillissement des équipements de télécommunication de la FAA — GeekWire
- La FAA lève l’interdiction de décollage à l’échelle nationale — CBS News
- Les voyageurs bloqués à l’aéroport de Dallas-Fort Worth se débrouillent tant bien que mal — CBS Texas
- Interdiction de décollage de la FAA et panne de Microsoft : l’IA a-t-elle joué un rôle ? — KingyAI
- Les perturbations à l’échelle nationale mettent en évidence les risques liés à la dépendance technologique — The National Desk
- Analyse annuelle des pannes 2026 — Uptime Institute
- Marché du cloud au 3e trimestre 2026 — Synergy Research via TechInsights
- Bilan de la panne d’AWS us-east-1 — BleepingComputer
- La panne de Microsoft 365 a duré près de 10 heures — The Register
- Panne des services Microsoft 365, le 23 juillet 2026 — Actualités sur la cybersécurité
- La panne de CrowdStrike a coûté 5,4 milliards de dollars aux entreprises du Fortune 500 — Axios / Parametrix
- Les coûts cachés des temps d’arrêt — Splunk et Oxford Economics
- Gartner : d’ici 2028, une IA mal configurée paralysera les infrastructures critiques d’un pays du G20
- La panne de Microsoft pourrait entraîner une perte de productivité de 7 milliards de dollars — CNN
- Les services Microsoft sont à nouveau opérationnels après 38 heures d’interruption ; les pertes s’élèveraient à entre 300 et 500 millions de dollars — NewsDrum / Reuters
- Microsoft 365 de nouveau opérationnel après une panne mondiale — Bright Defense
- Dernières nouvelles sur l’interdiction de décollage imposée par la FAA ; Morningstar et DBRS s’expriment sur les remboursements — The Globe and Mail
- L’interruption des vols ordonnée par la FAA a duré 4 heures et 21 minutes — Informed Clearly
- Panne AWS us-east-1 : pertes aux États-Unis comprises entre 500 et 650 millions de dollars — Parametrix
- Estimation des pertes couvertes par les assurances liées à la panne d’AWS : entre 38 et 581 millions de dollars — Risk & Insurance / CyberCube
- Les pannes critiques du cloud ont augmenté de 52 % depuis 2022 — CXOToday / Parametrix
- Baisse des incidents critiques liés au cloud en 2025 — Parametrix
- Nombre hebdomadaire de pannes recensées par ThousandEyes au 1er trimestre 2026 — DEV