Due guasti verificatisi nel giro di 48 ore hanno bloccato il lavoro e gli spostamenti in tutti gli Stati Uniti la scorsa settimana.
Le indagini sono ancora in corso, ma i rapporti preliminari suggeriscono che potrebbero essere stati causati inavvertitamente o per colpa propria.
Giovedì, una modifica alla rete ha causato l’interruzione di Microsoft 365 in oltre 70 paesi, e ci è voluto circa un giorno e mezzo per ripristinare completamente il servizio. Secondo una prima stima, la perdita di produttività si aggirerebbe intorno ai 7 miliardi di dollari. Venerdì, secondo quanto riferito, nuove apparecchiature avrebbero sovraccaricato le obsolete infrastrutture di telecomunicazione della FAA, e tutti i voli in partenza nel paese sono rimasti a terra per oltre quattro ore. Venerdì e sabato sono stati cancellati più di 13.000 voli.
Se delle modifiche di routine possono mettere fuori uso la posta elettronica mondiale e lo spazio aereo americano nella stessa settimana, pensate a cosa potrebbe fare qualcuno con intenzioni malevole. La resilienza non è più un piano di riserva. È un mandato a livello di consiglio di amministrazione.
Le grandi interruzioni stanno diventando sempre più estese e frequenti
Le interruzioni si verificano continuamente. All’inizio del 2026, ThousandEyes ha registrato tra le 200 e le 400 interruzioni di rete a settimana in tutto il mondo, e quasi nessuno se ne è accorto. Secondo alcuni indicatori, quelle ordinarie stanno addirittura migliorando: l’Uptime Institute ha registrato un calo dei tassi di interruzione per sito per cinque anni consecutivi.
Il problema si colloca nella fascia alta, dove due fattori stanno agendo contemporaneamente.
Quelle di grande entità sono più frequenti. Le interruzioni critiche presso i tre principali fornitori di servizi cloud sono aumentate del 52% tra il 2022 e il 2024, e le ore perse sono aumentate del 51%, raggiungendo le 221 all’anno. Il 2025 è stato più tranquillo. Il 2026 non lo è stato: tre gravi interruzioni di Microsoft 365 e un blocco totale a livello nazionale, con ancora sei settimane da trascorrere.
E sono più gravi. Una giornata storta costava milioni. L’aggiornamento difettoso di CrowdStrike nel luglio 2024 è costato alle aziende Fortune 500 circa 5,4 miliardi di dollari. L’interruzione di Microsoft di questa settimana potrebbe costare 7 miliardi di dollari solo in termini di perdita di produttività.
Eccone cinque degli ultimi 13 mesi. Nessuna è stata ricondotta a un attacco.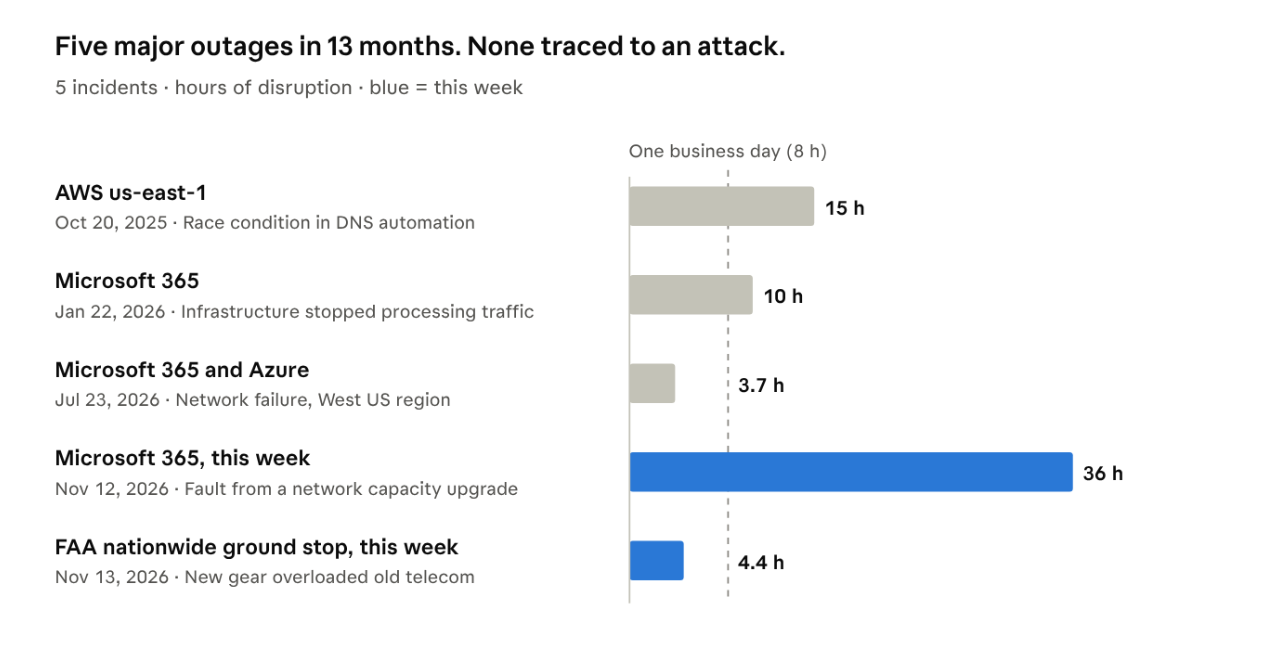 L’interruzione di Microsoft di questa settimana è stata la più lunga delle cinque. Quella della FAA ha rappresentato il blocco dei voli a livello nazionale più lungo degli ultimi 25 anni.
Ecco quanto sono costati, nei casi in cui il danno sia stato quantificato. Nessuno ha pubblicato una stima per le interruzioni di Microsoft di gennaio e luglio.
| Interruzione | Perdita economica stimata | Perdita assicurata | Stima a cura di |
|---|---|---|---|
| Microsoft 365, novembre 2026 | circa 7 miliardi di dollari di perdita di produttività (dati preliminari) | 300–500 milioni di dollari | Anderson Economic Groupdi identitàMorningstar DBRS |
| Sospensione dei voli disposta dalla FAA, novembre 2026 | Non è ancora stato stimato; i soli rimborsi potrebbero costare alle compagnie aeree miliardi | Non ancora stimato | Morningstar DBRS |
| AWS us-east-1, ottobre 2025 | 500–650 milioni di dollari per le aziende statunitensi | 38–581 milioni di dollari | Parametrixdi identitàCyberCube |
| Aggiornamento CrowdStrike, luglio 2024 | 5,4 miliardi di dollari per le aziende della classifica Fortune 500 | 0,54–1,08 miliardi di dollari | Parametrix |
L’assicurazione copre solo una minima parte di questa cifra. Dopo l’incidente di CrowdStrike, le polizze coprivano circa il 10–20% delle perdite delle aziende Fortune 500. Il resto ricadeva sulle aziende che non avevano alcuna responsabilità nel guasto. Per quanto riguarda le aziende Global 2000, Splunk e Oxford Economics hanno stimato in uno studio del 2024 che il costo annuale dei tempi di inattività ammontasse a 400 miliardi di dollari, pari a circa il 9% dei profitti.
Perché continua a succedere
Tre fattori si stanno combinando, e nessuno di essi è destinato a scomparire.
1. Concentrazione. AWS, Microsoft e Google Cloud detengono il 61% di un mercato del cloud che ora vale 168 miliardi di dollari a trimestre. I fornitori terzi sono responsabili di circa due terzi delle interruzioni segnalate pubblicamente negli ultimi nove anni. Quando uno di loro ha una giornata no, migliaia di aziende vivono la stessa giornata no alla stessa ora.
2. Il ritmo del cambiamento. I primi rapporti suggeriscono che entrambi i guasti della scorsa settimana abbiano avuto origine da una modifica apportata intenzionalmente da qualcuno: un aggiornamento della rete presso Microsoft, nuove apparecchiature presso la FAA. L’Uptime Institute rileva che gli errori di configurazione e di gestione delle modifiche sono la causa principale delle interruzioni di rete. I sistemi complessi stanno cambiando più rapidamente di quanto riusciamo a comprendere le conseguenze di tali cambiamenti.
3. L’intelligenza artificiale (IA). La spesa per il cloud è cresciuta del 55% nell’ultimo trimestre e l’IA ne rappresenta ormai circa un terzo. Ciò comporta un carico maggiore sulla stessa infrastruttura condivisa. Si tratta inoltre di un nuovo tipo di carico di lavoro: agenti che agiscono sui sistemi di produzione di propria iniziativa. Insieme, questi fattori costituiscono ciò che chiamiamo “vulnerabilità dell’IA”. Gartner prevede che, entro il 2028, un’IA configurata in modo errato nei sistemi cyber-fisici causerà il blocco delle infrastrutture critiche nazionali in un paese del G20.
Per chi si occupa professionalmente di attacchi alle infrastrutture critiche, le interruzioni della scorsa settimana hanno dimostrato fino a che punto possa propagarsi un singolo guasto. La difesa è la stessa in entrambi i casi: un’architettura in grado di riprendersi da un aggiornamento errato è in grado di riprendersi anche da un attacco.
I vostri dati non possono essere conservati in un unico luogo
Ponete oggi stesso una domanda al vostro team: se domani il nostro cloud principale smettesse di funzionare, da dove ripristineremmo i dati e dove li ripristineremmo? Per molte aziende la risposta onesta è “lo stesso cloud”. I loro dati, i loro backup e il loro percorso di Recovery risiedono tutti presso un unico provider. Quando quel provider fallisce, non resta altro da fare che aspettare.
Abbiamo creato Commvault Cloud in modo che ci sia sempre un altro luogo da cui eseguire il ripristino e un altro luogo in cui ripristinare i dati: tra diversi cloud, dall’infrastruttura on-premise al cloud e dal cloud di nuovo all’infrastruttura on-premise.
| Se dovesse smettere di funzionare | Approccio basato su un unico cloud | Con Commvault |
|---|---|---|
| Un unico cloud (Azure o AWS) | Attendere che il provider torni operativo | Ripristinare dalla copia presente nell’altro cloud o in locale e trasferire lì i carichi di lavoro |
| Il data center del cliente | I ripristini dipendono da ciò che è rimasto sul posto | Ripristinare dalla copia presente nel cloud ed eseguire lì i carichi di lavoro fino al ripristino del sito |
| Entrambi i cloud | Non è possibile ripristinare la situazione finché uno dei due non torni operativo | I clienti che conservano una copia al di fuori del cloud pubblico possono eseguire il ripristino da essa ed effettuare il Recovery nel proprio data center |
Sarò sincero riguardo al compromesso. Ogni copia in più comporta un costo e ogni ambiente aggiuntivo aumenta la complessità.Ne ho parlato quando lavoravo alla BCG: la maggior parte delle aziende che si definivano “multi-cloud” in realtà eseguivano carichi di lavoro diversi su cloud diversi, e la vera portabilità era rara e costosa. Quella era la giusta cautela nel 2021. Da allora, il dibattito è cambiato.
L’architettura cloud-native ha cambiato le carte in tavola. I carichi di lavoro basati su container e Kubernetes, con un’infrastruttura definita nel codice e i dati disaccoppiati dalla piattaforma sottostante, possono essere avviati su un secondo cloud o in un data center senza dover essere ricostruiti. Non tutti i carichi di lavoro ne valgono la pena. Ma per quella manciata di servizi di cui un’azienda non può fare a meno, la resilienza multi-cloud è oggi più raggiungibile che mai, e dopo questa settimana il costo di non averla è molto più facile da quantificare.
Per noi non si tratta di un obiettivo da inserire in una roadmap. I clienti Commvault oggi convertono le macchine virtuali tra hypervisor e cloud nell’ambito di un ripristino e avviano un ambiente di ripristino pulito e isolato, on-premise o nel cloud, tramite automazione. Numerosi clienti eseguono tale automazione regolarmente, non solo in caso di crisi.
Altre due cose sono importanti tanto quanto avere un’alternativa a cui ricorrere.
• Visibilità. Non è possibile recuperare ciò che non si vede. Troppe aziende scoprono dove si trovano i propri dati critici e cosa non è mai stato protetto solo nel bel mezzo di un’interruzione del servizio. Commvault offre ai clienti una visione continua di dove si trovano i loro dati, cosa è protetto e cosa è esposto, prima che si verifichi qualsiasi problema.
• Agenti basati sull’intelligenza artificiale. Gli agenti ora incorporano la logica di business, il che li rende applicazioni di produzione. Hanno bisogno delle stesse garanzie di qualsiasi altro carico di lavoro critico, e la maggior parte delle organizzazioni non è ancora a quel livello. Con AgentRecover, ora in accesso anticipato per Microsoft Foundry e in arrivo su Amazon Bedrock AgentCore a dicembre, possiamo verificare cosa ha fatto un agente e ripristinare sia l’agente stesso che le applicazioni che ha modificato.
Tre cose che i CISO e i consigli di amministrazione dovrebbero fare questa settimana
1. Individuate cosa va in errore contemporaneamente. Prendete i vostri dieci servizi aziendali più critici e risalite per ciascuno di essi fino alla regione cloud e al provider di identità da cui dipendono. State cercando elementi con un destino condiviso, e il primo posto in cui guardare sono i vostri stessi backup: si trovano nello stesso cloud dei sistemi che proteggono, e potete ripristinarli altrove? Il consiglio di amministrazione dovrebbe poter ottenere una risposta chiara a una domanda: quale singolo guasto di un fornitore ci mette fuori uso, e per quanto tempo?
2. Misurate il vostro tempo di Recovery con un test reale. Decidete quali servizi devono essere operativi fin dal primo giorno e quanto costa ogni ora di interruzione. Quindi, almeno una volta al trimestre, escludete un fornitore in un’esercitazione a sorpresa e cronometrate il tempo necessario per tornare a uno stato di piena operatività. Una simulazione teorica non conta. Il dato da presentare al consiglio di amministrazione è il tempo medio di Recovery completo, così come misurato.
3. Sottoponete gli agenti di intelligenza artificiale alle stesse regole dei sistemi di produzione. Conoscete ogni agente che eseguite, quali dati può raggiungere e cosa può modificare. Richiedete una traccia di audit e un modo per ripristinare sia l’agente che tutto ciò a cui ha avuto accesso. Se nessuno è in grado di dirvi cosa ha fatto un agente martedì scorso e come annullarlo, non è pronto per ricevere maggiori autorizzazioni.
Prima del prossimo
La settimana scorsa c’è stata una prova generale che è costata miliardi. La prossima volta potrebbe trattarsi di un attacco doloso, oppure potrebbe essere un agente di intelligenza artificiale ad apportare la modifica. Preparatevi fin da ora a questa eventualità. Ciò significa un processo di Recovery continuo: già in atto prima del prossimo incidente, non messo insieme durante lo stesso.
Fonti
- Cosa ha causato l’interruzione di Microsoft 365 del 12 novembre 2026 — Control Plane
- I funzionari attribuiscono la colpa alle apparecchiature di telecomunicazione obsolete della FAA — GeekWire
- La FAA revoca il divieto di decollo a livello nazionale — CBS News
- I viaggiatori bloccati all’aeroporto DFW si danno da fare — CBS Texas
- Sospensione dei voli da parte della FAA e interruzione dei servizi Microsoft: l’intelligenza artificiale ha avuto un ruolo? — KingyAI
- Le interruzioni a livello nazionale mettono in luce i rischi legati alla dipendenza dalla tecnologia — The National Desk
- Analisi annuale delle interruzioni 2026 — Uptime Institute
- Mercato del cloud, terzo trimestre 2026 — Synergy Research tramite TechInsights
- Analisi post-incidente dell’interruzione di AWS us-east-1 — BleepingComputer
- L’interruzione di Microsoft 365 si protrae per quasi 10 ore — The Register
- Interruzione dei servizi Microsoft 365, 23 luglio 2026 — Notizie sulla sicurezza informatica
- L’interruzione di CrowdStrike è costata alle aziende della Fortune 500 5,4 miliardi di dollari — Axios / Parametrix
- I costi nascosti dei tempi di inattività — Splunk e Oxford Economics
- Gartner: entro il 2028 un’intelligenza artificiale configurata in modo errato causerà il blocco delle infrastrutture critiche in un paese del G20
- L’interruzione di Microsoft potrebbe costare 7 miliardi di dollari in termini di perdita di produttività — CNN
- I servizi Microsoft tornano operativi dopo un’interruzione di 38 ore; perdite stimate tra i 300 e i 500 milioni di dollari — NewsDrum / Reuters
- Microsoft 365 ripristinato dopo un’interruzione a livello globale — Bright Defense
- Aggiornamenti in tempo reale sul blocco dei voli da parte della FAA; Morningstar DBRS sui rimborsi — The Globe and Mail
- Il blocco dei voli imposto dalla FAA è durato 4 ore e 21 minuti — Informed Clearly
- Interruzione di AWS us-east-1: perdite negli Stati Uniti pari a 500–650 milioni di dollari — Parametrix
- Stima delle perdite assicurate dovute all’interruzione di AWS: 38–581 milioni di dollari — Risk & Insurance / CyberCube
- I guasti critici al cloud sono aumentati del 52% dal 2022 — CXOToday / Parametrix
- Diminuzione degli eventi di interruzione critica del cloud nel 2025 — Parametrix
- Conteggi settimanali delle interruzioni di ThousandEyes nel primo trimestre del 2026 — DEV