Funzionalità di ripristino su cloud di Clumio
Rollback su scala cloud
Ripristina miliardi di oggetti allo stato in cui si trovavano prima dell’errore, senza modificarne la posizione.
Guarda come funziona
Rimetti a posto un secchio in pochi minuti
Guarda un rollback a un punto nel tempo su un bucket S3, eseguito dalla console e poi nuovamente tramite l’API.

Perché è importante
Vantaggi delle funzionalità
Recuperolaproprio come serve agli sviluppatori cloud: veloce, preciso e sul posto.

Recupero su scala in cloud
Gli oggetti tornano alla versione selezionata in cui si trovavano già; nulla viene ricopiato dal vault.

Oggetto, prefisso, partizione o bucket
È possibile eseguire il rollback di un oggetto, un prefisso, una partizione DynamoDB o un intero bucket.

Scegli il punto prima del danno
Scegli il momento esatto precedente all’implementazione non corretta, alla regola del ciclo di vita o all’attacco.

Nessuna copia in più da conservare
Il rollback funziona grazie al Versioning di S3, quindi la resilienza non implica la presenza di una seconda copia del bucket.

Miliardi di oggetti, un unico compito
L’automazione fa cosa?richiederebbe altrimenti un notevole impegno manuale: versione per versione in un intero bucket.

S3, DynamoDB e tabelle Iceberg
Lo stesso modello di rollback per l’object storage, le tabelle NoSQL e le tabelle lakehouse.
Riconoscimento da parte degli analisti
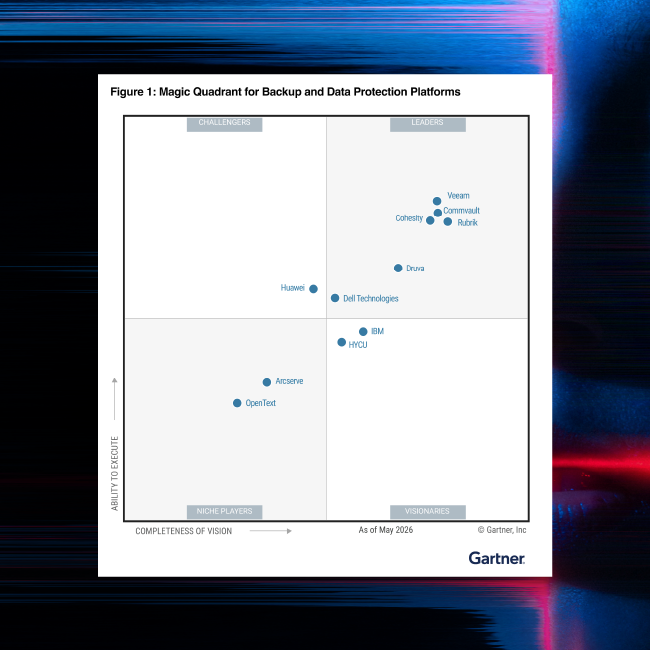
Rapporto Gartner® Magic Quadrant™ del 2026
Commvault è stata nominata leader nel Magic Quadrant™ di Gartner® per le piattaforme di backup e protezione dei dati per la quindicesima volta consecutiva e si è classificata al primo posto in 5 dei 6 casi d’uso nelle funzionalità critiche.
Come funziona
Funzionalità e caratteristiche
Rollback a un punto specifico nel tempo per Amazon S3
Ripristinare gli oggetti a una versione specifica in un momento specifico, per l’intero bucket.
Ripristino in loco per DynamoDB
Ripristina una tabella o una partizione a uno stato precedente, con precisione al secondo, senza creare una nuova tabella.
Recovery con rilevamento degli iceberg
Ripristina le tabelle con i relativi metadati e file di manifesto, in modo da evitare qualsiasi intervento manuale di ricollegamento.
In relazione a questa funzionalità
Soluzione per il recupero AI
Clumio CloudRecover
Una soluzione di Recovery pensata per il cloud. Collaudata su larga scala. Pronta per l’IA.

Rilevamento di minacce e ransomware
Un verdetto su ogni backup, con le prove a sostegno.
Scopri di più
Protezione isolata e immutabile
Ogni copiaisolato, immutabile earchiviatoal di fuori del tuoproduzioneaccount.
Scopri di più
Progettato per gli sviluppatori cloud
Protezione definita nel codice, gestita tramite API e attuabile da agenti di intelligenza artificiale.
Scopri di piùLA NOSTRA PORTATA
Commvault supporta oltre 100.000 aziende
Le aziende che gestiscono alcune delle più grandi infrastrutture cloud si affidano a CloudRecover per ripristinarle.
“Grazie a Clumio CloudRecover Instant Access, in caso di perdita di dati potremmo ripristinare la nostra applicazione in meno di un’ora. È una vera rivoluzione. Prima ci sarebbero voluti giorni o settimane per ripristinare i nostri vasti archivi di dati non strutturati.”
«La velocità di Recovery è uno degli aspetti in cui abbiamo riscontrato il miglioramento più significativo… Con Clumio CloudRecover, la funzione Instant Access ci permette di montare i backup in pochi minuti senza dover attendere il ripristino completo.»
Domande frequenti
Che cos’è il rollback in loco?
Il rollback in loco riporta i dati nel cloud a una versione specificata in un momento specifico, senza doverli ricopiare da un vault. Per Amazon S3 si basa sul versioning degli oggetti; per DynamoDB ripristina una tabella o una partizione a uno stato precedente; per Apache Iceberg ripristina la tabella mantenendo intatti i metadati. Miliardi di oggetti, una sola operazione.
È possibile utilizzare S3 Versioning per recuperare gli oggetti?
La funzione di versioning di Amazon S3 consente di ripristinare un oggetto a una versione precedente, con una Recovery eseguita oggetto per oggetto. Le applicazioni moderne e i carichi di lavoro basati sull’intelligenza artificiale richiedono questa funzionalità su interi bucket contenenti milioni o miliardi di oggetti, operazione che risulterebbe impraticabile se eseguita manualmente. Il rollback in loco automatizza questo processo, ripristinando gli oggetti a una versione e a un momento specifici su scala cloud.
Il rollback richiede che sia abilitata la funzione di versioning di S3?
Sì. La funzione di rollback per Amazon S3 utilizza le versioni già conservate da S3, motivo per cui non richiede copie aggiuntive nel vault. Il versioning è una best practice del cloud che la maggior parte delle organizzazioni ha già adottato;CloudRecoverrende tali versioni utilizzabili su larga scala.
Fino a quando posso tornare indietro?
Per quanto riguarda le versioni e i punti di ripristino conservati, il rollback utilizza le versioni conservate in base alle impostazioni del ciclo di vita di S3 e, per DynamoDB e Iceberg, i punti di ripristino specificati nella tua policy CloudRecover; spetta quindi a te definire i tempi di conservazione.
Il rollback in loco funziona per le tabelle DynamoDB e Iceberg?
Sì. Le tabelle e le partizioni DynamoDB possono essere ripristinate a uno stato precedente, con una precisione al secondo, senza creare una nuova tabella. Le tabelle Apache Iceberg su AWS, comprese le tabelle S3, vengono ripristinate mantenendo intatti i metadati e i manifesti, quindi non è necessario ricostruire manualmente la struttura della tabella.
Scoprilo con i tuoi dati
Valutazione dei rischi relativi ai dati con Clumio CloudRecover
CloudRecoverti aiuta a identificareCloudlacune nel recupero dei dati e nella resilienza. Ottieni unCloudRecoverValutazione dei rischi legati ai dati per individuare i rischi presenti nel vostro ambiente cloud e ottenere una tabella di marcia verso una maggiore resilienza.
