Dos fallos en 48 horas paralizaron el trabajo y los desplazamientos en todo Estados Unidos la semana pasada.
Las investigaciones siguen en curso, pero los informes preliminares apuntan a que podrían haber sido involuntarios o provocados por la propia empresa.
El jueves, un cambio en la red provocó la caída de Microsoft 365 en más de 70 países, y se tardó aproximadamente un día y medio en restablecer el servicio por completo. Una primera estimación sitúa la pérdida de productividad en cerca de 7.000 millones de dólares. El viernes, al parecer, unos nuevos equipos sobrecargaron los antiguos sistemas de telecomunicaciones de la FAA, y todos los vuelos con salida desde el país quedaron en tierra durante más de cuatro horas. Se cancelaron más de 13.000 vuelos entre el viernes y el sábado.
Si unos cambios rutinarios pueden dejar fuera de servicio el correo electrónico mundial y el espacio aéreo de Estados Unidos en la misma semana, imagínate lo que podría hacer alguien con intenciones maliciosas. La resiliencia ya no es un plan de contingencia. Es una exigencia a nivel directivo.
Las grandes interrupciones son cada vez más graves y frecuentes
Las interrupciones se producen constantemente. ThousandEyes registró entre 200 y 400 interrupciones de red a la semana en todo el mundo a principios de 2026, y casi nadie se dio cuenta. Según algunos indicadores, las interrupciones habituales incluso están mejorando: el Uptime Institute ha observado que las tasas de interrupción por sitio llevan cinco años consecutivos descendiendo.
El problema se encuentra en el extremo superior, donde dos factores están evolucionando al mismo tiempo.
Las grandes interrupciones son más frecuentes. Las interrupciones críticas en los tres principales proveedores de servicios en la nube aumentaron un 52 % entre 2022 y 2024, y las horas perdidas aumentaron un 51 %, hasta alcanzar las 221 al año. El año 2025 fue más tranquilo. El 2026 no lo ha sido: tres interrupciones importantes de Microsoft 365 y una interrupción general a nivel nacional, cuando aún quedan seis semanas para que termine el año.
Y son de mayor envergadura. Antes, un mal día costaba millones. La actualización defectuosa de CrowdStrike en julio de 2024 costó a las empresas de la lista Fortune 500 unos 5.4 mil millones de dólares. La interrupción de Microsoft de esta semana podría costar 7 mil millones de dólares solo en pérdida de productividad.
Aquí hay cinco ejemplos de los últimos 13 meses. Ninguno se ha atribuido a un ataque.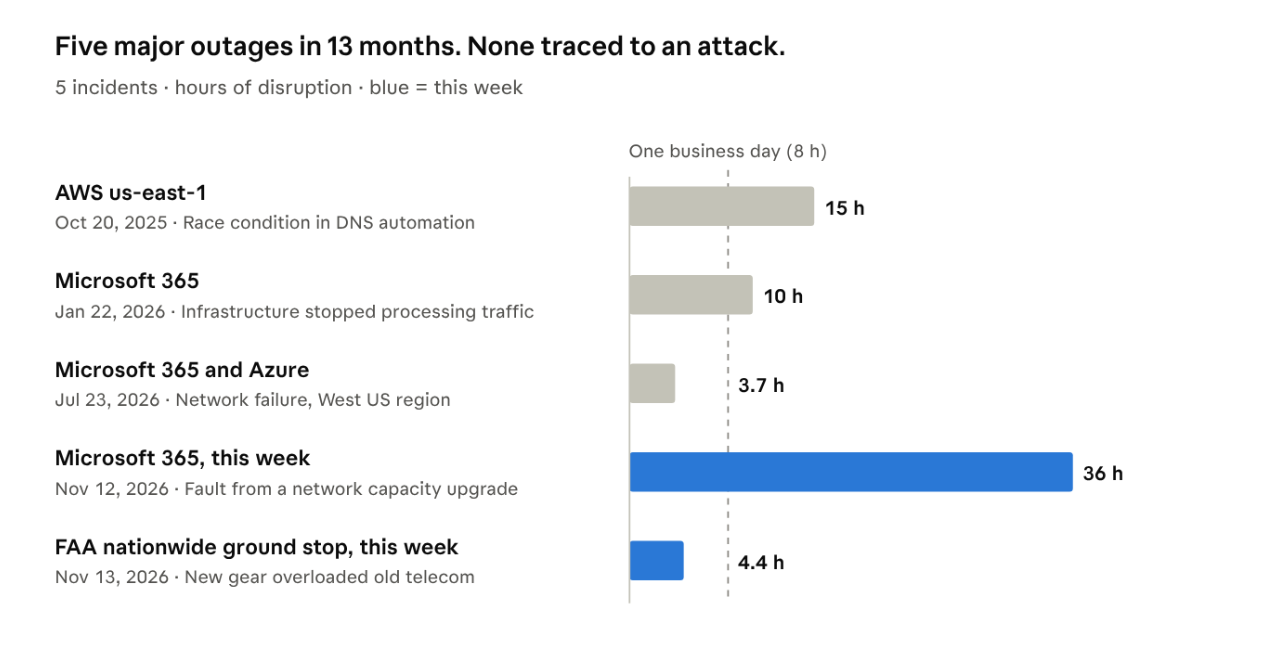 La interrupción de Microsoft de esta semana fue la más prolongada de las cinco. La de la FAA supuso la suspensión de vuelos a nivel nacional más larga de los últimos 25 años.
A continuación se indican los costes, en los casos en que se han cuantificado. Nadie ha publicado una estimación para las interrupciones de Microsoft de enero y julio.
| Interrupción | Pérdida económica estimada | Pérdida asegurada | Estimada por |
|---|---|---|---|
| Microsoft 365, noviembre de 2026 | ~7.000 millones de dólares en pérdida de productividad (cifra preliminar) | entre 300 y 500 millones de dólares | Anderson Economic Group;Morningstar DBRS |
| Suspensión de vuelos por parte de la FAA, noviembre de 2026 | Aún no se ha calculado; solo los reembolsos podrían suponer un coste de miles de millones para las aerolíneas | Aún no se ha calculado | Morningstar DBRS |
| AWS us-east-1, octubre de 2025 | Entre 500 y 650 millones de dólares para empresas estadounidenses | entre 38 y 581 millones de dólares | Parametrix;CyberCube |
| Actualización de CrowdStrike, julio de 2024 | 5.400 millones de dólares para las empresas de la lista Fortune 500 | Entre 0,54 y 1,08 mil millones de dólares | Parametrix |
Los seguros solo cubren una pequeña parte de esto. Tras el caso de CrowdStrike, se calcula que las pólizas cubrían entre el 10 % y el 20 % de las pérdidas de las empresas de la lista Fortune 500. El resto recayó sobre empresas que no tuvieron nada que ver con el fallo. En el conjunto de las empresas de la lista Global 2000, Splunk y Oxford Economics estimaron en un estudio de 2024 que el coste anual del tiempo de inactividad ascendía a 400 000 millones de dólares, lo que supone alrededor del 9 % de los beneficios.
¿Por qué sigue pasando esto?
Hay tres factores que se combinan, y ninguno de ellos va a desaparecer.
1. Concentración. AWS, Microsoft y Google acaparan el 61 % de un mercado de la nube que ahora mueve 168 000 millones de dólares al trimestre. Los proveedores externos son responsables de aproximadamente dos tercios de las interrupciones de servicio notificadas públicamente en los últimos nueve años. Cuando uno de ellos tiene un mal día, miles de empresas tienen el mismo mal día a la misma hora.
2. El ritmo del cambio. Los primeros informes sugieren que ambos fallos de la semana pasada se iniciaron con un cambio que alguien realizó a propósito: una actualización de la red en Microsoft y nuevos equipos en la FAA. El Uptime Institute constata que los fallos en la configuración y en la gestión de cambios son la principal causa de las interrupciones de red. Los sistemas complejos están cambiando más rápido que nuestra comprensión de las consecuencias que tendrán esos cambios.
3. IA. El gasto en la nube creció un 55 % el último trimestre, y la IA representa ahora aproximadamente un tercio de ese gasto. Esto supone una mayor carga sobre la misma infraestructura compartida. Además, se trata de un nuevo tipo de carga de trabajo: agentes que actúan en los sistemas de producción por iniciativa propia. En conjunto, todo ello conforma lo que denominamos «vulnerabilidad de la IA». Gartner prevé que, para 2028, una IA mal configurada en sistemas ciberfísicos provoque el colapso de la infraestructura crítica nacional de un país del G20.
Para quienes se dedican a atacar infraestructuras críticas, las interrupciones de la semana pasada demostraron hasta dónde puede llegar el impacto de un solo fallo. La defensa es la misma en ambos casos: una arquitectura capaz de recuperarse de una actualización defectuosa también puede recuperarse de un ataque.
Tus datos no pueden estar solo en un sitio
Plantea hoy mismo una pregunta a tu equipo: si mañana fallara nuestra nube principal, ¿desde dónde restauraríamos los datos y dónde los restauraríamos? Para muchas empresas, la respuesta sincera es «la misma nube». Sus datos, sus copias de seguridad y su ruta de Recovery residen todos en un único proveedor. Cuando ese proveedor falla, no queda más remedio que esperar.
Hemos creado Commvault Cloud para que siempre haya otro lugar desde el que restaurar y otro lugar al que restaurar: entre nubes, de las instalaciones a la nube y de la nube de vuelta a las instalaciones.
| Si esto no funciona | Enfoque de nube única | Con Commvault |
|---|---|---|
| Una sola nube (Azure o AWS) | Esperar a que el proveedor vuelva a estar operativo | Restaurar desde la copia almacenada en la otra nube, o desde las instalaciones, y trasladar allí las cargas de trabajo |
| El centro de datos del cliente | Las obras de restauración dependen de lo que quede en las instalaciones | Restaurar desde la copia en la nube y mantenerla en funcionamiento allí hasta que el sitio vuelva a estar operativo |
| Ambas nubes | No hay forma de recuperar los datos hasta que se recupere una de ellas. | Los clientes que conservan una copia fuera de la nube pública pueden restaurar los datos desde ella y llevar a cabo Recovery en su propio centro de datos. |
Voy a ser sincero respecto a este dilema. Cada copia adicional cuesta dinero, y cada entorno adicional aumenta la complejidad.Escribí sobre esto en BCG: la mayoría de las empresas que se autodenominaban «multinube» en realidad ejecutaban cargas de trabajo diferentes en nubes diferentes, y la verdadera portabilidad era poco frecuente y cara. Esa era la advertencia acertada en 2021. El panorama ha cambiado desde entonces.
La arquitectura nativa de la nube cambió las reglas del juego. Las cargas de trabajo basadas en contenedores y Kubernetes, con una infraestructura definida en código y los datos desacoplados de la plataforma subyacente, pueden ponerse en marcha en una segunda nube o en un centro de datos sin necesidad de reconstruirlas. No todas las cargas de trabajo merecen ese esfuerzo. Pero para ese puñado de servicios sin los que una empresa no puede funcionar, la resiliencia multicloud es hoy más alcanzable que nunca, y tras esta semana resulta mucho más fácil cuantificar el coste de no contar con ella.
Para nosotros, esto no es un simple punto en la hoja de ruta. Los clientes de Commvault ya convierten máquinas virtuales entre hipervisores y nubes como parte de una restauración, y ponen en marcha un entorno de recuperación limpio y aislado, ya sea en las propias instalaciones o en la nube, mediante la automatización. Numerosos clientes ejecutan esa automatización de forma rutinaria, no solo en caso de crisis.
Hay otras dos cosas tan importantes como disponer de un lugar alternativo al que acudir.
• Visibilidad. No se puede recuperar lo que no se ve. Demasiadas empresas descubren dónde se encuentran sus datos críticos —y qué nunca se protegió— en medio de una interrupción del servicio. Commvault ofrece a los clientes una visión continua de dónde están sus datos, qué está protegido y qué está expuesto, antes de que se produzca cualquier fallo.
• Agentes de IA. Los agentes incorporan ahora lógica de negocio, lo que los convierte en aplicaciones de producción. Necesitan las mismas garantías que cualquier otra carga de trabajo crítica, y la mayoría de las organizaciones aún no han llegado a ese punto. Con AgentRecover, actualmente en acceso anticipado para Microsoft Foundry y que llegará a Amazon Bedrock AgentCore en diciembre, podemos auditar lo que ha hecho un agente y recuperar tanto el agente como las aplicaciones que ha modificado.
Tres cosas que los CISO y los consejos de administración deberían hacer esta semana
1. Averigua qué elementos fallan de forma conjunta. Selecciona tus diez servicios empresariales más críticos y rastrea cada uno de ellos hasta la región de la nube y el proveedor de identidad del que dependen. Lo que buscas es un «destino compartido», y el primer lugar donde mirar son tus propias copias de seguridad: ¿se encuentran en la misma nube que los sistemas que protegen y puedes restaurarlas en cualquier otro lugar? El consejo de administración debería poder obtener una respuesta clara a una pregunta: ¿qué fallo de un único proveedor nos deja fuera de servicio y durante cuánto tiempo?
2. Mide tu tiempo de recuperación en una prueba real. Decide qué servicios deben estar operativos desde el primer día y cuánto cuesta cada hora sin ellos. A continuación, retira un proveedor en un ejercicio sin previo aviso, al menos cada trimestre, y mide cuánto tiempo se tarda en volver a un estado limpio. Un simulacro teórico no cuenta. La cifra que hay que presentar al consejo de administración es el tiempo medio de recuperación limpia, tal y como se ha medido.
3. Somete a los agentes de IA a las mismas normas que a los sistemas de producción. Conoce cada agente que ejecutes, a qué datos puede acceder y qué puede modificar. Exige un registro de auditoría y una forma de revertir tanto el agente como todo aquello a lo que haya accedido. Si nadie puede decirte qué hizo un agente el martes pasado y cómo deshacerlo, no está preparado para asumir más responsabilidades.
Antes del próximo
La semana pasada fue un ensayo general que costó miles de millones. La próxima vez puede ser un ataque malicioso, o quizá sea un agente de IA quien lleve a cabo el cambio. Diseña el sistema teniendo eso en cuenta desde ahora mismo. Eso significa Recovery continua: que esté lista antes del próximo incidente, no que se ponga en marcha durante el mismo.
Fuentes
- ¿Qué provocó la interrupción del servicio de Microsoft 365 el 12 de noviembre de 2026? — Control Plane
- Las autoridades achacan el problema al envejecimiento de los equipos de telecomunicaciones de la FAA — GeekWire
- La FAA levanta la suspensión de vuelos en todo el país — CBS News
- Los viajeros varados en el aeropuerto de Dallas-Fort Worth lo están pasando mal — CBS Texas
- La suspensión de vuelos por parte de la FAA y la interrupción del servicio de Microsoft: ¿influyó la IA? — KingyAI
- Las interrupciones a nivel nacional ponen de manifiesto los riesgos de la dependencia tecnológica — La Redacción Nacional
- Análisis anual de interrupciones de 2026 — Uptime Institute
- Mercado de la nube, tercer trimestre de 2026 — Synergy Research a través de TechInsights
- Análisis posterior a la interrupción del servicio de AWS us-east-1 — BleepingComputer
- La interrupción del servicio de Microsoft 365 se prolonga durante casi 10 horas — The Register
- Interrupción de los servicios de Microsoft 365, 23 de julio de 2026 — Noticias sobre ciberseguridad
- La interrupción de CrowdStrike supuso un coste de 5.4B para las empresas de la lista Fortune 500 — Axios / Parametrix
- Los costes ocultos del tiempo de inactividad — Splunk y Oxford Economics
- Gartner: una IA mal configurada paralizará las infraestructuras críticas de un país del G20 para 2028
- La interrupción de Microsoft podría suponer una pérdida de productividad de 7.000 millones de dólares — CNN
- Los servicios de Microsoft vuelven a funcionar tras una interrupción de 38 horas; pérdidas estimadas de entre 300 y 500 millones de dólares — NewsDrum / Reuters
- Microsoft 365 se restablece tras una interrupción a nivel mundial — Bright Defense
- Noticias en directo sobre la suspensión de vuelos por parte de la FAA; Morningstar y DBRS sobre los reembolsos — The Globe and Mail
- La suspensión de vuelos por parte de la FAA duró 4 horas y 21 minutos — Informed Clearly
- Interrupción de AWS en us-east-1: pérdidas en EE. UU. de entre 500 y 650 millones de dólares — Parametrix
- Estimación de las pérdidas aseguradas por la interrupción de AWS: entre 38 y 581 millones de dólares — Risk & Insurance / CyberCube
- Las interrupciones críticas en la nube han aumentado un 52 % desde 2022 — CXOToday / Parametrix
- Reducción de los incidentes críticos que provocan interrupciones del servicio en la nube en 2025 — Parametrix
- Recuento semanal de interrupciones de ThousandEyes en el primer trimestre de 2026 — DEV