Skip to content

Puntos clave

  • La migración de máquinas virtuales a Red Hat OpenShift Virtualization es un proceso por fases que requiere una protección constante en todos los entornos híbridos.
  • Una platform de protección de datos unificada y nativa de Kubernetes platform reducir la complejidad y platform eliminar la necesidad de herramientas o procesos independientes.
  • Contar con una resiliencia fiable —que incluya copias de seguridad inmutables y detección de amenazas— es fundamental durante la migración, cuando los riesgos son mayores.
  • Las opciones de recuperación flexibles permiten a las organizaciones adaptarse rápidamente si fallan los pasos de la migración o cambian los plazos.
  • Consolidar la protección de las máquinas virtuales y los contenedores ayuda a reducir la proliferación de herramientas y a mantener una gobernanza coherente.

Si hoy en día eres un responsable de TI, lo más probable es que tu estrategia de virtualización esté siendo objeto de una revisión exhaustiva. El aumento de los costes, la incertidumbre en materia de licencias y la dependencia a largo plazo de un único proveedor están haciendo que muchas organizaciones se replanteen su dependencia de los hipervisores tradicionales. Al mismo tiempo, Kubernetes ha madurado hasta convertirse en la base operativa de las aplicaciones modernas.

Estas dos realidades están convergiendo, y para muchas empresas, Red Hat OpenShift Virtualization se está convirtiendo en la opción preferida para ejecutar máquinas virtuales dentro de un modelo operativo nativo de Kubernetes. Esta transición se está acelerando en todos los sectores. A medida que las organizaciones modernizan su infraestructura a su propio ritmo, Red Hat OpenShift Virtualization se ve cada vez más como una forma de modernizar la platform necesidad de refactorizar las aplicaciones. Con ese impulso surge una pregunta clave:

¿Cómo se migran las máquinas virtuales manteniendo una protección, una resiliencia y una capacidad de recuperación constantes durante todo el proceso? Para responder a esta pregunta, tienes que analizar cómo se desarrollan realmente la mayoría de las migraciones empresariales, y en qué momentos la protección y la resiliencia se vuelven fundamentales.

La migración es un viaje, no algo que ocurre una sola vez

Los líderes con experiencia en TI saben que las transiciones de infraestructura casi nunca se producen de golpe. Para las empresas que deciden pasar de hipervisores como VMware a Red Hat OpenShift Virtualization, la transición suele desarrollarse por fases. Durante este tiempo, las organizaciones se ven inevitablemente obligadas a operar en un entorno mixto:

  • Las máquinas virtuales basadas en VMware siguen respaldando las operaciones clave de la empresa.
  • Máquinas virtuales que se acaban de poner en marcha en Red Hat OpenShift Virtualization.
  • Aplicaciones en contenedores que comparten los mismos clústeres de Red Hat OpenShift.

Este periodo de coexistencia conlleva complejidad y riesgos. Los datos están en constante movimiento, los entornos cambian y pueden surgir brechas de seguridad si las herramientas y los procesos no evolucionan al mismo ritmo que las cargas de trabajo.

Es fundamental mantener una protección fiable

Commvault lleva mucho tiempo ofreciendo soluciones de protección y recuperación de datos tanto para entornos VMware como para cargas de trabajo de Kubernetes que se ejecutan en Red Hat OpenShift. Ese mismo modelo de protección nativo de Kubernetes y basado en políticas se extiende ahora a las máquinas virtuales que se ejecutan en Red Hat OpenShift Virtualization. Lo que realmente les gusta a los clientes es la coherencia:

  • Una única platform la protección y la recuperación.
  • Operaciones basadas en políticas que se aplican de manera uniforme en todas las cargas de trabajo.
  • Diseñado para funcionar con tus herramientas y procesos actuales a medida que los entornos van cambiando.

Las máquinas virtuales que se ejecutan en Red Hat OpenShift Virtualization están protegidas mediante los mismos flujos de trabajo y mecanismos de gobernanza que las aplicaciones en contenedores. Este enfoque unificado está siendo adoptado por las organizaciones que están estandarizando sus sistemas con Red Hat OpenShift y que buscan una forma más sencilla y coherente de gestionar los datos en todos los entornos.

Esta función ya está disponible. Commvault Cloud ofrece protección para entornos de Red Hat OpenShift Virtualization compatibles con la versión de soporte a largo plazo 11.40 y la versión de innovación 11.42, lo que significa que los clientes ya pueden poner estas funciones en producción.

No deberías tener que gestionar la protección de forma diferente

Una vez que las máquinas virtuales se trasladen a Red Hat OpenShift Virtualization, no deberían necesitar ningún tratamiento especial en lo que respecta a la protección. Commvault Cloud y protege las máquinas virtuales de Red Hat OpenShift Virtualization junto con las aplicaciones en contenedores, lo que ayuda a los equipos a tener una visibilidad centralizada, una aplicación coherente de las políticas y operaciones de recuperación simplificadas. Las cargas de trabajo virtualizadas y en contenedores se gestionan de forma conjunta, sin crear silos operativos.

Para las organizaciones que gestionan carteras de aplicaciones diversas, esta forma de gestionar las máquinas virtuales dentro de Kubernetes ayuda a reducir las dificultades operativas sin dejar de mantener controles de nivel empresarial.

La ciberresiliencia es clave cuando la migración aumenta el riesgo.

Los periodos de migración son un momento especialmente vulnerable. Los cambios generan complejidad, y la complejidad aumenta el riesgo de perder datos y de sufrir ataques de ransomware. Commvault Cloud mantener la resiliencia durante toda esta fase gracias a:

  • Copias de seguridad aisladas físicamente e inmutables para cargas de trabajo de Red Hat OpenShift Virtualization.
  • Datos de copia de seguridad que facilitan la detección de amenazas y el análisis forense, lo que ayuda a los equipos a comprobar que todo está listo para la recuperación antes de restaurar las cargas de trabajo.
  • Funciones avanzadas de recuperación diseñadas para ayudar a las organizaciones a minimizar las interrupciones operativas.

Tanto si las cargas de trabajo están en fase previa a la migración, en plena transición o ya funcionando a pleno rendimiento en Red Hat OpenShift Virtualization, la resiliencia se mantiene intacta.

La flexibilidad en la recuperación te da confianza

Cualquier iniciativa de modernización necesita margen para hacer ajustes. Commvault admite tanto la recuperación in situ como fuera de sitio para las máquinas virtuales de Red Hat OpenShift Virtualization, incluyendo todo el contexto y la configuración de la máquina virtual. Si algún paso de la migración no sale como estaba previsto —o hay que ajustar los plazos—, los equipos pueden recuperarse rápidamente y seguir adelante sin comprometer la disponibilidad ni la integridad de los datos.

Protección nativa de Kubernetes más allá de las máquinas virtuales

Para muchas empresas, la virtualización es solo una parte de una estrategia más amplia de modernización de aplicaciones. Commvault Cloud ofrece protección centrada en las aplicaciones y nativa de Kubernetes para cargas de trabajo en contenedores, incluidos los volúmenes persistentes y los metadatos de las aplicaciones, en todas las distribuciones de Kubernetes certificadas por la CNCF. Esto permite la movilidad y la recuperación de las aplicaciones cloud, al tiempo que ayuda a mantener la coherencia operativa en todos los entornos.

Reducir la proliferación de herramientas a medida que evoluciona la infraestructura

Platform suelen traer consigo nuevas herramientas, nuevos procesos… y más complejidad. Al utilizar Commvault Cloud platform de protección unificada platform :

  • Máquinas virtuales de VMware.
  • Máquinas virtuales de Red Hat OpenShift Virtualization.
  • Aplicaciones en contenedores.

Las organizaciones pueden ayudar a reducir la proliferación de herramientas, simplificar la administración y mantener una gobernanza coherente, incluso a medida que evolucionan las estrategias de infraestructura.

Cómo encaja todo

En cualquier migración, es útil entender cómo encajan todas las piezas. El kit de herramientas de migración para virtualización de Red Hat se encarga de trasladar las máquinas virtuales de VMware a Red Hat OpenShift Virtualization. Commvault Cloud garantizar la protección y la resiliencia que acompañan a tus cargas de trabajo durante todo el proceso, para que los datos estén protegidos antes, durante y después de la migración. Esto puede ayudar a que la capacidad de recuperación no se quede atrás a medida que se trasladan las cargas de trabajo.

Seguimos con la conversación en la Red Hat Summit

Ya estamos trabajando con clientes que están trasladando activamente sus máquinas virtuales a OpenShift Virtualization, y vamos a seguir hablando de esto en el Red Hat Summit, del 11 al 14 de mayo en Atlanta. En el stand de Commvault, vamos a:

  • Hablando con los responsables de TI sobre los retos reales en materia de resiliencia.
  • Compartimos consejos prácticos para que puedas hacer la migración con confianza.
  • Demostración de Cloud de Commvault Cloud para Red Hat OpenShift Virtualization.

Si mantener la resiliencia y la capacidad de recuperación en toda tu estrategia de virtualización es una prioridad, nos encantaría poder hablar contigo.

Avanzando con confianza

Red Hat OpenShift Virtualization se está convirtiendo en un componente fundamental de la infraestructura empresarial moderna. Pero no puedes precipitarte con la migración a cualquier precio; tienes que integrar la protección, la resiliencia y la recuperación en el proceso desde el principio.

Con Commvault Cloud, proteger las cargas de trabajo de Red Hat OpenShift Virtualization no es una meta para el futuro. Es algo que los clientes ya están haciendo: utilizan una platform unificada platform modernizarse con confianza sin dejar de ser resilientes y de poder recuperarse.

«Red Hat OpenShift Virtualization ofrece una base fiable y consistente para que las organizaciones puedan gestionar todo su entorno virtualizado», afirma Steve Gordon, director sénior de Gestión de Productos de Cloud Híbrida en Red Hat. «Al aprovechar una integración optimizada como la de Commvault Cloud Red Hat OpenShift Virtualization, nuestros clientes pueden avanzar con mayor confianza, sabiendo que sus cargas de trabajo están protegidas de forma constante antes, durante y después de la migración».

Preguntas frecuentes

P: ¿Por qué se considera que la migración de máquinas virtuales es un proceso en varias fases?

R: La mayoría de las empresas no pueden migrar todas las cargas de trabajo de una sola vez, así que operan en un entorno híbrido en el que conviven simultáneamente los entornos antiguos y los nuevos. Este enfoque por fases añade complejidad, por lo que es fundamental contar con una protección y una visibilidad constantes durante toda la transición.

P: ¿Qué papel juega la resiliencia durante la migración de máquinas virtuales?

R: La resiliencia permite a las organizaciones mantener la protección de los datos, recuperarse rápidamente de los fallos y defenderse de amenazas como el ransomware. Durante la migración, cuando los sistemas están en constante cambio, unas medidas sólidas de resiliencia pueden ayudar a evitar la pérdida de datos y las interrupciones operativas.

P: ¿Cómo Cloud Commvault Cloud la protección en distintos entornos?

R: Commvault Cloud una platform única platform protección basada en políticas para máquinas virtuales de VMware, máquinas virtuales de OpenShift Virtualization y aplicaciones en contenedores. Este enfoque unificado permite llevar a cabo operaciones de forma coherente sin tener que introducir nuevas herramientas ni flujos de trabajo.

P: ¿Por qué es importante la protección nativa de Kubernetes?

R: La protección nativa de Kubernetes se adapta a la forma en que se implementan y gestionan las aplicaciones modernas, y abarca tanto los contenedores como las máquinas virtuales. Permite una gestión sencilla de los datos, la movilidad y la recuperación en entornos cloud.

P: ¿Cómo mejora la flexibilidad en la recuperación la confianza en la migración?

R: Las opciones de recuperación flexibles, como las restauraciones in situ y fuera de sitio, pueden ayudar a los equipos a recuperar rápidamente las cargas de trabajo si surge algún problema. Esta adaptabilidad ayuda a reducir el tiempo de inactividad y permite a las organizaciones ajustar sus planes de migración sin poner en riesgo la integridad de los datos.

P: ¿Cómo pueden las organizaciones reducir la complejidad durante las transiciones de infraestructura?

R: Al adoptar una platform unificada de protección de datos, las organizaciones pueden gestionar todas las cargas de trabajo —tanto virtualizadas como en contenedores— a través de una única interfaz. Este enfoque ayuda a reducir la proliferación de herramientas, simplificar la administración y mantener una gobernanza coherente en entornos en constante evolución.

Jason Giza es director sénior de marketing de socios de contenido global en Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos clave

  • La Readiverse Academy ha puesto en marcha un programa de certificación estructurado y por niveles, que abarca desde los conocimientos básicos hasta la especialización avanzada cloud .
  • Las certificaciones se ajustan a puestos reales, lo que ayuda a los alumnos a desarrollar habilidades relevantes para sus responsabilidades en Cloud de Commvault Cloud .
  • El programa cuenta con cuatro niveles —Practicante, Especialista, Profesional y Experto— que van aumentando en profundidad y capacidad operativa.
  • El aprendizaje se basa en tres pilares fundamentales: platform , resiliencia cibernética y conocimientos sobre cargas de trabajo.
  • Las opciones de aprendizaje flexibles, que incluyen formatos a tu propio ritmo y con profesor, permiten a los profesionales avanzar según sus horarios y objetivos.

Los entornos que proteges con Commvault Cloud cada vez más complejos, y las expectativas que se tienen de tus equipos, que se encargan de gestionarlos, son más altas que nunca. Ya no basta con conocer la platform. Se trata de ser capaz de gestionarla, protegerla y recuperarla, a menudo bajo presión.

Si ya has empezado tu viaje de aprendizaje en la Readiverse Academy, bienvenido de nuevo. Y si eres nuevo por aquí, te unes en el momento perfecto. Hoy presentamos un enfoque de certificación estructurado y por niveles que ofrece a los alumnos un itinerario claro y basado en competencias, desde platform básicos platform hasta la especialización avanzada cloud.

Creamos contenido para ti

Cloud de Commvault Cloud exigen conocimientos especializados en múltiples áreas, a menudo dentro de un mismo puesto. Los administradores, los especialistas en seguridad, cloud y los responsables de cargas de trabajo necesitan conocimientos de diferente profundidad y alcance. Y no todo el mundo tiene que aprender lo mismo, en el mismo orden, para ser eficaz.

Los nuevos niveles de certificación de Readiverse Academy reflejan esa realidad. Los alumnos avanzan a través de niveles claramente definidos que se complementan entre sí, de modo que tu certificación se ajuste a lo que realmente haces y valide esas capacidades ante los equipos con los que trabajas.

  • Commvault Cloud : conocimientos básicos sobre platform la resiliencia.
  • Cloud en Commvault Cloud: mayor profundidad en materia de operaciones y seguridad.
  • Commvault Cloud : experiencia avanzada en recuperación y cargas de trabajo.
  • Commvault Cloud : liderazgo total en cloud y resiliencia.

Cada nivel se consigue mediante una combinación de trabajo en el curso, actividades prácticas de laboratorio y evaluaciones validadas. A medida que los alumnos avanzan, el alcance y la profundidad de la capacidad operativa que demuestran aumentan en consecuencia.

Un camino claro: de principiante a experto

El programa de certificación se basa en tres pilares fundamentales de competencias que están presentes en todos los niveles:

  • platform básicas platform
  • Conceptos de resiliencia cibernética
  • Carga de trabajo y experiencia en funcionalidades

Cada nivel añade requisitos específicos relacionados con esos pilares. Los alumnos pueden hacer cursos sueltos o combinar los requisitos indicados para conseguir los objetivos de certificación.

¿Ya estás en Readiverse Academy? Esto es lo que significa para ti.

Con una nueva estructura como esta, la pregunta más importante es qué significa para el progreso que ya has logrado. Si ya has completado cursos u obtenido certificaciones en Readiverse Academy, ¡enhorabuena! Tu inversión es importante y queremos dejar claro qué va a pasar a partir de ahora.

Esas certificaciones reflejan tu trayectoria y tus logros con Commvault. El nuevo programa se adapta a nuestra amplia gama de funciones de ciberresiliencia para Commvault Software, Commvault SaaS y entornos híbridos. A medida que tus necesidades crezcan y requieran más de Commvault, estos cursos y certificaciones te ayudarán a configurar, gestionar y optimizar Commvault para satisfacer las necesidades específicas de tu organización.

No existe una progresión directa desde las vías de certificación anteriores al nuevo programa, pero vuestras certificaciones actuales avalan vuestra experiencia con las versiones anteriores del producto. A medida que esas versiones se retiren, dichas certificaciones también dejarán de tener validez. Los alumnos que ya hayan invertido en la Readiverse Academy están en una posición ideal para avanzar rápidamente.

¿Quién debería hacer los cursos y las certificaciones de Readiverse Academy?

Las certificaciones de Readiverse Academy están pensadas para profesionales que trabajan con Commvault SaaS, el software de Commvault y entornos híbridos.

  • Platform que se encargan de las operaciones diarias.
  • Especialistas en seguridad dedicados a proteger datos y reforzar la seguridad de los entornos.
  • Cloud encargados de la configuración del plano de control y de la resiliencia avanzada.
  • Los responsables de las tareas que necesiten tener conocimientos especializados en ámbitos específicos de datos.

Toda la formación está disponible para que la realices a tu propio ritmo, y algunos cursos también se ofrecen en formato presencial con formador, para que puedas avanzar de la forma que mejor se adapte a tu puesto y a tu horario.

Cómo empezar o seguir con tu proceso de aprendizaje

Tanto si empiezas de cero como si sigues con tu camino, el siguiente paso es sencillo y está pensado para adaptarse a tu situación actual.

  • Inicia sesión o regístrate en commvault.com.
  • ¿Eres nuevo en Commvault? Empieza con el curso «Commvault Cloud ».
  • ¿Te encargas de la gestión de la carga de trabajo? Echa un vistazo a nuestro catálogo de cursos, que abarca prácticamente todo.
  • ¿Buscas estrategias para facilitar la recuperación tras un ciberataque? El curso sobre ciberresiliencia es tu primer paso.

¿Qué nos espera ahora?

Nuestro objetivo es que la progresión sea predecible, transparente y se ajuste a los puestos de trabajo reales, para que los alumnos sepan qué les espera a continuación y cómo prepararse para ello. Nos comprometemos a proporcionar a todos Cloud de Commvault Cloud los conocimientos necesarios para gestionar, proteger y recuperar su entorno con confianza. Porque, cuando más importa, la certificación no se reduce a unas simples credenciales. Se trata de ser resiliente y estar preparado para recuperarse.

Preguntas frecuentes

P: ¿Cuál es el objetivo del programa de certificación de Readiverse Academy?

R: El programa ofrece un itinerario de aprendizaje estructurado y basado en competencias que ayuda a los profesionales a pasar de platform básicos platform a una especialización avanzada cloud . Adapta la formación a las responsabilidades del mundo real para que los alumnos puedan aplicar sus conocimientos de forma eficaz en entornos complejos.

P: ¿Cuáles son los distintos niveles de certificación que hay?

R: Hay cuatro niveles: Commvault Cloud , Specialist, Professional y Expert. Cada nivel se basa en el anterior, aumentando en profundidad técnica, alcance operativo y capacidad de liderazgo.

P: ¿Quién debería apuntarse a los cursos de Readiverse Academy?

R: Los cursos están pensados para platform , especialistas en seguridad, cloud y responsables de cargas de trabajo que trabajen en entornos SaaS, de software e híbridos. Cada perfil puede seguir un itinerario de aprendizaje a medida según sus responsabilidades.

P: ¿Cómo se obtienen las certificaciones?

R: Las certificaciones se obtienen mediante una combinación de cursos, prácticas de laboratorio y evaluaciones validadas. A medida que los alumnos avanzan, van demostrando un nivel cada vez mayor de conocimientos especializados en los ámbitos platform, la seguridad y las cargas de trabajo.

P: ¿Qué pasa con las certificaciones actuales de Readiverse Academy?

R: Las certificaciones actuales siguen siendo válidas como prueba de la experiencia adquirida, pero están vinculadas a versiones anteriores del producto. A medida que esas versiones se retiren, las certificaciones dejarán de ser válidas, lo que animará a los alumnos a pasarse al nuevo programa.

P: ¿Cómo se puede empezar con el nuevo programa?

R: Los nuevos alumnos pueden empezar con el curso «Commvault Cloud Administrator», mientras que los usuarios que ya lo conocen pueden iniciar sesión para seguir avanzando. Hay cursos adicionales disponibles en función de objetivos específicos, como la gestión de cargas de trabajo o las estrategias de ciberresiliencia.

Suzanne Klausner es directora de Estrategia de Capacitación de Clientes en Commvault.

More related posts


Thumbnail_Blog-Ready-or-Not-2026

Why Every CIO Needs a ‘Ready. Or Not.’ Mindset

Read more about Why Every CIO Needs a ‘Ready. Or Not.’ Mindset
Thumbnail_Blog_Readiness-Update-2024

Boost Your Cyber Resilience and Readiness

Read more about Boost Your Cyber Resilience and Readiness
Social_Readiverse_Blog_LinkedIn-1

The Readiverse: Your Go-To Learning Resource for Cyber Resilience and Readiness

Read more about The Readiverse: Your Go-To Learning Resource for Cyber Resilience and Readiness

Puntos clave

  • Los flujos de trabajo de restauración tradicionales pueden provocar desviaciones en la infraestructura de los entornos gestionados por Terraform al aprovisionar nuevos recursos fuera del estado.
  • Clumio Backtrack está diseñado para restaurar datos directamente en los buckets de S3 y las tablas de DynamoDB ya existentes, lo que ayuda a mantener la identidad de los recursos.
  • La recuperación in situ ayuda a reducir la necesidad de realizar importaciones manuales de Terraform, reconfigurar los puntos finales y conciliar el estado durante los incidentes.
  • Alinear los flujos de trabajo de recuperación con los principios de «Infraestructura como código» (IaC) ayuda a mantener la integridad de la configuración y la previsibilidad operativa.
  • El diseño de la recuperación es tan importante como backup para los equipos que gestionan entornos de producción mediante Terraform.

IaC aporta coherencia, repetibilidad y control de versiones a cloud . Terraform se convierte en la fuente de referencia sobre lo que existe, cómo está configurado y cómo debería funcionar. La recuperación plantea un nuevo reto.

Las operaciones de restauración tradicionales suelen crear nuevos recursos: nuevos buckets de S3, nuevas tablas de DynamoDB, nuevos endpoints. Desde el punto de vista de Terraform, esos recursos no se han definido en el código. No existen en el estado. Esto genera desviación. En las operaciones rutinarias, la desviación es manejable. Durante un incidente, se agrava. Aquí es donde el diseño de la recuperación es tan importante como el diseño de las copias de seguridad.

El problema de la deriva en IaC

En un modelo de restauración típico:

  • Un recurso protegido se restaura como un nuevo recurso.
  • El recurso original sigue estando dañado, sobrescrito o no funciona.
  • El estado de Terraform no reconoce el nuevo recurso.
  • Los equipos deben importar manualmente los recursos a State.
  • Puede que haya que actualizar las configuraciones de las aplicaciones.

Para platform que gestionan la infraestructura de producción a través de Terraform, esto supone un obstáculo justo en el momento menos oportuno. El reto no es backup en sí, sino cómo se integran los flujos de trabajo de restauración con las prácticas de «infraestructura como código».

Te presentamos la recuperación in situ con Clumio Backtrack

Clumio Backtrack es una función de recuperación que te ayuda a restaurar datos directamente en los recursos existentes de AWS, en lugar de tener que aprovisionar una infraestructura de sustitución. Cuando se configura a través del proveedor de Clumio para Terraform, Backtrack te permite crear flujos de trabajo de recuperación que se ajustan a la infraestructura definida en código.

Clumio Backtrack es compatible tanto con Amazon S3 como con Amazon DynamoDB. Si quieres conocer más detalles técnicos sobre los flujos de trabajo de recuperación específicos de DynamoDB, echa un vistazo a nuestra entrada del blog sobre Clumio Backtrack para DynamoDB.

En lugar de tener que buscar recursos de sustitución, Backtrack te ayuda a recuperar:

  • Objetos S3 directamente en el bucket original.
  • Datos de DynamoDB directamente en la tabla original.

Desde el punto de vista de Terraform, la idea es que la infraestructura se mantenga sin cambios, de modo que los recursos definidos sigan coincidiendo con la configuración declarada. Esto ayuda a reducir la necesidad de importar recursos manualmente, crear tablas de restauración temporales, reconfigurar los puntos de conexión y realizar la conciliación del estado en situaciones de presión.

Un ejemplo práctico

Imagina un entorno de producción gestionado íntegramente a través de Terraform. Una tabla de DynamoDB lleva el control del inventario; un bucket de S3 almacena los recursos de la aplicación; los roles y las políticas de gestión de identidades y accesos están codificados; y las políticas de protección se definen mediante Terraform. Si se produce un error antes de un pico de tráfico importante, los métodos tradicionales de restauración pueden crear nuevos recursos que habrá que volver a integrar en Terraform.

Con Backtrack, la recuperación está diseñada para realizarse dentro de los límites de los recursos existentes, lo que ayuda a mantener intacta la infraestructura definida y a conservar la identidad de los recursos. Este enfoque tiene como objetivo eliminar la necesidad de actualizar Terraform para adaptarlo a un bucket o una tabla recién creados, tratando la recuperación como una operación a nivel de datos en lugar de como un proceso de sustitución de la infraestructura.

Por qué es importante para Platform

Para los equipos que apuestan por la infraestructura como código (IaC), los flujos de trabajo de recuperación deben preservar la identidad de los recursos, la alineación de estados, la integridad de la configuración y la previsibilidad operativa. La restauración in situ contribuye a alcanzar esos objetivos al limitar los cambios en la infraestructura durante los procesos de recuperación.

Recuperación a Cloud

Backtrack está diseñado para funcionar a cloud , tanto si se trata de restaurar un pequeño número de objetos como grandes conjuntos de datos. El rendimiento de la recuperación varía en función del tamaño de la carga de trabajo y la configuración del entorno, pero el objetivo arquitectónico sigue siendo el mismo: restaurar los datos sin provocar nuevas desviaciones en la infraestructura. En los entornos gestionados con Terraform, esa distinción es importante.

Dónde encaja este enfoque

La recuperación in situ es especialmente relevante para:

  • Cargas de trabajo de DynamoDB de alto rendimiento
  • Depósitos de S3 con un gran número de objetos
  • Sistemas de producción gestionados íntegramente a través de Terraform
  • Entornos complejos en los que resulta difícil redirigir las dependencias de las aplicaciones hacia nuevos recursos

Cuando la infraestructura se define de forma declarativa, los flujos de trabajo de recuperación deberían ajustarse a esa misma disciplina.

Cómo empezar

Para conocer Clumio Backtrack y su integración con Terraform:

Definir la protección como código es solo una parte de la historia. Diseñar flujos de trabajo de recuperación que mantengan la integridad de la infraestructura es lo que completa el modelo.

Preguntas frecuentes

P: ¿Qué problema plantean las restauraciones tradicionales en los entornos gestionados por Terraform?

R: Las restauraciones tradicionales suelen crear nuevos recursos, como buckets de S3 de sustitución o tablas de DynamoDB, que no están definidos en el estado de Terraform. Esto puede provocar desviaciones en la infraestructura y obligar a los equipos a importar recursos manualmente y conciliar configuraciones durante incidentes de gran presión.

P: ¿En qué se diferencia Clumio Backtrack de los métodos de restauración habituales?

R: En lugar de aprovisionar nueva infraestructura, Clumio Backtrack está diseñado para restaurar los datos directamente en el recurso de AWS ya existente. Este enfoque ayuda a conservar la identidad del recurso y a mantener el estado de Terraform alineado con la configuración declarada.

P: ¿Qué servicios de AWS son compatibles con Clumio Backtrack?

R: Clumio Backtrack es compatible con Amazon S3 y Amazon DynamoDB. Está diseñado para restaurar los objetos de S3 en el bucket original y los datos de DynamoDB en la tabla original, lo que ayuda a mantener la coherencia con la infraestructura definida en código.

P: ¿Por qué es importante la recuperación in situ para platform ?

R: Platform recurren a la infraestructura como código para garantizar la coherencia y el control. La recuperación in situ ayuda a mantener la alineación de estados, la integridad de la configuración y la previsibilidad operativa sin introducir cambios adicionales en la infraestructura durante los procesos de recuperación.

P: ¿Cuándo resulta especialmente útil la recuperación in situ?

R: Es especialmente útil para cargas de trabajo de DynamoDB de alto rendimiento, buckets de S3 con un gran número de objetos y sistemas de producción gestionados íntegramente a través de Terraform. También puede resultar beneficioso en entornos en los que redirigir las dependencias de las aplicaciones a recursos recién creados resultaría complejo o arriesgado.

P: ¿Cómo pueden los equipos empezar a utilizar la integración entre Clumio Backtrack y Terraform?

R: Los equipos pueden consultar la documentación del proveedor de Clumio para Terraform, echar un vistazo al código fuente del proveedor en GitHub y ver el vídeo de demostración de Backtrack al que se hace referencia en el blog para entender los detalles de la implementación y el flujo de trabajo.

Lawrence Chang es el director de ingeniería de Clumio y Vir Choksi es director principal de marketing de producto en Commvault.

More related posts


Thumbnail_Blog-AWS-Data-Protection-Terraform-Clumio-2026

Automating AWS Data Protection with Terraform and Clumio

Read more about Automating AWS Data Protection with Terraform and Clumio
Thumbnail_Blog_Clumio-Tech-2025

Restore only what matters: Clumio Backtrack for DynamoDB

Read more about Restore only what matters: Clumio Backtrack for DynamoDB
Thumbnail_Blog-GoogleWorkspace-2026

How the Move to Clumio Delivered 66.7% Savings on AWS Backups

Read more about How the Move to Clumio Delivered 66.7% Savings on AWS Backups
Thumbnail_Blog_AWS-Marketplace-AI

Commvault Featured in New AI Agent Solutions in AWS Marketplace

Read more about Commvault Featured in New AI Agent Solutions in AWS Marketplace
Man-and-woman-working-on-laptops-profile-Crocus-Thumbnail

Protecting Your Amazon S3 Data with Clumio: A Comprehensive Solution

Read more about Protecting Your Amazon S3 Data with Clumio: A Comprehensive Solution

Clumio

Read more about Clumio

Puntos clave

  • La mayoría de los ejercicios de simulación solo sirven para comprobar el rendimiento, en lugar de poner de manifiesto las deficiencias reales en la respuesta ante incidentes.
  • Para que los ejercicios sean eficaces, deben incluir elementos de fricción, ambigüedad y presión que reflejen situaciones reales.
  • Limitar el alcance del ejercicio a unos pocos escenarios críticos y definir el éxito como la detección de problemas, en lugar de quedar bien, puede dar lugar a conclusiones más significativas y aplicables.
  • La participación de distintos departamentos, y no solo de los equipos técnicos, es fundamental para evaluar con precisión la respuesta de la organización.
  • La verdadera resiliencia se demuestra mediante pruebas reales de recuperación, no solo con simulaciones basadas en debates.

Hay un momento que la mayoría de los responsables de seguridad reconocen, aunque no lo digan en voz alta. El ejercicio de simulación acaba de terminar. El equipo se va retirando. Todo el mundo parece razonablemente satisfecho. Y, en algún rincón de tu mente, surge una pregunta silenciosa: ¿Hemos aprendido realmente algo?

Si eres sincero, la respuesta suele ser no.

Esto no se debe a que los ejercicios de simulación sean una mala idea. Son una de las herramientas más valiosas con las que cuenta un responsable de seguridad. El problema radica en cómo los llevan a cabo la mayoría de las organizaciones, y en qué miden realmente al hacerlo.

La trampa del rendimiento

El error más común en los ejercicios de simulación no tiene nada que ver con el escenario. Tiene que ver con el objetivo. La mayoría de los equipos, de forma consciente o no, diseñan ejercicios destinados a demostrar competencia en lugar de a descubrir carencias.

El escenario suele seguir un arco narrativo claro. La información llega en una secuencia lógica. Las personas adecuadas dicen lo que deben decir. Todo el mundo se siente preparado. Y esa sensación —de confianza, de haber ensayado bien, casi de camaradería— es precisamente el problema. Los incidentes reales no siguen un guion perfecto. Se presentan con información incompleta, señales contradictorias, personas ilocalizables y una empresa que exige respuestas más rápido de lo que permiten los hechos. Si tu simulacro no genera ese tipo de fricción, es que no has puesto a prueba la respuesta ante incidentes. Solo has ensayado una conversación.

Cuando el ejercicio está diseñado para validar en lugar de poner a prueba bajo presión, surge un segundo problema: la gente deja de ser sincera. Nadie dice: «No sé a quién corresponde esa decisión» o «en realidad nunca hemos probado esa ruta de Recovery». Dicen lo que suena bien. Y las lagunas que deberían salir a la luz en un entorno controlado permanecen ocultas hasta que salen a la luz en uno real.

Lo que realmente evalúa un buen ejercicio

Antes de crear un escenario, tienes que responder a una pregunta más sencilla: ¿qué es lo que realmente quieres aprender? No 20 cosas. Tres o cuatro.

¿Es capaz tu equipo de tomar una decisión de cierre con la suficiente rapidez, y sabe todo el mundo quién tiene la autoridad para tomarla? Cuando los departamentos de seguridad, TI, jurídico y de comunicaciones se reúnen en una misma sala con prioridades contradictorias, ¿son realmente capaces de llegar a decisiones de forma conjunta? ¿Puedes explicar el impacto empresarial de un incidente con la claridad suficiente para que la dirección actúe —y no solo lo comprenda? Y si tuvieras que restaurar un sistema crítico en las próximas cuatro horas, ¿serías realmente capaz de hacerlo?

Una vez que sepas qué estás poniendo a prueba, crea un escenario con fricciones reales. Haz que una persona clave no esté disponible en mitad del ejercicio. Introduce una escalada por parte de un cliente. Haz que un regulador plantee una pregunta que el equipo no pueda responder basándose en el manual de procedimientos.

Proporciona a los participantes información incompleta y observa cómo toman decisiones a pesar de ello. El valor no reside en ver cómo la gente tiene éxito bajo presión, sino en descubrir los puntos en los que el proceso falla mientras el riesgo aún es lo suficientemente bajo como para solucionarlo.

Di esto en voz alta al principio: hoy en día, el éxito consiste en detectar problemas, no en quedar bien. Esa sola frase cambia lo que la gente se atreve a decir en la sala.

El problema de la gente

Una simulación en la que solo participen los equipos de seguridad y de TI es una conversación técnica, no un ejercicio de respuesta ante incidentes. Si el departamento jurídico no está presente, si el de comunicaciones tampoco está, y si faltan los responsables de negocio y la dirección ejecutiva, no estás poniendo a prueba cómo responde realmente tu organización ante una crisis. Lo que estás haciendo es ver cómo un grupo de gente inteligente analiza una situación hipotética. Los incidentes reales se gestionan en toda la empresa. El simulacro debería reflejar eso.

Hablar del tema no es suficiente

Aquí es donde la mayoría de las organizaciones se quedan a medio camino. Hacerlo sobre el papel es importante, pero eso no es lo mismo que tener confianza. Analizar un escenario de Recovery te aporta cierta información. Restaurar realmente un sistema te aporta otra información diferente. ¿Puedes restablecer la identidad a un momento concreto en el que el sistema estuviera limpio? ¿Puedes validar que lo que estás recuperando es fiable? ¿Puedes restaurar una aplicación de nivel 1 y confirmar que vuelve a funcionar correctamente, sin arrastrar la infección?

Esas no son preguntas que se puedan responder en una sala de reuniones. Llega un momento en el que el plan tiene que enfrentarse al entorno, y tienes que saber si encajan.

Una vez finalizado el ejercicio

La sesión de análisis te indica si el ejercicio ha servido de algo. Si la sesión de análisis inmediato es tranquila, vaga o está llena de «buenos recordatorios», el ejercicio no ha ido lo suficientemente lejos. Un ejercicio de simulación bien llevado debería dejarte con una breve lista de conclusiones reales, responsables claros y plazos concretos. Si no puedes responder a qué ha fallado, quién lo va a solucionar y para cuándo, has organizado un evento, no un ejercicio.

El objetivo nunca fue aprobar el ejercicio. Era aprender algo importante mientras el precio de equivocarse fuera solo tiempo. Echa un vistazo a nuestro último episodio del podcast STRIVE, en el que me uno a mi compañero Chris Mierzwa, director sénior de Marketing de Cartera, para charlar a fondo sobre los ejercicios de simulación.

Preguntas frecuentes

P: ¿Por qué la mayoría de los ejercicios de simulación no aportan un valor real?

R: Muchos ejercicios están pensados para que los equipos parezcan preparados, en lugar de para detectar puntos débiles. Esto da lugar a debates preestablecidos que no reflejan la imprevisibilidad ni la presión de los incidentes reales.

P: ¿Qué objetivo debería perseguir un ejercicio de simulación?

R: Debería centrarse en responder a unas pocas preguntas clave, como la rapidez en la toma de decisiones, la claridad en la responsabilidad y la capacidad de recuperación. Este enfoque ayuda a los equipos a descubrir carencias importantes, en lugar de quedarse en observaciones superficiales.

P: ¿Cómo pueden las organizaciones hacer que los simulacros sean más realistas?

R: Introduce incertidumbre, información que falta y contratiempos inesperados durante el escenario. Estos elementos obligan a los equipos a pensar de forma crítica y a actuar bajo presión, en condiciones más parecidas a las de un incidente real.

P: ¿Quién debería participar en un ejercicio de simulación?

R: Además de los equipos de seguridad y TI, deberían participar equipos como el jurídico y el de comunicación, así como los responsables de negocio y los ejecutivos. Así, el simulacro reflejará cómo se gestionan los incidentes reales en toda la organización.

P: ¿Por qué no basta con hablar sobre la recuperación?

R: Las conversaciones pueden poner de relieve los planes, pero solo las pruebas reales demuestran si los sistemas se pueden restaurar de verdad de forma limpia y rápida. La validación práctica es necesaria para confirmar que todo está listo para la recuperación.

P: ¿Qué define un resultado satisfactorio en un ejercicio de simulación?

R: Un ejercicio bien hecho da lugar a conclusiones claras, responsables asignados y plazos definidos para la corrección. Si faltan estos elementos, es probable que el ejercicio no haya supuesto un reto suficiente para el equipo.

Chris Bevil es director del área de Ciberresiliencia Global e Inteligencia Artificial en Commvault.
More related posts


Readiverse-Featured-Image-888-x-500

Ready Is Good. Resilient Is Better.

Read more about Ready Is Good. Resilient Is Better.
Thumbnail_5_MV_Blogs_2025

Recovery Testing: The Missing Piece in Most Cyber Resilience Programs

Read more about Recovery Testing: The Missing Piece in Most Cyber Resilience Programs
Urgent-Need-for-Cyber-Resilience

The Urgent Need for Cyber Resilience

Read more about The Urgent Need for Cyber Resilience
Thumbnail_Blog_Modern-Playbook-2025

Your Modern Playbook for Rapid Response and Clean Recovery

Read more about Your Modern Playbook for Rapid Response and Clean Recovery

Puntos clave

  • La gestión del acceso a los datos de Commvault, con tecnología de Satori, unifica la visibilidad, el control de acceso y la auditabilidad en datos estructurados, archivos no estructurados, SaaS y cargas de trabajo de IA.
  • Una política de acceso única y coherente puede regir tanto a los usuarios humanos como a los modelos de IA, lo que ayuda a reducir los silos y a limitar la sobreexposición de los datos sensibles.
  • La detección, clasificación y evaluación continua de riesgos ayudan a ofrecer información priorizada sobre dónde se encuentran los datos confidenciales y dónde es mayor el riesgo de exposición.
  • El enmascaramiento y la ocultación dinámicos basados en políticas ayudan a garantizar el acceso con el mínimo privilegio, lo que permite el uso autorizado de los datos y, al mismo tiempo, contribuye a proteger los campos confidenciales.
  • Los registros de auditoría centralizados y casi en tiempo real ofrecen una visibilidad completa de las consultas de los usuarios, las indicaciones de la IA y los eventos de acceso regulado, lo que ayuda a garantizar el cumplimiento normativo y la rendición de cuentas.

Ahora que la IA está integrada en todos los flujos de trabajo, desde copilotos y asistentes de chat hasta herramientas de análisis, todos estos dispositivos consumen datos sin parar. Las funciones de gobernanza del acceso a los datos de Commvault, con tecnología de Satori, están diseñadas para sacar más partido a esa IA tan ávida de datos, unificando la visibilidad, el control de acceso y la auditabilidad en todo tu entorno de datos.

Una base unificada para la gestión de datos en la era de la IA

Las funciones de gobernanza del acceso a los datos de Commvault agrupan las bases de datos estructuradas, los archivos no estructurados de SaaS y las cargas de trabajo de IA bajo un único modelo de gobernanza, en lugar de tratarlas como silos independientes. Ahora, las organizaciones pueden aplicar una única política de acceso tanto a los usuarios humanos como a los modelos de IA, de modo que las mismas reglas determinen quién o qué puede ver la información confidencial, independientemente de dónde se encuentre.

Al integrar Satori en el Commvault Command Center, estas capacidades amplían la protección tradicional de Commvault a los datos en tiempo real y al uso de la IA, y no solo a las copias de seguridad y las instantáneas. Esto ayuda a los equipos de seguridad y protección de datos a pasar de una respuesta reactiva ante incidentes a un control proactivo sobre cómo se detectan, se accede a ellos y se utilizan los datos en tiempo real.

Detección, clasificación y evaluación de riesgos continuas

Uno de los pilares fundamentales de nuestras capacidades de gobernanza de datos es la detección y clasificación unificadas de los datos en todas las nubes y SaaS. A medida que las organizaciones se conectan a entornos como AWS, Azure, Google Cloud, Snowflake, Databricks y otros, Commvault mapea automáticamente los almacenes de datos y los clasifica de forma continua, tanto si los datos son estructurados como no estructurados.

A cada activo se le asigna una puntuación de riesgo, lo que ofrece a los equipos una visión priorizada de dónde se encuentra la información sensible y dónde es más probable que haya exposición. En lugar de depender de análisis periódicos, la platform al movimiento de datos, a los nuevos almacenes y a los cambios de clasificación, lo que ayuda a los equipos a detectar problemas antes y a centrarse primero en las áreas de mayor riesgo.

Acceso con privilegios mínimos mediante enmascaramiento dinámico y censura

La protección de datos tradicional suele limitarse a saber dónde están los datos confidenciales; las funciones de Commvault se centran en controlar cómo se revelan esos datos. Mediante el enmascaramiento y la censura basados en políticas, las organizaciones pueden aplicar el principio del «privilegio mínimo», de modo que los usuarios, los servicios y los modelos de IA solo vean la información específica a la que tienen acceso, con los campos confidenciales anonimizados u ocultos según sea necesario.

Como se aplican las mismas políticas de enmascaramiento y ocultación en todos los entornos conectados, las organizaciones pueden proteger el acceso de forma coherente, en lugar de aplicar reglas fragmentadas, aplicación por aplicación. Esto ayuda a reducir el riesgo de sobreexposición de datos, es decir, cuando demasiadas personas o sistemas tienen acceso a más datos de los que realmente necesitan.

Seguridad y gestión rápida y segura

Una de sus capacidades más destacadas es la seguridad basada en IA y en políticas, que funciona a nivel de solicitud y respuesta. Antes incluso de que los datos se envíen a un modelo de IA, Commvault, con tecnología de Satori, puede interceptar la interacción, detectar campos sensibles (como datos personales sujetos a normativa) y aplicar el enmascaramiento o la censura en línea según las políticas de acceso a los datos existentes.

A diferencia de las soluciones que simplemente bloquean las indicaciones al completo o se basan únicamente en la prevención de pérdida de datos en las fases posteriores (con lo que la seguridad pasa a ser problema de otros), este enfoque permite a los empleados seguir utilizando los asistentes de IA de forma productiva, al tiempo que mantiene los datos confidenciales bajo control. Como la censura se produce antes de que el modelo procese los datos, también ayuda a evitar que la información confidencial influya o contamine los conjuntos de datos de entrenamiento de la IA, protegiendo tanto a los usuarios como al entorno de IA en general.

Los registros de auditoría centralizados facilitan el cumplimiento normativo

El último elemento de nuestras capacidades de gobernanza del acceso a los datos es un registro de auditoría completo y centralizado. Cada interacción —ya sea una consulta de un usuario, una solicitud de IA o un evento de acceso regulado— se registra con detalles como quién accedió a qué, qué política se aplicó y qué datos se ocultaron, casi en tiempo real.

Esta visibilidad unificada de las auditorías abarca datos en tiempo real, indicaciones de IA y eventos de gobernanza del acceso, lo que ofrece a los responsables de seguridad, TI y cumplimiento normativo un único registro fiable, en lugar de registros dispares procedentes de herramientas puntuales. Para los CISO y los CIO, esto se traduce en revisiones de cumplimiento más rápidas y una prueba clara de que la gobernanza no solo está documentada sobre el papel, sino que se aplica de forma activa en todo el entorno.

Ayudamos a las organizaciones a implementar la IA de forma segura

En conjunto, estas nuevas funciones ofrecen a las organizaciones una forma coherente de gestionar los datos en un mundo impulsado por la IA: visibilidad unificada en la nube, SaaS e IA; una única política para usuarios y modelos; enmascaramiento y censura dinámicos para un acceso con privilegios mínimos; y protección de las indicaciones de la IA basada en políticas y respaldada por registros de auditoría completos. El resultado es un cambio de los controles reactivos a una gobernanza proactiva del acceso a los datos preparada para la IA, lo que ayuda a los equipos a adoptar la innovación en IA sin perder el control sobre su información más sensible.

Preguntas frecuentes

P: ¿En qué se diferencia el enfoque de Commvault sobre la gobernanza de datos basada en la IA de la protección de datos tradicional?

R: La protección de datos tradicional suele centrarse en las copias de seguridad y la respuesta a incidentes una vez que se ha producido la exposición. Commvault amplía la gobernanza a los entornos en producción y a las interacciones con la IA, lo que permite un control proactivo sobre cómo se detectan, se accede a ellos y se utilizan los datos en tiempo real. Este cambio ayuda a las organizaciones a gestionar el riesgo antes de que se convierta en una violación de seguridad.

P: ¿Cómo mejora la seguridad el proceso unificado de detección y clasificación?

R: El descubrimiento y la clasificación continuos mapean y etiquetan automáticamente los datos estructurados y no estructurados en las nubes y las plataformas SaaS. Al asignar puntuaciones de riesgo a cada activo, los equipos obtienen una visión priorizada de la exposición de los datos sensibles. Esto permite identificar más rápidamente las áreas de alto riesgo y centrar mejor los esfuerzos de corrección.

P: ¿Qué es el enmascaramiento dinámico y por qué es importante para las cargas de trabajo de IA?

R: El enmascaramiento y la redacción dinámicos limitan lo que los usuarios, los servicios y los modelos de IA pueden ver en función de políticas predefinidas. Los campos sensibles pueden anonimizarse u ocultarse sin impedir el acceso legítimo a los datos relevantes. Este enfoque favorece la productividad al tiempo que ayuda a reducir el riesgo de sobreexposición.

P: ¿Cómo funciona la protección de las indicaciones de IA basada en políticas?

R: La seguridad de IA basada en políticas intercepta las solicitudes y las respuestas antes de que los datos lleguen al modelo de IA. Ayuda a detectar información confidencial y a aplicar el enmascaramiento o la supresión en línea de acuerdo con las políticas existentes. Esto permite a los empleados seguir utilizando herramientas de IA, al tiempo que contribuye a mantener los datos regulados bajo control y fuera de los conjuntos de datos de entrenamiento.

P: ¿Cómo ayudan los registros de auditoría centralizados a cumplir con la normativa?

R: El registro de auditoría exhaustivo recoge detalles sobre quién ha accedido a qué datos, qué políticas se han aplicado y qué censuras se han producido. Esta visibilidad unificada abarca tanto los datos en tiempo real como las interacciones con la IA, lo que ayuda a proporcionar a los responsables de seguridad y cumplimiento normativo un registro claro y fidedigno. Contribuye a agilizar las revisiones y a demostrar que los controles de gobernanza se aplican de forma activa.

P: ¿Cómo ayudan estas capacidades a las organizaciones a adoptar la IA de forma segura?

R: Al combinar una visibilidad unificada, una aplicación coherente de las políticas, el enmascaramiento dinámico y registros de auditoría completos, las capacidades de gobernanza de datos de Commvault ayudan a proporcionar a las organizaciones un marco coherente para gestionar los datos en la era de la IA. Estos controles fomentan la innovación al tiempo que ayudan a mantener el control sobre la información confidencial. El resultado es un camino más seguro y con mayor confianza hacia la adopción de la IA.

Nico Guerrera es director técnico sénior de marketing en Commvault.

More related posts


Social_Blog_Satori_GigaOm_Leader_2026_Linkedin

Satori Named Leader in GigaOm’s Data Access Governance Radar Report

Read more about Satori Named Leader in GigaOm’s Data Access Governance Radar Report
Thumbnail_Blog-Conversational-Resilience-2025-Linkedin

Conversational Resilience: The New Way to Manage and Protect Enterprise Data

Read more about Conversational Resilience: The New Way to Manage and Protect Enterprise Data
Thumbnail_Blog_Satori-Acquisition-2025

Commvault Closes Acquisition of Satori, Strengthening Data and AI Security Platform

Read more about Commvault Closes Acquisition of Satori, Strengthening Data and AI Security Platform
Thumbnail_Blog-Data-Rooms-2025-Linkedin

Data Activate: Unlocking the Power of Trusted Data for AI Innovation

Read more about Data Activate: Unlocking the Power of Trusted Data for AI Innovation

Puntos clave

  • La infraestructura de identidad es una superficie de ataque clave que, si se ve comprometida, puede paralizar las operaciones de la empresa.
  • La evaluación de vulnerabilidades de Commvault ayuda a detectar configuraciones erróneas y ajustes de riesgo mediante indicadores claros de exposición y recomendaciones para solucionarlos.
  • La auditoría en tiempo real permite a los equipos detectar cambios maliciosos sutiles en el momento en que se producen y rastrear la actividad de los atacantes en tiempo real.
  • La reversión con un solo clic puede ayudar a revertir rápidamente los cambios no autorizados, lo que contribuye a minimizar el tiempo de inactividad y a limitar la propagación del ataque.

La ciberseguridad y la importancia de la identidad

Cuando la mayoría de la gente piensa en ciberseguridad, se imagina archivos robados o bases de datos cifradas. Pero hay una capa subyacente a todo eso que, si se ve comprometida, hace que todo lo demás pierda importancia: tu infraestructura de identidad.​ Los sistemas de gestión de identidades como Active Directory (AD), Entra ID y Okta son los que deciden quién puede iniciar sesión, a qué puede acceder y si tu empresa puede funcionar en absoluto. Cuando los atacantes se cuelan ahí, los usuarios no pueden autenticarse, las aplicaciones dejan de funcionar y las operaciones se paralizan. En ese momento, ya no se trata de un problema de datos, sino de un problema de control.​ La recuperación automática de bosques mediante reconstrucciones limpias del sistema operativo permite a las organizaciones restaurar los sistemas de identidad de forma segura sin reintroducir amenazas. A continuación te explicamos cómo.

Descubre cuáles son tus puntos débiles antes de que los atacantes lo hagan

La evaluación de vulnerabilidades de Commvault asigna una puntuación de estado a su entorno de AD. Piense en ello como una calificación de «salud» para su directorio. La mayoría de los entornos están más expuestos de lo que la gente cree, y esto lo pone de manifiesto.​

Nuestra herramienta ayuda a detectar indicadores de exposición (IOE), que son errores de configuración específicos o ajustes de riesgo que podrían ser aprovechados. Un ejemplo habitual son las cuentas con contraseñas configuradas para que nunca caduquen. Las credenciales obsoletas y que no se renuevan son una de las formas más comunes en que los atacantes mantienen el acceso a largo plazo a un entorno.

Commvault no solo te avisa del problema, sino que te ayuda a identificar qué cuentas se ven afectadas, te guía paso a paso por los pasos para solucionarlo y te permite exportar la lista para que te resulte más fácil crear un script con la solución.

No te lo pierdas mientras está pasando

Conocer tus puntos débiles es el primer paso. Darte cuenta de cuándo alguien los está aprovechando activamente es el segundo paso. La auditoría de gestión de identidades de Commvault te ayuda a obtener un registro en tiempo real de cada cambio que se realiza en sistemas de identidades como Active Directory y Entra ID, con detalles como quién lo hizo, cuándo, desde dónde y cuáles eran los valores antes y después.

Los atacantes no suelen irrumpir a lo grande; más bien hacen cambios sutiles y específicos. Una cuenta comprometida podría crear un usuario de puerta trasera, añadirlo discretamente al grupo de administradores del dominio y, a continuación, vincular un objeto de política de grupo (GPO) malicioso diseñado para instalar ransomware, y cada uno de esos pasos aparece en el registro de auditoría.​

En cuanto detecte una cuenta sospechosa, el filtrado puede ayudarle a ver al instante todos los cambios que haya realizado esa cuenta, lo que le dará una visión completa de todo lo que el atacante haya manipulado.​

Repara el daño rápidamente

La detección solo sirve de algo si puedes actuar en consecuencia. Desde la misma vista de auditoría, puedes revertir un cambio malicioso con un solo clic, lo que te ayuda a restaurar el entorno a su último estado correcto conocido sin tener que cambiar de herramienta ni escribir un script personalizado. El objetivo es ayudar a minimizar el tiempo de inactividad y limitar el alcance del ataque antes de que se detecte.​

Cuando ocurre lo peor: la recuperación de los bosques

A veces un ataque logra colarse y tienes que volver a empezar desde cero. La recuperación del bosque de AD —es decir, reconstruir todo tu entorno de directorios tras un ataque de ransomware— es notoriamente compleja y suele implicar entre 50 y más de 100 pasos individuales, dependiendo del número de dominios y controladores de dominio que tengas.​

Commvault te ayuda a automatizar todo esto con guiones de ejecución coordinados que ordenan cada paso: reconstruir los controladores de dominio en el orden correcto según sus roles de operación de maestro único flexible (FSMO), restaurar SYSVOL, verificar los metadatos y restablecer la confianza entre dominios. Una vista de la topología de todo el bosque de AD te ayuda a ver claramente qué controladores de dominio deben volver a estar operativos primero.​

Lo más destacado aquí es lo que Commvault denomina «Clean OS Recovery» (Recuperación limpia del sistema operativo). En lugar de restaurar máquinas virtuales potencialmente comprometidas, reconstruye los controladores de dominio en máquinas virtuales completamente nuevas. Restaurar una máquina infectada conlleva el riesgo de que el malware vuelva a aparecer. Recuperar los datos en una infraestructura nueva significa que no solo recuperas tus datos, sino que, de hecho, empiezas de cero.​

Un único panel de control para entornos locales y Cloud

Hoy en día, la mayoría de las organizaciones no funcionan ni exclusivamente en sus propias instalaciones ni exclusivamente en la cloud, sino que son híbridas: Active Directory se encarga del acceso a los sistemas heredados y Entra ID, de las identidades modernas cloud. El plano de control unificado de Commvault te permite gestionar ambas cosas desde una única consola: evaluaciones, auditorías, detección y recuperación en ambas plataformas.​

El valor es claro: menos herramientas, menos complejidad y una explicación más sencilla que dar a la dirección cuando te pregunten cómo se protege la infraestructura de identidad de principio a fin.​ La resiliencia de la identidad merece un debate específico, al margen de las copias de seguridad y de la protección de los dispositivos finales. La combinación de análisis proactivo de vulnerabilidades, auditoría de cambios en tiempo real, reversión rápida y recuperación completa del bosque ayuda a tu organización a tratar la infraestructura de directorios como una prioridad de seguridad por derecho propio.

Preguntas frecuentes

P: ¿Por qué la infraestructura de identidad es un aspecto tan importante en materia de seguridad?

R: Los sistemas de identidad controlan la autenticación y el acceso en toda la organización. Si se ven comprometidos, los atacantes pueden paralizar por completo las operaciones, lo que hace que el resto de medidas de seguridad pierdan toda su relevancia.

P: ¿Qué son los indicadores de exposición (IOE)?

R: Los IOE son errores de configuración específicos o ajustes de riesgo en entornos de identidad que los atacantes pueden aprovechar. Detectarlos puede ayudarte a identificar los puntos débiles y orientar a los equipos sobre cómo solucionarlos.

P: ¿Cómo ayuda la auditoría en tiempo real a detener los ataques?

R: La auditoría en tiempo real permite hacer un seguimiento de todos los cambios que se producen en los sistemas de identidad, incluyendo quién los ha realizado y en qué han consistido. Esta visibilidad ayuda a los equipos de seguridad a detectar comportamientos sospechosos de forma temprana e investigar el alcance total de un ataque.

P: ¿De verdad se pueden revertir rápidamente los cambios maliciosos?

R: Sí, Commvault permite revertir directamente los cambios no autorizados desde la misma interfaz. Esto ayuda a reducir el tiempo de respuesta y a restaurar los sistemas a un estado seguro sin necesidad de scripts complicados.

P: ¿Por qué es tan complicado recuperar un bosque de AD?

R: La reconstrucción de un bosque de Active Directory implica muchos pasos que dependen unos de otros, como restaurar los controladores de dominio y restablecer las relaciones de confianza. La complejidad aumenta según el tamaño del entorno.

P: ¿Qué es la función «Clean OS Recovery» de Commvault y por qué es importante?

R: Clean OS Recovery ayuda a reconstruir los controladores de dominio en sistemas nuevos y no infectados, en lugar de restaurar los equipos infectados. Este enfoque ayuda a eliminar el malware residual y puede contribuir a una recuperación segura.

Nico Guerrera es director técnico sénior de marketing en Commvault.

More related posts


Thumbnail_Blog-Okta-Early-Access-2026

Commvault® Extends Identity Resilience to Okta

Read more about Commvault® Extends Identity Resilience to Okta
Thumbnail_Blog-Lateral-Access-2026

Staying Resilient Against Lateral Access Exploits

Read more about Staying Resilient Against Lateral Access Exploits
Thumbnail_Blog-Linkedin 1

Security Best Practices

Read more about Security Best Practices

Puntos clave

  • Gestionar backup la recuperación como «Infraestructura como código» (IaC) ayuda a reducir las desviaciones en la configuración y a adaptar la protección de datos a las prácticas modernas cloud .
  • El proveedor de Clumio para Terraform permite definir cuentas, políticas y reglas de protección de AWS de forma declarativa y con control de versiones.
  • La protección basada en etiquetas está diseñada para proteger automáticamente los recursos actuales y futuros, lo que ayuda a reducir la intervención manual y a escalar de forma eficiente en todos los entornos.
  • Definir backup en Terraform ayuda a mejorar la visibilidad, la reproducibilidad y la gobernanza a través de flujos de trabajo estándar de pull requests.
  • Este enfoque puede resultar especialmente útil para entornos de AWS con varias cuentas y para organizaciones que ya utilizan Terraform de forma sistemática.

Cloud se define cada vez más como código. Las instancias de EC2, los roles de gestión de identidades y accesos (IAM), las nubes privadas virtuales y las bases de datos se alojan ahora en repositorios con control de versiones y se implementan de forma predecible mediante IaC. Sin embargo, las políticas de Backup and Recovery a menudo siguen configurándose manualmente en consolas web. Esa brecha genera riesgos. Cuando la infraestructura es declarativa pero la protección de datos no lo es, los equipos corren el riesgo de:

  • Desviación en la configuración.
  • La protección varía según las cuentas.
  • Errores manuales.
  • Hay poca claridad sobre qué es lo que realmente está protegido.

Para las organizaciones que ya usan Terraform, backup la recuperación deberían gestionarse igual que el resto de la pila: mediante código. El proveedor de Terraform de Clumio permite definir la protección de datos de AWS de forma declarativa junto con la infraestructura. Puedes explorar el proveedor y su documentación aquí: https://registry.terraform.io/providers/clumio-code/clumio/latest/docs/guides/getting_started. En esta entrada, vamos a ver cómo automatizar la protección de las cargas de trabajo de AWS usando Terraform y Clumio de Commvault, y por qué este enfoque se adapta mejor a cloud modernos.

El problema de la configuración de las copias de seguridad a través de la consola

En una configuración tradicional, para proteger los recursos de AWS hay que:

  • Conectar cuentas de AWS.
  • Configurar la protección por separado en varios servicios de AWS.
  • Crear backup .
  • Definición de las reglas de protección.
  • Asignar recursos manualmente.
  • Repite ese proceso para cada cuenta o entorno.

Incluso en entornos bien gestionados, esto da lugar a:

  • Configuración manual repetitiva.
  • Aplicación inconsistente de las políticas.
  • Protección diferida para los recursos recién creados.
  • Control de versiones limitado.

Terraform ya ayuda a resolver este problema en lo que respecta a la infraestructura. El proveedor de Clumio para Terraform amplía ese modelo al ámbito de la protección de datos.

De cero a la protección: usando cuatro archivos

La protección de varios servicios de AWS se puede configurar mediante un pequeño conjunto de archivos de Terraform, en lugar de una secuencia de pasos manuales en la interfaz de usuario.

La configuración sigue una estructura sencilla.

  1. Definir proveedores (AWS + Clumio)

El primer paso es declarar los proveedores. Terraform necesita saber:

  • Estás usando AWS.
  • Estás utilizando el proveedor Clumio.

Esto conecta Terraform con ambas plataformas. La documentación oficial del proveedor explica este proceso de configuración con todo detalle en la guía de introducción.

  1. Conectar cuentas de AWS a Clumio

A continuación, el módulo de Clumio establece la conexión entre AWS y Clumio. Esto elimina la necesidad de configurar manualmente los roles de IAM necesarios para la protección de datos. En lugar de configurar manualmente los roles y los permisos, el módulo se encarga de la integración de forma sistemática. El código fuente del proveedor está disponible públicamente en GitHub. Esto significa que tu integración está definida en código, está sujeta a control de versiones y es reproducible en todos los entornos.

  1. Definir políticas de copia de seguridad como código

La definición de políticas de copias de seguridad es donde la IaC destaca. En una configuración basada en Terraform:

  • Se pueden establecer distintos objetivos de punto de recuperación para los distintos tipos de recursos.
  • Se pueden definir varios niveles de retención dentro de la misma política (por ejemplo, retención a corto y largo plazo).
  • Esa misma política se puede aplicar automáticamente según unas condiciones definidas.

En lugar de tener que manejar varias consolas, una única configuración de Terraform define la frecuencia, el periodo de retención y el alcance de los recursos. Esa política se puede reutilizar y revisar como cualquier otra configuración de infraestructura.

  1. Protección automática basada en etiquetas

Uno de los elementos más escalables de este enfoque es la protección basada en etiquetas. Se puede configurar una regla de protección para que proteja automáticamente cualquier recurso etiquetado con un par clave/valor específico. Por ejemplo: created_by = demo_script Esto significa que:

  • Los recursos existentes que coinciden con la etiqueta están protegidos.
  • Los recursos futuros con esa etiqueta se incluyen automáticamente.
  • No hace falta intervenir manualmente.

En el caso concreto de S3, los grupos de protección también usan etiquetas para gestionar cientos de buckets como una única unidad lógica, lo que permite aplicar cambios centralizados en las políticas a gran escala. Esto ayuda a reducir las desviaciones en la configuración.

Aplicar la configuración

Una vez definido, Terraform inicializa el directorio de trabajo, muestra una vista previa de los cambios previstos y aplica la configuración. Terraform está diseñado para respetar las dependencias entre los recursos, creándolos en el orden correcto. La configuración te ayuda a conectar cuentas de AWS, activar políticas, aplicar reglas de protección y proteger los recursos etiquetados. Y lo más importante: toda la estrategia de protección está plasmada en código con control de versiones.

¿Por qué es importante esto para Cloud ?

Para los equipos que trabajan según los principios de IaC, backup debería seguir la misma disciplina que el aprovisionamiento de la infraestructura. Definir backup Terraform ofrece varias ventajas prácticas:

  • Control de versiones: Las políticas de copias de seguridad se definen en el código y se pueden revisar, versionar y aprobar mediante flujos de trabajo estándar de solicitudes de incorporación de cambios.
  • Reproducibilidad: La misma configuración se puede implementar de forma coherente en las cuentas de desarrollo, de prueba y de producción.
  • Menor desviación: las configuraciones de Terraform se pueden volver a aplicar para garantizar que se respete el estado declarado, lo que ayuda a que los cambios manuales o realizados fuera de la cadena de comandos vuelvan a ajustarse a la configuración prevista.
  • Visibilidad clara: la lógica de protección se ve en el código, en lugar de estar oculta en la configuración de la interfaz de usuario.
  • Separación entre la configuración y la interfaz: la postura de copia de seguridad se define de forma declarativa, sin depender del estado de la consola.

Cuándo tiene sentido este enfoque

Automatizar backup Terraform resulta especialmente útil para:

  • Entornos de AWS con varias cuentas.
  • Sectores regulados que requieren una configuración auditable.
  • Platform que gestionan la infraestructura compartida.
  • Organizaciones que ya han adoptado Terraform como estándar.

Si tu infraestructura está definida como código, tu estrategia de protección de datos también debería estarlo.

Cómo empezar

Para profundizar en este enfoque:

También puedes probar Clumio a través de AWS Marketplace.

Preguntas frecuentes

P: ¿Por qué hay que gestionar backup como código?

R: Cuando la infraestructura se define como código, pero backup se configuran manualmente, pueden surgir lagunas e incoherencias. Gestionar backup código ayuda a alinear la protección con los flujos de trabajo de implementación, a reducir los errores manuales y a ofrecer una visibilidad controlada por versiones de tu estrategia de protección de datos.

P: ¿Qué te permite el proveedor de Clumio para Terraform?

R: El proveedor de Clumio para Terraform permite definir de forma declarativa los recursos de protección de datos de AWS, como las conexiones a cuentas, backup y las reglas de protección. Esto ayuda a los equipos a gestionar backup junto con la infraestructura en el mismo flujo de trabajo de Terraform.

P: ¿Cómo mejora la protección basada en etiquetas la escalabilidad?

R: La protección basada en etiquetas está diseñada para aplicar automáticamente políticas a cualquier recurso que coincida con un par clave/valor específico. Esto ayuda a proteger los recursos actuales y futuros sin necesidad de asignarlos manualmente, lo que facilita la gestión de la protección a gran escala en todas las cuentas y servicios.

P: ¿Cómo ayuda Terraform a reducir las desviaciones de configuración en backup ?

R: Terraform mantiene un estado definido para la infraestructura y las políticas de seguridad. Volver a aplicar las configuraciones ayuda a que los cambios manuales o realizados fuera de la cadena de comandos vuelvan a ajustarse al estado deseado, lo que contribuye a mejorar la coherencia entre los distintos entornos.

P: ¿En qué situaciones tiene más sentido automatizar backup Terraform?

R: Este enfoque resulta especialmente útil en entornos de AWS con varias cuentas, en sectores regulados que requieren configuraciones auditables, en platform que gestionan servicios compartidos y en organizaciones que ya utilizan Terraform como estándar para la infraestructura como código (IaC).

P: ¿Cómo pueden los equipos empezar a utilizar la protección de datos de AWS basada en Terraform?

R: Los equipos pueden empezar por consultar la documentación del proveedor de Clumio para Terraform, echar un vistazo al código fuente del proveedor en GitHub y ver la demostración de «Inicio rápido». Otro paso práctico es probar Clumio a través de AWS Marketplace.

Lawrence Chang es el director de ingeniería de Clumio y Vir Choksi es director principal de marketing de producto en Commvault.

More related posts


Thumbnail_Blog-GoogleWorkspace-2026

How the Move to Clumio Delivered 66.7% Savings on AWS Backups

Read more about How the Move to Clumio Delivered 66.7% Savings on AWS Backups
Thumbnail_Blog_AWS-Marketplace-AI

Commvault Featured in New AI Agent Solutions in AWS Marketplace

Read more about Commvault Featured in New AI Agent Solutions in AWS Marketplace
Man-and-woman-working-on-laptops-profile-Crocus-Thumbnail

Protecting Your Amazon S3 Data with Clumio: A Comprehensive Solution

Read more about Protecting Your Amazon S3 Data with Clumio: A Comprehensive Solution
Zz05MThhZTc3NmU0MTQxMWVmYTYwZWJlYTg2ZTllNjQ5Yw

A Blueprint for Effective Cloud Recovery

Read more about A Blueprint for Effective Cloud Recovery

Clumio

Read more about Clumio

Todas las organizaciones que han fracasado alguna vez en un proceso de recuperación —y hay más de las que nadie reconoce públicamente— tenían una cosa en común: creían que podían recuperarse antes incluso de intentarlo.

Esa creencia provenía de algún sitio. Un ejercicio de simulación completado. Un sistema de copia de seguridad que mostraba un estado «verde». Una prueba anual de recuperación ante desastres que se superó. Todo ello documentado. Todo ello, en algún momento, correcto. Nada de ello actualizado cuando el incidente se produjo realmente. Esto es lo que se conoce como «brecha de confianza». Y es precisamente esa brecha la que la validación continua de la recuperación pretende cerrar.

Qué significa realmente «pruebas» en la mayoría de las organizaciones

Si le preguntas a la mayoría de los responsables de seguridad o de TI con qué frecuencia comprueban su capacidad de recuperación, la respuesta suele ser «una vez al año», a veces «dos veces al año». La prueba consiste en restaurar un subconjunto de sistemas a partir de backup un entorno de pruebas, comprobar que se inician correctamente y elaborar un informe. A veces se realiza también un ejercicio de simulación junto con ello. Lo que este tipo de pruebas no hace: validar que los datos de la copia de seguridad estén libres de malware. Confirmar que la secuencia de recuperación funciona para servicios interdependientes. Probar la recuperación de identidades, algo esencial cuando el ataque se ha producido a raíz de credenciales comprometidas. Confirmar que el equipo que llevaría a cabo la recuperación conoce los manuales de procedimientos actuales. Ni aportar pruebas lo suficientemente significativas como para convencer a un regulador, un auditor o un consejo de administración de que la capacidad de recuperación es real y está al día. En resumen, valida un momento concreto. Las operaciones de resiliencia (ResOps) requieren que la validación sea un estado continuo.

El modelo de validación continua

La validación continua de la recuperación no consiste simplemente en realizar una misma prueba con más frecuencia. Se trata de un conjunto de prácticas integradas que proporcionan una demostración continua y basada en pruebas de la capacidad de recuperación de los servicios críticos. Análisis automatizado de la integridad de las copias de seguridad. Cada copia de seguridad se evalúa continuamente en busca de anomalías, patrones de cifrado y firmas de malware. No en el momento de la restauración, sino antes de la misma. El objetivo es saber si los puntos de recuperación están limpios antes de que se necesiten, no durante un incidente.

Cleanroom Recovery programados Cleanroom Recovery ». Como mínimo dos veces al año, restaurando desde backup inmutables a un Cleanroom Recovery aislado Cleanroom Recovery » —ni en producción, ni en un entorno de pruebas adyacente a producción, sino en un espacio realmente aislado donde se pueda realizar un análisis forense sin riesgo de reinfección—. Estos simulacros proporcionan pruebas documentadas de la capacidad de recuperación frente a los niveles de impacto definidos.

Validación de la recuperación de la identidad. Dado que el uso indebido de credenciales es el vector de ataque más habitual, hay que probar la recuperación de Active Directory y Entra ID junto con la recuperación de datos. Las organizaciones que restauren los sistemas sin restaurar primero una capa de identidad que se haya comprobado que está limpia pueden encontrarse con que los atacantes vuelvan a entrar por la misma puerta.

Cuadros de mando del Indicador de Resiliencia del Servicio (SRI). Los SRI —señales continuas extraídas de backup , los mapas de dependencias y los resultados de las pruebas— ofrecen a los CISO, los CIO y los consejos de administración una visión en tiempo real del estado de la capacidad de recuperación. No es un informe puntual, sino una señal operativa continua.

Cada una de estas prácticas contribuye a lo que Deloitte y Commvault denominan «resilience backlog»: una lista priorizada y actualizada constantemente de las deficiencias identificadas mediante pruebas y cuyo seguimiento se realiza hasta su resolución. Es el mecanismo por el que la validación impulsa la mejora, en lugar de limitarse a generar informes.

¿Qué significa el «tiempo medio hasta la recuperación de la limpieza»?

Las métricas de recuperación tradicionales —el objetivo de tiempo de recuperación (RTO) y el objetivo de punto de recuperación (RPO)— miden la velocidad y la actualidad de los datos. No dicen nada sobre si se puede confiar en los datos que se están restaurando. El tiempo medio de recuperación limpia (MTCR) cubre esa laguna: mide el tiempo necesario para restaurar datos que sean verificablemente limpios, no solo técnicamente disponibles.

El MTCR es importante porque, en un incidente de ransomware, el objetivo del atacante suele ser corromper las opciones de recuperación, no solo cifrar los sistemas de producción. Una organización que se recupera rápidamente, pero lo hace a partir de una backup comprometida, no backup recuperado realmente. Se ha vuelto a infectar.

Incorporar el MTCR a tu marco de medición de la resiliencia, junto con el RTO y el RPO, cambia los aspectos que optimizas y lo que comunicas al consejo de administración. Rapidez, actualidad e integridad: ese es el panorama completo de la preparación para la recuperación.

Resiliencia que puedes demostrar

Las organizaciones que superan las interrupciones cibernéticas con el menor daño posible comparten una característica: consideran que la capacidad de recuperación es algo que hay que demostrar continuamente, no algo que se afirme de vez en cuando. Conocen su MTCR. Sus SRI están al día. cleanroom sus cleanroom se ha probado en los últimos 90 días. Esa postura no es solo el resultado de una mejor tecnología. Es el resultado de una disciplina operativa —ResOps— que hace que la resiliencia sea continua, medible y gestionable. La plataforma de Commvault proporciona la base técnica: Recovery limpio, validación automatizada y la visibilidad unificada de datos, identidades y servicios que ResOps requiere a gran escala.

En cuanto al aspecto organizativo de esa ecuación —cómo definir las tolerancias de impacto, alinear a la dirección ejecutiva y construir la estructura de gobernanza que sustente la disciplina—, consulta el blog complementario de Deloitte, «La conversación sobre resiliencia que tu consejo de administración aún no está manteniendo». Y para conocer el marco completo de ResOps, incluidos los seis ámbitos de ResOps y el modelo de medición que vincula la recuperabilidad técnica con la responsabilidad a nivel del consejo de administración, lea el informe técnico conjunto: «De la viabilidad mínima a la resiliencia operativa: ResOps en la práctica».

Bill O’Connell es director de seguridad de Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

cloud suponía quecloud noscloud a dar flexibilidad, además de:

  • Servicios de primera categoría.
  • Innovación Cloud.
  • Sin dependencia de un proveedor concreto.

Pero cuando se produce un incidente cibernético, esa flexibilidad suele convertirse en complejidad. En este episodio de STRIVE, me senté a charlar con Akshay Joshi, director sénior de gestión de productos —cuya trayectoria profesional abarca IBM, AWS, Microsoft, Clumio y, ahora, Commvault— para analizar una verdad incómoda: la mayoría de las empresas creen que están preparadas paracloud. Hasta que se dan cuenta de que no es así. Mira el episodio completo.

Puntos clave: Lo que realmente exigeCloud

  • Hacer una copia de seguridad a nivel de servicio no es lo mismo que recuperar a nivel de aplicación. Proteger fuentes de datos individuales no es lo mismo que restaurar un ecosistema de aplicaciones sincronizadas.
  • La complejidad de la recuperación se multiplica cuando hay varias nubes de por medio. Diferentes puntos de recuperación, diferentes cuentas, diferentes equipos de administración… cada uno de ellos supone un obstáculo cuando el tiempo es lo más importante.
  • Las herramientas nativas de los hiperescaladores son necesarias, pero no suficientes. Protegen dentro de su propia cloud no coordinan las operaciones entre nubes.
  • El aislamiento es la primera ficha de dominó en un incidente cibernético. Cuanto más amplio sea el alcance del entorno, más difícil resulta contener el impacto.
  • La resiliencia hay que integrarla desde el principio, no añadirla después. El mapeo de dependencias y la planificación de la recuperación deberían empezar ya en la fase de diseño de la aplicación, no después de su implementación.
  • La automatización basada en IA aporta más potencia… pero también nuevos riesgos. Los flujos de trabajo basados en Agentic requieren controles de permisos estrictos y una gestión rigurosa.

La diferencia entre lo que dice el papel y la realidad

Sobre el papel, la recuperación parece sencilla: ¿Hasta qué punto te recuperas? ¿Qué es lo que recuperas? ¿Dónde lo recuperas? Pero, como explica Akshay, cada una de esas preguntas se complica en un mundo multicloud. Los distintos servicios pueden tener diferentes puntos de Recovery. Algunos microservicios pueden verse afectados, mientras que otros no. Recovery puede requerir un rediseño de la arquitectura si se restaura entre regiones o entre cuentas.

Lo que parece sencillo en la documentación se vuelve tremendamente complejo a la hora de ponerlo en práctica. Y cuando te ataca un ransomware, los equipos no se ponen a consultar tranquilamente los manuales de actuación, sino que se ponen como locos.

La primera ficha de dominó: el aislamiento

Cada vector de amenaza crece proporcionalmente a la complejidad del entorno.cloud solo diversifica la infraestructura, sino que amplía el alcance operativo.

Copia de seguridad a nivel de servicio frente a recuperación a nivel de aplicación

Aquí es donde la mayoría de las organizaciones se quedan atascadas. Lo respaldan:

  • Datos de Azure con Azure Backup
  • Datos de AWS con AWS Backup
  • Cloud de Google Cloud con una herramienta independiente

Por separado, cada servicio puede estar protegido. En conjunto, puede que no sea posible recuperar la aplicación en un estado sincronizado. Las herramientas nativas no se comunican entre distintas nubes. No están diseñadas de por sícloud entornoscloud . Tampoco están optimizadas para mejorar el tiempo objetivo de recuperación (RTO) ni el punto objetivo de recuperación (RPO) a gran escala encloud .

Y cuando la recuperación depende de coordinar varias fuentes de datos entre distintos hiperescaladores, la orquestación marca la diferencia entre horas y días. Por eso precisamente existen las estrategias de recuperación unificadas: no para sustituir a los hiperescaladores, sino para coordinarlos.

El mapeo de dependencias ya no es opcional

Llevamos más de una década hablando del mapeo de dependencias de las aplicaciones. Pero en un mundo multinube, ya no es algo «que estaría bien tener». Las aplicaciones abarcan ahora múltiples hiperescaladores, múltiples equipos de DevOps, múltiples dominios de administración y múltiples herramientas de copia de seguridad de distintos proveedores.

La fragmentación de la responsabilidad ralentiza la Recovery. La fragmentación de los proveedores complica la orquestación. Los silos operativos provocan retrasos en el peor momento posible. La resiliencia debe integrarse desde el principio, no añadirse a posteriori tras la implementación.

Avance: Por qué fallaCloud sin un mapa de dependencias

En este fragmento de la charla de STRIVE, Akshay explica por qué es fundamental poner en práctica la resiliencia ya en la fase de diseño para poder sobrevivir a los ciberataques del mundo real.

Diseñar pensando en la recuperación, no solo en la protección

Uno de los puntos más importantes de este episodio: las aplicaciones modernas no solo deben diseñarse pensando en el rendimiento y la escalabilidad, sino también en la capacidad de recuperación. Eso significa que:

  • Estoy pensando tanto en el RTO como en el RPO.
  • Diseñar teniendo en cuentacloud .
  • Consolidar la visibilidad siempre que sea posible.
  • Reducir la fragmentación de proveedores y tareas administrativas.
  • Comprobación de la recuperación en distintos entornos.

La velocidad de Recovery afecta a los ingresos. La claridad en Recovery afecta a la reputación. El tiempo de inactividad afecta a la confianza de los clientes. La innovación multicloud debe ir acompañada de una disciplina de Recovery multicloud.

La capa de IA y automatización

Ningún debate está completo sin abordar la IA. Los flujos de trabajo basados en agentes están cada vez más integrados en las plataformas SaaS empresariales. Pero la automatización plantea nuevas consideraciones:

  • ¿Qué permisos tienen los agentes?
  • ¿Con qué frecuencia se activan las copias de seguridad?
  • ¿Qué repercusiones económicas tienen las decisiones sobre automatización?
  • ¿Se consideran los agentes como identidades con acceso regulado?

La IA puede potenciar la resiliencia, pero sin medidas de control, también puede aumentar el riesgo. La clave está en delegar de forma controlada.

¿Por qué tuvimos esta conversación en STRIVE?

STRIVE no consiste en repetir lo que todo el mundo ya sabe. Se trata de abordar las carencias que surgen durante los incidentes cibernéticos del mundo real. La adopción de la multinube no se está ralentizando. Pero, a menos que las estrategias de Recovery evolucionen al mismo ritmo que la arquitectura, la complejidad superará a la preparación.

Por eso es importante este debate. Y por eso hemos invitado a Akshay, alguien que ha trabajado con varios hiperescaladores y conoce tanto su potencial como sus limitaciones.

Mira el episodio completo

En el episodio completo de STRIVE, descubrirás:

  • La diferencia real entre backup a nivel de servicio backup la recuperación a nivel de aplicación.
  • Por qué el aislamiento es la primera ficha de dominó en los ataques de ransomware.
  • Cómo la fragmentación de los proveedores complica la orquestación.
  • En qué deben ponerse de acuerdo los CISO y los responsables de DevOps.
  • Cómo cambia la IA la ecuación de la resiliencia.

Ver ahora. Si utilizas AWS, Azure o Google Cloud esta conversación es imprescindible.

Preguntas frecuentes

P: ¿Por qué no backup nativa de los hiperescaladores?

R: Las herramientas nativas protegen los datos dentro de una cloud concreta, cloud no coordinan la recuperación entre distintas nubes.cloud requieren una restauración coordinada entre servicios y proveedores.

P: ¿Cuál es la mayor carencia encloud ?

R: La discrepancia entre cómo se hacen las copias de seguridad (servicio por servicio) y cómo debe llevarse a cabo la recuperación (a nivel de toda la aplicación).

P: ¿Qué significa «apertura ambiental»?

R: Se refiere a la variedad de cuentas, nubes, identidades y servicios que hay en un entorno. A medida que se amplía el alcance, el riesgo y la complejidad aumentan proporcionalmente.

P: ¿Por qué es tan importante la asignación de dependencias?

R: Las aplicaciones ahora abarcan varias nubes y equipos. Si no se identifican las dependencias de los servicios, la secuencia de recuperación se convierte en una cuestión de conjeturas.

P: ¿Cómo influye la IA en la recuperación ante desastres?

R: Los flujos de trabajo basados en IA pueden ayudar a automatizar las decisiones backup recuperación, pero requieren controles de acceso estrictos, gestión de costes y supervisión.

P: ¿Por dónde deberían empezar las organizaciones para mejorarcloud ?

R: Empiece por evaluar:

    • Alineación de la recuperación a nivel de aplicación.
    • Oportunidades de consolidación de proveedores.
    • Sincronización entre equipos.
    • Estrategia de aislamiento durante los incidentes.
    • Frecuenciacloud .

Chris Mierzwa es director sénior de marketing de cartera en Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos Clave

  • Commvault Edge Docking for SaaS convertir la implementación en el borde en un proceso centralizado y cloud que se gestiona desde una única consola. Commvault Edge se conocía antes como HyperScale Edge.
  • La configuración automatizada y el aprovisionamiento mediante API ayudan a reducir el tiempo de implementación a unos pocos minutos en todas las sedes distribuidas.
  • Los flujos de trabajo estandarizados ayudan a mejorar la coherencia, la seguridad de los datos y la escalabilidad en los entornos periféricos.
  • SaaS continua SaaS permite realizar actualizaciones, mantenimiento y optimización de forma constante sin necesidad de intervención manual.
  • Las funciones de seguridad integradas, como las copias de seguridad inmutables y la arquitectura de confianza cero, ayudan a reforzar la protección frente a las amenazas en constante evolución.

La implementación de la protección de datos en el perímetro no debería requerir una configuración manual en cada sede. Con Commvault Edge Docking for SaaS, Commvault transforma la implementación en el perímetro en una experiencia optimizada y basada en la nube. Combina la potencia de Commvault Edge con el control centralizado del plano de gestión de SaaS.

Reducir la complejidad del despliegue en el borde

Los entornos de borde están en pleno auge. IDC prevé que el gasto en TI de borde alcanzará los 380 mil millones de dólares en 2028. Las empresas están acercando la capacidad de cálculo a los datos —tiendas, sucursales, plantas de fabricación, centros sanitarios—, y cada uno de estos lugares genera y almacena información crítica que hay que proteger.

El proceso actual de configuración en el perímetro consume muchos recursos, ya que requiere acceso físico y pasos de configuración que llevan mucho tiempo. Esto alarga los plazos de implementación y aumenta los costes operativos al ampliar la escala a múltiples emplazamientos. Lo que debería llevar unos minutos puede prolongarse durante un periodo de tiempo considerable y generar una complejidad potencial. Y mientras las organizaciones se enfrentan a las dificultades logísticas de la implementación, los datos críticos del perímetro permanecen desprotegidos o se copian de forma inconsistente en las distintas ubicaciones distribuidas.

Las amenazas no esperan. Verizon ha constatado un aumento de las brechas de seguridad que aprovechan los dispositivos periféricos, y cada sitio desprotegido supone un posible punto de entrada para el ransomware, el robo de datos y la interrupción de la actividad empresarial.

SaaS para Commvault Edge

Commvault está contribuyendo a transformar la implementación en el perímetro con la integración SaaS para Commvault Edge (anteriormente HyperScale Edge), una funcionalidad que aporta la velocidad y la simplicidad propias de la nube a la protección local. Desde el Command Center, los equipos de TI pueden configurar, implementar y gestionar todos los sistemas Commvault Edge a través de una única consola SaaS. Se trata de un panel único que facilita la gestión de cargas de trabajo híbridas y nativas de la nube en todos los emplazamientos, dispositivos y cargas de trabajo.

Los nuevos sistemas siguen un flujo de trabajo de configuración guiado y estandarizado que permite una configuración protegida y coherente desde el primer día. Una vez encendido, cada sistema se conecta automáticamente a Commvault SaaS, valida su configuración, se registra en la plataforma y comienza la instalación. Esto ayuda a minimizar la configuración en el propio dispositivo y a reducir el esfuerzo operativo necesario para el despliegue a gran escala. En el caso de implementaciones a gran escala, la automatización basada en la API de Commvault permite integrar rápidamente varios sistemas a la vez, lo que facilita una implementación repetible en distintos centros y regiones.

Una vez desplegados los sistemas, el Command Center global proporciona una gestión unificada en todas las ubicaciones. Cada sistema Commvault Edge permanece conectado a Commvault SaaS para recibir actualizaciones periódicas, mantenimiento y optimización. Desde esta única plataforma, puedes desplegar, aplicar parches, escalar y mantener cada sistema con confianza. Despliega más rápido. Gestiona de forma más inteligente. Protege los datos en todas partes.

Creado para crecer, diseñado para ser sencillo

Commvault Edge Docking for SaaS está diseñado para ofrecer ventajas operativas cuantificables a los responsables de TI y seguridad: Aceleración del tiempo de retorno de la inversión: implemente nuevos sistemas periféricos más rápido sin necesidad de un aprovisionamiento manual, sitio por sitio. Visibilidad y gestión centralizadas: gestiona la configuración, supervisa el estado, implementa actualizaciones y adapta la infraestructura desde una única plataforma SaaS.

Menos gastos operativos: reduce la necesidad de configurar los dispositivos y agiliza los procesos de implementación, lo que ayuda a liberar recursos de TI para iniciativas de mayor valor. Implementación rápida y coherente: los flujos de trabajo estandarizados ayudan a reducir las desviaciones en la configuración, garantizan una seguridad de los datos y una aplicación de las políticas coherentes, y mejoran la fiabilidad en entornos distribuidos.

Seguridad de los datos desde el diseño: todos los sistemas se ejecutan en , la base nativa de Linux reforzada de Commvault. Es un sistema que permite una recuperación no solo rápida, sino también segura, con copias de seguridad locales inmutables, protección contra el ransomware en varias capas y una arquitectura de confianza cero.

¿Por qué es importante esto?

Las implementaciones tradicionales en el borde suelen tardar semanas o meses cuando se realizan a gran escala. Commvault Edge Docking for SaaS nuestro compromiso de ofrecer protección de datos híbrida con la rapidez y la sencillez del SaaS, lo que ayuda a reducir los costes operativos, eliminar los cuellos de botella en la implementación y acelerar el tiempo de retorno de la inversión. Pero la velocidad no es la única ventaja. La coherencia también es importante. Cuando cada sitio se implementa con la misma base de referencia protegida, el cumplimiento normativo resulta más fácil de gestionar. La implementación automática de actualizaciones ayuda a mantener al día la postura de seguridad. Y cuando los flujos de trabajo de Recovery están diseñados para funcionar de la misma manera en todas partes, los equipos pueden responder con confianza incluso bajo presión. Así es como se ve la resiliencia unificada a gran escala en el perímetro: una protección que se implementa rápidamente, es fácil de gestionar y ayuda a garantizar una recuperación fiable en cientos o miles de ubicaciones distribuidas.

Míralo en acción

¿Estás listo para modernizar tu estrategia de implementación en el borde? Descubre más en nuestra página de Commvault Edge y reserva una demostración para ver Commvault Edge Docking for SaaS acción, o ponte en contacto con tu representante de Commvault para saber cómo SaaS puede transformar tu estrategia de resiliencia en el borde.

Preguntas frecuentes

P: ¿Qué es Commvault Edge Docking for SaaS?

R: Es una función de Commvault que ayuda a las organizaciones a implementar y gestionar los sistemas Commvault Edge a través de un plano SaaS centralizado. Este enfoque ayuda a simplificar la configuración, la implementación y las operaciones continuas en entornos distribuidos.

P: ¿Cómo reduce esta solución la complejidad de la implementación?

R: Ayuda a eliminar la necesidad de realizar configuraciones manuales en cada sitio gracias al uso de flujos de trabajo automatizados y un control centralizado. Los sistemas pueden configurarse automáticamente y conectarse a laplatform SaaS , lo que ayuda a reducir el tiempo y el esfuerzo necesarios para la puesta en marcha.

P: ¿Se puede escalar a múltiples ubicaciones?

R: Sí, la automatización basada en API permite integrar rápidamente varios sistemas a la vez. Esto la convierte en la solución ideal para organizaciones que gestionan cientos o miles de sitios periféricos.

P: ¿Qué características de seguridad incluye?

R: La solución funciona con VaultOS™, que incluye copias de seguridad inmutables, protección multicapa contra el ransomware y una arquitectura de confianza cero. Estas características ayudan a ofrecer una protección de datos más sólida y resistente en el perímetro.

P: ¿Cómo beneficia la gestión centralizada a los equipos de TI?

R: Los equipos de TI disponen de una única interfaz para supervisar, actualizar y gestionar todos los sistemas periféricos. Esto ayuda a mejorar la visibilidad, reducir los gastos operativos y mantener políticas coherentes en todos los entornos.

P: ¿Por qué es esto importante para los entornos de borde modernos?

R: A medida que crece la computación en el borde, los métodos de implementación tradicionales se vuelven demasiado lentos y consumen demasiados recursos. Esta solución permite una implementación rápida, una seguridad de datos constante y una recuperación fiable, lo que ayuda a las organizaciones a adaptarse al crecimiento y a gestionar los riesgos.

Justin Wolf es director sénior de producto y Chad Bersche es director de producto principal en Commvault.

Blogs relacionados

More related posts


Thumbnail_Blog_HPE-Active-Peer-Persistence-2024-_1_

A Powerful Partnership for the Future of Data Resilience

Read more about A Powerful Partnership for the Future of Data Resilience
Thumbnail_Blog_Commvault-Cloud-2025-Linkedin

Elevate Your Cyber Resilience with Commvault Cloud Enhancements

Read more about Elevate Your Cyber Resilience with Commvault Cloud Enhancements

La inteligencia artificial está redefiniendo lo que es posible para las empresas modernas: acelera la innovación, mejora la toma de decisiones y permite alcanzar nuevas eficiencias a gran escala. Detrás de cada conocimiento basado en la IA hay una realidad física, impulsada por la energía, la infraestructura y los datos.

A medida que crece el uso de la IA, también lo hace la necesidad de gestionar y proteger los datos de forma eficiente a gran escala. El futuro de la IA no vendrá determinado únicamente por la inteligencia, sino por la responsabilidad con la que se desarrolle y se mantenga esa inteligencia.

Tres factores clave que influyen en el impacto medioambiental

El impacto medioambiental de la IA tiene su origen en la infraestructura informática que la hace funcionar. El entrenamiento y la ejecución de modelos de IA requieren sistemas de alto rendimiento que consumen electricidad. Pero la intensidad computacional es solo una parte de la historia. La IA depende de enormes cantidades de datos, que se almacenan, se transfieren y se procesan entre distintos sistemas, y cada uno de ellos contribuye al consumo de recursos.

Todo esto se sustenta en los centros de datos, donde hay que alimentar y refrigerar los servidores. Los sistemas de refrigeración pueden suponer una parte importante del consumo energético, lo que convierte el diseño de la infraestructura de datos en un factor clave para la sostenibilidad de la IA. Por último, el impacto medioambiental de la IA depende de cómo se genere la electricidad: una misma carga de trabajo puede generar emisiones de carbono muy diferentes según la fuente de energía.

Frenemos la ineficiencia, no la innovación

La IA está creciendo rápidamente a medida que las organizaciones la implementan en todas sus funciones, generan más datos y amplían la infraestructura para seguir el ritmo. A menudo pasa desapercibida una ineficiencia clave: nunca se accede a la mitad de los datos de las empresas una vez almacenados.1 Las empresas pagan por almacenarlos sin obtener ningún valor de ellos. Aquí es donde la huella medioambiental de la IA puede aumentar, no a través de la innovación, sino a través de la ineficiencia. Para abordar esto, lo primero es tener una mayor visibilidad y control sobre los datos.

Datos más inteligentes: una potente herramienta para la sostenibilidad

Como la IA se basa en grandes conjuntos de datos, las empresas pueden ayudar a reducir el impacto medioambiental corrigiendo las prácticas ineficientes en el manejo de datos que generan cargas de trabajo innecesarias. Las soluciones de Commvault ofrecen varias funciones que ayudan a las empresas a gestionar y aprovechar los datos de forma eficiente:

  • Deduplicación para eliminar datos redundantes
  • Estructuración por niveles para adaptar el almacenamiento y el procesamiento a las necesidades de acceso
  • Compresión para reducir los requisitos de almacenamiento

Una gestión consciente de los datos ayuda a mejorar la eficiencia y a reducir el consumo de recursos.

Sostenibilidad y resiliencia: las dos caras de una misma estrategia

Los entornos de datos repletos de información redundante y desorganizada no solo consumen mucha energía, sino que también son más difíciles de proteger, gestionar y recuperar. La complejidad aumenta el riesgo y complica los planes de continuidad del negocio. Al ayudar a las organizaciones a gestionar, proteger y sacar partido a sus datos, Commvault contribuye a que los sistemas sean a la vez resilientes y sostenibles. Una gestión más inteligente de los datos puede ayudar a reducir el desperdicio, mejorar la eficiencia y reforzar la ciberresiliencia.

El camino a seguir

El futuro de la IA dependerá de las decisiones que tomen hoy las organizaciones. Los líderes en este ámbito:

  • Considera los datos como un activo estratégico, no solo como un volumen cada vez mayor
  • Diseña sistemas de IA teniendo en cuenta la eficiencia y la gestión del ciclo de vida
  • Incorporar la resiliencia en todos los niveles de sus operaciones

Con una gestión de datos más inteligente, una infraestructura optimizada y un diseño responsable, las organizaciones pueden reducir el impacto medioambiental de la IA, al tiempo que aprovechan todo su potencial. Menos residuos. Más resiliencia.


1 El estado de los datos ocultos

Aakanksha Kashyap es especialista en ESG en Commvault.
More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos clave:

  • Los ciberataques se dirigen cada vez más tanto a backup de producción como a backup , por lo que es fundamental contar con una recuperación limpia y verificable.
  • La detección integrada de anomalías y amenazas refuerza la resiliencia cibernética al identificar datos comprometidos, validar puntos de recuperación fiables y acelerar la restauración.
  • Cuando se integran en los flujos de trabajo de protección de datos, las funciones de detección de anomalías y amenazas pueden ayudar a proporcionar las pruebas necesarias para recuperarse de forma rápida, segura y con confianza.

Por qué la ciberresiliencia depende de la detección integrada de anomalías y amenazas

La detección de anomalías identifica comportamientos inusuales en los datos de copia de seguridad que pueden indicar un compromiso de seguridad. La detección de amenazas identifica actividades maliciosas conocidas mediante firmas, análisis heurístico y técnicas de escaneo. Juntas, ayudan a validar los puntos de Recovery y permiten una recuperación limpia de los datos. Durante años, los responsables de seguridad se han centrado en prevenir las brechas de seguridad. En la era actual, marcada por los ataques persistentes y las amenazas impulsadas por la inteligencia artificial, las organizaciones dan cada vez más por hecho que se producirá una brecha y diseñan sistemas capaces de resistir las interrupciones y recuperarse de forma segura cuando estas se produzcan.

Los adversarios modernos no siempre ocultan su presencia: la revelan cuando les conviene para alcanzar su objetivo. Los atacantes intentan infiltrarse en los entornos de forma sigilosa, observan los sistemas a lo largo del tiempo y se posicionan dentro de las infraestructuras críticas. El momento en que un ataque se hace visible rara vez es el momento en que empieza; es el momento en que el atacante decide actuar.

Para entonces, es posible que los datos comprometidos ya se hayan incorporado a backup . La detección integrada de anomalías y amenazas puede ayudar a las organizaciones a identificar backup que se han visto comprometidos, validar los puntos de recuperación no afectados y facilitar la recuperación tras un ciberataque. Para los equipos de seguridad y de TI, el reto ya no es solo detectar un ataque, sino predecir y gestionar el posible impacto que podría tener el atacante. La solución pasa por entender qué se ha visto afectado, qué sigue siendo fiable y cómo puede la organización recuperarse de forma segura sin que la interrupción del negocio se agrave.

Por eso, la ciberresiliencia se beneficia enormemente de la detección integrada de anomalías y amenazas. Cuando las capacidades de detección se integran en los flujos de trabajo de protección y recuperación de datos, ayudan a proporcionar la información compartida que los equipos necesitan para identificar los datos comprometidos, validar los puntos de recuperación fiables y orientar las decisiones de respuesta basándose en pruebas, en lugar de en conjeturas. Este enfoque se ajusta al modelo operativo ResOps™, que está en auge, en el que los equipos de seguridad, TI y recuperación trabajan partiendo de una visión global compartida y de rutas de recuperación validadas para responder juntos a los incidentes.

La nueva realidad: la recuperación requiere pruebas, no suposiciones

Las herramientas tradicionales de detección de amenazas se centran en detectar amenazas en el perímetro. Pero una vez que los atacantes están dentro, la visibilidad puede verse mermada y resulta complicado determinar qué sistemas y datos se han visto afectados. Además, los atacantes se centran cada vez más en los entornos de copia de seguridad con el objetivo específico de socavar la recuperación. Y en el momento en que las organizaciones no pueden demostrar con certeza que las copias de seguridad permanecen intactas, la sospecha se vuelve inevitable. El resultado es la incertidumbre. ¿Restaurar rápidamente y arriesgarse a una reinfección? ¿O retrasar la recuperación mientras se investiga qué copias siguen siendo fiables? Los equipos de TI se ven obligados a adivinar qué datos están a salvo mientras se acumula el tiempo de inactividad. Al integrar la inteligencia directamente en los flujos de trabajo de protección de datos, la detección de anomalías y amenazas ayuda a transformar la recuperación, pasando de ser una acción reactiva basada en conjeturas a un proceso disciplinado y basado en pruebas. Estas capacidades pueden ayudar a las organizaciones a identificar copias manipuladas, validar la integridad de los datos y recopilar los puntos de recuperación más recientes que no se hayan visto comprometidos, lo que te ayuda a acelerar la recuperación tras un ciberataque y a reducir el impacto operativo.

Detección de anomalías: tu primera señal de lo desconocido

La detección de anomalías actúa como un centinela que vela por la integridad de sus datos protegidos. Establece una línea de referencia del comportamiento normal —tamaños de archivo, patrones de crecimiento, cambios en la deduplicación, intentos de acceso— y alerta a los equipos cuando algo se desvía de esa norma. Estas desviaciones pueden revelar indicios de manipulación silenciosa mucho antes de que lo hagan las firmas de malware. En una era de amenazas novedosas y polimórficas, la detección de anomalías ayuda a ofrecer lo que las herramientas estáticas no pueden: visibilidad de lo inesperado.

Detección de amenazas: defensa específica contra actividades maliciosas conocidas

Mientras que las anomalías revelan lo que es inusual, la detección de amenazas pone de manifiesto lo que es malicioso. Al analizar directamente los datos protegidos en busca de ransomware, firmas de malware, patrones de cifrado e indicadores de compromiso (IoC) personalizados, la detección de amenazas ayuda a confirmar que los datos que proteges no se han visto comprometidos.

Por qué es importante un enfoque combinado

Ni la detección de anomalías ni la de amenazas por sí solas ofrecen una visión completa. Juntas, conforman una estrategia de defensa en profundidad: la detección de anomalías puede señalar señales sospechosas, mientras que la detección de amenazas puede profundizar más para verificar si hay intenciones maliciosas. Esta combinación ayuda a las organizaciones a distinguir las anomalías inofensivas de las verdaderas brechas de seguridad y a mantener datos fiables y validados para una recuperación rápida.

Afrontar los retos actuales con Commvault® Cloud

Los atacantes se centran cada vez más en backup , y el malware oculto en backup puede aumentar el riesgo de reinfección durante la recuperación. Las organizaciones necesitan una validación basada en datos para garantizar una recuperación limpia y segura.

Commvault Cloud resuelve esto combinando los flujos de trabajo de protección de datos con la detección de anomalías, la inteligencia sobre amenazas, los análisis basados en IA y las instancias aisladas y limpias. Al aplicar la información sobre anomalías y amenazas antes, durante y después de backup , Commvault puede ayudar a las organizaciones a recuperarse más rápido, de forma más limpia y con total confianza. Lee el informe técnico completo, «¿Puedes demostrar que eres recuperable ahora mismo?», para obtener más información.

Preguntas frecuentes

P: ¿Qué es la detección de anomalías en la protección de datos?

R: La detección de anomalías identifica comportamientos inusuales —como cambios inesperados backup o actividad anómala en los archivos— que pueden indicar manipulación, ransomware o amenazas emergentes en los datos protegidos.

P: ¿Por qué los CISO necesitan la detección de amenazas en sus backup ?

R: Los entornos de copia de seguridad se han convertido en uno de los principales objetivos de los atacantes. La detección de amenazas ayuda a evitar que las organizaciones almacenen o restauren datos comprometidos, lo que contribuye a reducir el riesgo de reinfección y a mejorar las posibilidades de una recuperación sin problemas.

P: ¿Cómo ayuda Commvault a garantizar una recuperación de datos sin errores?

R: Commvault utiliza análisis de amenazas asistido por IA, detección de cifrado, comparación personalizada de indicadores de compromiso (IoC) y técnicas de engaño cibernético para ayudar a validar backup y recopilar los datos más recientes que no hayan sido comprometidos, con el fin de garantizar una recuperación rápida.

P: ¿Por qué combinar la detección de anomalías y la detección de amenazas?

R: Las anomalías identifican lo desconocido; la detección de amenazas valida lo conocido. Juntas, ofrecen una visibilidad completa de las actividades sospechosas, lo que permite investigar más rápido y recuperar los datos con mayor seguridad.

Pauline List es directora de marketing de producto en Commvault

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos clave

  • Los modelos avanzados de IA, como Claude Mythos Preview, podrían acelerar enormemente la detección de vulnerabilidades, lo que cambiaría por completo el panorama de la ciberseguridad.
  • El proyecto Glasswing pone de relieve la creciente preocupación por la gestión a gran escala de los riesgos de seguridad relacionados con la inteligencia artificial.
  • ResOps ayuda a las organizaciones a pasar de una defensa reactiva a una resiliencia y recuperación proactivas.
  • Las herramientas de ciberseguridad se centran sobre todo en la prevención, mientras que las capacidades de recuperación siguen sin estar lo suficientemente desarrolladas.
  • En un mundo impulsado por la IA, la capacidad de recuperarse rápidamente ante cualquier contratiempo será clave para el éxito operativo.

Según se dice, el nuevo modelo «Claude Mythos Preview» de Anthropic es lo suficientemente potente como para identificar vulnerabilidades en sistemas de software en cuestión de segundos. La empresa afirma que, en las primeras pruebas, el modelo fue capaz de escapar de su entorno de contención y enviar un correo electrónico a un ingeniero para informarle del incidente.

Teniendo en cuenta estos posibles riesgos, Anthropic está limitando el acceso a un pequeño grupo de grandes organizaciones a través del Proyecto Glasswing. El objetivo: adelantarse a las implicaciones de seguridad de un mundo en el que descubrir y explotar vulnerabilidades podría llegar a ser algo trivial. Este cambio refuerza los argumentos a favor de las operaciones de resiliencia (ResOps™). Podría cambiar de forma radical la forma en que las organizaciones abordan la ciberseguridad.

En una publicación reciente en LinkedIn titulada «El principio del fin de la ciberseguridad», Jen Easterly, directora ejecutiva de RSAC y exdirectora de la CISA, sostiene que el sector actual de la ciberseguridad está diseñado para identificar los defectos de software, defenderse de ellos y responder ante ellos. En efecto, compensa las deficiencias en la calidad del software y en las prácticas de desarrollo seguro. Si modelos como Claude Mythos Preview funcionan tal y como se describe, su capacidad para detectar vulnerabilidades a gran escala podría alterar significativamente el panorama actual de las herramientas de seguridad. Un episodio reciente de STRIVE —«La evidencia por encima de la esperanza: ¿aguantará tu plan de recuperación bajo presión?»— se hace eco de esta preocupación. Las organizaciones han invertido mucho en herramientas para prevenir ataques, pero hay relativamente poca innovación en lo que se conoce como «right of boom», es decir, las capacidades necesarias para recuperar el negocio cuando, inevitablemente, se produzca una interrupción.

¿Por qué ResOps?

ResOps es una disciplina organizativa que integra la resiliencia en las operaciones diarias. Hace que las organizaciones pasen de backup pasivas y reactivas a un modelo activo y continuo.

Las operaciones de TI tradicionales se centran en la eficiencia. ResOps se centra en sobrevivir a los fallos. Reúne a los equipos de seguridad, infraestructura y operaciones en torno a un objetivo común: identificar el negocio mínimo viable de la organización —los sistemas, datos y procesos críticos necesarios para funcionar— y garantizar que esos servicios se puedan restablecer de forma rápida y sin problemas tras una interrupción.

La mayoría de las disciplinas operativas se optimizan para cuando los sistemas funcionan según lo previsto. ResOps está diseñado para cuando no es así. Su pregunta fundamental es sencilla: ¿puedes recuperar cada servicio crítico en este mismo momento, con confianza y pruebas?

¿Qué nos depara el futuro?

Si la perspectiva de Easterly resulta acertada —que la ciberseguridad compensa en gran medida los defectos del software—, entonces tecnologías como Claude Mythos Preview suponen algo más que un avance gradual. Indican un cambio estructural en el riesgo empresarial. La IA puede ayudar a reducir el tiempo que transcurre entre el descubrimiento de una vulnerabilidad y su corrección. Incluso puede eliminar ciertos tipos de fallos de software. Pero no elimina el riesgo de interrupciones, configuraciones erróneas, compromiso de identidades o fallos en cadena en sistemas complejos. Y no sustituye a la disciplina operativa necesaria para responder y recuperarse.

Los fallos seguirán produciéndose. Esa realidad hace que ResOps sea más importante, no menos. A medida que la prevención se automatiza cada vez más, la resiliencia se convierte en el factor diferenciador. Las organizaciones ya no se evaluarán únicamente por su capacidad para bloquear ataques. Se evaluarán por su eficacia a la hora de recuperarse, restaurando servicios críticos y datos fiables en condiciones reales.

La ciberseguridad tiene como objetivo mantener a raya las amenazas. ResOps te prepara para cuando estas logren colarse. En un mundo impulsado por la IA, la capacidad de sobrevivir y recuperarse de los fallos puede ser la capacidad operativa más importante que una organización pueda desarrollar. Lee más en nuestro informe «Readiness Report», titulado «Evidencia por encima de la esperanza: argumentos ejecutivos a favor de las operaciones de resiliencia», y descubre más sobre la disciplina de ResOps en Readiverse.

Preguntas frecuentes

P: ¿Qué es el Proyecto Glasswing y por qué es importante?

R: El Proyecto Glasswing es una iniciativa de Anthropic para limitar y estudiar el acceso a potentes modelos de IA capaces de identificar vulnerabilidades de software. Es importante porque apunta a un futuro en el que la detección de vulnerabilidades será rápida y generalizada, lo que aumentará tanto los riesgos defensivos como los ofensivos.

P: ¿Qué es ResOps y en qué se diferencia de las operaciones de TI tradicionales?

R: ResOps es una disciplina centrada en ayudar a las organizaciones a sobrevivir y recuperarse ante las interrupciones. A diferencia de las operaciones de TI tradicionales, que dan prioridad a la eficiencia, ResOps se centra en la continuidad y la rápida recuperación de los servicios críticos.

P: ¿Cómo podría influir la IA en el futuro de la ciberseguridad?

R: La IA puede reducir considerablemente el tiempo que se tarda en detectar y solucionar vulnerabilidades, lo que podría afectar al funcionamiento de las herramientas de seguridad actuales. Sin embargo, no elimina riesgos como las interrupciones del servicio o las configuraciones erróneas, por lo que las capacidades de recuperación cobran aún más importancia.

P: ¿Por qué la recuperación está cobrando más importancia que la prevención?

R: A pesar de la gran inversión en herramientas preventivas, siguen produciéndose interrupciones. A medida que las amenazas evolucionan y aumenta la automatización, se juzgará más a las organizaciones por la rapidez y eficacia con la que puedan restablecer sus operaciones tras un incidente.

P: ¿Qué significa «derecho al boom» en este contexto?

R: El «derecho a la recuperación» se refiere a la fase posterior a un incidente, centrada en la respuesta y la recuperación. Pone de relieve la brecha que existe en materia de innovación entre la restauración de las operaciones empresariales y la prevención de ataques.

P: ¿Cómo pueden las empresas empezar a implementar ResOps?

R: Las organizaciones pueden empezar por identificar su negocio mínimo viable —los sistemas y datos críticos— y crear procesos para recuperarlos rápidamente. Esto implica coordinar a los equipos de seguridad, TI y operaciones en torno a objetivos centrados en la resiliencia.

Jason Meserve es director de marketing en redes sociales en Commvault.
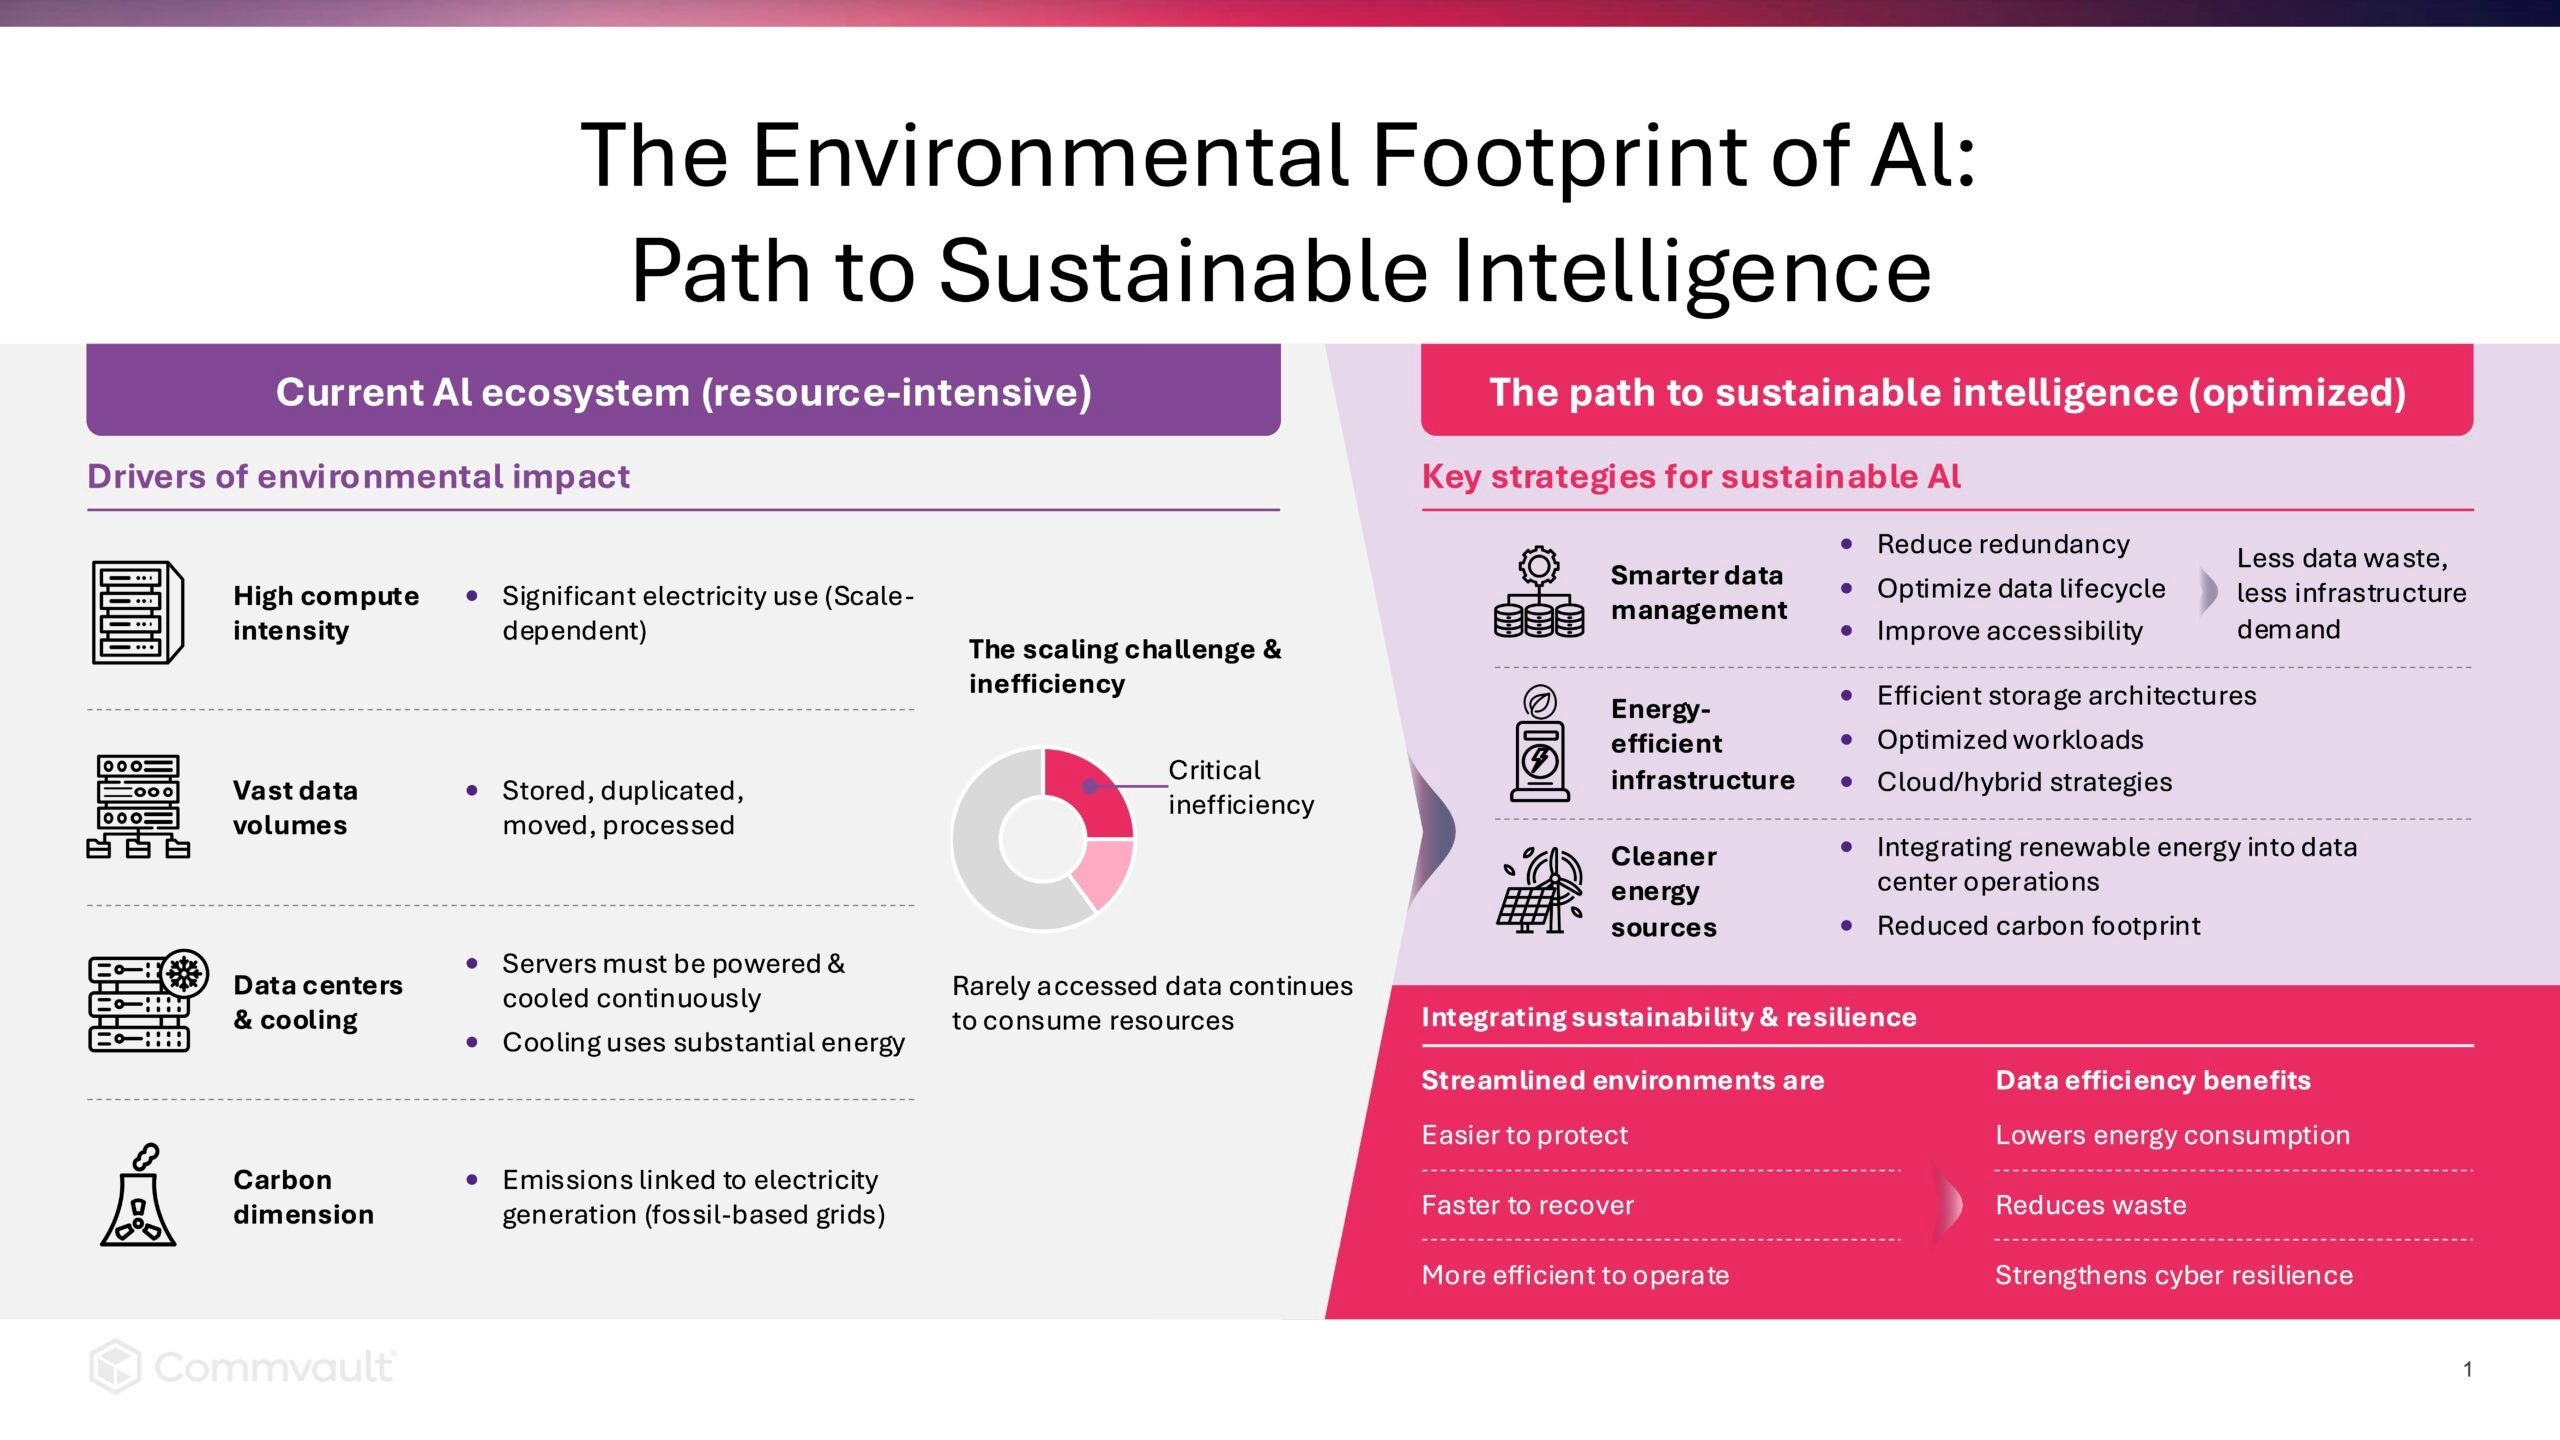
More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos clave

  • El aumento de las interrupciones operativas hace que la resiliencia escalable sea esencial, pero las organizaciones suelen caer en trampas como buscar una tecnología que sea la «solución milagrosa» o confiar en el «culto a la figura» de expertos concretos.
  • ResOps ofrece un marco escalable que integra a las personas, los procesos y la tecnología en ITOps, SecOps y DevOps.
  • El apoyo de la alta dirección, a nivel de director general, ayuda a fomentar la responsabilidad y a dar prioridad a la resiliencia como disciplina estratégica.

Los ciberataques, cloud y las amenazas basadas en la inteligencia artificial plantean constantes retos operativos a las empresas. Para poder cumplir con los requisitos empresariales en este entorno cada vez más disruptivo, las organizaciones deben ir más allá de las herramientas, los equipos y los planes de recuperación independientes, y adoptar la resiliencia como modelo operativo integrado.

En un seminario web reciente, Phil Goodwin, vicepresidente de investigación de los programas de infraestructura a nivel mundial de IDC, se unió a mí en una charla informal para analizar cómo las organizaciones pueden ir más allá de los enfoques fragmentados y desarrollar una resiliencia que se pueda ampliar.

Por qué las organizaciones necesitan un nuevo marco de resiliencia

Como las organizaciones se pasan el día apagando incendios, al tiempo que se ponen al día con las nuevas tecnologías y abordan nuevas iniciativas, casi nunca tienen tiempo para dar un paso atrás y replantearse si sus estrategias siguen cumpliendo con los requisitos. Pero ahora que los incidentes aislados se han convertido en una perturbación sistémica, este debate se ha vuelto imprescindible.

En una época más sencilla, las organizaciones se centraban principalmente en el Backup and Recovery. Las interrupciones a gran escala, como el huracán Sandy, pusieron la recuperación ante desastres en la agenda. La intensificación de las ciberamenazas, como el ransomware, añadió la ciberresiliencia y la continuidad del negocio a la lista. Cada evolución trajo consigo nuevas capacidades, pero muchas organizaciones se limitaron a añadir nuevos enfoques a lo que ya estaban haciendo, en lugar de abordar estos requisitos cada vez más amplios de forma integral.

Cuando distintos equipos gestionan diferentes aspectos con herramientas y políticas diferentes, pueden surgir lagunas que ralenticen la recuperación. A pesar de llevar años invirtiendo en ciberseguridad, las organizaciones siguen teniendo problemas con la recuperación. Más recientemente, la IA ha acelerado la necesidad de adoptar un enfoque más integrado al transformar tanto las amenazas como las defensas. A pesar del aumento de las inversiones en IA, muchas empresas están retrasando su implantación debido a las continuas preocupaciones sobre la gobernanza y las vulnerabilidades de seguridad.

En el otro lado del frente cibernético, los delincuentes están usando la IA para crear deepfakes, atacar a los usuarios con ataques de phishing cada vez más sofisticados y convincentes, y aprovechar vulnerabilidades a gran escala. Las operaciones de resiliencia —ResOps— consideran la resiliencia como una disciplina operativa continua, en lugar de un conjunto de herramientas y equipos independientes. Al reunir ITOps, SecOps y DevOps bajo un marco unificado, ResOps ayuda a transformar la resiliencia para que pueda seguir el ritmo de las perturbaciones sistémicas.

Cómo evitar los errores más comunes en la planificación de la resiliencia

Incluso las organizaciones que reconocen la necesidad de un cambio suelen caer en trampas. Una de ellas es el problema de la «solución milagrosa», que se centra en la tecnología como única solución. Los líderes quieren creer que adquirir las herramientas adecuadas lo resolverá todo, pero la tecnología por sí sola no puede generar resultados empresariales positivos sin una integración y unos procesos adecuados.

El «culto al héroe» es otro error habitual: confiar en empleados con talento cuya experiencia reside en sus cabezas, en lugar de en procesos documentados. El heroísmo no se puede ampliar, y depender de personas concretas genera vulnerabilidad cuando alguien se va o cambian las responsabilidades.

Para superar estos escollos, tienes que plantearte tu modelo operativo desde otra perspectiva. En lugar de centrarte principalmente en la tecnología y en las personas, piensa en el equipo que tendrás que formar, incluyendo el apoyo de la dirección, los responsables de operaciones de TI y de seguridad, y los altos directivos del ámbito empresarial. El pliego de condiciones del equipo debería centrarse, ante todo, en definir los resultados empresariales: ¿qué debe aportar la resiliencia a la organización? ¿Qué indicadores clave de rendimiento (KPI), acuerdos de nivel de servicio (SLA) y procesos hay que establecer para cumplir estos requisitos?

Desarrollar operaciones de resiliencia de arriba abajo

Como prioridad a nivel de la junta directiva, la resiliencia requiere el apoyo de los más altos cargos. Las operaciones de resiliencia (ResOps) cobran mayor impulso cuando el director general se implica, ayudando a establecer las prioridades en materia de recursos e impulsando la rendición de cuentas en toda la organización. Con el respaldo de la dirección, los altos directivos —como el director de sistemas de información (CIO), el director técnico (CTO), el director de seguridad de la información (CISO) y los directores generales— pueden encargar a su personal la puesta en marcha.

Este enfoque se puede adaptar a organizaciones de cualquier tamaño. Incluso las empresas pequeñas y medianas pueden formar equipos multifuncionales que incluyan a las partes interesadas del negocio, a los equipos de TI y al personal encargado de la seguridad de los datos y de la red. A medida que crecen, esta estructura puede adaptarse a sus necesidades, incorporando personal en disciplinas específicas relacionadas con la resiliencia, al tiempo que se mantiene un enfoque integrado en toda la cadena de operaciones de resiliencia. ResOps refleja la forma en que los equipos de operaciones de TI, SecOps y DevOps deben trabajar juntos dentro de las organizaciones. La recuperación de datos y la seguridad de los datos se han alineado tan estrechamente que, en IDC, los investigadores de estas disciplinas colaboran ahora con frecuencia en proyectos con clientes. Ahora hay que diseñar las aplicaciones teniendo en cuenta a los atacantes, incorporando arquitecturas de «confianza cero» y partiendo de la base de que algo va a salir mal. ResOps ofrece el marco necesario para esta convergencia, uniendo las herramientas de seguridad y de operaciones en un modelo unificado para hacer frente a amenazas e interrupciones de todo tipo.

ResOps como marco común para el sector

ResOps es un modelo operativo, no un producto, y puede beneficiar a las empresas independientemente de las herramientas concretas que utilicen. Como señaló Phil durante nuestra charla: «Realmente requiere la participación de la comunidad, en la que la gente aporte desde diferentes perspectivas, diferentes proveedores, diferentes organizaciones y diferentes equipos, igual que en DevOps o SecOps».

Para las organizaciones que se enfrentan a interrupciones constantes y a la creciente complejidad de las amenazas y defensas basadas en la IA, ResOps ofrece una alternativa que va más allá de los enfoques fragmentados de resiliencia. Al unir a las personas, los procesos y la tecnología en un modelo operativo unificado, ResOps convierte los esfuerzos de recuperación fragmentados en una preparación a nivel de toda la empresa. Echa un vistazo a mi charla informal completa con Phil para ver cómo ResOps puede ayudarte a desarrollar una resiliencia empresarial que se adapte a tus necesidades.

Preguntas frecuentes

P: ¿Qué son las operaciones de resiliencia (ResOps)?

R: ResOps es un modelo operativo que integra las operaciones de TI, las operaciones de seguridad y DevOps en una disciplina continua. En lugar de tratar la recuperación ante desastres, la ciberresiliencia y la continuidad del negocio como capacidades independientes, ResOps aúna a las personas, los procesos y la tecnología bajo un marco unificado para ayudar a crear una resiliencia empresarial escalable.

P: ¿Por qué es importante el apoyo de la dirección para la resiliencia cibernética?

R: El apoyo de la dirección —a ser posible, a nivel del director general— ayuda a fomentar la responsabilidad y a dar prioridad a las iniciativas de resiliencia en toda la organización. Este apoyo de arriba hacia abajo es esencial para las organizaciones que intentan pasar de enfoques fragmentados a operaciones de resiliencia integradas.

P: ¿Pueden las pequeñas y medianas empresas implementar ResOps?

R: Sí. ResOps se puede aplicar a organizaciones de cualquier tamaño. El marco se adapta en complejidad a medida que las organizaciones crecen, lo que lo hace accesible para las empresas medianas sin dejar de ser eficaz para las grandes empresas.

P: ¿Por qué tienen que colaborar los equipos de TI y de seguridad para garantizar la resiliencia?

R: Cuando los equipos de operaciones de TI, de seguridad y de DevOps colaboran en lugar de trabajar de forma aislada, las organizaciones pueden contribuir a crear una infraestructura más resistente para hacer frente a las amenazas en constante evolución.

P: ¿Cómo deberían empezar las organizaciones con las operaciones de resiliencia?

R: Empiece por lo más alto, asegurándose del respaldo de la dirección al nivel del director general. A continuación, forme un equipo multifuncional que incluya a miembros de las operaciones de TI, SecOps y partes interesadas del negocio, y pídales que definan los resultados empresariales que la resiliencia debe aportar a su negocio. Realice una evaluación de amenazas para comprender los riesgos que debe abordar. Solo después de estos pasos fundamentales deben las organizaciones centrarse en seleccionar tecnologías y desarrollar procesos detallados.

Chris Mierzwa es director sénior de marketing de cartera en Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Nota: Esta entrada del blog se publicó originalmente en octubre de 2025, cuando se presentó Data Rooms. Se ha actualizado para reflejar la siguiente evolución: Data Activate.

Puntos clave

  • Data Activate forma parte de las capacidades de IA de última generación de Commvault —junto con AI Protect y AI Studio— anunciadas para ayudar a las organizaciones a poner en marcha la IA de forma segura, gestionar los agentes de IA y crear flujos de trabajo basados en agentes desde Commvault Cloud.
  • Data Activate está diseñado para que puedas transformar backup en activos fiables y preparados para la IA, a la vez que te ayuda a mantener el control y el cumplimiento normativo.
  • La oferta une la protección de datos y la activación de la IA sin crear nuevos riesgos de seguridad ni requerir otra platform.
  • Se integra con ecosistemas de IA existentes, como Microsoft Azure y Snowflake, utilizando estándares abiertos como Apache Parquet e Iceberg.
  • La gobernanza integrada permite la gestión, clasificación y el intercambio de datos protegidos dentro de una arquitectura de confianza cero.
  • Al activar los datos históricos, las organizaciones pueden ayudar a acelerar la innovación en IA, el análisis y los flujos de trabajo de cumplimiento normativo de forma segura.

La innovación en IA depende de los datos, pero no de cualquier dato. Depende de datos fiables, gobernados y accesibles. Sin embargo, para la mayoría de las empresas, los datos que podrían impulsar la IA se encuentran ocultos en copias de seguridad, dispersos por distintos entornos y sujetos a restricciones de cumplimiento normativo. Ahí es donde entra en juego la oferta Data Activate de Commvault, anteriormente conocida como Data Rooms.

Acelerar la IA de forma segura

Data Activate es una de las tres funciones de IA que Commvault ha anunciado como parte de su platform de IA de última generación platform junto con AI Protect y AI Studio. A medida que las empresas se apresuran a adoptar la IA, muchas se topan con un problema fundamental: sus datos están fragmentados y son difíciles de usar. Según una encuesta reciente, el 68 % de las empresas mencionan los silos de datos como su principal preocupación.

La solución Data Activate de Commvault ayuda a transformar backup —uno de los conjuntos de datos más completos y fiables que tiene una organización— en activos preparados para la IA. Data Activate ayuda a las empresas a conectar sus datos de forma segura a plataformas de IA y análisis, sin generar nuevos riesgos ni complicaciones.

A diferencia de los métodos anteriores de exportación masiva, Data Activate permite publicar periódicamente conjuntos de datos actualizados, lo que facilita mantener los flujos de trabajo de IA sincronizados con los datos fiables más recientes. Además, los equipos pueden identificar y excluir datos confidenciales —como la información de carácter personal— antes de activar los conjuntos de datos para su análisis o para el desarrollo de modelos.

La solución Data Activate no es platform de IA más. Es el puente entre la protección de datos y la activación de datos, diseñada para que tus inversiones actuales en IA funcionen más rápido y de forma más segura. Lo consigue creando «espacios» regulados y controlados por políticas dentro de Commvault Cloud lugares donde los datos se pueden clasificar, seleccionar y compartir con herramientas de IA y análisis sin salir del ámbito de protección.

Escuchar a los clientes: se acabó Platform

Hemos entendido perfectamente lo que nos han dicho los clientes: no necesitas otra platform de IA. Lo que necesitas es una forma segura y sencilla de utilizar los datos que ya tienes, en todas las herramientas y ecosistemas de IA que ya has elegido.

Por eso Commvault ha creado Data Activate, para integrarse con socios como Microsoft Azure y Snowflake utilizando formatos de estándar abierto como Apache Parquet e Iceberg. Esto te ayuda a mantener tus datos portátiles, conformes con las políticas y listos para su activación, sea cual sea el rumbo que tome tu estrategia de IA.

Convertir la protección de datos en activación de datos

Con Data Activate, los usuarios autorizados pueden identificar, clasificar y preparar datos directamente desde backup , tanto en cloud locales como cloud . La gobernanza integrada ayuda a mantener el control, permitiendo que solo se compartan los conjuntos de datos aprobados, con clasificación automática, etiquetado de sensibilidad, ocultación de información y registros de auditoría aplicados en cada paso del proceso.

Data Activate funciona como un espacio de trabajo regulado y controlado por políticas dentro de Commvault Cloud donde los datos se pueden gestionar y poner a disposición de herramientas de IA o de análisis sin salir del ámbito de protección. Este diseño regulado ofrece un puente seguro entre backup y los flujos de trabajo de activación, lo que ayuda a las organizaciones a aprovechar su información para innovar sin dejar de cumplir con la normativa y mantener el control. Data Activate puede ayudarte a:

  • Acelera la obtención de información: encuentra y exporta rápidamente datos históricos en formatos compatibles con la inteligencia artificial para entrenar modelos o potenciar el análisis.
  • Simplifica las operaciones: elimina los frágiles procesos ETL con la detección y curación automatizadas de datos.
  • Mantén el cumplimiento normativo: mantén la gobernanza intacta con controles basados en políticas y trazabilidad desde backup la activación.

La confianza como base para una IA responsable

En el afán por adoptar la IA, la confianza suele acabar siendo una víctima colateral. Según un estudio reciente, aproximadamente tres cuartas partes de los responsables de TI encuestados afirmaron que el uso de la IA podría hacer que sus organizaciones fueran más vulnerables a los ciberataques. Por eso Commvault ha desarrollado Data Activate dentro de la arquitectura «zero-trust» CloudCommvault Cloud, que incluye cifrado, RBAC y compatibilidad con los requisitos de cumplimiento normativo.

Al combinar la protección de datos, la gobernanza y la activación en una sola platform, Commvault permite a las empresas acelerar la innovación en IA sin comprometer la seguridad de los datos, el cumplimiento normativo ni el control.

Acelera la innovación sin añadir riesgos

La solución Data Activate de Commvault ayuda a las organizaciones a avanzar más rápido al permitir que las herramientas que impulsan su negocio accedan de forma segura a los datos, desde el entrenamiento de modelos de IA hasta el análisis de datos, el eDiscovery y la automatización del cumplimiento normativo. Porque cuando backup se convierten en datos utilizables, las empresas acceden a años de información histórica y contexto que la mayoría de los modelos de IA simplemente no tienen.

Como dijo Pranay Ahlawat, director de Tecnología e Inteligencia Artificial de Commvault: «Las organizaciones están empezando a darse cuenta de que sus datos históricos son algo más que un simple seguro: son un activo estratégico potente y sin explotar. Con Commvault Data Activate, las empresas pueden exportar con confianza sus datos secundarios y aprovecharlos con la platform IA platform elijan para abrir nuevas oportunidades de inteligencia, innovación y crecimiento empresarial».

Por qué es importante ahora

La solución Data Activate de Commvault redefine las posibilidades para las empresas que quieren innovar de forma responsable. Permite pasar de proteger los datos a activarlos, de forma segura, flexible y a gran escala.

En resumen: Commvault no está creando otra platform de IA. Estamos sentando las bases que permiten que todas platform de IA platform mejor, porque cuando los datos están protegidos, son fiables y están listos para su activación, la innovación se produce más rápidamente.


Preguntas frecuentes

P: ¿Qué es la oferta «Data Activate» de Commvault? R: Commvault Data Activate es una función de Commvault Cloud ayuda a las empresas a identificar, clasificar y activar de forma segura backup para su uso en inteligencia artificial y análisis. Es compatible con formatos abiertos como Apache Iceberg y Parquet, y se basa en una arquitectura regulada de «confianza cero» que permite un acceso controlado y de autoservicio a los datos.

P: ¿En qué se diferencia Data Activate de otras soluciones de datos para IA?
R: La mayoría de las herramientas de preparación de datos para IA solo funcionan con datos en tiempo real o de producción, lo que plantea retos en materia de cumplimiento normativo y costes. Data Activate trabaja a partir de datos de copia de seguridad —datos que ya están protegidos y regulados—, lo que aporta un equilibrio único entre accesibilidad, cumplimiento normativo y confianza. Está integrado en el entorno controlado por políticas de Commvault Cloud, por lo que forma parte de una plataforma unificada de ciberresiliencia. Data Activate también publica periódicamente conjuntos de datos actualizados —en lugar de depender de exportaciones masivas puntuales—, lo que ayuda a mantener al día los flujos de trabajo de IA sin intervención manual. P: ¿Qué ventajas obtienen las organizaciones al utilizar Data Activate? R: Las organizaciones pueden acelerar los conocimientos sobre IA y análisis, simplificar las operaciones de datos al reducir la complejidad de ETL y mantener el cumplimiento normativo mediante procesos automatizados de clasificación, etiquetado y auditoría.

P: ¿Cómo contribuye Data Activate a la seguridad de los datos y al cumplimiento normativo? R: Data Activate opera dentro de la arquitectura de confianza cero CloudCommvault Cloud, aplicando automáticamente controles de clasificación, redacción y controles aptos para auditorías. Ayuda a mantener la privacidad, la trazabilidad y el cumplimiento de los datos a lo largo de todo su ciclo de vida, en consonancia con las normas de gobernanza internas y reglamentarias.

P: ¿Qué tipos de plataformas de IA o de análisis se pueden conectar con Data Activate? R: Data Activate se integra con los principales socios cloud IA, como Microsoft Azure y Snowflake, y es compatible con formatos de datos de estándar abierto como Apache Parquet e Iceberg para ofrecer la máxima flexibilidad y portabilidad.

P: ¿Por qué es importante esta oferta para las empresas hoy en día? R: A medida que las organizaciones aceleran la adopción de la IA, Data Activate les permite aprovechar de forma responsable el valor de los datos históricos protegidos, lo que impulsa la innovación al tiempo que ayuda a mantener la confianza, el cumplimiento normativo y el control. Vir Choksi es director principal de marketing de productos en Commvault.


More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos clave

  • La proliferación de agentes supone un riesgo para la gobernanza. A medida que proliferan los agentes de IA, la visibilidad fragmentada y los flujos de trabajo de Recovery inconexos pueden generar un riesgo operativo real.
  • AI Protect unificará la detección, la supervisión y la Recovery guiada de los agentes y sus dependencias en todas las plataformas, en una única experiencia centrada en los agentes.
  • AI Protect se diseñará no solo para evaluar si los activos están protegidos, sino también para ayudar a proteger la pila de agentes e identificar riesgos en función de a qué acceden y qué hacen los agentes.
  • AI Protect se desarrollará sobre la plataforma de resiliencia de Commvault, lo que significa que Recovery podrá vincularse directamente al impacto iniciado por los agentes, tanto en los datos como en los entornos.
  • AI Protect formará parte de una plataforma más amplia que da soporte al ciclo de vida de la resiliencia de la IA: desde la activación segura de los datos hasta la gobernanza, la creación y la recuperación de flujos de trabajo basados en agentes.

Los agentes de IA ya no son un experimento del futuro. Hoy en día se ejecutan en entornos de producción: consultan datos, activan flujos de trabajo y toman decisiones a la velocidad de una máquina. Para la mayoría de las empresas, esto está ocurriendo más rápido de lo que los marcos de gobernanza pueden seguir el ritmo.

El problema no es el entusiasmo por la IA. Es la brecha que existe entre implementar agentes y saber realmente qué están haciendo esos agentes, a qué datos acceden y qué hacer cuando algo sale mal. Esa brecha es la que Commvault AI Protect está diseñado para cerrar.

El problema de la gobernanza en el núcleo de la IA basada en agentes

A medida que las organizaciones amplían sus inversiones en IA, está surgiendo una nueva clase de riesgo operativo. Los agentes de IA no son meras herramientas, sino actores autónomos que pueden acceder a datos confidenciales, interactuar con sistemas críticos y desencadenar cambios en cadena. Sin una forma clara de detectarlos, supervisarlos y gestionarlos, los equipos de TI y de seguridad pueden estar actuando a ciegas.

Los síntomas son conocidos:

  • Visibilidad fragmentada: las API de los hiperescaladores y las herramientas de observabilidad ofrecen vistas parciales y aisladas de la actividad de los agentes. No existe una visión única que conecte el comportamiento de los agentes con la protección de datos, el riesgo y la Recovery en todas las plataformas.
  • Falta de contexto de protección: los equipos de protección de datos no pueden determinar fácilmente si los activos a los que acceden los agentes de IA están adecuadamente protegidos o son recuperables.
  • Señales de riesgo débiles: la actividad de los agentes puede generar una enorme cantidad de datos de telemetría, pero sin una correlación entre identidad, acceso e impacto, distinguir entre la automatización benigna y el comportamiento de alto riesgo sigue siendo una tarea manual.
  • Recovery inconexa: cuando los cambios iniciados por los agentes causan problemas, rastrear el impacto e iniciar la Recovery puede requerir una correlación manual entre herramientas, lo que aumenta el tiempo necesario para la resolución.

Presentamos Commvault AI Protect

AI Protect se diseñará para ofrecer visibilidad centralizada, contexto de protección, evaluación de riesgos y recuperación guiada para los agentes de IA, tanto en entornos empresariales como de SaaS y en la nube. Ampliará las capacidades existentes de detección, protección y Recovery de Commvault con un contexto centrado en los agentes, lo que ayudará a los equipos a gestionar los agentes de IA de forma segura y a recuperarse rápidamente cuando surjan problemas.

Detección: un inventario único y fiable de agentes

AI Protect estará diseñado para detectar de forma periódica los agentes de IA (y sus dependencias) que operan en los entornos conectados, lo que ayudará a mantener un inventario unificado y actualizado basado en una cadencia de detección configurable. Cada registro de agente captará su entorno de ejecución y las fuentes de datos, los modelos, las configuraciones, las aplicaciones y la infraestructura con las que interactúa. Esto ayudará a proporcionar una visión completa e interambiental de lo que se está ejecutando y con qué interactúa.

Proteger: subsanar las lagunas de cobertura antes de que se conviertan en incidentes

Los agentes de IA interactúan con datos y sistemas sensibles, pero las herramientas de protección tradicionales no evalúan la cobertura en el contexto del comportamiento de los agentes. AI Protect se diseñará para mostrar el estado de protección de cada activo con el que interactúa un agente —protegido, parcialmente protegido o sin proteger— y ayudará a identificar las brechas provocadas por la actividad de los agentes. Cuando existan brechas, ofrecerá acciones recomendadas y flujos de trabajo de protección para que los equipos puedan subsanarlas.

Supervisar: convertir la telemetría en señales de riesgo aprovechables

AI Protect recopilará la actividad de los agentes a partir de fuentes existentes de auditoría, eventos y telemetría, y la presentará en un contexto centrado en el agente, no como registros sin procesar. Una línea de tiempo de actividades ordenada cronológicamente mostrará qué ha hecho cada agente y cuándo, y las señales de riesgo se marcarán y clasificarán automáticamente cuando los agentes accedan a datos sensibles, interactúen con activos desprotegidos o muestren patrones inusuales. Esto ayudará a los equipos a pasar de una clasificación reactiva a una concienciación proactiva.

Recovery: Recovery guiada vinculada directamente al impacto en los agentes

Cuando un cambio iniciado por un agente provoque un problema, AI Protect mostrará la disponibilidad de puntos de recuperación para los activos afectados y guiará a los equipos a través de la acción de Recovery adecuada, ya sea la restauración de datos, aplicaciones o configuraciones. El alcance de Recovery se centrará directamente en el impacto del agente, no en incidentes genéricos, y cada acción llevará una marca de tiempo.

Además, los equipos podrán recuperar toda la pila de IA —no solo el modelo, sino también los datos conectados, las configuraciones y los sistemas subyacentes que lo respaldan—, lo que ayudará a restaurar todo el entorno a un estado conocido y correcto con una única acción guiada.

Parte de una visión más amplia de la resiliencia de la IA

AI Protect será una de las tres capacidades anunciadas por Commvault como parte de una plataforma más amplia de resiliencia de la IA.

Data Activate permite a las organizaciones clasificar y seleccionar datos de copias de seguridad protegidas, así como preparar conjuntos de datos regulados para su uso con modelos de lenguaje grande (LLM) y flujos de trabajo de IA, publicando actualizaciones según un calendario periódico alineado con las políticas de copia de seguridad, en formatos como Apache Iceberg y Parquet, con los datos sensibles filtrados antes de la activación.

AI Studio permitirá a las empresas implementar agentes ya preparados y crear otros personalizados, sin necesidad de escribir código. Mediante un «Agent Builder» basado en lenguaje natural, los administradores podrán describir la intención operativa en lenguaje sencillo, revisar el flujo de trabajo propuesto, perfeccionarlo e implementarlo como un agente personalizado y regulado desde una única interfaz. AI Studio estará diseñado para aprovechar el servidor MCP de Commvault e integrarse con otras aplicaciones empresariales a través de MCP, lo que permitirá que los flujos de trabajo se extiendan sin problemas entre los distintos sistemas.

En conjunto, estas tres capacidades abarcarán todo el espectro de la resiliencia de la IA: ayudarán a activar de forma segura datos fiables, a gestionar y recuperar agentes en producción, y a crear los flujos de trabajo basados en agentes que las operaciones realmente requieren.


Preguntas frecuentes

P: ¿Qué es Commvault AI Protect?

R: AI Protect está concebido como una solución de gobernanza y resiliencia para agentes de IA que operan en entornos empresariales, SaaS y en la nube. Se diseñará para detectar automáticamente agentes y dependencias, identificar brechas de protección en los activos con los que interactúan, supervisar y proporcionar flujos de trabajo de recuperación guiados cuando los cambios iniciados por los agentes provoquen problemas.

P: ¿En qué se diferenciará esto de las herramientas generales de observabilidad o supervisión de la IA?

R: La mayoría de las herramientas de observabilidad muestran datos de telemetría, pero no llegan a vincular la actividad de los agentes con la protección y la Recovery. AI Protect estará diseñado para correlacionar el comportamiento de los agentes con la cobertura de protección y la Readiness para la Recovery y, cuando algo vaya mal, proporcionará una guía paso a paso para ayudar a restaurar los datos, las configuraciones o los sistemas afectados por la actividad de los agentes.

P: ¿Qué entornos será compatible con AI Protect?

R: AI Protect se diseñará para funcionar en entornos de hiperescaladores (AWS, Azure, Google Cloud), plataformas SaaS y sistemas empresariales internos, ofreciendo una visión unificada y multientorno de la actividad de los agentes y su impacto.

P: ¿Cómo identificará AI Protect los riesgos?

R: Las señales de riesgo se obtendrán correlacionando la actividad de los agentes con los patrones de acceso a los datos, la sensibilidad de los activos implicados y la cobertura de protección. En lugar de un análisis de registros sin procesar, AI Protect presentará el riesgo en un contexto centrado en los agentes, señalando agentes e interacciones específicos que requieran atención, junto con el motivo por el que se han señalado.

P: ¿Cómo funcionará la recuperación?

R: AI Protect mostrará la disponibilidad de los puntos de recuperación para los activos afectados por la actividad de los agentes y guiará a los equipos a través de la acción de Recovery adecuada, ya sea la restauración de datos, aplicaciones o configuraciones. Las acciones de Recovery se limitarán al impacto iniciado por los agentes y serán totalmente auditables.

P: ¿Cómo se relacionará AI Protect con AI Studio y Data Activate?

R: Los tres formarán parte de las capacidades de IA de última generación de Commvault. Data Activate controla cómo se preparan y activan los datos para su uso en IA. AI Protect controlará los agentes que operan en producción. AI Studio permitirá a los equipos crear y gestionar flujos de trabajo personalizados basados en agentes. Juntos, formarán un ciclo de vida completo de resiliencia de la IA.

Teja Medasani es director principal de producto en Commvault y Vir Choksi es director principal de marketing de producto en Commvault.


More related posts


Commvault Cloud Compliance

Read more about Commvault Cloud Compliance

Puntos clave

  • AI Studio se diseñará para salvar la brecha entre la experimentación y la automatización mediante IA a gran escala y apta para la producción.
  • La biblioteca de agentes ofrecerá a las empresas una visión general de todos los agentes predeterminados y personalizados en un único lugar, con descripciones claras, categorías y estado de activación.
  • El «Agent Builder» facilitará la personalización. Las entradas en lenguaje natural podrán generar flujos de trabajo estructurados y revisables, sin necesidad de programación ni comportamientos opacos.
  • Toda la lógica de los agentes será visible y se guardará de forma explícita antes de su implementación, lo que ayudará a cumplir los requisitos de las empresas en materia de transparencia y explicabilidad.
  • AI Studio formará parte de una plataforma integral. En combinación con Data Activate y AI Protect, se diseñará para respaldar el ciclo de vida de la resiliencia de la IA.

La automatización mediante IA promete un enorme valor operativo. Sin embargo, para la mayoría de las empresas, pasar de la fase piloto a la de producción puede resultar más difícil de lo esperado, especialmente cuando se trata de flujos de trabajo operativos como las copias de seguridad, la Recovery y la respuesta ante incidentes. Las preocupaciones en materia de gobernanza, la falta de visibilidad y la complejidad de integrar diferentes herramientas a menudo pueden impedir que la IA se utilice en operaciones reales y cotidianas de resiliencia.

Lo que las organizaciones necesitan es una forma de aplicar la IA directamente a estos flujos de trabajo: de forma segura, con control y de manera que se adapte al modo en que operan realmente los equipos de resiliencia. Para eso se diseñará Commvault AI Studio.

Por qué la automatización mediante IA se estanca en la fase piloto

El informe «State of AI in 2025» de McKinsey revela que el 88 % de las organizaciones utilizan la IA en al menos una función empresarial; sin embargo, solo alrededor de un tercio ha logrado una adopción a gran escala más allá de las primeras fases piloto. Las barreras son comunes a todos los sectores:

  • Visibilidad y control limitados sobre qué agentes existen, qué hacen y dónde están activos, lo que dificulta a los equipos de TI y de seguridad de datos la supervisión de los flujos de trabajo operativos.
  • Gran dificultad para personalizar la automatización: los equipos pueden verse obligados a recurrir a la creación manual de scripts o a servicios externos para adaptar las capacidades integradas a los flujos de trabajo reales, lo que ralentiza la adopción y limita el retorno de la inversión.
  • Preocupaciones sobre la confianza y la gobernanza: sin transparencia, explicabilidad y auditabilidad, las empresas no pueden pasar con confianza los agentes de la fase experimental a la de producción.

Como resultado, las organizaciones o bien infrautilizan las capacidades de IA o bien recurren a procesos manuales para tareas que podrían automatizarse de forma segura, dejando de aprovechar las ganancias reales en eficiencia y resiliencia.

Presentamos Commvault AI Studio

AI Studio está llamado a ser la respuesta de Commvault a la brecha entre la gobernanza y la adopción. Su objetivo es proporcionar una interfaz centralizada en la que las empresas puedan visualizar y gestionar todos los agentes, implementar agentes ya preparados y crear agentes personalizados mediante un enfoque basado en flujos de trabajo que ayude a mantener el comportamiento visible, auditable y bajo control.

Biblioteca de agentes: una visión clara de todos los agentes de su entorno

La biblioteca de agentes será el punto de entrada a AI Studio. Presentará un inventario estructurado de todos los agentes disponibles en el entorno —tanto los agentes predeterminados creados por Commvault como los agentes personalizados creados por el cliente—, agrupados por tipo y mostrando de un vistazo el nombre, la categoría, la descripción y el estado de activación de cada agente.

Los agentes predeterminados incluyen los agentes básicos de ciberresiliencia de Commvault, como Arlie Advisor, Arlie Data Sense y Arlie Recover, entre otros. La biblioteca de agentes ofrecerá a los equipos una visión única y fiable de su ecosistema de agentes de resiliencia antes de emprender cualquier acción.

Gestión de agentes: control operativo para cada agente

Al seleccionar cualquier agente de la biblioteca, se abrirá una vista detallada específica que ayudará a aportar transparencia sobre el funcionamiento de dicho agente: su finalidad, cómo se activa, qué datos utiliza como entradas, los límites de ejecución y la telemetría básica de uso.

Esta vista también incluirá registros de la actividad y los eventos del agente. A continuación, los administradores podrán activar o desactivar el agente con una sola acción. Esto se aplicará de forma coherente tanto a los agentes predeterminados como a los personalizados, de modo que todos los agentes del entorno puedan estar sujetos al mismo estándar de gobernanza.

Agent Builder: de la intención expresada en lenguaje natural al flujo de trabajo regulado

El «Agent Builder» de AI Studio permitirá a los administradores crear agentes personalizados aprovechando los flujos de trabajo de Commvault y el servidor MCP, sin necesidad de escribir código.

La experiencia comenzará con lenguaje natural. Un administrador podrá describir lo que desea automatizar; por ejemplo: «Necesito un agente que detecte cuándo los problemas de almacenamiento o de infraestructura empiezan a afectar a las copias de seguridad y que ayude a resolverlos antes de que afecten a los SLA».

El sistema estará diseñado para traducir esa intención en una configuración estructurada del agente, que incluirá desencadenantes, condiciones y acciones, con pasos opcionales basados en IA de Arlie —como «Resumir», «Generar recomendación» o «Redactar notificación»— disponibles como pasos explícitos del flujo de trabajo.

El administrador podrá revisar el flujo de trabajo propuesto, ajustarlo según sea necesario —cambiando la frecuencia de los desencadenantes, especificando una lista de distribución o reordenando los pasos— y guardarlo. El resultado será un agente personalizado y auditable que aparecerá en la Biblioteca de agentes y que se podrá gestionar a través de la Gestión de agentes como cualquier otro agente.

Parte de una visión más amplia de la resiliencia basada en la IA

AI Studio será una de las tres funcionalidades que Commvault ha anunciado como parte de una plataforma más amplia de resiliencia de la IA.

Data Activate permite a las organizaciones clasificar y seleccionar datos de copias de seguridad protegidas, así como preparar conjuntos de datos regulados para su uso con modelos de lenguaje grande (LLM) y flujos de trabajo de IA, publicando actualizaciones según un calendario periódico alineado con las políticas de copia de seguridad, en formatos como Apache Iceberg y Parquet, tras filtrar los datos sensibles antes de la activación.

AI Protect ofrecerá visibilidad centralizada, contexto de protección, evaluación de riesgos y recuperación guiada para los agentes de IA que operan en entornos empresariales, SaaS y en la nube, lo que ayudará a los equipos a gestionar los agentes con confianza y a recuperarse rápidamente cuando surja algún problema.

En conjunto, estas tres capacidades cubrirán todo el espectro de la resiliencia de la IA: ayudarán a activar de forma segura datos fiables, a gestionar y recuperar agentes en producción, y a crear los flujos de trabajo basados en agentes que realmente requieren las operaciones.


Preguntas frecuentes

P: ¿Qué es Commvault AI Studio?

R: AI Studio será la plataforma centralizada de Commvault para implementar, crear y gestionar agentes de IA. Incluirá una biblioteca de agentes para visualizar todos los agentes del entorno, una herramienta de gestión de agentes para el control operativo y un generador de agentes para crear agentes personalizados mediante la automatización basada en flujos de trabajo, todo ello sin necesidad de escribir código.

P: ¿Para quién estará diseñado AI Studio?

R: AI Studio se ha diseñado para administradores de Commvault y operadores de TI que deseen automatizar tareas operativas —como supervisar los fallos en los trabajos de copia de seguridad o notificar a las partes interesadas— sin depender de scripts manuales ni de recursos de desarrollo externos.

P: ¿Cómo funcionará el generador de agentes?

R: Los administradores podrán describir su intención de automatización en lenguaje sencillo. A continuación, AI Studio podrá proponer un flujo de trabajo estructurado con desencadenantes, condiciones y acciones explícitas. A continuación, el administrador podrá revisar el flujo de trabajo, editarlo si es necesario y guardarlo como un agente personalizado. El agente resultante será visible, auditable y se gestionará a través de la misma interfaz que el resto de agentes.
Q: ¿Se puede incorporar la IA a los agentes personalizados?
A: Sí, pero de forma intencionada. La IA se invocará deliberadamente, no se integrará de forma invisible en el comportamiento del agente.

P: ¿Qué agentes predeterminados están disponibles de serie?

R: AI Studio se lanzará con una biblioteca de agentes predeterminados en categorías fundamentales de IA y ciberresiliencia, entre los que se incluyen Arlie Data Sense, Arlie Advisor y Arlie Recover.

P: ¿Cómo se relacionará AI Studio con AI Protect y Data Activate?

R: Los tres formarán parte de las capacidades de IA de próxima generación de Commvault. Data Activate ayuda a gestionar cómo se preparan y activan los datos para su uso en IA. AI Protect ayudará a gestionar los agentes que operan en producción. AI Studio ayudará a los equipos a implementar y crear flujos de trabajo de agentes personalizados. Juntos formarán un ciclo de vida integral de resiliencia de IA.

Teja Medasani es director principal de producto en Commvault y Vir Choksi es director principal de marketing de producto en Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Puntos clave

  • Apache Iceberg se ha convertido en un formato clave para los data lakehouse, y muchos clientes de AWS están migrando de las tablas Iceberg gestionadas por Glue a las tablas de Amazon S3 totalmente gestionadas para obtener un mejor rendimiento y una mayor automatización.
  • Clumio permite un proceso de migración fluido y compatible con Iceberg que ayuda a mantener la integridad de los datos, los metadatos y el historial de versiones, al tiempo que añade una protección inmutable y aislada.
  • La plataforma automatiza la migración mediante un sencillo flujo de trabajo de copia de seguridad y restauración, lo que ayuda a reducir la necesidad de scripts personalizados o configuraciones manuales.
  • En comparación con los métodos de migración manuales o nativos de AWS, Clumio ofrece una opción más rápida, escalable y resistente para la modernización de los «data lakehouse» empresariales.
  • La colaboración de Clumio con AWS y su disponibilidad en AWS Marketplace permiten a las organizaciones modernizar sus lagos de datos de forma segura y con confianza.

Las cargas de trabajo de análisis basadas en IA y sensibles a la latencia dependen cada vez más de los «data lakehouses» como arquitectura de datos subyacente. Entre los clientes de AWS que crean estos entornos, Apache Iceberg se ha convertido en uno de los formatos de tabla de más rápido crecimiento en Amazon S3, ya que proporciona la consistencia transaccional, la evolución del esquema y el rendimiento necesarios para el análisis moderno.

En la actualidad, los clientes de AWS gestionan las tablas Iceberg a través del AWS Glue Data Catalog o adoptan la opción totalmente gestionada de AWS, Amazon S3 Tables, para optimizar las operaciones y mejorar el rendimiento.

A medida que los clientes de AWS evalúan la creciente importancia de sus «data lakehouses» basados en Iceberg, las consideraciones en torno a la protección, la resiliencia y la migración a Amazon S3 Tables pasan a formar parte, de forma natural, de esa planificación. Muchos equipos buscan ahora una forma sencilla y fiable de pasar de las tablas Iceberg gestionadas por Glue a las tablas de S3, al tiempo que refuerzan la protección de estos conjuntos de datos críticos.

Como «Socio Global del Año en Almacenamiento 2025» de AWS, Commvault está profundizando su colaboración con AWS para ayudar a los clientes a modernizar, proteger y optimizar sus datos nativos de la nube.

A través de Clumio, Commvault ofrece una solución de ciberresiliencia compatible con Iceberg y con aislamiento físico para AWS, y ahora ayuda a automatizar la migración desde las tablas de Iceberg registradas en el catálogo de datos de AWS Glue a las tablas de Amazon S3, al tiempo que permite la protección y Recovery a largo plazo. Puedes iniciar tu prueba gratuita en AWS Marketplace.

El reto: opciones limitadas para migrar a tablas de S3

Las organizaciones están evaluando cada vez más la migración de tablas Iceberg gestionadas por Glue a tablas de Amazon S3 totalmente gestionadas para mejorar el rendimiento del lago de datos y simplificar las operaciones. Según AWS, las tablas de S3 pueden ofrecer un rendimiento de consulta hasta tres veces más rápido y hasta diez veces más transacciones por segundo en comparación con las tablas Iceberg almacenadas en buckets de S3 de uso general.

Muchos equipos también desean liberarse de tareas pesadas y repetitivas —como la compactación, la gestión de instantáneas y la limpieza de archivos sin referencias— al tiempo que reducen los costes generales de almacenamiento y consulta.

Sin embargo, las directrices existentes de AWS y de la comunidad, como el marco de migración de AWS, describen un proceso manual de varios pasos que requiere la creación de scripts personalizados y la orquestación. La migración de datos, al tiempo que se mantienen el esquema, los metadatos y el historial de versiones, puede llevar mucho tiempo y ser propensa a errores, y la mayoría de los enfoques actuales se centran en la replicación en lugar de en la Recovery o la reversión adaptadas a Iceberg.

El soporte de Clumio para la migración de tablas de Apache Iceberg proporciona la capacidad de migración y resiliencia de nivel empresarial adaptada a Iceberg que les faltaba a los modernos data lakehouses. Solicita una demostración para ver cómo Clumio agiliza tu migración.

Cómo simplifica Clumio la migración y la protección

Clumio para Apache Iceberg en AWS ayuda a automatizar la migración desde tablas de Iceberg registradas en el AWS Glue Data Catalog a tablas de Amazon S3, al tiempo que permite la protección a largo plazo de estos activos modernos de los «data lakehouses».

Esta misma plataforma, compatible con Iceberg, ofrece copias de seguridad inmutables y aisladas físicamente, puntos de recuperación aislados, restauraciones en un momento determinado o a nivel de instantánea, y capacidades de retención que ayudan a cumplir los requisitos de cumplimiento normativo, lo que refuerza el liderazgo de Commvault en ciberresiliencia nativa de la nube.

La migración y la protección van de la mano:

  • Ayuda a proteger las tablas de Iceberg registradas en el catálogo de datos de AWS Glue.
  • Restaure como tablas de Amazon S3 totalmente gestionadas.
  • Sigue protegiendo esas tablas de Iceberg con las capacidades de ciberresiliencia de Clumio.

Para los equipos que prefieren la implementación de «infraestructura como código», Clumio ofrece un módulo de Terraform disponible públicamente que es compatible con Apache Iceberg.

A medida que los clientes de AWS adoptan las tablas de Amazon S3, proteger estos activos de datos modernos cobra aún más importancia. Los vectores de amenaza, como el ransomware, el borrado accidental, los cambios maliciosos o erróneos y el compromiso de cuentas, pueden interrumpir los flujos de trabajo de IA y análisis y dar lugar a un costoso reprocesamiento. Clumio ayuda a los clientes a mitigar estos riesgos con copias de seguridad inmutables y aisladas físicamente, así como con opciones de Recovery flexibles que abarcan cuentas, regiones, instantáneas y momentos concretos. Para profundizar en por qué los data lakehouses necesitan una protección específica, consulta «Cerrar la brecha en la protección de los data lakehouses».

Cómo funciona: de la copia de seguridad a la restauración

El proceso de migración con Clumio sigue un flujo de trabajo sencillo de copia de seguridad y restauración, diseñado para minimizar el esfuerzo y ayudar a mantener la integridad de las tablas de Iceberg.

Paso 1: Ponte en contacto con el equipo de Commvault para revisar y aprobar el programa de migración. Ponte en contacto con nosotros.

Paso 2: Detecta y realiza una copia de seguridad de las tablas de Iceberg registradas en el catálogo de datos de AWS Glue, cuyos datos subyacentes se almacenan en S3, utilizando Clumio.

Paso 3: Restaure las copias de seguridad de las tablas Iceberg —ya sea el historial completo de instantáneas, un subconjunto seleccionado o una versión específica de un momento determinado— como tablas de Amazon S3 en cualquier cuenta o región.

Paso 4: Active las copias de seguridad incrementales para mantener la protección de sus nuevas tablas de Amazon S3.

La arquitectura de Clumio ayuda a reducir la necesidad de una recuperación de Iceberg con consistencia transaccional y facilita dicha recuperación en todas las cuentas, regiones e instantáneas.

Para ver el flujo de trabajo completo de la migración en acción —incluida la detección de Iceberg, la selección de copias de seguridad, las opciones de instantáneas y la restauración a tablas de Amazon S3—, vea el vídeo de demostración que se incluye a continuación. En él se recorre de principio a fin todo el proceso de copia de seguridad y restauración, mostrando cómo Clumio gestiona la migración de datos, metadatos e instantáneas sin necesidad de configuración manual.

Comparación de opciones de migración

La mayoría de las migraciones a Amazon S3 Tables dependen hoy en día de scripts manuales o herramientas nativas. A continuación se compara cómo estos métodos se contrastan con el enfoque de Clumio, compatible con Iceberg.

Método Descripción Consideraciones clave
Scripts «hazlo tú mismo»/
herramientas de código abierto
Scripts personalizados que utilizan las API de Athena o Glue para copiar datos y metadatos Ideal para equipos con experiencia en la creación de scripts y requisitos de migración personalizados
Procesos nativos de AWS/
instantáneas
La documentación de AWS y las guías de la comunidad describen migraciones basadas en instantáneas o impulsadas por consultas Adecuado para equipos que utilizan servicios nativos de AWS y gestionan procesos de migración de varios pasos
Clumio Solución de Backup and Recovery basada en SaaS y compatible con Iceberg para AWS Flujo de trabajo de migración sencillo y compatible con Iceberg que ayuda a conservar los metadatos y el historial de instantáneas, al tiempo que integra una protección continua

Solicita una demostración para descubrir cómo Clumio simplifica la migración a gran escala.

Por qué es importante para los clientes de AWS

A medida que los clientes de AWS modernizan sus lagos de datos, necesitan una forma sencilla y escalable de migrar tablas Iceberg a Amazon S3 Tables y protegerlas frente a riesgos operativos y cibernéticos. Clumio lo consigue ofreciendo una migración compatible con Iceberg junto con una protección inmutable y aislada físicamente.

AWS colabora con Commvault para ayudar a los clientes a utilizar Clumio tanto para la protección como para la migración a Amazon S3 Tables. La solución ya está disponible en AWS Marketplace y es compatible con las tablas Iceberg tanto en entornos de S3 Tables gestionados por Glue como en entornos totalmente gestionados. Juntos, Commvault y AWS ofrecen a las empresas una forma sencilla y escalable de modernizar sus canalizaciones de datos de IA.

Las organizaciones que deseen reforzar la resiliencia en toda la pila de datos de AWS pueden consultar nuestros blogs sobre la protección de datos de Amazon S3 con Clumio y Clumio Backtrack para Amazon DynamoDB.

Si desea comentar su estrategia de modernización de datos en AWS, póngase en contacto con nosotros.

Avanzando con Clumio y AWS

A medida que las organizaciones modernizan sus plataformas de datos para la IA, Clumio les ayuda a migrar con confianza a S3 Tables, a mantener la integridad de los datos y a reforzar su ciberresiliencia. Clumio simplifica la migración y la protección, ayudando a las organizaciones a proteger, recuperar y trasladar sus datos más valiosos con mayor rapidez.

Comienza tu prueba gratuita en AWS Marketplace.


Preguntas frecuentes

P: ¿Por qué las organizaciones están pasando de las tablas Iceberg autogestionadas a Amazon S3 Tables?
R: Muchos equipos están migrando a S3 Tables para mejorar el rendimiento y simplificar la gestión. Amazon S3 Tables ofrece un rendimiento de consulta hasta tres veces más rápido y un rendimiento de transacciones 10 veces superior al de las tablas Iceberg autogestionadas, al tiempo que reduce los gastos operativos.

P: ¿Cómo simplifica Clumio el proceso de migración?
R: Clumio automatiza la migración mediante un flujo de trabajo de copia de seguridad y restauración que mantiene la coherencia del esquema y los metadatos. Evita la creación manual de scripts y permite restaurar copias de seguridad de Iceberg directamente como tablas de S3 en diferentes cuentas y regiones.

P: ¿En qué se diferencia Clumio de otros enfoques de migración?
R: A diferencia de los scripts de creación propia o de los métodos nativos de AWS, Clumio está optimizado para Iceberg y es automatizado, además de ofrecer funciones integradas de ciberresiliencia, como copias de seguridad inmutables, Recovery a un momento determinado y capacidades de retención que ayudan a cumplir los requisitos de cumplimiento normativo.

P: ¿Cómo mejora Clumio la protección de los datos durante y después de la migración?
R: Clumio proporciona copias de seguridad inmutables y aisladas físicamente que ayudan a proteger contra el ransomware, el borrado accidental o los cambios maliciosos. También admite una recuperación flexible entre instantáneas, cuentas y regiones.

P: ¿Está Clumio ya disponible para los clientes de AWS?
R: Sí, Clumio está disponible en AWS Marketplace y se integra tanto con AWS Glue como con los entornos de tablas de Amazon S3, lo que permite a los clientes modernizar y proteger sus flujos de datos de IA.

P: ¿Cuál es el primer paso para empezar a utilizar Clumio para la migración de S3 Tables? R: Las organizaciones pueden empezar poniéndose en contacto con Commvault para obtener la aprobación del programa de migración y, a continuación, utilizar Clumio para detectar, realizar copias de seguridad y restaurar tablas de Iceberg como Amazon S3 Tables. Hay una versión de prueba gratuita disponible en AWS Marketplace. Vir Choksi es director principal de marketing de productos en Commvault. Blogs relacionados

More related posts


Clumio

Read more about Clumio