Deux pannes survenues en 48 heures ont paralysé le travail et les déplacements à travers les États-Unis la semaine dernière.
Les enquêtes sont en cours, mais les premiers rapports laissent entendre qu’il pourrait s’agir d’erreurs involontaires ou d’erreurs commises par les responsables eux-mêmes.
Jeudi, une modification du réseau a provoqué la panne de Microsoft 365 dans plus de 70 pays, et il a fallu environ un jour et demi pour que le service soit entièrement rétabli. Selon une première estimation, la perte de productivité s’élèverait à près de 7 milliards de dollars. Vendredi, de nouveaux équipements auraient surchargé les installations de télécommunications vieillissantes de la FAA, et tous les vols au départ du pays ont été cloués au sol pendant plus de quatre heures. Plus de 13 000 vols ont été annulés vendredi et samedi.
Si de simples changements de routine peuvent paralyser la messagerie électronique mondiale et l’espace aérien américain au cours de la même semaine, imaginez ce qu’une personne mal intentionnée pourrait faire. La résilience n’est plus un simple plan de secours. C’est une priorité au plus haut niveau de l’entreprise.
Les pannes majeures prennent de l’ampleur et sont de plus en plus fréquentes
Les pannes sont monnaie courante. Au début de l’année 2026, ThousandEyes a recensé entre 200 et 400 pannes de réseau par semaine dans le monde entier, et presque personne ne s’en est aperçu. Selon certains indicateurs, les pannes courantes sont même en baisse : l’Uptime Institute constate une diminution des taux de panne par site depuis cinq années consécutives.
Le problème se situe au plus haut niveau, où deux phénomènes se produisent simultanément.
Les pannes majeures sont plus fréquentes. Les pannes critiques chez les trois plus grands fournisseurs de cloud ont augmenté de 52 % entre 2022 et 2024, et le nombre d’heures perdues a augmenté de 51 %, pour atteindre 221 par an. L’année 2025 a été plus calme. Ce n’est pas le cas de 2026 : trois pannes majeures de Microsoft 365 et une interruption nationale des services, alors qu’il reste encore six semaines avant la fin de l’année.
Et elles sont plus importantes. Auparavant, une mauvaise journée coûtait des millions. La mise à jour défectueuse de CrowdStrike en juillet 2024 a coûté aux entreprises du Fortune 500 environ 5,4 milliards de dollars. La panne de Microsoft de cette semaine pourrait coûter 7 milliards de dollars rien qu’en perte de productivité.
En voici cinq survenues au cours des 13 derniers mois. Aucune n’a été attribuée à une attaque.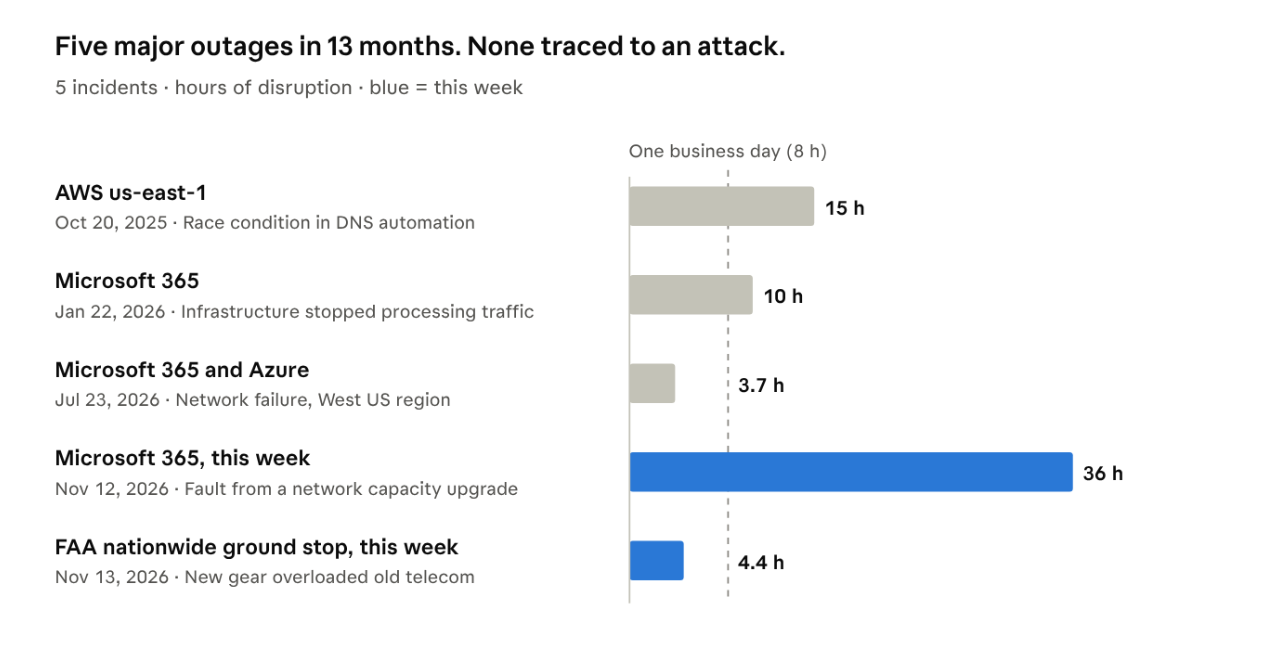 La panne de Microsoft de cette semaine a été la plus longue des cinq. Celle de la FAA a entraîné la plus longue suspension des vols à l’échelle nationale depuis 25 ans.
Voici ce qu’elles ont coûté, lorsque leur coût a pu être chiffré. Personne n’a publié d’estimation concernant les pannes de Microsoft de janvier et juillet.
| Panne | Perte économique estimée | Perte couverte par l’assurance | Estimation réalisée par |
|---|---|---|---|
| Microsoft 365, novembre 2026 | Environ 7 milliards de dollars de perte de productivité (chiffre provisoire) | 300 à 500 millions de dollars | Anderson Economic Group;Morningstar DBRS |
| Interdiction de décollage décrétée par la FAA, novembre 2026 | Chiffre non encore estimé ; les remboursements pourraient à eux seuls coûter des milliards aux compagnies aériennes | Pas encore évalué | Morningstar DBRS |
| AWS us-east-1, octobre 2025 | Entre 500 et 650 millions de dollars pour les entreprises américaines | 38 à 581 millions de dollars | Parametrix;CyberCube |
| Mise à jour CrowdStrike, juillet 2024 | 5,4 milliards de dollars pour les entreprises du Fortune 500 | entre 0,54 et 1,08 milliard de dollars | Parametrix |
L’assurance ne couvre qu’une fraction de ce montant. Après l’affaire CrowdStrike, les polices d’assurance couvraient environ 10 à 20 % des pertes subies par les entreprises du Fortune 500. Le reste était à la charge des entreprises qui n’avaient pourtant aucune responsabilité dans cette défaillance. Pour l’ensemble du Global 2000, Splunk et Oxford Economics ont estimé, dans une étude de 2024, le coût annuel des temps d’arrêt à 400 milliards de dollars, soit environ 9 % des bénéfices.
Pourquoi cela continue-t-il à se produire ?
Trois facteurs se combinent, et aucun d’entre eux n’est près de disparaître.
1. La concentration. AWS, Microsoft et Google détiennent 61 % d’un marché du cloud qui représente désormais 168 milliards de dollars par trimestre. Les fournisseurs tiers sont à l’origine d’environ deux tiers des pannes rendues publiques au cours des neuf dernières années. Lorsqu’un d’entre eux connaît une mauvaise journée, des milliers d’entreprises connaissent la même mauvaise journée au même moment.
2. Le rythme du changement. Les premiers rapports indiquent que les deux pannes de la semaine dernière ont été provoquées par une modification effectuée délibérément : une mise à niveau du réseau chez Microsoft, de nouveaux équipements à la FAA. L’Uptime Institute constate que les défaillances liées à la configuration et à la gestion du changement constituent la principale cause des pannes de réseau. Les systèmes complexes évoluent plus vite que notre compréhension des conséquences de ces changements.
3. L’IA. Les dépenses liées au cloud ont augmenté de 55 % au dernier trimestre, et l’IA en représente désormais environ un tiers. Cela se traduit par une charge accrue sur la même infrastructure partagée. Il s’agit également d’un nouveau type de charge de travail : des agents qui agissent de leur propre chef sur les systèmes de production. Ensemble, ces éléments constituent ce que nous appelons la vulnérabilité liée à l’IA. Gartner prévoit que, d’ici 2028, une IA mal configurée dans des systèmes cyber-physiques provoquera la paralysie d’une infrastructure critique nationale dans un pays du G20.
Pour ceux qui gagnent leur vie en s’attaquant aux infrastructures critiques, les perturbations de la semaine dernière ont montré à quel point les répercussions d’une seule défaillance peuvent être considérables. La défense est la même dans les deux cas : une architecture capable de se remettre d’une mise à jour défaillante est capable de se remettre d’une attaque.
Vos données ne peuvent pas être stockées à un seul endroit
Posez dès aujourd’hui une question à votre équipe : si notre cloud principal tombait en panne demain, d’où restaurerions-nous nos données, et vers quelle destination ? Pour de nombreuses entreprises, la réponse honnête est « le même cloud ». Leurs données, leurs sauvegardes et leur chemin de restauration reposent tous chez un seul fournisseur. Lorsque ce fournisseur subit une panne, il n’y a rien d’autre à faire qu’attendre.
Nous avons conçu Commvault Cloud pour qu’il y ait toujours un autre emplacement à partir duquel restaurer et un autre vers lequel restaurer : d’un cloud à un autre, d’un environnement sur site vers le cloud, et du cloud vers un environnement sur site.
| En cas de panne | Approche « mono-cloud » | Avec Commvault |
|---|---|---|
| Un seul cloud (Azure ou AWS) | Attendre que le fournisseur soit à nouveau opérationnel | Restaurer à partir de la copie stockée dans l’autre cloud ou sur site, puis y déployer les charges de travail |
| Le centre de données du client | Les restaurations dépendent de ce qui reste sur place | Restaurer à partir de la copie stockée dans le cloud et y exécuter les tâches jusqu’à ce que le site soit à nouveau opérationnel |
| Les deux nuages | Il est impossible de récupérer les données tant que l’un des deux n’est pas rétabli | Les clients qui conservent une copie en dehors du cloud public peuvent effectuer la restauration à partir de celle-ci et exécuter Recovery dans leur propre centre de données |
Je vais être franc au sujet de ce compromis. Chaque copie supplémentaire coûte de l’argent, et chaque environnement supplémentaire ajoute à la complexité. JeJ’ai écrit un article à ce sujet chez BCG: la plupart des entreprises qui se qualifiaient de « multicloud » exécutaient en réalité différentes charges de travail dans différents clouds, et la véritable portabilité était rare et coûteuse. C’était là une mise en garde pertinente en 2021. Le débat a évolué depuis.
L’architecture cloud native a changé la donne. Les charges de travail reposant sur des conteneurs et Kubernetes, avec une infrastructure définie par code et des données découplées de la plateforme sous-jacente, peuvent être déployées dans un deuxième cloud ou dans un centre de données sans avoir à être reconstruites. Toutes les charges de travail ne le valent pas. Mais pour la poignée de services dont une entreprise ne peut se passer, la résilience multicloud est aujourd’hui plus accessible que jamais, et depuis cette semaine, le coût de ne pas en disposer est beaucoup plus facile à chiffrer.
Ce n’est pas pour nous un simple point de la feuille de route. Aujourd’hui, les clients de Commvault transfèrent des machines virtuelles d’un hyperviseur à un autre et d’un cloud à un autre dans le cadre d’une restauration, et mettent en place un environnement de reprise propre et isolé, sur site ou dans le cloud, grâce à l’automatisation. De nombreux clients exécutent cette automatisation de manière routinière, et pas seulement en cas de crise.
Deux autres éléments sont tout aussi importants que le fait de disposer d’un autre endroit où se replier.
• La visibilité. On ne peut pas restaurer ce qu’on ne voit pas. Trop d’entreprises ne découvrent où se trouvent leurs données critiques, et ce qui n’a jamais été protégé, qu’au moment même d’une panne. Commvault offre à ses clients une vue d’ensemble en temps réel de l’emplacement de leurs données, de ce qui est protégé et de ce qui est exposé, avant même qu’un incident ne se produise.
• Les agents IA. Les agents intègrent désormais une logique métier, ce qui en fait des applications de production. Ils nécessitent les mêmes garanties que n’importe quelle autre charge de travail critique, et la plupart des entreprises n’en sont pas encore là. Grâce à AgentRecover, actuellement en accès anticipé pour Microsoft Foundry et bientôt disponible sur Amazon Bedrock AgentCore en décembre, nous pouvons auditer les actions d’un agent et restaurer à la fois l’agent et les applications qu’il a modifiées.
Trois mesures que les RSSI et les conseils d’administration devraient prendre cette semaine
1. Identifiez les éléments qui tombent en panne simultanément. Prenez vos dix services métier les plus critiques et remontez la piste de chacun d’entre eux jusqu’à la région cloud et au fournisseur d’identité dont il dépend. Vous recherchez les éléments dont le sort est lié, et le premier endroit où chercher est vos propres sauvegardes : se trouvent-elles dans le même cloud que les systèmes qu’elles protègent, et pouvez-vous les restaurer ailleurs ? Le conseil d’administration doit pouvoir obtenir une réponse claire à une question : quelle défaillance d’un seul fournisseur nous mettrait hors service, et pour combien de temps ?
2. Mesurez votre temps de reprise lors d’un test en conditions réelles. Déterminez quels services doivent être opérationnels dès le premier jour et quel est le coût de chaque heure d’indisponibilité. Ensuite, dans le cadre d’un exercice inopiné, au moins une fois par trimestre, retirez un fournisseur du système et chronométrez le temps nécessaire pour revenir à un état de fonctionnement normal. Une simulation sur table ne compte pas. Le chiffre à présenter au conseil d’administration est le temps moyen de reprise complète, tel qu’il a été mesuré.
3. Soumettez les agents d’IA aux mêmes règles que les systèmes de production. Connaissez chaque agent que vous exécutez, les données auxquelles il a accès et ce qu’il peut modifier. Exigez une piste d’audit et un moyen de revenir en arrière, tant pour l’agent que pour tout ce qu’il a modifié. Si personne n’est en mesure de vous dire ce qu’un agent a fait mardi dernier et comment annuler cette action, il n’est pas prêt à se voir confier davantage de responsabilités.
Avant le prochain incident
La semaine dernière, il s’agissait d’une répétition générale qui a coûté des milliards. La prochaine fois, l’action pourrait être malveillante, ou un agent d’IA pourrait procéder à la modification. Préparez-vous dès maintenant à cette éventualité. Cela implique une Recovery continue : à mettre en place avant le prochain incident, et non pendant celui-ci.
Sources
- Quelles sont les causes de la panne de Microsoft 365 du 12 novembre 2026 — Control Plane
- Les responsables attribuent la panne au vieillissement des équipements de télécommunication de la FAA — GeekWire
- La FAA lève l’interdiction de décollage à l’échelle nationale — CBS News
- Les voyageurs bloqués à l’aéroport de Dallas-Fort Worth se débattent — CBS Texas
- Interdiction de décollage de la FAA et panne de Microsoft : l’IA a-t-elle joué un rôle ? — KingyAI
- Les perturbations à l’échelle nationale mettent en évidence les risques liés à la dépendance technologique — The National Desk
- Analyse annuelle des pannes 2026 — Uptime Institute
- Marché du cloud au 3e trimestre 2026 — Synergy Research via TechInsights
- Bilan de la panne d’AWS us-east-1 — BleepingComputer
- La panne de Microsoft 365 a duré près de 10 heures — The Register
- Panne des services Microsoft 365, le 23 juillet 2026 — Actualités sur la cybersécurité
- La panne de CrowdStrike a coûté 5,4 milliards de dollars aux entreprises du Fortune 500 — Axios / Parametrix
- Les coûts cachés des temps d’arrêt — Splunk et Oxford Economics
- Gartner : d’ici 2028, une IA mal configurée paralysera les infrastructures critiques d’un pays du G20
- La panne de Microsoft pourrait entraîner une perte de productivité de 7 milliards de dollars — CNN
- Les services Microsoft sont à nouveau opérationnels après 38 heures d’interruption ; pertes estimées : 300 à 500 millions de dollars — NewsDrum / Reuters
- Microsoft 365 de nouveau opérationnel après une panne mondiale — Bright Defense
- Dernières nouvelles sur l’interdiction de décollage imposée par la FAA ; Morningstar et DBRS s’expriment sur les remboursements — The Globe and Mail
- L’interruption des vols ordonnée par la FAA a duré 4 heures et 21 minutes — Informed Clearly
- Panne AWS us-east-1 : pertes aux États-Unis comprises entre 500 et 650 millions de dollars — Parametrix
- Estimation des pertes couvertes par les assurances liées à la panne d’AWS : entre 38 et 581 millions de dollars — Risk & Insurance / CyberCube
- Les pannes critiques du cloud ont augmenté de 52 % depuis 2022 — CXOToday / Parametrix
- Baisse des incidents critiques liés au cloud en 2025 — Parametrix
- Nombre hebdomadaire de pannes recensées par ThousandEyes au 1er trimestre 2026 — DEV