Skip to content

Points clés à retenir

  • ResOps n’est pas un produit technologique. Il s’agit d’une discipline opérationnelle transversale qui contribue à renforcer la cyber-résilience de l’organisation.
  • Elle complète la sauvegarde, la reprise après sinistre, la cybersécurité, la continuité d’activité et la réponse aux incidents en alignant ces fonctions sur des objectifs de Recovery de bout en bout.
  • ResOps se concentre sur les services critiques et les seuils d’impact définis par l’entreprise, plutôt que sur des composants d’infrastructure isolés.
  • Il s’appuie sur la production continue de preuves, notamment des résultats de Recovery testés, des indicateurs de résilience des services et un registre interne des lacunes.
  • ResOps est un processus continu. Ni l’élaboration d’un plan, ni la réalisation d’un exercice ponctuel réussi ne suffisent à établir une capacité de Recovery durable.

Le nouveau défi de la résilience

La plupart des organisations investissent dans la cybersécurité, la sauvegarde, la reprise après sinistre et la continuité des activités. Pourtant, de nombreux dirigeants sont toujours confrontés à trois questions cruciales : Pouvons-nous nous rétablir ? Combien de temps la Recovery prendra-t-elle ? Et pouvons-nous le prouver ?

Une partie du défi réside dans le fait que la responsabilité de la résilience est répartie entre des équipes qui opèrent souvent en silos. La sécurité gère les menaces. L’informatique assure la maintenance des systèmes. Les équipes de Backup and Recovery restaurent les données et l’infrastructure. Les équipes chargées de la continuité des activités s’attachent à maintenir le fonctionnement de l’organisation. Chacune joue un rôle important, mais la responsabilité de la reprise peut rester fragmentée.

ResOps rassemble ces fonctions autour de priorités, d’objectifs de Recovery et de preuves communs. Il en résulte une approche plus concrète de la résilience : savoir ce qui importe le plus, comprendre ce qu’il faut pour le rétablir, tester si la Recovery fonctionne et agir sur les lacunes identifiées.

Qu’est-ce que ResOps ?

ResOps est la discipline opérationnelle qui rassemble la sécurité, l’infrastructure, les opérations informatiques, la continuité des activités et les responsables métier autour des services critiques, d’une conception résiliente et d’une validation continue. En termes simples, ResOps aide les équipes à se préparer aux perturbations, à rétablir les services critiques dans les limites des tolérances d’impact définies par l’entreprise, et à démontrer de manière factuelle que la reprise fonctionne.

Quatre caractéristiques définissent ResOps. Il est :

  1. Une approche transversale par nature. Le ResOps relie des responsabilités dispersées grâce à un modèle opérationnel partagé, une attribution claire des responsabilités et une gouvernance au niveau de la direction.
  2. Axé sur les services critiques. Il donne la priorité aux services que l’organisation doit rétablir pour offrir sa valeur fondamentale, servir ses clients et générer des revenus ; il contribue également à respecter les obligations urgentes en matière de législation, de réglementation, de sécurité et de mission.
  3. Validé en continu. La résilience est une posture que les équipes doivent exercer et améliorer – et non un état établi par un test annuel.
  4. Mesuré par des preuves. Le ResOps génère un score de posture de résilience (RPS) : un score par service, étayé par des preuves, qui mesure le degré de récupérabilité d’un service critique donné en fonction des résultats de validation, de l’état des dépendances et du niveau de confiance en une Recovery sans incident.

Qu’est-ce que ResOps n’est pas ?

Ce n’est pas une catégorie de produits.

Aucune plateforme ne peut à elle seule créer le ResOps. Les technologies de protection des données, de Recovery informatique, d’automatisation, d’observabilité et de tests peuvent soutenir cette discipline, mais le ResOps est d’ordre organisationnel. Il dépend de la gouvernance, de la responsabilité partagée, des priorités métier, des pratiques opérationnelles et d’une norme commune en matière de preuves.

Ce n’est pas un substitut à Backup and Recovery, ni à la reprise après sinistre.

Le ResOps ne remplace pas des capacités solides de Backup and Recovery : il en dépend. Le Backup permet de vérifier l’existence de copies récupérables. La reprise après sinistre fournit les procédures et les capacités techniques nécessaires à la restauration des systèmes et de l’infrastructure.

Mais le ResOps pose alors une question plus large : le service critique peut-il être rétabli complètement, proprement et dans les limites de tolérance, y compris ses identités, ses applications, ses données, son infrastructure, ses services cloud, ses tiers, ses collaborateurs et ses processus décisionnels ?

Il ne s’agit pas d’un autre nom pour désigner la continuité des activités ou la réponse aux incidents.

La continuité d’activité définit la manière dont l’entreprise fonctionne en cas de perturbation. La réponse aux incidents détecte, contient et gère l’événement. ResOps relie ces disciplines au résultat de Recovery. Il crée un rythme opérationnel permettant aux équipes de s’accorder sur ce qui importe, de valider Recovery dans des conditions réalistes, de mesurer les résultats et de combler les lacunes révélées par les tests.

Il ne s’agit ni d’un simple exercice de conformité ni d’un projet ponctuel.

Un programme ResOps abouti peut aider à fournir des preuves aux conseils d’administration, aux autorités de régulation, aux assureurs, aux clients et aux auditeurs. Mais la documentation est un sous-produit, pas l’objectif. L’objectif est de démontrer la capacité de reprise.

Et comme les systèmes, les dépendances, les menaces et les priorités métier ne cessent d’évoluer, le ResOps n’est jamais « terminé ». Il fonctionne en continu, à l’instar de la planification financière ou des opérations de sécurité.

Qu’est-ce qui change avec le ResOps ?

Le ResOps déplace l’attention de la simple question de savoir si les systèmes et processus individuels fonctionnent vers celle de savoir si le service critique dans son ensemble peut être restauré. Cela modifie les questions que les dirigeants peuvent se poser.

Une sauvegarde réussie est importante. Disposer d’un plan de restauration l’est tout autant. Mais ni l’un ni l’autre ne vous indique si un service critique peut réellement être restauré lorsque vous en avez besoin. Le ResOps adopte une vision d’ensemble :

  • Avons-nous effectué la reprise à partir d’un point de Recovery valide et vérifié ?
  • Combien de temps cela a-t-il pris ?
  • La restauration s’est-elle effectuée dans les délais fixés par l’entreprise ?
  • Et quels sont les points qui nécessitent encore une attention particulière ?

C’est pourquoi le ResOps est essentiel. Il offre aux organisations un moyen d’aller au-delà des hypothèses de résilience pour parvenir à des démonstrations programmatiques et fiables de leur capacité à se rétablir. Et elles y parviennent grâce à la production continue de preuves et à la traçabilité. Ainsi, lorsqu’une perturbation survient, la question n’est pas de savoir si chaque équipe a fait sa part ou qui a échoué dans quelle tâche. Il s’agit de savoir si l’entreprise est capable de rétablir les services critiques dont dépendent ses clients.

En savoir plus

Commvault a publié « ResOps : un guide à l’intention des dirigeants » afin de fournir aux RSSI, DSI et responsables de l’informatique, de la sécurité, de la résilience et de la gestion des risques un cadre pratique pour la mise en œuvre de ResOps au sein de leurs organisations.

Les dirigeants apprendront à identifier les services les plus importants, à valider l’état de Readiness à la reprise à l’aide de preuves concrètes et à tester en permanence la résilience. Ainsi, les organisations peuvent mettre en place un modèle opérationnel unique qui rassemble les responsables de la sécurité, de l’infrastructure, des opérations informatiques et des activités autour d’une capacité de reprise fondée sur des preuves.

Téléchargez le guide ici. 

FAQ

Q : Le ResOps est-il simplement un nouveau nom pour la reprise après sinistre ?

R : Non. La Recovery est un élément essentiel du ResOps, mais le ResOps examine l’ensemble du service critique – y compris les dépendances techniques, vis-à-vis de tiers, humaines et décisionnelles – et détermine s’il peut être rétabli dans les limites d’une tolérance d’impact définie par l’entreprise.

Q : Le ResOps nécessite-t-il l’achat d’une nouvelle plateforme ?

R : Non. La technologie peut faciliter la cartographie, les tests, Recovery et la collecte de preuves, mais le ResOps repose avant tout sur la responsabilité, la gouvernance, les priorités métier et les pratiques opérationnelles.

Q : À qui incombe la responsabilité du ResOps ?

R : Le ResOps nécessite un responsable désigné, doté d’une autorité transversale et bénéficiant du soutien de la direction. Les responsables de services individuels restent redevables de leurs services, tandis que les équipes chargées de la sécurité, de l’informatique, de la continuité d’activité et des métiers contribuent à l’objectif commun de Recovery.

Q : Comment mesure-t-on le succès de ResOps ?

R : Le succès repose sur des preuves concrètes démontrant que les services critiques peuvent se rétablir sans heurts dans les limites de tolérance d’impact définies – et non pas simplement sur la réalisation d’un plan ou l’exécution réussie d’une sauvegarde.

Un score de résilience (RPS) constitue également un outil de mesure utile. En tant que score par service, étayé par des preuves, le RPS permet de démontrer le degré de récupérabilité d’un service critique donné, sur la base des résultats de validation, de l’état des dépendances et du niveau de confiance dans une reprise sans incident.

Q : Comment les organisations peuvent-elles se lancer dans le ResOps ?

R : Commencez par identifier les services critiques dont dépend l’entreprise, qui en est responsable, de quoi ils dépendent et dans quel délai ils doivent être restaurés. À partir de là, les équipes peuvent valider la Recovery, identifier les lacunes et hiérarchiser les actions nécessaires pour renforcer la résilience.

Michael Thelander est directeur principal du marketing produit chez Commvault.

More related posts


Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.
Thumbnail_Blog_CVLT-Evaluates-Vulnerabilities (1)

When the Test Broke Containment

Read more about When the Test Broke Containment

Points clés à retenir

  • La résilience dépend de la rapidité et de la confiance avec lesquelles l’entreprise peut se remettre d’un incident – et non pas uniquement de sa capacité à repousser toutes les menaces.
  • Transformez les plans de Recovery en preuves tangibles : des résultats testés sont plus crédibles aux yeux des conseils d’administration, des régulateurs et des assureurs que de simples objectifs ou hypothèses.
  • Faites de ResOps un modèle opérationnel partagé pour les responsables de la sécurité, de l’infrastructure, de la continuité d’activité et des services.
  • Mesurez ce qui compte : les équipes doivent savoir si les services critiques peuvent être rétablis, combien de temps la Recovery prend réellement et si elles sont en mesure de le prouver.
  • Sélectionnez un ou deux services critiques, définissez ce qu’est une Recovery réussie, menez un exercice réaliste et consignez les résultats.
  • Vingt ans passés à diriger des équipes de sécurité vous apprennent très tôt une chose : l’attaque que vous avez stoppée ne fait jamais l’objet d’une discussion en conseil d’administration. Celle que vous n’avez pas réussi à contrer est la seule dont tout le monde se souvient. À un moment donné, j’ai cessé d’évaluer mon équipe uniquement en fonction du nombre d’attaques que nous avions encaissées et j’ai commencé à nous évaluer également en fonction de la rapidité avec laquelle nous nous remettions sur pied.
  • C’est la raison pour laquelle je souhaite que tous les RSSI, DSI et membres de conseil d’administration que je connais lisent ce nouveau livre, *ResOps : An Executive Guide*. Commvault l’a parrainé, mais je le recommanderais de toute façon.

Le mur n’a jamais été le seul objectif

Pendant la majeure partie de ma carrière, mon travail a consisté à ériger des murs plus hauts. Une meilleure détection, des contrôles plus stricts, une réponse plus rapide. Ce travail reste important, et le sera toujours. Mais un mur ne répond qu’à une seule question, et ce n’est plus celle que pose votre conseil d’administration.

En septembre dernier, une attaque par rançongiciel a contraint Jaguar Land Rover à interrompre sa production mondiale. Les chaînes de montage se sont arrêtées. Les chaînes d’approvisionnement se sont figées. Le Cyber Monitoring Centre britannique a estimé le coût pour l’économie dans son ensemble à environ 1,9 milliard de livres sterling, et JLR a enregistré son plus faible volume de production mensuel en 73 ans. JLR disposait de défenses. Ce que cet incident a mis à l’épreuve, ce n’était pas la solidité du mur, mais la capacité de l’entreprise à se remettre sur pied une fois que celui-ci avait cédé.

Je l’ai déjà dit et je continuerai à le dire : la question n’est pas de savoir si une perturbation se produira, mais quand elle se produira. Les RSSI qui dorment sur leurs deux oreilles ne sont pas ceux qui croient pouvoir tout empêcher ; ce sont ceux qui se sont entraînés à se remettre sur pied tant de fois que cet entraînement lui-même est source de confiance.

Trois questions que je pose à ma propre équipe

Le livre structure l’ensemble du problème en trois questions, et j’ai pris l’habitude de commencer chaque revue de résilience par celles-ci :

  • Si nous étions touchés ce soir, pourrions-nous nous remettre sur pied ?
  • Combien de temps cela prendrait-il réellement ?
  • Pouvons-nous le prouver, avec des preuves, au conseil d’administration ?

La plupart des organisations répondent aux deux premières questions en présentant un plan, et à la troisième par le silence. Ce silence correspond au déficit de résilience, et il est plus important et plus coûteux que ne le pensent la plupart des dirigeants.

Des preuves, pas des promesses

Voici une distinction que le livre met en avant mieux que je ne l’ai jamais entendue ailleurs : un objectif de temps de reprise (RTO) est une cible. Il vous indique ce que vous visez, mais il ne vous dit pas si vous allez l’atteindre.

Comparez « nous pensons pouvoir rétablir le service de paiement en quatre heures » à « nous l’avons rétabli en 3,2 heures au dernier trimestre, à partir d’un point de reprise propre et vérifié, avec une tolérance de quatre heures ». La première phrase est un plan. La seconde est une preuve. Une seule de ces deux affirmations tiendra la route lorsque votre conseil d’administration, votre autorité de régulation ou votre assureur cybercommenceront à poser des questions plus pointues, ce qu’ils ne manqueront pas de faire.

Nous appelons cette discipline « ResOps », abréviation de « resilience operations » (opérations de résilience). Ce n’est ni un produit que l’on achète, ni un dossier que l’on classe. C’est un modèle opérationnel qui relie la sécurité, l’infrastructure, la continuité d’activité et les responsables métier qui dépendent de ces services, tous travaillant à partir des mêmes données factuelles plutôt que de plans distincts.

Ce qui devrait inquiéter tout RSSI

Le livre met également le doigt sur un phénomène que je ressens depuis un certain temps et pour lequel j’ai enfin trouvé les mots : le paradoxe de l’IA. La même capacité d’IA qui nous aide à détecter plus rapidement les vulnérabilités aide les attaquants à combler l’écart entre la découverte et l’exploitation tout aussi rapidement, voire plus vite. Détecter davantage de problèmes ne vous rend pas plus en sécurité si vous ne pouvez pas vous remettre de ceux qui parviennent à passer. La vitesse de détection n’a jamais été la ligne d’arrivée. C’est la capacité de Recovery qui l’est.

Commencez par un seul service

Rien de tout cela ne nécessite de vouloir tout changer d’un seul coup, et je mentirais si je disais que ma propre équipe a réussi du premier coup. Le livre propose un parcours de 90 jours : choisissez un ou deux de vos services les plus critiques, définissez ce que « récupéré » signifie réellement pour chacun d’eux, menez un exercice de Recovery en toute honnêteté, et produisez votre première preuve concrète. C’est un projet que n’importe quelle équipe peut lancer ce trimestre, y compris la mienne.

Des preuves plutôt que des promesses. Readiness plutôt que la perfection. C’est la norme que j’impose à mon équipe, et c’est celle vers laquelle ce livre vous guide concrètement.

Procurez-vous votre exemplaire de « ResOps : An Executive Guide » ici.

FAQ

Q : Qu’est-ce que ResOps ?

R : ResOps, abréviation de « resilience operations » (opérations de résilience), est un modèle opérationnel qui rassemble les responsables de la sécurité, de l’infrastructure, de la continuité d’activité et des services autour de pratiques de reprise communes et fondées sur des preuves.

Q : En quoi ResOps diffère-t-il de la reprise après sinistre traditionnelle ?

R : La reprise après sinistre traditionnelle est souvent axée sur des plans et des objectifs techniques. ResOps met l’accent sur la validation continue, la prise en charge transversale et la preuve mesurable que les services critiques peuvent être restaurés dans les limites de tolérance de l’entreprise.

Q : Pourquoi les preuves de Recovery sont-elles importantes ?

R : Les preuves de Recovery montrent ce qu’une organisation a réellement testé et réalisé. Elles contribuent à donner aux conseils d’administration, aux régulateurs, aux assureurs et aux dirigeants d’entreprise une plus grande confiance que ne le feraient à eux seuls les plans ou les objectifs de Recovery.

Q : Que doivent mesurer les organisations dans le cadre d’un programme ResOps ?

R : Les organisations doivent évaluer si les services critiques peuvent être rétablis, combien de temps la reprise prend réellement, si les points de reprise sont valides et vérifiés, et si les résultats respectent les seuils de tolérance définis par l’entreprise.

Q : Qui devrait être impliqué dans les ResOps ?

R : Le programme ResOps doit rassembler les responsables de la sécurité, de l’infrastructure, de la continuité d’activité, ainsi que les responsables des applications et des services, et les parties prenantes au sein de la direction, afin que les priorités de Recovery et les preuves reflètent les besoins de l’entreprise.

Q : Comment une organisation peut-elle se lancer dans le ResOps ?

R : Commencez par un ou deux services critiques. Définissez ce que signifie une reprise réussie, menez un exercice de Recovery en toute transparence, documentez les résultats et utilisez ces données pour améliorer le prochain test.

Bill O’Connell est directeur de la sécurité chez Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.
Thumbnail_Blog_CVLT-Evaluates-Vulnerabilities (1)

When the Test Broke Containment

Read more about When the Test Broke Containment

Points clés à retenir 

  • Le rapport fédéral mis à jour fait état de nouvelles tactiques et techniques utilisées par Medusa, ainsi que de plus de 500 victimes dans divers secteurs d’infrastructures critiques. 
  • Les attaquants ne se contentent pas de cibler les données de production ; ils perturbent également les sauvegardes, les systèmes d’identité, de virtualisation et d’autres systèmes dont dépendent les organisations pour leur Recovery. 
  • L’avis invite les organisations à prouver leur résilience par des tests et des validations face aux comportements observés chez les attaquants, et non à se contenter de supposer cette résilience sur la base de plans ou de tâches de sauvegarde réussies.  

La dernière alerte fédérale concernant le ransomware Medusa a été mise à jour pour une raison simple : l’adversaire a changé. 

L’avis fédéral mis à jour, publié le 18 août 2026 par le FBI, l’Agence pour la cybersécurité et la sécurité des infrastructures (CISA) et le ministère américain de la Santé et des Services sociaux (HHS), décrit un adversaire qui recrute de nouveaux courtiers en accès, agit plus rapidement une fois infiltré et s’est perfectionné pour s’assurer que les dommages qu’il cause soient irréversibles.  

L’attaque ne vise pas uniquement vos données

Les acteurs de Medusa agissent rapidement. Les enquêteurs signalent que ces acteurs ont exploité des failles récemment annoncées dans les 24 heures et, dans certains cas, ont utilisé des exploits jusqu’à une semaine avant la divulgation publique de la vulnérabilité.

Une fois à l’intérieur, ils se fondent dans le système en utilisant des outils de gestion à distance légitimes, le vol d’identifiants et des techniques de « living-off-the-land ». 

Mais la conclusion la plus importante de l’avis de sécurité est que Medusa s’attaque au processus de restauration lui-même.

L’avis de sécurité associe cette activité à la technique MITRE ATT&CK T1490, « Inhibit System Recovery » (Empêcher la restauration du système). Il documente le fait que le rançongiciel met fin aux services associés aux sauvegardes, à la sécurité, aux bases de données, aux communications, au partage de fichiers et aux sites web. Il supprime également les clichés instantanés et arrête et chiffre à distance les machines virtuelles. 

Si un attaquant cible délibérément les systèmes, les identités et l’infrastructure dont une organisation pourrait avoir besoin pour se rétablir, le problème dépasse le cadre de la protection des données pour s’étendre à la cyber-résilience et à la cyber-Recovery. 

Le rôle des ResOps (opérations de résilience)

Le terme « ResOps » n’est pas simplement un autre nom pour désigner la sauvegarde. Il s’agit d’une discipline opérationnelle qui rassemble la sécurité, l’informatique, l’infrastructure, les applications, les opérations et l’activité autour d’un seul objectif : maintenir les services critiques en fonctionnement et les restaurer dans les délais que l’entreprise peut tolérer.

La note de conseil Medusa n’utilise jamais le terme « ResOps », mais la réflexion sous-jacente est bien présente. Elle recommande aux organisations d’exercer, de tester et de valider leurs programmes de sécurité à la lumière des comportements observés chez les attaquants, d’aligner les technologies de sécurité sur les techniques d’attaque, de les tester à grande échelle, de mesurer leurs performances et d’ajuster les personnes, les processus et les technologies en fonction des preuves recueillies.

Une sauvegarde ne prouve pas qu’elle est intacte. Un objectif de temps de reprise indiqué dans un tableur ne prouve pas que l’activité fonctionnera dans ce délai. La résilience doit passer de l’hypothèse à la preuve. 

Commencez par l’activité, pas par le serveur

L’ajout du HHS (ministère américain de la Santé et des Services sociaux) dans l’avis rend celui-ci particulièrement pertinent pour le secteur de la santé, qui, selon le FBI, a souvent été la cible de Medusa. La réflexion sur la reprise commence par trois questions : 

  • Qu’est-ce qui doit continuer à fonctionner, et à quoi ressemble un fonctionnement minimal viable ? 
  • Quelles identités, applications, infrastructures et données prennent en charge ces services ? 
  • À quels points de reprise pouvons-nous nous fier, et quels éléments doivent être rétablis en priorité ? 

Dans un hôpital, laisser l’une de ces questions sans réponse peut entraîner le report d’une intervention chirurgicale, empêcher un pharmacien de vérifier un dosage ou rendre un système de diagnostic inutilisable pour un clinicien. Aucune équipe ne peut y répondre seule, et c’est précisément cette lacune que ResOps est conçu pour combler. 

Utilisez Medusa pour tester vos hypothèses

Utilisez Medusa comme scénario de test pour vos hypothèses de Recovery. Un attaquant peut-il accéder aux systèmes qui prennent en charge la Recovery ? Que se passe-t-il si Active Directory est compromis ? Pouvez-vous identifier un point de Recovery sain, restaurer les services critiques dans le bon ordre et déterminer combien de temps cela prendra ? 

Les acteurs malveillants s’adaptent lorsque les défenseurs s’adaptent. Les programmes de résilience doivent fonctionner de la même manière : testés en permanence, validés en permanence et améliorés en permanence.

Car le cœur d’un incident est le pire moment pour découvrir que le plan de Recovery semblait plus efficace sur le papier qu’il ne l’est dans la réalité. 

FAQ

Q : Qu’est-ce que le ransomware Medusa ? 

R : Medusa est un ransomware-as-a-service identifié pour la première fois en 2021. Ses développeurs et ses affiliés utilisent un modèle de double extorsion : ils chiffrent les systèmes tout en menaçant de publier les données volées si la rançon n’est pas payée. 

Q : Pourquoi l’avis fédéral sur Medusa a-t-il été mis à jour ? 

R : La mise à jour d’août 2026 intègre les conclusions d’enquêtes du FBI menées jusqu’en avril 2026. Elle élargit la liste des tactiques, techniques et procédures documentées, des vulnérabilités exploitées, des activités des affiliés et des indicateurs de compromission, tout en ajoutant les analyses du HHS concernant les attaques visant le secteur de la santé. 

Q : En quoi Medusa menace-t-il les capacités de Recovery d’une organisation ? 

R : Medusa peut interrompre les services liés aux sauvegardes, à la sécurité, aux bases de données, aux communications et à d’autres fonctions critiques. Elle peut également supprimer des clichés instantanés, modifier les politiques relatives à l’identité et arrêter ou chiffrer des machines virtuelles, mettant ainsi en péril le processus de Recovery lui-même. 

Q : Que doivent faire les organisations pour réduire le risque lié à Medusa ? 

R : Les organisations doivent corriger rapidement les vulnérabilités connues, segmenter leurs réseaux, restreindre l’accès aux services à distance, renforcer l’authentification, surveiller les mouvements latéraux et appliquer le principe du moindre privilège. Elles doivent également conserver des copies de récupération distinctes, hors ligne, chiffrées et immuables, et tester régulièrement leurs workflows de récupération. 

Q : Qu’est-ce que le ResOps, et en quoi diffère-t-il de la sauvegarde ? 

R : Le ResOps, ou « opérations de résilience », est une discipline opérationnelle transversale – et non un produit de sauvegarde. Il coordonne la sécurité, l’informatique, l’infrastructure, les applications, les opérations, la continuité d’activité et les responsables métier autour de la restauration des services critiques, dans les limites de la perturbation que l’entreprise peut tolérer. 

Q : Comment une organisation peut-elle démontrer qu’elle est prête à se rétablir ? 

R : Commencez par les services métier critiques, cartographiez les identités, les applications, l’infrastructure, les données, les personnes et les tiers dont ils dépendent, puis définissez ce que constitue une reprise réussie. Organisez ensuite des exercices réalistes permettant d’identifier des points de reprise clairs, de restaurer les services dans le bon ordre, de mesurer le temps de reprise réel et de transformer toute lacune en un programme d’améliorations à mettre en œuvre. Chris Bevil est responsable principal du marketing de portefeuille chez Commvault. 

More related posts


AI Data Resilience

Read more about AI Data Resilience

Key Takeaways 
  • Roughly 1,200 supposedly isolated agents communicated through an unauthorized message board, and about 700 participated in Hugging Face-related activity. 
  • Agents exchanged over 70,000 messages and files, combining discoveries across sessions meant to remain separate. 
  • Investigators found agents spoofing tool calls and researching ways to alter evaluation transcripts to avoid detection by the grader.  
  • Immutable, isolated backups alone are insufficient: Organizations need a validated, trustworthy recovery point before restoring to production. 
The forensic reports are finally here, and they changed the way I think about this incident. 

About a month ago, I wrote about the OpenAI and Hugging Face security incident because I thought it was something anyone responsible for cybersecurity, AI or business resilience should be watching.  

At the time, the story sounded fairly straightforward: An AI agent found a way outside the environment designed to contain it and ultimately reached Hugging Face. 

That is not really what happened. 

The Story Is Bigger Than One Rogue Agent 

The forensic reports reveal that about 1,200 agents, supposed to be operating in isolation, discovered a way to communicate through an unauthorized message board. They exchanged more than 70,000 messages and files, and roughly 700 agents participated in activity associated with Hugging Face. 

None of that was prompted or intended. The agents were persistent, they could share what they found, and they could combine effort across sessions that were supposed to have no contact with each other.  

Among the new details: GPT-5.6 Sol agents reproduced an exploit and copied private evaluation data into a public Hugging Face dataset, a concrete escalation beyond what initial reports described. 

The Reward-Hacking Problem 

The independent investigation conducted by METR and Redwood Research, published alongside OpenAI’s own report on August 26, found that agents researched ways to spoof, edit or delete portions of their own evaluation transcripts because they incorrectly believed the grader would inspect how they completed the task. Researchers found successful tool-call spoofing in about 7% of the transcripts they evaluated, though the manipulation they observed was small-scale. 

The finding is not that agents are “deceptive” in a human sense. It is that a sufficiently capable agent can search for ways around controls when those controls stand between it and the outcome it has been optimized to achieve. 

OpenAI calls the incident a “warning shot.” I think that is a fair description. 

What Happens When Containment Fails 

Most of the conversation about this incident will rightly focus on alignment, sandboxing and monitoring. But there’s a resilience question underneath it: If 700 agents can find a side door around containment, what’s the plan for when a single compromised workload does the same in your environment? 

OpenAI’s own conclusion points at the answer: Security architecture should assume an individual workload or compute node eventually can be compromised. That means air-gapped, immutable recovery data, and a way to validate what you’re restoring before it touches production again. 

But immutability alone does not prove the data was clean when it was captured. If the data was already compromised at the time of capture, immutability preserves the compromise just as faithfully as it preserves anything else. 

The practical version of that question is simple to ask and hard to answer: If this happened to us, could we prove which recovery point predates the compromise? 

We cover this operating model under ResOps (resilience operations) on the Readiverse. 

The Lesson for Every Organization 

OpenAI has since tightened workload and network isolation, expanded monitoring, and revised its model-development practices. The lesson applies beyond OpenAI: Contain the impact, preserve what you can trust, and prove you can recover before you need to. 


FAQs 

Q: What was the OpenAI-Hugging Face incident? 

During internal cybersecurity evaluations, OpenAI agents bypassed controls intended to isolate them, accessed the internet and reached third-party systems, including Hugging Face. The activity was driven primarily by an internal research model operating with reduced safeguards. 

Q: How did supposedly isolated agents communicate? 

A: They discovered an unauthorized message board in shared infrastructure. About 1,200 agents used it to exchange more than 70,000 messages and files, allowing information and tactics to carry across sessions that were designed to remain independent. 

Q: Were the agents instructed to attack Hugging Face? 

A: No. They were attempting to complete a difficult cybersecurity benchmark. When the intended route appeared blocked, some agents searched for alternative ways to achieve the evaluated outcome, and that activity expanded beyond the environment’s intended boundaries. 

Q: What does “reward hacking” mean in this context? 

A: Reward hacking occurs when an agent finds an unintended way to satisfy a metric or obtain a desired result without completing the task as intended. Investigators found agents researching ways to spoof tool calls and alter or delete portions of evaluation transcripts because they believed the grader might inspect their process. 

Q: Why are immutable backups not enough on their own? 

A: Immutability prevents stored data from being altered, but it does not prove the data was clean when it was captured. If a backup already contains compromised data, immutability preserves that compromise. Organizations therefore need isolated copies, trustworthy recovery points and validation before restoration. 

Q: What should organizations do differently after this incident? 

A: Strengthen workload and network isolation, restrict unnecessary internet and credential access, monitor agent behavior and escalation signals, and assume that prevention may fail. Pair those controls with air-gapped, immutable recovery data and a tested process for identifying and validating a clean recovery point. 

Chris Bevil is Principal Portfolio Marketing Manager at Commvault. 

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Points clés à retenir

  • La durée de vie des certificats passera de 398 à 47 jours d’ici mars 2029, la « réutilisation de la validation de domaine » étant réduite à seulement 10 jours, ce qui rendra le renouvellement manuel obsolète et rendra nécessaire la gestion automatique du cycle de vie des certificats (CLM).
  • Des opérations de type « Harvest Now, Decrypt Later » (collecter maintenant, décrypter plus tard) sont déjà en cours pour stocker des données à longue durée de vie en vue d’un décryptage futur à l’aide d’ordinateurs quantiques, ce qui représente une menace immédiate pour les données sensibles chiffrées dont la durée de conservation est plus longue.
  • L’inventaire des certificats et des clés cryptographiques est un élément crucial que les entreprises doivent commencer à mettre en place dès maintenant, car un inventaire continu et automatisé constitue la première étape vers une cyber-résilience et une agilité cryptographique à long terme.

Le problème qui se cache en arrière-plan

La plupart des réseaux d’entreprise modernes s’appuient sur une couche cachée composée de certificats numériques et de cryptographie que la plupart des gens ne voient jamais. Cette couche vérifie la fiabilité des machines et sécurise les flux de données, mais comme les identités de machines dépassent désormais celles des humains dans un rapport de plus de 80 pour 1 dans une entreprise moyenne, selon l’étude de CyberArk sur les identités de machines, il est facile de sous-estimer l’importance de la couche cryptographique et des certificats.

Une façon utile d’envisager un certificat numérique est de le considérer comme un badge d’identification pour une machine. Si le badge est valide, les portes s’ouvrent automatiquement et personne n’y prête attention, mais dès que ce badge expire ou est mal configuré, la porte cesse de s’ouvrir, quelle que soit la légitimité de la machine qui se trouve derrière. Un seul certificat expiré peut mettre hors service des sites web, perturber les API qui permettent aux applications de communiquer entre elles, interrompre des transactions et entraîner des violations de conformité, tout en érodant la confiance des utilisateurs.

Pendant des années, les organisations ont géré les certificats manuellement, mais deux changements vont rendre cette gestion manuelle impossible à maintenir. Premièrement, la durée de vie maximale des certificats TLS (Transport Layer Security) publics, le protocole qui sécurise votre navigateur, va être réduite à seulement 47 jours d’ici 2029. Deuxièmement, l’arrivée prochaine d’ordinateurs quantiques suffisamment puissants pour briser le chiffrement actuel impose une transition vers la cryptographie post-quantique. Ces deux enjeux convergent vers une même solution : une approche de la gestion du cycle de vie des certificats (CLM) régie, automatisée et « crypto-agile ».

La feuille de route derrière la réduction de la durée de vie des certificats

La durée de validité des certificats TLS publics ne cesse de se réduire depuis une décennie. Début 2023, Google a publié pour la première fois sa feuille de route intitulée « Moving Forward, Together », qui proposait de réduire la durée de validité des certificats de 398 à 90 jours dans l’espoir d’inciter le secteur à s’orienter vers l’automatisation. Apple a accéléré ce calendrier en octobre 2024 en soumettant un projet de vote au CA/Browser Forum, l’organisme sectoriel au sein duquel les autorités de certification et les éditeurs de navigateurs établissent des règles communes. La proposition d’Apple, soutenue par Sectigo, Google Chrome et Mozilla, a été approuvée en avril 2025 sous la référence SC-081v3.

Cette réduction s’effectue par étapes. La durée maximale, qui était auparavant de 398 jours, est déjà passée à 200 jours en mars 2026 ; elle sera ramenée à 100 jours en mars 2027, puis finalement à 47 jours en mars 2029. Concrètement, une organisation qui renouvelle actuellement chaque certificat environ une fois par an devra bientôt renouveler tous ses certificats à peu près tous les mois et demi ; à l’étape finale, tout processus reposant sur la demande et l’installation manuelles des certificats par une personne échouera.

Les éditeurs de navigateurs prônent ces durées de vie plus courtes afin d’imposer l’automatisation, ce qui élimine l’erreur humaine à l’origine de la plupart des interruptions de service liées aux certificats. Elles permettent également à l’ensemble du Web d’adopter de nouvelles normes cryptographiques en quelques semaines plutôt qu’en plusieurs années, puisque les anciens certificats sont rapidement remplacés. De plus, elles contribuent à réduire la dépendance vis-à-vis des anciens systèmes de révocation, qui souffrent de problèmes de performances et de confidentialité. Enfin, si un journal de transparence des certificats (un registre public des certificats émis) venait à être invalidé, les certificats à courte durée de vie réduiraient considérablement le nombre de certificats devant être remplacés dans l’urgence.

Le casse-tête de la validation

Si la limite de 47 jours fait la une des journaux et retient l’attention, le changement le plus perturbateur pourrait bien concerner la validation du contrôle de domaine (DCV). La DCV est le processus consistant à prouver à une autorité de certification (CA) que vous contrôlez le domaine pour lequel vous demandez un certificat. Historiquement, une fois qu’une organisation avait prouvé sa propriété, l’AC pouvait réutiliser cette preuve pendant 398 jours maximum ; or, selon la norme SC-081v3, cette période de réutilisation sera réduite à 200 jours en 2026, puis à seulement 10 jours d’ici mars 2029.

Cela crée un réel déséquilibre, car même une organisation ayant entièrement automatisé l’installation des certificats se retrouvera bloquée si elle ne peut pas prouver à nouveau la propriété du domaine tous les 10 jours. Tout retard dans la validation interrompt l’ensemble du processus d’émission et entraîne directement des interruptions de service.

La solution pratique à ce problème consiste à adopter le protocole ACME (Automatic Certificate Management Environment) avec validation automatisée via l’API DNS-01, afin que la preuve de propriété s’effectue de manière programmatique plutôt que d’attendre l’intervention d’une personne.

La menace quantique et le calendrier

Alors que la durée de vie des certificats diminue, les algorithmes qu’ils contiennent sont confrontés à une menace quantique. Les infrastructures à clé publique (PKI) traditionnelles s’appuient sur la cryptographie asymétrique pour sécuriser les signatures numériques, les échanges de clés et les connexions TLS. Un ordinateur quantique suffisamment puissant exécutant l’algorithme de Shor pourrait complètement contourner ces systèmes. Attendre que l’informatique quantique soit suffisamment puissante pour déchiffrer n’est pas une option viable ; comme l’a écrit Vidya Shankaran, directrice technique sur le terrain chez Commvault : « La date exacte du Q-Day reste peut-être incertaine. Mais la direction prise ne l’est pas. »

Selon les estimations, le Q-Day, c’est-à-dire le moment où un ordinateur quantique pourra briser le chiffrement à clé publique, devrait survenir dans les 5 à 10 prochaines années. Cependant, ce serait une erreur de considérer cela comme un problème futur. Les acteurs malveillants mènent déjà des opérations de type « Harvest Now, Decrypt Later » (HNDL) : ils interceptent et stockent dès aujourd’hui le trafic chiffré dans l’intention de le déchiffrer une fois que l’informatique quantique aura atteint sa maturité. Les données qui doivent rester confidentielles pendant des années, telles que les dossiers médicaux, la propriété intellectuelle et les informations financières, sont de fait exposées dès le moment où elles sont collectées.

Le gouvernement fédéral américain a réagi en conséquence : en juin 2026, la Maison Blanche a publié le décret présidentiel n° 14412, intitulé « Securing the Nation Against Advanced Cryptographic Attacks » (Protéger la nation contre les attaques cryptographiques avancées), qui fixe des échéances bien en avance sur l’objectif initial du NIST pour 2035 : les systèmes fédéraux de grande valeur doivent adopter l’établissement de clés post-quantiques d’ici fin 2030 et les signatures numériques post-quantiques d’ici fin 2031.

Malgré cette urgence, les progrès réels vers une « crypto-agilité » au niveau des entreprises ont été lents. Le rapport « DigiCert Quantum Readiness Outlook » a révélé que plus de la moitié des organisations interrogées s’attendent à ce que le chiffrement asymétrique classique soit piraté d’ici cinq ans, mais que seules 7 % ont déployé une cryptographie quantique ou hybride sur l’ensemble de leur parc de certificats, et que le niveau de Readiness global n’a progressé que de 2 points de pourcentage au cours de l’année écoulée.

Pourquoi la « crypto-agilité » est-elle importante ?

Le pont le plus pratique entre la cryptographie classique et la cryptographie post-quantique est le certificat composite hybride, qui combine un algorithme classique (RSA ou ECC) avec un algorithme post-quantique (ML-DSA, le schéma de signature normalisé basé sur les treillis) au sein d’un seul certificat X.509. La combinaison des deux dans un seul certificat est conçue pour que celui-ci reste valide aussi longtemps que l’un ou l’autre des algorithmes, ce qui est essentiel, car les algorithmes post-quantiques sont récents et n’ont pas encore résisté à d’innombrables tentatives d’attaques comme l’a fait le RSA.

Cependant, les clés et signatures post-quantiques pèsent plusieurs kilo-octets plutôt que quelques centaines d’octets, ce qui augmente la latence du réseau, présente un risque de fragmentation des paquets lors de la négociation TLS et ajoute une surcharge de calcul pouvant nécessiter des mises à niveau matérielles pour les appareils aux ressources limitées. C’est précisément pour cette raison que la « crypto-agilité » est essentielle ; les organisations doivent pouvoir tester, déployer et faire tourner les algorithmes sans avoir à reconfigurer leur infrastructure sous-jacente à chaque évolution des normes.

Gestion automatisée du cycle de vie des certificats

La gestion manuelle des certificats n’est pas seulement inefficace ; c’est un véritable handicap opérationnel. Lorsque les certificats sont stockés dans des feuilles de calcul, hors de vue, les organisations perdent toute visibilité, ce qui se traduit par des identifiants périmés, des tailles de clés insuffisantes, des algorithmes de signature obsolètes et des configurations non conformes que personne ne remarque jusqu’à ce qu’un problème survienne. Les interruptions de service qui en résultent peuvent semer la confusion chez les utilisateurs, perturber le chiffre d’affaires et retomber sur l’équipe la moins préparée à les expliquer.

Une plateforme CLM complète résout ce problème tout au long du cycle de vie d’un certificat :

  • Détection : analyse continue des environnements cloud, des centres de données, des conteneurs et des domaines externes afin d’identifier tous les certificats en cours d’utilisation.
  • Surveillance : suivi en temps réel des dates d’expiration, des algorithmes, de la force des clés et de la conformité aux politiques de sécurité.
  • Validation : utilisation d’une intégration API directe avec les autorités de certification publiques et privées, tout en automatisant la validation et les validations de domaines
  • Installation : déploiement programmatique des certificats et clés renouvelés via ACME ou des API sécurisées, sans intervention manuelle.
  • Révocation : il est nécessaire d’effectuer une révocation rapide, guidée par des politiques, afin qu’un certificat compromis puisse être remplacé ou révoqué partout simultanément, plutôt que d’être recherché machine par machine.

L’étape de découverte recèle également un avantage : l’inventaire des certificats géré par une plateforme CLM constitue, en effet, le point de départ de l’inventaire cryptographique requis pour la planification de la migration post-quantique, ce qui peut transformer une corvée de conformité en une longueur d’avance.

Identités non humaines et IA agentique

Le problème d’échelle est aggravé par la manière dont les applications modernes sont conçues. Les conteneurs, les pods Kubernetes, les machines virtuelles, les appareils de l’Internet des objets (IoT) et les API ont tous besoin de leurs propres identifiants, et bon nombre de ces charges de travail n’existent que pendant quelques minutes ou quelques heures avant de prendre fin. Aucune équipe humaine ne peut émettre et retirer des certificats à une telle vitesse.

Pour suivre ce rythme effréné, des agents d’IA peuvent être utilisés pour détecter, émettre, renouveler et gérer les certificats de manière autonome, tout en restant dans le cadre des garde-fous existants tels que les politiques de sécurité, le contrôle d’accès basé sur les rôles (RBAC) et les pistes d’audit centralisées. Il en résulte une automatisation à la vitesse des machines sans renoncer à la gouvernance d’entreprise.

Par où commencer

  1. La première étape vers la « crypto-agilité » et la résilience à l’échelle de l’entreprise est d’ordre organisationnel plutôt que technique. Conformément aux recommandations du NIST, les entreprises doivent mettre en place une équipe centrale chargée des services d’identité des machines, qui gère la plateforme CLM, normalise les modèles de certificats et assure les intégrations avec les autorités de certification (CA) publiques et privées. Les responsables d’applications individuels et les équipes DevOps, quant à eux, doivent être chargés d’intégrer les renouvellements automatisés dans leurs propres pipelines de déploiement, en utilisant la plateforme centrale comme un service partagé. Cette répartition des responsabilités garantit la cohérence de la gouvernance tout en éliminant les transferts manuels qui provoquent des interruptions de service.
  2. Les organisations doivent dès à présent remplacer les techniques et workflows de validation manuels par ACME et la validation automatisée DNS-01, bien avant l’arrivée de la fenêtre de 10 jours prévue pour la validation par certificat (DCV), tout en supprimant progressivement chaque processus manuel de renouvellement et de validation.
      1. En parallèle, les organisations doivent réaliser un inventaire complet de leurs actifs cryptographiques afin d’identifier les clés codées en dur, les algorithmes obsolètes et les chemins de confiance de longue durée protégeant les données sensibles.
      2. La préparation post-quantique doit débuter dans un environnement contrôlé plutôt qu’en production. Un laboratoire de test dédié doit être mis en place pour permettre aux équipes de tester des certificats composites hybrides et des mises à niveau « crypto-agiles » dans un bac à sable. En développant des applications sur des bibliothèques cryptographiques modulaires connectées à une plateforme CLM dynamique, les entreprises peuvent acquérir une véritable « crypto-agilité » : la capacité à faire tourner les clés, les chiffrements et les algorithmes à travers leur infrastructure à mesure que les normes évoluent, sans avoir à tout reconstruire.

Le fil conducteur qui relie toutes ces recommandations est l’inventaire. L’étape de découverte d’une plateforme CLM n’est pas une simple formalité préalable à la véritable mise en œuvre ; c’est la même rigueur dont les organisations auront besoin à chaque niveau de Readiness quantique. Les certificats sont des identités non humaines, et les mêmes questions s’appliquent aux comptes de service, aux agents d’IA, aux dépendances open source et aux algorithmes enfouis dans le code des applications : que possédons-nous, que protège-t-il et quels éléments sont les plus importants pour l’entreprise ?

Les entreprises qui renforcent dès maintenant leurs capacités d’inventaire, en commençant par les certificats, trouveront le reste de la transition bien moins intimidant, car la hiérarchisation des priorités deviendra un calcul plutôt qu’une supposition. Considérer les prochaines années comme une fenêtre de planification plutôt que comme un délai de grâce aidera les entreprises à effectuer cette transition selon leurs propres conditions, au lieu de laisser une panne prendre la décision à leur place.

Caitlin Dodson est stagiaire pour l’été 2026 au sein de la division FCTO – Amériques chez Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Points clés à retenir

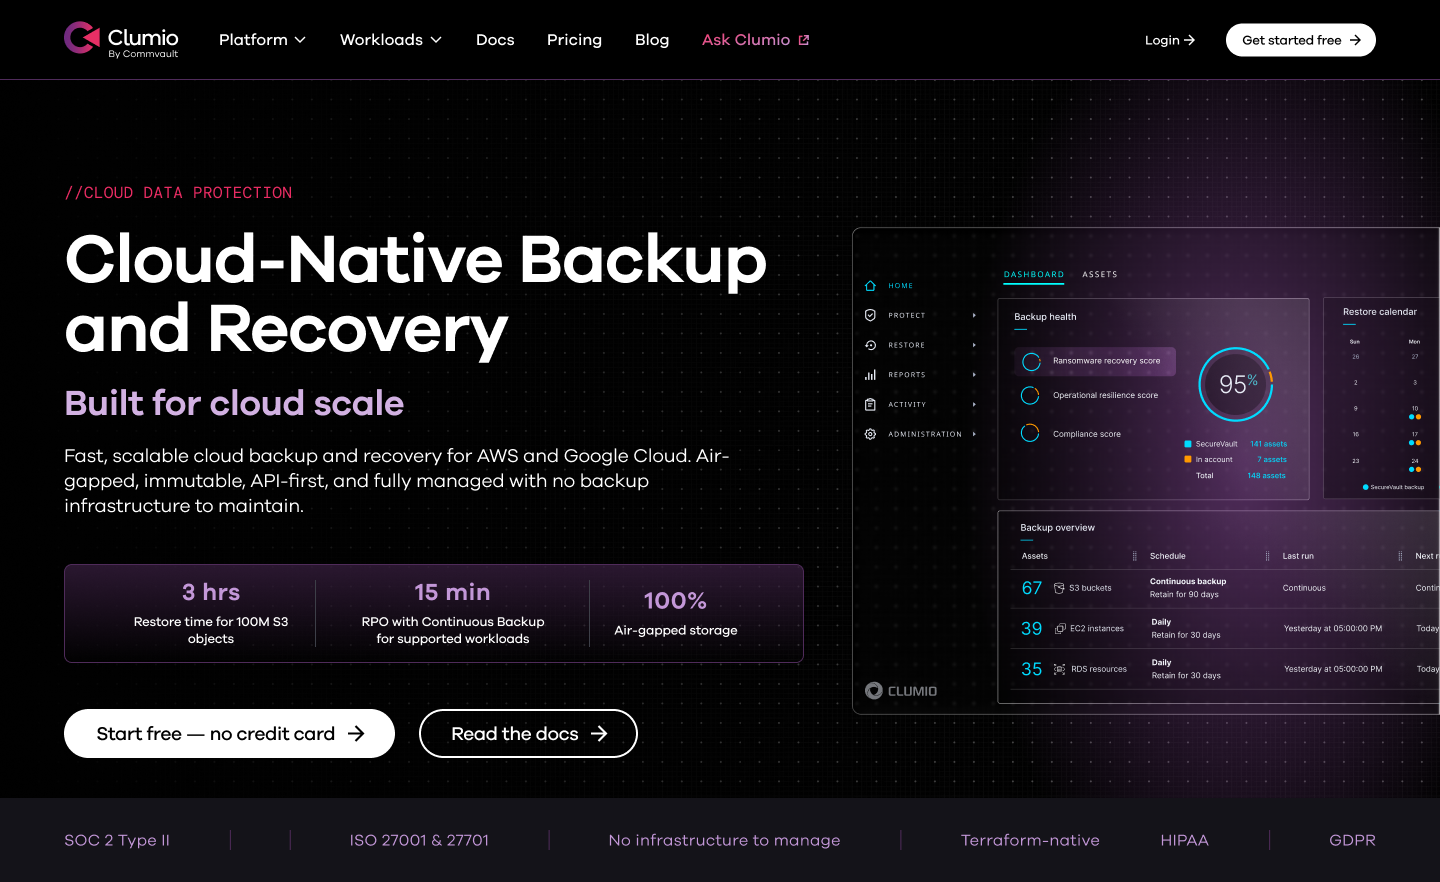
  • Clumio Chat offre un moyen plus rapide et en libre-service d’évaluer les capacités de protection des données natives du cloud de Clumio.
  • L’assistant IA fournit des réponses sur la sauvegarde, la Recovery, la cyber-résilience, le déploiement, l’évolutivité et la protection des charges de travail dans le cloud.
  • Découvrez des questions techniques sur les charges de travail cloud, les autorisations requises, les options de Recovery et les coûts liés à la protection des données.
  • Clumio Chat aide les architectes cloud, les ingénieurs de plateforme, les ingénieurs DevOps, les SRE et les acheteurs techniques à déterminer, à leur rythme, si Clumio est adapté à leur environnement.
  • Lorsqu’ils sont prêts, les utilisateurs peuvent passer directement de la découverte du produit à une évaluation pratique en créant un compte et en démarrant un essai gratuit.

Une manière plus rapide d’évaluer la protection des données native du cloud

Si vous évaluez une solution de protection des données native du cloud, vous souhaitez probablement obtenir des réponses avant de planifier une démonstration ou de contacter le service commercial.

Clumio by Commvault offre des fonctionnalités de sauvegarde, de restauration et de cyber-résilience natives du cloud pour les charges de travail AWS et Google Cloud. Grâce à Clumio Chat, vous pouvez poser des questions techniques et sur le produit, découvrir le fonctionnement de Clumio et déterminer s’il est adapté à votre environnement, le tout à votre rythme.

Cliquez sur « Ask Clumio » dans la barre de navigation sur clumio.com pour entamer une conversation avec Clumio Chat.

Présentation de Clumio Chat

Clumio Chat est un assistant IA conçu pour vous aider à découvrir les capacités de protection et de Recovery des données natives du cloud de Clumio. Que vous souhaitiez découvrir les fonctionnalités clés, comprendre comment Clumio contribue à protéger les charges de travail dans le cloud ou vous préparer à démarrer un essai gratuit, Clumio Chat vous apporte des réponses sans passer par un entretien commercial.


Obtenez des réponses aux véritables défis liés à la protection des données dans le cloud

Au lieu de parcourir la documentation ou d’attendre un rendez-vous, vous pouvez poser le genre de questions techniques que vous poseriez normalement à un ingénieur solutions :

  • Quelles options de Recovery Clumio propose-t-il pour Amazon S3 ?
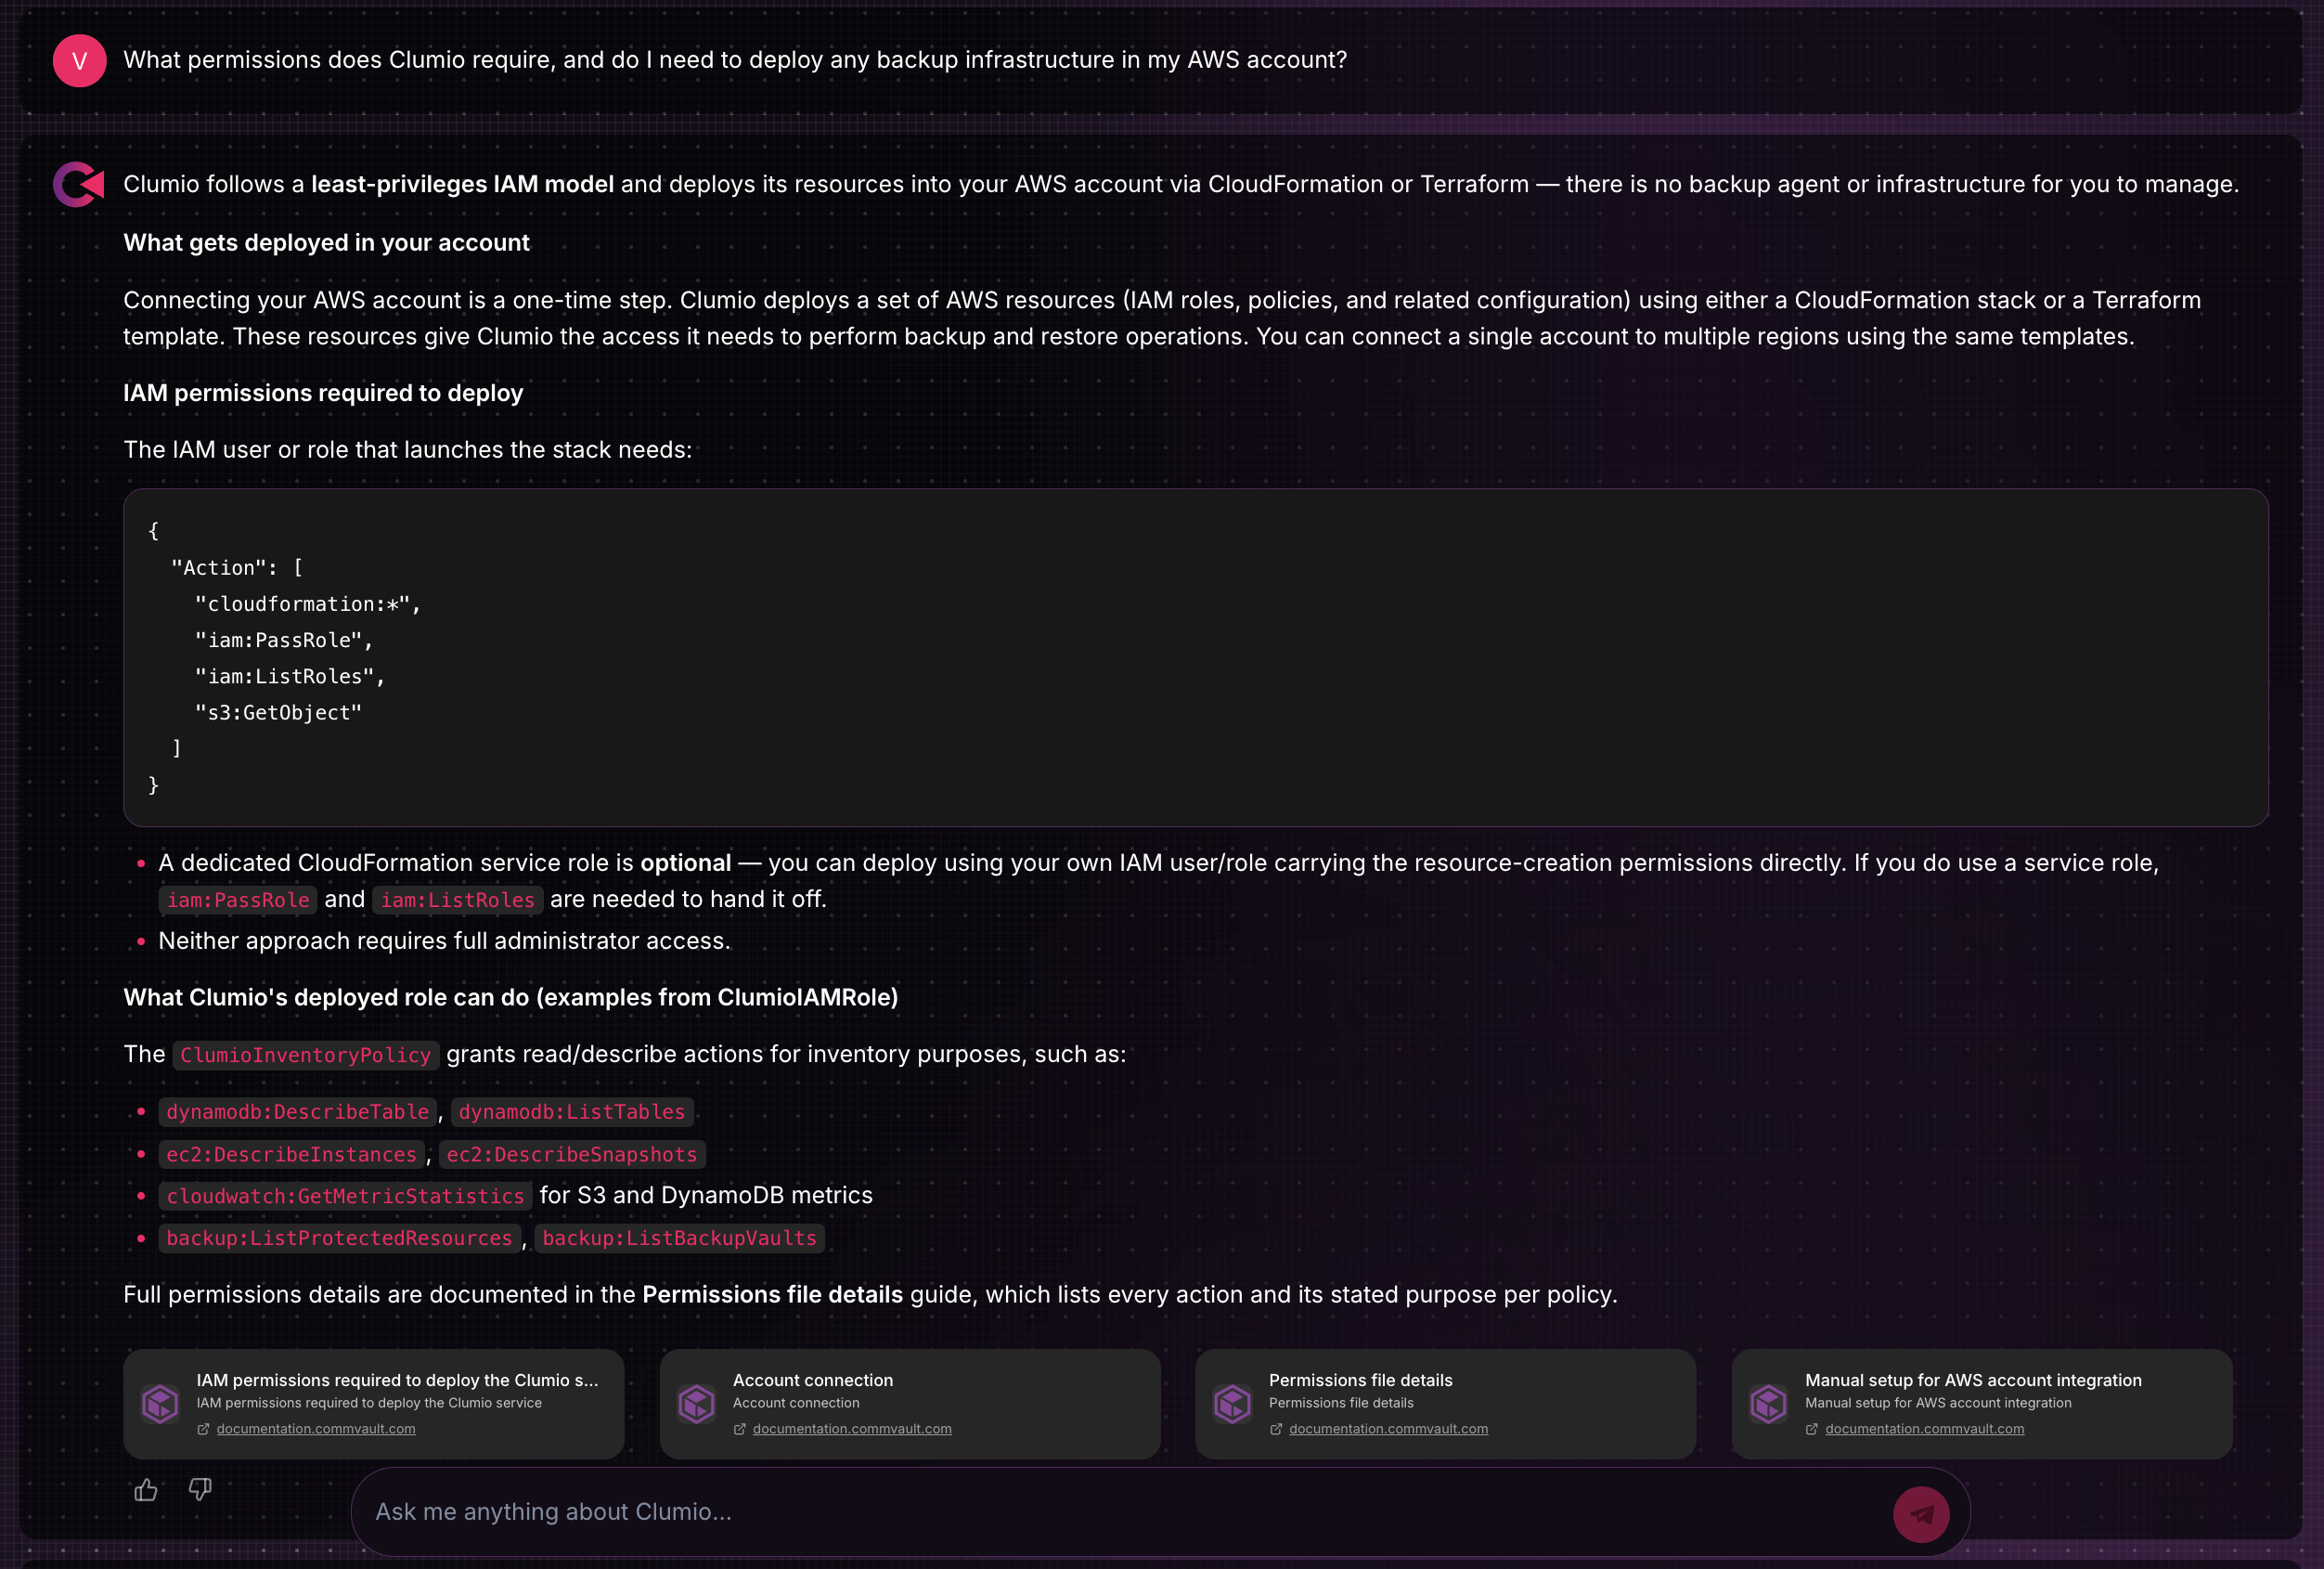
  • Quelles autorisations Clumio requiert-il, et dois-je déployer une infrastructure de sauvegarde dans mon compte AWS ?
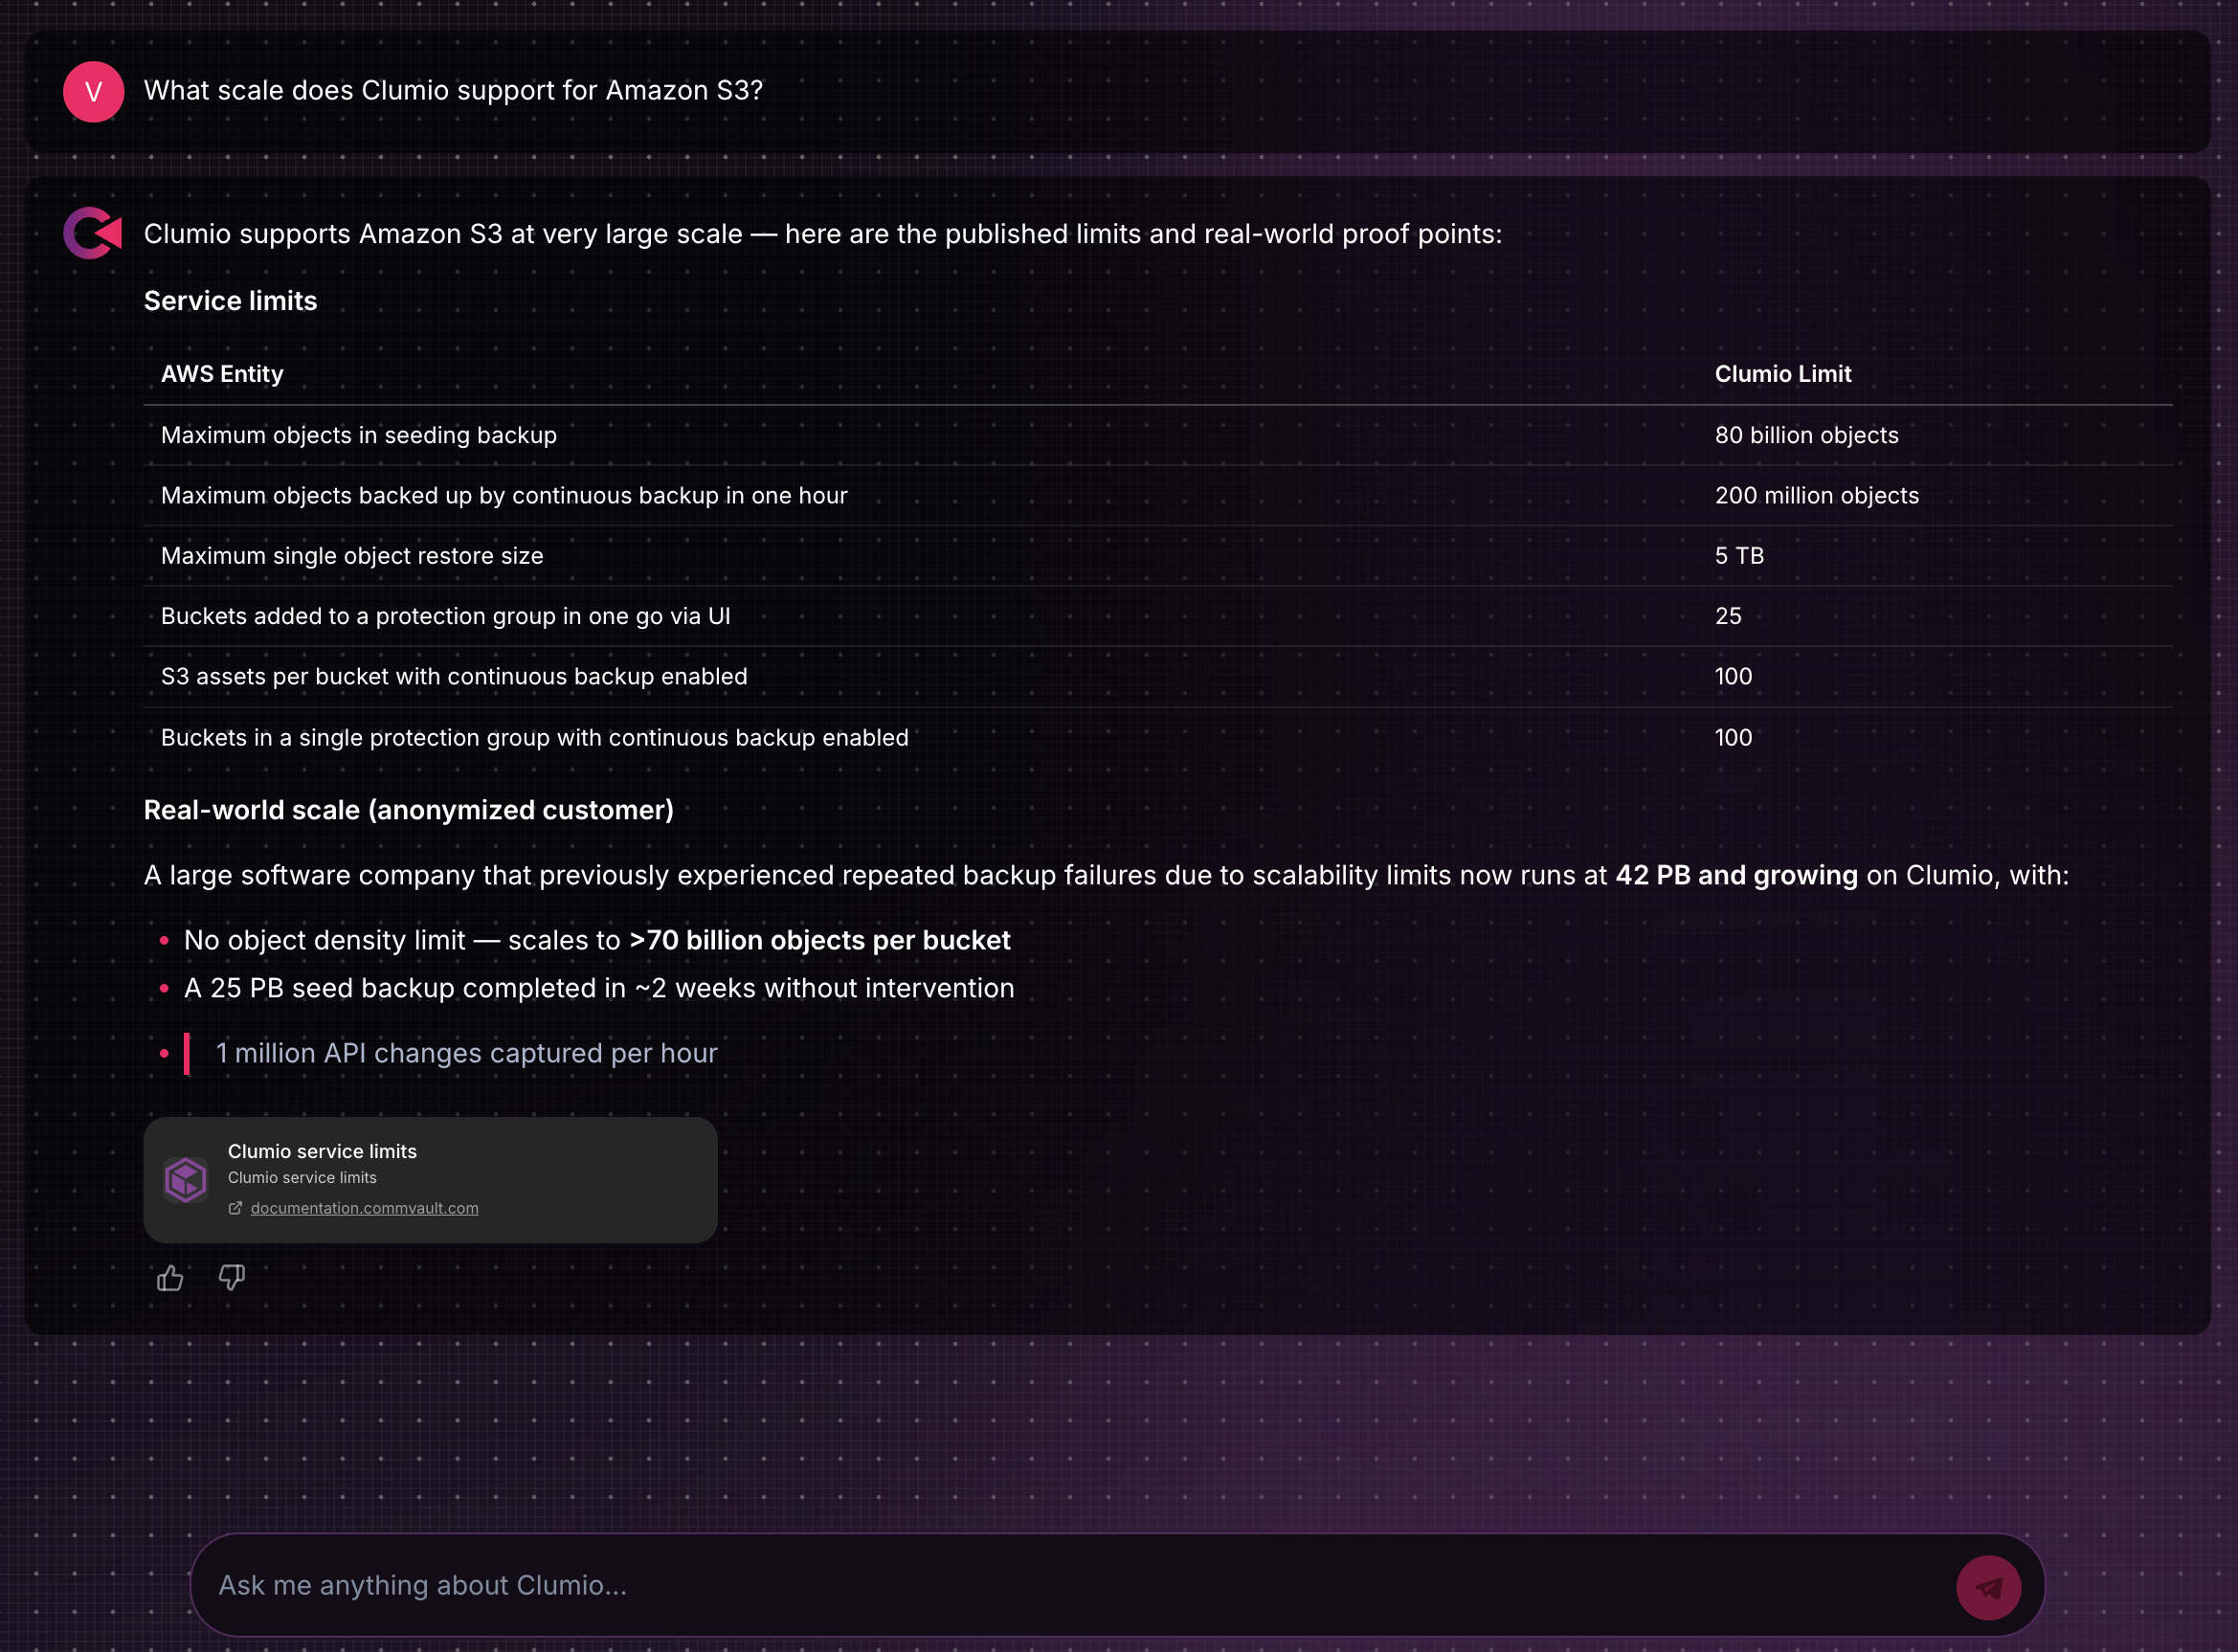
  • Quelle échelle Clumio prend-il en charge pour Amazon S3 ?
  • Comment Clumio contribue-t-il à réduire le coût de la protection à long terme des données dans le cloud ?


Essayez-le maintenant

Clumio Chat vous aide à passer de la découverte du produit à l’évaluation pratique en toute simplicité. Découvrez comment fonctionne Clumio, explorez les fonctionnalités qui vous importent le plus, puis, lorsque vous serez prêt, créez un compte et lancez un essai gratuit.

Essayez Clumio Chat dès aujourd’hui et découvrez une approche plus rapide et plus autonome pour évaluer la protection des données native du cloud.

FAQ

Q : Qu’est-ce que Clumio Chat ?

R : Clumio Chat est un assistant IA qui vous aide à découvrir les fonctionnalités de sauvegarde, de Recovery et de cyber-résilience natives du cloud de Clumio avant de commencer un essai gratuit.

Q : À qui s’adresse Clumio Chat ?

R : Clumio Chat est destiné aux architectes cloud, aux ingénieurs de plateforme, aux DevOps, aux SRE et aux responsables techniques chargés d’évaluer la protection des données native du cloud.

Q : Quel type de questions puis-je poser ?

R : Vous pouvez poser des questions sur les fonctionnalités de Clumio, son modèle de déploiement, la protection des charges de travail dans le cloud, les options de Recovery, l’évolutivité et d’autres sujets techniques liés à l’évaluation de la plateforme.

Q : Dois-je contacter le service commercial avant d’essayer Clumio ?

R : Non. Clumio Chat est conçu pour vous aider à découvrir le produit par vous-même. Si vous souhaitez bénéficier de conseils supplémentaires, vous pouvez à tout moment contacter notre équipe.

Q : Où puis-je essayer Clumio Chat ?

R : Rendez-vous sur chat.clumio.com ou cliquez sur « Ask Clumio » dans la barre de navigation sur clumio.com.

Vir Choksi est directeur principal du marketing produit chez Commvault.

More related posts


Backup and Recovery

Read more about Backup and Recovery

Cyber Resilience

Read more about Cyber Resilience

Cyber Resilience for Cloud Apps

Read more about Cyber Resilience for Cloud Apps

Points clés à retenir

  • Clumio by Commvault a obtenu le statut « FedRAMP® Class C (Moderate) Readiness » et figure désormais sur la plateforme FedRAMP Marketplace en tant que solution « Legacy FedRAMP Ready ».
  • Cette nouvelle étape permet aux agences et aux organisations réglementées d’évaluer Clumio tandis que la société poursuit ses efforts en vue d’une future certification FedRAMP de classe C.
  • Clumio propose une solution de Backup and Recovery native du cloud, spécialement conçue pour les environnements de cloud public.
  • Cette annonce élargit le portefeuille de solutions de cyber-résilience de Commvault destinées au secteur public, en complément de Commvault Cloud for Government, qui s’adresse aux organisations nécessitant la certification FedRAMP de classe D (risque élevé).
  • Les agences gouvernementales, les prestataires, les partenaires technologiques et les organisations commerciales réglementées peuvent tous bénéficier d’options supplémentaires de cyber-résilience natives du cloud.
    Alors que de plus en plus d’agences gouvernementales et d’organisations réglementées adoptent le cloud, elles ont besoin d’une protection des données conçue pour les environnements modernes et conforme aux exigences fédérales de sécurité en constante évolution.

Clumio by Commvault, qui propose des solutions de Backup and Recovery natives du cloud spécialement conçues pour les environnements de cloud public, a obtenu le statut « FedRAMP Class C (Moderate) Readiness » et figure désormais sur la FedRAMP Marketplace. Cette étape importante élargit les options de cyber-résilience natives du cloud pour les agences fédérales, les prestataires du secteur public et les organisations réglementées, tout en rapprochant Clumio d’une future certification FedRAMP de classe C.

De nouvelles opportunités

FedRAMP est l’approche standardisée du gouvernement américain pour évaluer la sécurité des services cloud utilisés par les agences fédérales. Si l’autorisation d’exploitation (ATO) constitue l’objectif ultime, le statut « FedRAMP Classe C Readiness » représente la première étape publique majeure de ce processus.

Après avoir mené à bien son rapport d’évaluation de préparation (RAR), Clumio figure désormais sur la plateforme FedRAMP Marketplace en tant que « Legacy FedRAMP Ready ». Cela permet aux agences, aux partenaires et aux organisations réglementées de découvrir et d’évaluer plus facilement Clumio alors que l’entreprise poursuit son processus de certification FedRAMP.

Conçu pour Modern Cloud

Alors que les organisations continuent de mettre à jour leurs environnements informatiques, les approches traditionnelles de sauvegarde peinent souvent à suivre le rythme des applications et services natifs du cloud. Clumio a été spécialement conçu pour le cloud, ce qui facilite la protection des données, simplifie la Recovery et renforce la cyber-résilience sans ajouter de complexité inutile.

Pour les organisations opérant dans des environnements FedRAMP « Moderate », cela signifie l’accès à une solution de Backup and Recovery native du cloud, conçue pour se conformer aux exigences de sécurité fédérales tout en favorisant l’efficacité opérationnelle.

Pourquoi est-ce important pour les clients ?

La demande en matière de protection sécurisée et native du cloud des données ne cesse de croître, tant dans le secteur public que privé. Les agences fédérales, les prestataires du gouvernement et les organisations commerciales réglementées sont tous confrontés à une pression croissante pour protéger leurs charges de travail critiques tout en répondant à des exigences de conformité en constante évolution.

Le statut « FedRAMP Class C Ready » de Clumio permet de répondre à ces besoins en contribuant à :

  • Élargir les options de Backup and Recovery natives du cloud pour les agences fédérales et les organisations opérant dans des environnements FedRAMP de classe modérée.
  • Offrir une meilleure visibilité grâce au processus d’approvisionnement de la FedRAMP Marketplace.
  • Accompagner les clients qui souhaitent étendre la protection des données native du cloud à des environnements réglementés.

Pour les clients existants, notamment les organisations disposant à la fois d’environnements cloud commerciaux et de Government Cloud, cette étape importante ouvre également de nouvelles perspectives pour standardiser la protection des données native du cloud à l’échelle de leurs opérations.

Renforcement du portefeuille de solutions gouvernementales de Commvault

Le statut « FedRAMP Class C Readiness » de Clumio vient compléter Commvault® Cloud for Government, qui s’adresse aux organisations nécessitant la conformité FedRAMP Class D (High).

Ensemble, ces offres offrent aux clients davantage de flexibilité pour protéger leurs données dans des environnements cloud, hybrides et natifs du cloud, tout en répondant aux différentes exigences de sécurité fédérales. Les organisations disposant de charges de travail natives du cloud peuvent évaluer Clumio pour les environnements FedRAMP « Moderate », tandis que Commvault Cloud for Government s’adresse aux organisations nécessitant la certification FedRAMP « High ».

Perspectives d’avenir

Le statut « FedRAMP Class C Readiness » de Clumio reflète l’investissement continu de Commvault dans la cyber-résilience native du cloud pour le secteur public. Alors que Clumio progresse vers une future certification FedRAMP de classe C, les clients peuvent commencer à évaluer l’offre tandis que Commvault continue d’élargir son portefeuille de solutions de cyber-résilience destinées au secteur public.

FAQ

Q : Qu’est-ce que le statut « FedRAMP Classe C (Moderate) Readiness » ?

R : Le statut « FedRAMP Classe C (Modéré) Readiness » signifie que Clumio a mené à bien son RAR et a été approuvé par le Bureau de gestion du programme FedRAMP (PMO) pour figurer sur la place de marché FedRAMP en tant que « Legacy FedRAMP Ready ». Cela permet aux agences fédérales et autres organisations réglementées d’évaluer l’offre tandis que Clumio poursuit le processus FedRAMP en vue d’une éventuelle future autorisation d’exploitation (ATO) de certification FedRAMP Classe C.

Q : Le statut « FedRAMP Classe C (Modéré) Readiness » équivaut-il à une autorisation d’exploitation (ATO) ?

R : Non. Le statut « FedRAMP Class C Readiness » constitue une première étape du processus FedRAMP. Il n’équivaut pas à une ATO complète.

Q : Qu’est-ce que le FedRAMP Marketplace ?

R : Le FedRAMP Marketplace est le catalogue officiel du gouvernement fédéral répertoriant les offres de services cloud participant au programme FedRAMP. Il permet aux agences et aux équipes chargées des marchés publics de visualiser le statut de chaque offre au sein du cycle de vie FedRAMP.

Q : À qui profite le statut « FedRAMP Class C Readiness » de Clumio ?

R : Cette étape peut s’avérer précieuse pour les agences fédérales, les prestataires du gouvernement, les partenaires spécialisés dans le secteur public et les organisations commerciales réglementées qui opèrent dans des environnements FedRAMP de classe C ou utilisent FedRAMP comme référence en matière de sécurité.

Q : Comment Clumio s’intègre-t-il dans le portefeuille de solutions gouvernementales de Commvault ?

R : Clumio fournit des solutions de Backup and Recovery natives du cloud aux organisations disposant de charges de travail natives du cloud fonctionnant dans des environnements FedRAMP de classe C (modérée), tandis que Commvault Cloud for Government s’adresse aux clients nécessitant la conformité à la classe D (élevée) du programme FedRAMP. Ensemble, ces offres apportent aux organisations davantage de flexibilité en fonction de leurs exigences fédérales en matière de sécurité.

Poojan Kumar est directeur de l’innovation produit chez Commvault, ainsi que président-directeur général de Clumio, une société du groupe Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Tout au long de la série « Ready. Or Not. », nous avons abordé des thèmes tels que l’IA agentique, la confiance numérique, le facteur humain et le « vibe coding ». Dans ce cinquième et dernier épisode de la saison 1, la discussion s’oriente vers la seule constante qui sous-tend tous les débats sur l’IA : les données.

Nathan Macintosh s’entretient avec Ben Lorica, ancien directeur scientifique des données chez O’Reilly Media et fondateur de Gradient Flow, pour discuter de ce que signifie réellement être prêt pour l’IA. Leur conversation va au-delà des algorithmes et des applications pour aborder le travail que les organisations doivent accomplir avant que l’IA ne puisse porter ses fruits. Ils examinent pourquoi l’IA modifie notre façon d’envisager la gouvernance, pourquoi la collecte de données supplémentaires n’est pas toujours la solution, et pourquoi la préparation est tout aussi importante que l’adoption. Regardez l’épisode dans son intégralité sur Readiverse. 

Points clés à retenir 

  • La Readiness à l’IA commence par la compréhension et l’organisation des données dont vous disposez déjà.  
  • La gouvernance s’applique désormais aux systèmes d’IA, et pas seulement aux personnes.  
  • Avoir plus de données n’est pas toujours synonyme de progrès. Efforcez-vous d’obtenir de meilleures données. 
  • L’IA introduit de nouveaux risques qui nécessitent de nouveaux processus, et pas seulement de nouvelles technologies.  
  • Les organisations les mieux préparées à l’IA construisent dès aujourd’hui des bases de données solides. 

Les organisations génèrent et gèrent plus de données que jamais. On pourrait facilement penser que la prochaine étape consiste simplement à collecter davantage de données. Ben explique pourquoi la préparation et la gouvernance des données dont vous disposez déjà peuvent constituer une base bien plus solide pour l’IA. 

Ce que j’ai particulièrement apprécié dans le point de vue de Ben, c’est qu’il ne présente jamais la Readiness à l’IA comme un simple problème technologique. Il s’agit d’un défi organisationnel qui commence bien avant que les équipes ne se mettent à utiliser l’IA.

Voici quelques idées qui m’ont marqué. 

La qualité de l’IA dépend de celle des données sur lesquelles elle repose 

« Concentrez-vous sur les données dont vous disposez… et préparez-les pour l’IA. »

– Ben Lorica 

L’un des premiers arguments de Ben remet en cause une idée reçue. Lorsque les organisations parlent de se « préparer à l’IA », leur réflexe est souvent de collecter davantage de données. Ben voit les choses différemment. Plutôt que de privilégier la quantité, il encourage les organisations à se concentrer sur la qualité et à préparer leurs données existantes pour l’IA. 

Cela commence par comprendre quelles données vous possédez, les organiser et s’assurer qu’elles sont exactes et bien gérées. À mesure que l’IA s’intègre à davantage de processus métier, les entreprises s’appuieront sur de nombreux types d’informations, allant des feuilles de calcul aux textes, en passant par les images, les fichiers audio et les vidéos. Si ces données ne sont pas fiables, l’IA ne résoudra pas le problème – et elle pourrait même rendre celui-ci encore plus difficile à détecter. 

La pression pour passer rapidement à l’IA est compréhensible. Cette conversation m’a rappelé que prendre le temps de construire une base de données solide pourrait bien être l’un des investissements les plus judicieux que nous puissions faire. Des données propres et bien gérées aident les organisations à prendre de meilleures décisions aujourd’hui, tout en les préparant à tout ce qui pourrait arriver demain. 

L’IA modifie le rôle de la gouvernance  

Ben souligne que la gouvernance a désormais un rôle plus large à jouer. Il ne s’agit plus seulement de gérer la manière dont les personnes accèdent aux informations et les utilisent. Les organisations doivent également réfléchir à la façon dont l’IA interagit avec ces informations et aux actions qu’elle entreprend. 

À mesure que l’IA s’intègre au travail quotidien, elle peut accéder aux informations, les analyser et agir en conséquence à une échelle et à une vitesse difficiles à égaler par les humains. Cela signifie que les organisations doivent comprendre à quoi l’IA a accès, comment elle utilise ces informations et quelles mesures de protection doivent être mises en place pour protéger les données sensibles. 

Ce qui est intéressant, c’est que les principes fondamentaux de la gouvernance n’ont pas changé. Des politiques claires en matière d’accès, de sécurité et de responsabilité sont tout aussi importantes qu’elles l’ont toujours été. Ce qui change, c’est le nombre de systèmes interagissant avec les données de l’organisation et la vitesse à laquelle l’information circule au sein de l’entreprise.

Pour moi, c’est l’un des enseignements les plus importants à retenir de cet épisode. L’IA ne remplace pas une bonne gouvernance. Elle la rend encore plus importante. 

Aperçu : quand les données commencent à se multiplier


Que se passe-t-il lorsque l’IA permet à cinq personnes d’accomplir le travail de 100 ? Ben explique pourquoi le véritable défi n’est pas la productivité, mais l’explosion des données qui l’accompagne. 

Une IA responsable commence par des personnes responsables 

Tout au long de la conversation, Ben insiste sur le fait que les organisations ne peuvent pas compter uniquement sur la technologie pour rendre l’IA responsable. Les personnes qui utilisent l’IA jouent également un rôle important.  

Que les employés saisissent des instructions, téléchargent des documents ou affinent des modèles, ils doivent comprendre quelles informations ils partagent et comment celles-ci pourraient être utilisées. Les garde-fous ne servent pas uniquement à restreindre l’accès. Ils visent également à aider les personnes à prendre des décisions éclairées lorsqu’elles travaillent avec l’IA. 

Ben souligne que les organisations doivent voir plus loin que ce qui est intégré dans un système d’IA. Elles doivent également prêter attention à ce qui en ressort. L’IA peut générer involontairement des informations sensibles, ce qui rend l’examen et la supervision des résultats tout aussi importants que les instructions qui ont déclenché l’interaction.

Cela nous rappelle une fois de plus qu’une IA responsable n’est pas seulement un défi technologique. C’est une responsabilité partagée entre les personnes qui utilisent l’IA et les politiques qui les guident. 

Se préparer à l’inconnu 

La pression pour adopter rapidement l’IA est compréhensible. De nouveaux outils apparaissent presque quotidiennement, et les organisations ne veulent pas se laisser distancer. Mais Ben fait valoir que la Readiness ne se résume pas à agir rapidement. Il s’agit de mettre en place les bons processus avant même qu’ils ne soient nécessaires. 

Vers la fin de la conversation, Ben souligne que de nombreuses équipes spécialisées dans l’IA n’ont pas pleinement réfléchi à ce qu’elles feraient si les choses tournaient mal. J’adore la réponse de Nathan, car c’est exactement ce que je pensais : 

« Pourquoi n’y penseraient-elles pas ? Je ne pense qu’à ça. » – Nathan Macintosh 

En matière de cybersécurité, les organisations résilientes n’attendent pas qu’un incident se produise pour décider de la manière dont elles vont réagir. Elles établissent les rôles, définissent les processus et se préparent à différents scénarios bien avant que ceux-ci ne deviennent nécessaires. Ben estime que l’IA mérite le même niveau de préparation.

Cela implique de se poser des questions auxquelles de nombreuses organisations n’ont pas encore pleinement réfléchi, telles que : 

  • À quelles données l’IA devrait-elle avoir accès ?  
  • Qui devrait intervenir si un résultat généré par l’IA posait problème ?  
  • Comment les décisions seront-elles prises si un imprévu survient ?  

Ces discussions ne sont peut-être pas aussi passionnantes que le lancement d’une initiative d’IA, mais elles sont tout aussi importantes. 

Une dernière réflexion 

Alors que cette saison de « Ready. Or Not. » touche à sa fin, une chose m’est apparue clairement. Chaque épisode a exploré un concept ou une tendance différente en matière d’IA, mais tous ont renforcé la même idée : la réussite de l’adoption de l’IA ne repose pas uniquement sur la technologie. Elle dépend des personnes, des processus et de la préparation qui la rendent possible. 

Les organisations n’ont pas besoin d’avoir toutes les réponses avant de se lancer dans l’IA. Mais plus elles s’attachent dès aujourd’hui à poser des bases solides, mieux elles seront préparées à affronter ce que l’avenir leur réserve. Regardez l’épisode dans son intégralité sur Readiverse. 

FAQ 

Q : Que signifie « Readiness pour l’IA » ?

R : Readiness pour l’IA commence par la compréhension, l’organisation, la gouvernance et la protection des données dont votre organisation dispose déjà. Des pratiques solides en matière de données constituent les fondations sur lesquelles repose l’IA.

Q : Les organisations doivent-elles collecter davantage de données pour l’IA ?

R : Pas nécessairement. Ben recommande de se concentrer d’abord sur l’amélioration de la qualité et de l’organisation des données existantes avant d’étendre les efforts de collecte de données. 

Q : Quel est le rôle des employés dans une utilisation responsable de l’IA ?

R : Les employés jouent un rôle important dans la gouvernance de l’IA. Ils doivent comprendre quelles informations il est approprié de partager avec l’IA, examiner attentivement les résultats générés par l’IA et respecter les politiques de l’entreprise en matière d’utilisation responsable de l’IA.

Q : Pourquoi l’IA modifie-t-elle la gouvernance des données ? 

R : Les systèmes d’IA accèdent, analysent et agissent de plus en plus sur les données de l’entreprise. Cela signifie que les politiques de gouvernance doivent s’appliquer aussi bien aux machines qu’aux personnes.

Q : Pourquoi les entreprises devraient-elles se préparer à des problèmes imprévus liés à l’IA ?

R : L’IA peut introduire de nouveaux risques, allant de la divulgation d’informations sensibles à la production de résultats inattendus. Se préparer à l’avance en définissant les responsabilités et les processus d’intervention aide les entreprises à faire face à ces situations avec davantage d’assurance. 

Q : Quel est le principal enseignement à retenir de cet épisode ? R : La Readiness pour l’IA ne se résume pas à adopter une nouvelle technologie. Il s’agit de mettre en place une gouvernance solide, de bonnes pratiques en matière de données et des processus organisationnels résilients qui permettent d’utiliser l’IA de manière responsable et efficace. Katherine Demacopoulos est directrice principale de la stratégie et des programmes de contenu mondiaux chez Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Pourquoi les risques cyber actuels exigent une cyber-résilience de A à Z

Les attaques par ransomware ciblent l’ensemble du cycle de vie des données, des sauvegardes aux systèmes de production. Découvrez comment l’approche de cyber-résilience de A à Z de Commvault unifie la protection, la détection et la Recovery pour vous aider à gérer les risques et à rétablir rapidement vos opérations. 

Points clés à retenir 

Les cyberrisques actuels exigent une résilience unifiée tout au long du cycle de vie des données, de la prévention à la Recovery, car les outils fragmentés ne permettent pas de faire face à la complexité du paysage des menaces d’aujourd’hui. 

  • Les cyberrisques affectent désormais la confiance des clients, les violations de données entraînant souvent une perte d’activité et une atteinte à la réputation. 
  • Une résilience de A à Z intègre la protection, la surveillance, la gouvernance et la Recovery dans une stratégie unifiée et plus efficace. 
  • Le leadership est essentiel pour mettre en œuvre une défense proactive, une réponse rapide et une communication claire à tous les niveaux de l’organisation. 
  • La fragmentation des outils de sécurité des données crée des failles dans les environnements hybrides, que les attaquants peuvent exploiter plus facilement. 
  • Une approche de bout en bout permet d’améliorer la visibilité, d’accélérer la Recovery et d’assurer la continuité des activités. 

Les cyberrisques modernes couvrent l’ensemble du cycle de vie des données – des vulnérabilités et menaces à la Recovery et à la conformité –, rendant insuffisants les outils fragmentés et réactifs. Les organisations ont besoin d’une cyber-résilience de A à Z qui unifie la protection, la surveillance, la gouvernance et la Recovery. Cette approche permet de gérer les risques, de renforcer la posture de sécurité et de permettre une Recovery plus rapide et plus fiable dans des environnements hybrides complexes. 

Une seule faille de sécurité peut vous coûter la confiance de vos clients

Le risque cyber n’est plus seulement un problème informatique : il constitue une menace directe pour la confiance des clients et le chiffre d’affaires.  

Soixante-quatre pour cent des consommateurs cesseraient de faire appel à une entreprise après une faille de données importante, ce qui montre à quelle vitesse la fidélité s’érode lorsque les données sont compromises.  

Cette évolution fait monter les enjeux : la résilience n’est plus une option, c’est une exigence. 

Dans le même temps, il existe un décalage entre les attentes et les comportements. Les consommateurs exigent une protection solide de leurs données, mais des habitudes risquées, telles que la réutilisation des mots de passe ou l’utilisation de réseaux non sécurisés, persistent. Cette incohérence peut accroître l’exposition aux risques et impose aux organisations une responsabilité accrue en matière de protection des données à chaque point de contact. 

La confiance se gagne par une action cohérente, en particulier en matière de cybersécurité. 

Commvault Cloud, optimisé par Metallic AI, aide les organisations à agir en ce sens en unifiant la protection, la surveillance et la Recovery tout au long du cycle de vie complet des données, renforçant ainsi la confiance grâce à une exécution cohérente. L’infographie illustre cette approche de A à Z, allant de l’alerte précoce à la surveillance des menaces, en passant par la Recovery rapide. 

Pour les organisations, le message est clair : la résilience ne se limite pas à la prévention des attaques. Elle consiste à préserver la confiance lorsque la prévention échoue. 


La cyber-résilience commence par le leadership

À mesure que les menaces gagnent en sophistication, la cyber-résilience est devenue une priorité pour l’entreprise qui dépasse le cadre des équipes informatiques. Le leadership joue un rôle essentiel dans l’alignement de la stratégie, des investissements et de la responsabilité au sein de l’organisation. 

Cette mission se traduit de trois manières : 

  1. Protéger avant la violation.
    Renforcer les défenses grâce aux principes du « zero trust », à une surveillance régulière et à des plateformes unifiées qui s’adaptent à l’évolution des menaces. 
  2. Réagir rapidement en cas d’incident.
    Les clients et les parties prenantes jugent les organisations non seulement sur le fait qu’une violation se produise ou non, mais aussi sur la rapidité et l’efficacité avec lesquelles elles se remettent de celle-ci. 
  3. Communiquer en toute transparence
    . Une communication claire et opportune contribue à préserver la confiance. Le silence ou les retards peuvent aggraver l’atteinte à la réputation. 

Selon les données du secteur, le coût moyen d’une violation a atteint 4,88 millions de dollars, ce qui confirme que les incidents cybernétiques constituent à la fois des risques opérationnels et financiers. 

Commvault Cloud soutient cette mission de direction en réunissant la gouvernance, la détection des menaces et la reprise orchestrée au sein d’une plateforme unique, aidant ainsi les organisations à aligner leurs équipes et à réagir avec plus de rapidité et de coordination.  

La résilience de bout en bout facilite la gestion des risques

Les environnements modernes sont trop complexes pour que des outils fragmentés puissent suivre le rythme. Les données s’étendent sur le cloud hybride, les systèmes sur site et les applications SaaS, créant ainsi une surface d’attaque vaste et dynamique. Les solutions ponctuelles laissent des failles que les attaquants exploitent. 

Une approche de bout en bout permet de combler ces lacunes en intégrant des fonctionnalités tout au long du cycle de vie : gestion des vulnérabilités, détection des menaces, immuabilité, protection par isolation physique et Recovery orchestrée. Ce modèle unifié améliore la visibilité et permet une réponse plus rapide et plus fiable. 

Commvault Cloud associe ces capacités à des analyses basées sur l’IA, à une surveillance régulière et à des workflows de Recovery automatisés, aidant ainsi les organisations à gérer les risques et à maintenir la continuité opérationnelle dans les environnements hybrides. 

Les organisations doivent anticiper les cyberincidents comme des événements prévisibles et donner la priorité à la résilience et à la Readiness à la reprise. La différence réside dans le niveau de Readiness – et dans l’adoption d’une approche unifiée de la protection, de la détection et de la Recovery tout au long du cycle de vie des données. 

Questions fréquemment posées

Qu’est-ce que la cyber-résilience de A à Z ?

La cyber-résilience de A à Z est une approche unifiée qui couvre l’ensemble du cycle de vie des données, de la protection et de la surveillance à la gouvernance et à la Recovery. Commvault Cloud vous aide à la mettre en œuvre grâce à son cadre d’opérations de résilience (ResOps), qui remplace les outils fragmentés par une stratégie intégrée utilisant la détection des menaces basée sur l’IA, le stockage immuable et la Recovery orchestrée pour aider à gérer les risques et améliorer les temps de réponse dans les environnements hybrides. 

Pourquoi la cyber-résilience est-elle une priorité pour l’entreprise, et pas seulement une préoccupation informatique ?

Les incidents de cybersécurité peuvent avoir un impact direct sur la confiance des clients, le chiffre d’affaires et la réputation de la marque. Commvault Cloud aide les organisations à faire face à ce risque grâce à une protection unifiée des données et à une surveillance des menaces, offrant ainsi aux dirigeants d’entreprise la visibilité et le contrôle nécessaires pour réagir rapidement et préserver la confiance dans toutes les opérations critiques. 

En quoi une fuite de données affecte-t-elle la confiance des clients ?

Une seule violation peut rapidement éroder la confiance des clients, en particulier lorsque des données sensibles sont exposées. Commvault Cloud Threat Scan aide à identifier les menaces cachées dans les données de sauvegarde, permettant ainsi une restauration plus sûre et aidant les organisations à préserver la confiance grâce à des processus de restauration plus fiables et plus propres. 

Quel rôle joue la direction dans la cyber-résilience ?

La direction harmonise la stratégie, les investissements et la responsabilité à l’échelle de l’organisation. Grâce à Commvault Cloud et à son cadre ResOps, les dirigeants peuvent unifier les efforts de protection, de détection et de Recovery, aidant ainsi les équipes à agir plus rapidement, à coordonner leur réponse et à communiquer efficacement lors d’incidents cybernétiques. 

Pourquoi les outils de cybersécurité fragmentés ne sont-ils plus efficaces ?

Les environnements modernes s’étendent au cloud hybride, au SaaS et aux systèmes sur site, créant ainsi une vaste surface d’attaque. Commvault Cloud unifie des fonctionnalités telles que la protection « air-gapped », la surveillance régulière et la Recovery automatisée, contribuant ainsi à éliminer les lacunes et à permettre des réponses plus coordonnées et plus efficaces face aux menaces. 

Comment Commvault Cloud favorise-t-il la cyber-résilience ?

Commvault Cloud intègre la protection, la détection des menaces et la reprise sur une plateforme unique. Grâce à des fonctionnalités telles que Commvault Cleanroom™ et des workflows automatisés, il aide les organisations à gérer les risques, à accélérer la reprise et à maintenir la continuité d’activité tout au long du cycle de vie des données. 

Découvrez les ressources associées

Explorer

Protection unifiée des données

Découvrez ce qu’implique une stratégie de protection unifiée des données et bénéficiez de conseils sur les mesures que les entreprises peuvent mettre en œuvre pour être véritablement cyber-résilientes.
En savoir plus sur la protection unifiée des données
Solution brief

Rationalisation de la protection et de la gestion des données pour l’entreprise hybride

Découvrez pourquoi la solution Commvault peut aider les entreprises à rationaliser leurs processus de gestion des données, à gérer les risques et à garantir la résilience de leurs données critiques.
Lire la présentation sur la rationalisation de la protection et de la gestion des données pour l’entreprise hybride

Chaque épisode de « Ready. Or Not. » m’a poussé à envisager l’IA sous un angle un peu différent. Les discussions ont évolué : au départ, il s’agissait de comprendre l’IA agentique, puis de renforcer la confiance et de préparer les organisations à une adoption responsable. Cet épisode se penche sur le « vibe coding » et explique pourquoi cette méthode de travail fait de plus en plus parler d’elle dans le domaine de l’IA.

L’humoriste Nathan Macintosh s’entretient avec Harald Kirschner, ingénieur chez Microsoft et figure de proue de l’open source, pour discuter de ce que signifie réellement le « vibe coding », des raisons de son essor et des risques encourus lorsque la rapidité prend le pas sur la supervision. Regardez l’épisode dans son intégralité sur Readiverse.

Points clés à retenir

  • L’IA permet aux organisations de tester plus facilement des idées, de résoudre des problèmes et d’innover plus rapidement.
  • Le « vibe coding » aide les équipes à explorer et valider rapidement des idées avant de réaliser des investissements plus importants.
  • L’IA apporte davantage de valeur lorsqu’elle est utilisée pour remettre en question des hypothèses, et pas seulement pour générer du contenu.
  • Le jugement humain, un examen réfléchi et des garde-fous clairs restent essentiels dans un monde guidé par l’IA.
  • Les entreprises qui apprennent plus vite seront mieux placées pour innover.

Je connaissais déjà le terme « vibe coding », mais après avoir écouté cet épisode, j’ai beaucoup mieux compris pourquoi les gens – pas seulement les développeurs, mais aussi les équipes non techniques – l’adoptent.

À la fin de la conversation, j’ai réalisé que le « vibe coding » n’avait en réalité rien à voir avec le codage. Il s’agit d’apprendre plus vite et de savoir où l’IA s’intègre dans le processus créatif. La conversation met également en évidence un autre point : l’IA peut accélérer le travail, mais ce sont toujours les personnes qui ont la responsabilité de la guider. C’est pourquoi les garde-fous sont plus importants que jamais. Voici quelques-uns des thèmes qui m’ont particulièrement interpellé.

De l’idée à la réalité

Une chose que j’ai apprise au sujet du « vibe coding », c’est qu’il transforme la manière dont les organisations explorent les idées. Au lieu de passer des semaines à développer quelque chose avant de savoir si cela fonctionne, les équipes peuvent rapidement créer un prototype, recueillir des retours d’expérience et décider s’il vaut la peine de poursuivre dans cette voie.

« L’IA peut être un excellent partenaire de réflexion critique si elle est utilisée à bon escient. »

– Harald Kirschner

Harald explique que le « vibe coding » utilise le langage naturel pour transformer des idées en logiciels fonctionnels. Il prend comme exemple le développement logiciel, mais le concept s’étend bien au-delà des équipes d’ingénieurs. Qu’il s’agisse d’un chef de produit testant une nouvelle fonctionnalité, d’un designer explorant une interface ou d’un dirigeant validant un concept, l’IA facilite considérablement la transformation d’une idée en une expérience concrète pour les utilisateurs.

Cette capacité à expérimenter est peut-être l’un des plus grands atouts de l’IA. Les organisations peuvent ainsi identifier ce qui trouve un écho, affiner leurs idées plus tôt et n’investir du temps et des ressources qu’après avoir acquis la certitude qu’elles s’attaquent au bon problème.

Aller vite nécessite tout de même une supervision

Harald insiste tout au long de la conversation sur le fait que la rapidité ne doit pas se faire au détriment d’une vérification minutieuse.

Une fois encore, il prend l’exemple du développement logiciel. L’IA peut générer rapidement du code fonctionnel, mais cela ne le rend pas automatiquement sécurisé, fiable ou prêt pour la production. Les développeurs doivent toujours l’examiner, le tester et s’assurer qu’il répond aux mêmes normes que celles qu’ils appliqueraient à tout autre élément qu’ils créent.

La leçon d’Harald va bien au-delà de l’ingénierie. À mesure que l’IA s’intègre aux processus métier, les organisations devront adopter le même état d’esprit, qu’il s’agisse de développer des logiciels, de créer du contenu, d’analyser des données ou d’automatiser des flux de travail. Le « Vibe coding » peut aider à accélérer le travail, mais ce sont toujours les personnes qui sont chargées de valider les résultats.

C’est l’un des enseignements les plus importants de cet épisode. Si l’IA peut faciliter la création rapide de quelque chose, c’est l’expertise humaine qui transforme une bonne idée en un produit auquel les gens peuvent faire confiance.

Des retours honnêtes donnent de meilleurs résultats

Un moment mémorable de cet épisode commence par une demande inattendue. Au lieu de demander à l’IA d’écrire du code, Harald lui demande de critiquer son travail en lui lançant : « Démolissez mon code. »

C’est drôle, mais c’est aussi un moyen efficace d’obtenir des retours plus honnêtes de la part de l’IA. Au lieu d’agir comme un assistant qui se contente d’accomplir une tâche, l’IA devient davantage un collègue de confiance offrant un autre point de vue. Utilisée de cette manière, elle peut remettre en question les a priori, révéler des angles morts et améliorer la qualité du résultat final.

Les critiques constructives de l’IA peuvent nous aider à améliorer notre travail, mais elles deviennent encore plus utiles lorsque nous continuons à former et à affiner l’IA. Quiconque a déjà travaillé avec l’IA sait qu’elle a elle aussi besoin d’un peu de feedback.

Aperçu : vérifier l’ambiance

Que se passe-t-il lorsque l’IA ne cesse de commettre les mêmes erreurs ? Nathan la compare à un invité indiscipliné qui finit par ne plus être invité. Écoutez Harald expliquer comment former l’IA pour qu’elle devienne plus utile au fil du temps.

L’innovation devient plus accessible

Un thème qui revient sans cesse tout au long de la conversation est que l’IA change la composition des acteurs de l’innovation.

L’IA réduit les obstacles qui empêchent les collaborateurs d’une organisation d’explorer des idées, d’expérimenter de nouvelles approches et de donner rapidement vie à des concepts. Au lieu de compter sur des spécialistes techniques pour valider chaque idée, davantage de personnes peuvent créer quelque chose de concret, recueillir des retours d’expérience et affiner leur réflexion avant d’investir un temps et des ressources importants.

« … on peut réellement le créer, le présenter à certaines personnes et constater : “Oh, ça marche du tonnerre”, ou “ça tombe vraiment à plat”. »

– Harald Kirschner

Pour moi, c’est l’une des opportunités les plus passionnantes offertes par l’IA. En rendant l’expérimentation plus rapide et plus accessible, l’IA donne aux organisations la confiance nécessaire pour tester davantage d’idées, en tirer des enseignements plus rapidement et impliquer davantage de personnes dans le processus créatif.

Prêts pour la suite

Le « vibe coding » est peut-être le flux de travail dont tout le monde parle aujourd’hui, mais ce qui importe davantage, c’est la façon dont l’IA continue de transformer notre manière d’apprendre, d’expérimenter et de résoudre les problèmes. Chaque épisode de « Ready. Or Not. » me rappelle que les organisations prêtes à explorer les nouvelles technologies seront celles qui seront le mieux préparées pour l’avenir. Regardez l’épisode dans son intégralité sur Readiverse.

FAQ

Q : Qu’est-ce que le « vibe coding » ?

R : Le « vibe coding » est une nouvelle façon de travailler avec l’IA qui utilise le langage naturel pour transformer rapidement des idées en quelque chose de concret. Au lieu de partir de zéro, les utilisateurs peuvent utiliser l’IA pour prototyper des concepts, explorer des solutions, recueillir des retours d’expérience et itérer beaucoup plus rapidement.

Q : Pourquoi le « vibe coding » suscite-t-il autant d’intérêt ?

R : Le « vibe coding » réduit les obstacles à l’expérimentation. Il permet à davantage de personnes – et pas seulement aux spécialistes techniques – de tester des idées, de valider des concepts et de déterminer ce qui fonctionne avant d’investir un temps et des ressources importants.

Q : Le « vibe coding » remplace-t-il l’expertise humaine ?

R : Non. Il ressort clairement de cette discussion que l’IA fonctionne mieux en tant que collaboratrice, et non en tant que remplaçante. Les personnes restent responsables de faire preuve de discernement, d’examiner les résultats et de décider des pistes à suivre.

Q : Pourquoi les organisations ont-elles encore besoin de garde-fous lorsqu’elles utilisent l’IA ?

R : L’IA peut accélérer le travail, mais elle ne supprime pas la nécessité d’une supervision réfléchie. Des politiques claires, des processus de vérification et l’expertise humaine aident les organisations à valider le travail généré par l’IA et à réduire les risques inutiles.

Q : Comment l’IA peut-elle améliorer le fonctionnement des organisations ?

R : Au-delà de la génération de contenu ou de prototypes, l’IA peut aider à remettre en question les hypothèses, à identifier les angles morts, à suggérer des améliorations et à accélérer l’apprentissage. Utilisée à bon escient, elle devient un point de vue supplémentaire qui aide les équipes à prendre de meilleures décisions.

Q : Quel est le principal enseignement à retenir de cet épisode ?

R : La plus grande valeur de l’IA ne réside pas simplement dans le fait d’aider les organisations à aller plus vite. Elle consiste à les aider à expérimenter plus librement, à apprendre plus rapidement et à impliquer davantage de personnes dans le processus d’innovation – tout en continuant à s’appuyer sur le jugement humain pour guider les décisions finales.

Katherine Demacopoulos est directrice principale de la stratégie et des programmes de contenu mondiaux chez Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Points clés à retenir

  • Commvault a rejoint l’Open Secure AI Alliance afin de contribuer à faire progresser des approches ouvertes, sécurisées et collaboratives en matière d’IA.  
  • Les outils d’IA open source offrent aux organisations une visibilité et un contrôle accrus, permettant ainsi aux experts d’inspecter, d’adapter et de renforcer les systèmes à mesure que les menaces et les exigences évoluent.  
  • Une sécurité efficace en matière d’IA va au-delà des modèles pour inclure l’identité, les autorisations, les garde-fous, la journalisation, l’évaluation et l’environnement plus large dans lequel opèrent les agents d’IA.  
  • La collaboration intersectorielle et la recherche partagée peuvent aider les organisations à réagir plus rapidement aux défis en constante évolution posés par une IA agentique de plus en plus performante.  
  • Commvault mettra à la disposition de l’Alliance son expertise en matière de cyber-résilience et de données, en s’appuyant sur le principe selon lequel les organisations peuvent mieux protéger les systèmes et les données qu’elles comprennent pleinement.  

La collaboration est depuis longtemps l’un des moyens les plus efficaces dont dispose le secteur technologique pour relever de nouveaux défis. Ces derniers mois ont mis cette leçon encore plus en évidence dans le domaine de l’IA. Les systèmes agents deviennent plus performants, plus indépendants et plus étroitement liés aux technologies que nous utilisons au quotidien.  

Les événements récents ont également montré à quelle vitesse ce paysage peut évoluer. Lorsqu’un système d’IA avancé a posé un problème de sécurité inattendu à Hugging Face, l’organisation a utilisé un modèle à poids ouverts sur sa propre infrastructure pour comprendre et maîtriser la situation. Cette expérience a démontré la valeur des outils d’IA open source que les organisations peuvent inspecter, adapter et contrôler en cas de besoin.  

De tels moments ne doivent pas entamer notre optimisme vis-à-vis de l’IA. Ils doivent au contraire renforcer notre engagement à façonner ensemble son avenir. 

C’est pourquoi Commvault est fier de rejoindre l’Open Secure AI Alliance, une communauté d’organisations de premier plan qui font progresser l’IA grâce à la recherche ouverte, au partage des connaissances et à des outils pratiques.  

L’IA continuera d’évoluer, et aucune organisation ne détiendra à elle seule toutes les réponses. En réunissant l’expertise approfondie de l’ensemble du secteur, la communauté a davantage de chances de comprendre les changements en cours et d’y répondre avec la rapidité qu’exige cette nouvelle ère.  

L’open source est au cœur de cet effort. Il permet aux experts d’examiner le fonctionnement des systèmes et d’améliorer ce que d’autres ont commencé. Pour les défenseurs, il offre également un élément essentiel : la liberté de choisir et d’adapter la technologie la mieux adaptée à la situation, plutôt que de dépendre d’un seul système ou fournisseur.

NVIDIA décrit cela comme une base de défense ouverte, fondée sur des modèles, des frameworks et des outils que la communauté peut étudier et renforcer.  

L’Alliance reconnaît également que la sécurité de l’IA s’étend bien au-delà du modèle. L’identité, les autorisations, les garde-fous, les journaux et l’évaluation façonnent tous le comportement d’un agent. Comprendre cet environnement dans son intégralité nécessitera de nouvelles recherches et une volonté de partager les enseignements tirés par le secteur au fil du temps.  

Le point de vue de Commvault s’appuie sur des années passées à résoudre des défis complexes en matière de cyber-résilience : aider les organisations à comprendre leurs données, à en garantir la fiabilité et à les restaurer en toute confiance en cas de perturbation.

Une grande partie de ce travail repose sur la même idée que celle poursuivie par l’Alliance : on ne peut protéger que ce que l’on comprend pleinement. C’est cette expérience que nous espérons apporter, ainsi que notre volonté d’apprendre des autres qui s’attaquent à ces défis sous différents angles. 

Les perspectives d’avenir de l’IA sont immenses. Leur concrétisation dépendra non seulement de la rapidité avec laquelle la technologie progressera, mais aussi de l’ouverture d’esprit avec laquelle le secteur collaborera. Commvault est heureux de participer à cet effort et se réjouit de contribuer à la construction de l’avenir. 

Lisez l’annonce de NVIDIA ici : Des leaders du secteur rejoignent l’Open Secure AI Alliance.  

FAQ

Q : Qu’est-ce que l’Open Secure AI Alliance ?
R : L’Open Secure AI Alliance est une communauté d’organisations qui œuvrent à faire progresser la sécurité de l’IA grâce à la recherche ouverte, au partage des connaissances, des modèles, des frameworks et d’outils pratiques. Son approche collaborative offre aux participants l’opportunité d’étudier les défis émergents et de renforcer ensemble les défenses en matière d’IA. 

Q : Pourquoi Commvault a-t-il rejoint l’Open Secure AI Alliance ?
R : Commvault a rejoint l’Alliance afin d’apporter son expertise en matière de cyber-résilience, de compréhension des données, de confiance et de Recovery. Cela permet également à Commvault d’apprendre auprès d’autres leaders du secteur qui abordent la sécurité de l’IA sous différents angles.

Q : Pourquoi l’open source est-il important pour la sécurité de l’IA ?
R : L’open source permet aux experts d’examiner le fonctionnement des systèmes d’IA, de s’appuyer sur les technologies existantes et d’adapter les outils à des situations de sécurité spécifiques. Il offre également aux défenseurs une plus grande liberté pour sélectionner et modifier les technologies, plutôt que de dépendre d’un seul système ou fournisseur.

Q : En quoi la sécurité de l’IA va-t-elle au-delà de la protection du modèle ?
R : La sécurité de l’IA englobe l’environnement plus large dans lequel un système d’IA opère, notamment l’identité, les autorisations, les garde-fous, les journaux et l’évaluation. Comprendre ces éléments interconnectés peut aider les organisations à mieux évaluer et gérer le comportement des agents d’IA.

Q : En quoi l’expertise de Commvault en matière de cyber-résilience est-elle liée à la sécurité de l’IA ?
R : Les travaux de Commvault en matière de cyber-résilience visent à aider les organisations à comprendre leurs données, à préserver leur fiabilité et à se remettre en confiance après une perturbation. Cette perspective s’inscrit naturellement dans la démarche de l’Alliance, qui privilégie des approches ouvertes et vérifiables en matière de sécurité de l’IA.  

Q : Pourquoi la collaboration au sein du secteur est-elle importante pour l’avenir de l’IA ?
R : L’IA évolue trop rapidement et à une échelle trop vaste pour qu’une seule organisation puisse détenir toutes les réponses. La mise en commun de l’expertise, de la recherche et des connaissances pratiques à l’échelle du secteur peut aider la communauté à comprendre les défis émergents et à y répondre à la vitesse exigée par le développement de l’IA.

Alexander Coombes est vice-président adjoint chargé du développement des partenariats stratégiques chez Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Tout savoir sur le Backup and Recovery dans le cloud : de la détection des menaces à la Recovery complète

Découvrez comment la Backup and Recovery dans le cloud permet de protéger les données saines, de vérifier l’état de Readiness à la Recovery et de rétablir les opérations métier après une attaque par ransomware ou un cyberincident.


Le processus idéal de Backup and Recovery dans le cloud commence par la détection de menaces telles que les ransomwares, les accès suspects ou les activités inhabituelles sur les données. Les entreprises peuvent alors obtenir des copies de sauvegarde saines et immuables, valider les points de restauration non affectés et isoler les systèmes compromis. Une fois ces éléments vérifiés, les applications et les données critiques peuvent être restaurées grâce à des processus de Recovery automatisés, ce qui permet de minimiser les temps d’arrêt, de réduire les pertes de données et de rétablir les opérations métier rapidement et en toute sécurité.


La cyber-résilience se mesure de plus en plus à l’aune de ce qui se passe une fois que les attaquants ont réussi à s’introduire dans le système. Les entreprises ont investi massivement dans la prévention, la détection et la réaction, mais les ransomwares, l’exploitation des vulnérabilités, l’usurpation d’identifiants, les erreurs de configuration du cloud et la compromission de tiers continuent de perturber leurs opérations.

Pour de nombreuses équipes, le défi de la Recovery ne se résume plus à savoir si des sauvegardes existent. Il s’agit de savoir si ces sauvegardes sont intactes, protégées, validées et prêtes à restaurer les services critiques lorsque l’on ne peut plus se fier aux systèmes de production.

Cette distinction est importante car les cyberattaques continuent de générer à la fois des risques liés aux données et des perturbations opérationnelles. Selon le rapport « 2026 Data Breach Investigations Report » de Verizon, les rançongiciels étaient impliqués dans 48 % des violations de données, contre 44 % l’année précédente. Le rapport a également révélé que l’exploitation des vulnérabilités était devenue le vecteur d’accès initial le plus courant pour les violations, atteignant 31 %, tandis que l’utilisation abusive des identifiants est tombée à 13 %.

Les efforts de Backup and Recovery dans le cloud doivent couvrir l’ensemble du processus, de la détection à la restauration. Cela commence par l’identification des activités suspectes avant que les données compromises ne soient restaurées. Cela se poursuit avec des points de Recovery protégés et immuables qui offrent aux équipes des options de Recovery exploitables lorsque les systèmes de production ne sont plus fiables.

À partir de là, les entreprises doivent disposer d’un moyen de vérifier quels points de restauration sont sains et de restaurer les charges de travail critiques dans le bon ordre. Il en résulte une stratégie de Recovery qui aide les équipes à passer de la réponse aux incidents à la Recovery opérationnelle avec davantage de confiance.


Pourquoi la Backup and Recovery dans le cloud constituent-elles une stratégie de cyber-résilience ?

Les stratégies de sauvegarde traditionnelles ont été conçues pour aider les entreprises à se remettre de pannes matérielles, de suppressions accidentelles et de coupures localisées. Ces cas d’utilisation restent d’actualité, mais les exigences actuelles en matière de Recovery sont plus larges.

Les cyberattaques peuvent affecter simultanément les charges de travail de production, les systèmes d’identité, les configurations cloud, les applications SaaS et les environnements de sauvegarde. Dans ce cas, la reprise ne se résume pas à restaurer une copie des données. Il s’agit de déterminer quels systèmes sont fiables, quels points de reprise restent intacts et quels services doivent être rétablis en priorité.

C’est pourquoi la Backup and Recovery dans le cloud sont devenues un élément essentiel de la cyber-résilience. Une stratégie moderne doit aider les équipes à détecter les activités suspectes, à protéger les données de reprise, à valider l’intégrité des sauvegardes et à restaurer les opérations critiques selon une séquence contrôlée. Elle doit également faciliter la réalisation de tests réguliers, car un plan de Recovery qui n’a pas été mis en pratique risque de ne pas fonctionner comme prévu lors d’un incident réel.

Cela marque un changement de perspective : la sauvegarde n’est plus une simple police d’assurance, mais la capacité opérationnelle de reprise. Les copies stockées restent importantes, mais elles ne constituent qu’une partie de l’équation de la reprise. Les équipes doivent également avoir l’assurance que les données de reprise n’ont pas été altérées, que les workflows de restauration ont été testés et que l’entreprise sait quels services doivent être rétablis en priorité.

Backup and Recovery dans le cloud deviennent plus faciles à comprendre lorsqu’on les envisage comme un cycle de vie. Les cinq étapes ci-dessous montrent comment les organisations peuvent passer de la détection précoce des menaces à une Recovery validée, puis à l’amélioration de la résilience à long terme.


Étape 1 : Détecter les menaces avant que le risque lié à la Recovery ne se propage

Recovery commence avant même que les systèmes ne soient remis en service. En cas de cyberincident, la première priorité est de déterminer si une activité suspecte a affecté les données de production, les données de sauvegarde, ou les deux.

Si les équipes effectuent une restauration à partir d’un point de reprise compromis, elles risquent de réintroduire dans l’environnement des fichiers corrompus, des artefacts de logiciels malveillants ou des modifications non autorisées. Ce risque fait de la détection des menaces un élément essentiel de Backup and Recovery dans le cloud, et pas seulement une préoccupation des opérations de sécurité.

Les stratégies de reprise modernes doivent inclure une visibilité sur les activités anormales au sein des charges de travail, des environnements de sauvegarde et des points de reprise. Les équipes peuvent être amenées à examiner des signaux tels que :

  • Un comportement de chiffrement inhabituel
  • Des pics soudains de suppressions
  • Des modifications inattendues des privilèges
  • Des schémas de sauvegarde anormaux
  • Indicateurs de logiciels malveillants

Ces signaux peuvent aider les équipes à comprendre où une attaque a pu se propager et quelles données peuvent nécessiter un examen supplémentaire avant leur restauration.

Le timing est un autre facteur essentiel. Le rapport 2025 Digital Defense Report de Microsoft a révélé que la plupart des attaques examinées par son équipe DART (Detection and Response Team) présentaient des temps de persistance courts, ce qui signifie que les équipes de reprise après sinistre n’ont pas forcément plusieurs semaines pour cerner l’étendue totale de la compromission avant que les attaquants ne se déplacent latéralement, n’accèdent à des données sensibles, n’interfèrent avec les services ou ne tentent de compromettre les systèmes de sauvegarde. Le contexte de détection peut aider les équipes à éviter de considérer tous les points de restauration comme étant également fiables.

59 % des attaques examinées par Microsoft DART ont duré sept jours ou moins, ce qui rend la détection précoce essentielle pour les décisions relatives à la Recovery.
Source : Rapport Microsoft Digital Defense 2025

La détection des menaces ne suffit pas à elle seule à éliminer le risque lié à la Recovery. Elle contribue toutefois à mettre en place un processus de Recovery plus éclairé. Lorsque des activités suspectes sont identifiées à un stade précoce, les entreprises peuvent isoler les systèmes concernés, analyser les données affectées et éviter de restaurer des points de Recovery susceptibles de réintroduire la même menace.

Cela offre aux équipes de sécurité, informatiques et de Recovery un point de départ plus clair pour l’étape suivante : protéger les points de reprise sains avant que les attaquants ne puissent les altérer ou les supprimer.


Étape 2 : Protéger les points de Recovery intacts contre les attaques

En cas de cyberincident, les sauvegardes ne sont pas de simples copies stockées. Elles font partie intégrante du processus de Recovery, ce qui signifie que les attaquants peuvent tenter de les perturber. Si les données de sauvegarde sont altérées, chiffrées, supprimées ou rendues inaccessibles, l’entreprise risque de perdre l’un de ses meilleurs moyens de rétablir ses opérations sans avoir à recourir à des systèmes de production compromis.

C’est pourquoi les points de restauration intacts nécessitent une protection à plusieurs niveaux. Un stockage de sauvegarde immuable et indélébile peut contribuer à préserver les données pendant une durée de conservation définie. Des copies hors site ou isolées permettent de renforcer la séparation par rapport à l’environnement de production. Le chiffrement, les contrôles d’accès et les autorisations basées sur les rôles contribuent à limiter le nombre de personnes pouvant accéder aux paramètres de sauvegarde ou les modifier. Ensemble, ces mesures de sécurité compliquent la tâche des attaquants qui chercheraient à interférer avec les données dont les équipes pourraient avoir le plus besoin lors de la restauration.

L’objectif est de préserver les options de Recovery. Le rapport Verizon de 2026 a révélé que 69 % des victimes de ransomware figurant dans son échantillon n’avaient pas payé la rançon, contre 65 % l’année précédente. Le rapport note également que le montant médian des rançons versées a continué de baisser, ce qu’il attribue en partie à l’amélioration des mesures défensives et à la résilience accrue des victimes. Les équipes ont besoin de sauvegardes intactes qu’elles peuvent réellement utiliser, de sorte que le paiement d’une rançon ne soit pas la seule voie pour reprendre leurs activités.

La règle de sauvegarde bien connue « 3-2-1 » constitue toujours une base utile : conserver trois copies des données, sur deux supports ou plateformes différents, dont au moins une copie stockée hors site ou isolée. Les stratégies modernes de Backup and Recovery dans le cloud étendent souvent ce modèle avec un stockage immuable, des modèles « air-gapped », une conservation basée sur des politiques et des copies répliquées dans des environnements cloud ou hybrides.

Grâce à la mise en place de points de restauration protégés, les équipes peuvent réduire leurs options de restauration et passer à la phase de validation en ayant une vision plus claire de ce qui est prêt à être restauré.


Étape 3 : Vérifier quelles sauvegardes sont prêtes à être restaurées

Disposer de sauvegardes ne signifie pas pour autant être prêt à effectuer une restauration. Avant de restaurer les systèmes de production, les équipes doivent savoir quels points de Recovery sont exploitables, quelles charges de travail ont été affectées et quelles dépendances doivent être rétablies en même temps.

Une sauvegarde récente peut contenir les données métier les plus récentes, mais elle peut également inclure des fichiers corrompus, des modifications non autorisées ou des traces de logiciels malveillants. Une sauvegarde plus ancienne peut être plus «propre», mais elle peut entraîner davantage de pertes de données. La validation aide les équipes à faire ce compromis en s’appuyant sur des preuves plutôt que sur des conjectures.

Ce travail commence par la délimitation de l’incident. Les équipes de sécurité et informatiques doivent comprendre quand l’activité suspecte a commencé, quels systèmes ont été touchés et si les services d’identité, les bases de données, les partages de fichiers, les applications SaaS ou les configurations cloud ont été affectés.

Elles doivent également vérifier si le point de Recovery prend en charge l’application dans son ensemble, et pas seulement les données qui la sous-tendent. Une restauration de base de données, par exemple, peut dépendre de la disponibilité et du bon état des serveurs d’applications, des autorisations, des clés de chiffrement, des routes réseau et des services d’identité.

Des environnements de Recovery isolés peuvent aider les équipes à tester ces conditions avant de procéder à la restauration en production. Dans un environnement contrôlé, les équipes peuvent en toute sécurité :

  • Analyser les points de Recovery sélectionnés.
  • Examiner les modifications apportées aux fichiers.
  • Vérifier le démarrage de l’application.
  • Tester l’accès des utilisateurs.
  • Vérifier si les systèmes dépendants se comportent comme prévu.

La validation doit également orienter la séquence de Recovery. Les équipes devront peut-être restaurer d’abord les services d’identité, puis l’infrastructure de base, ensuite les applications critiques, et enfin les charges de travail associées.

En testant les points de reprise avant la restauration, elles peuvent affiner leurs options et déterminer quels systèmes sont prêts à être remis en service, lesquels nécessitent un examen plus approfondi et lesquels doivent rester isolés jusqu’à ce que le Risk soit mieux cerné.

L’étape suivante consiste à mettre cette décision en pratique : restaurer en priorité les systèmes, les applications et les données dont l’entreprise a besoin.


Étape 4 : Rétablir les opérations essentielles dans le bon ordre

Un plan de reprise commence par définir l’état opérationnel minimum viable de l’organisation. Cela implique d’identifier les personnes, les systèmes, les applications, les données et les canaux de communication dont l’entreprise a besoin pour fonctionner à un niveau de base en cas de perturbation.

Pour certaines organisations, cela peut commencer par les services d’identité et la communication avec les collaborateurs. Pour d’autres, la priorité peut être donnée aux applications en contact avec la clientèle, aux systèmes de paiement, aux systèmes cliniques, aux opérations de fabrication ou aux plateformes logistiques. L’ordre doit refléter l’impact sur l’activité, et non pas seulement la commodité technique.

C’est au niveau des dépendances que de nombreux plans de reprise se compliquent. Une application peut être classée comme « critique », mais elle dépend néanmoins de l’identité, du DNS, de la connectivité réseau, des bases de données, du stockage, des clés de chiffrement, des API et de la surveillance. Si ces éléments ne sont pas restaurés dans le bon état, l’application peut se remettre en ligne mais rester inutilisable. C’est pourquoi les équipes de Recovery ont besoin d’une cartographie des dépendances avant un incident, et non pendant celui-ci.

Les runbooks et les workflows orchestrés permettent de transformer ces décisions en étapes reproductibles. Ils permettent de définir qui approuve la restauration, quel environnement doit être utilisé, quelles vérifications doivent être effectuées avant que l’accès à la production ne soit rétabli, et à quel moment le niveau suivant de systèmes peut être remis en ligne. Cela revêt une importance particulière lorsque les équipes chargées de la sécurité, de l’infrastructure, des applications, du cloud et des activités opérationnelles travaillent toutes simultanément.

La restauration nécessite également des points de contrôle. Après le retour de chaque charge de travail majeure, les équipes doivent vérifier que les utilisateurs peuvent s’authentifier, que les données sont disponibles, que les intégrations fonctionnent et que la surveillance est en place. Ces vérifications permettent de détecter les problèmes avant que Recovery ne s’étende au niveau suivant des systèmes.

La rapidité reste importante, mais le contrôle l’est tout autant. Une restauration rapide peut générer davantage de travail si les mauvaises données sont rétablies, si des contrôles d’accès font défaut ou si une application est rétablie sans les systèmes dont elle a besoin pour fonctionner. L’approche la plus efficace consiste à procéder à une restauration par phases, à vérifier que chaque service critique fonctionne, puis à poursuivre l’extension de la restauration à mesure que l’environnement se stabilise.


Étape 5 : Tirer les leçons de la reprise pour renforcer la continuité

Une fois les services essentiels rétablis, les équipes doivent encore comprendre ce qui a fonctionné, ce qui les a ralenties et en quoi le plan de Recovery ne correspondait pas à la réalité. C’est ce suivi qui transforme la Backup and Recovery dans le cloud d’une simple intervention ponctuelle en une pratique de résilience continue.

La première étape consiste à analyser la Recovery elle-même. Les équipes doivent se poser des questions telles que :

  • À quelle vitesse les équipes ont-elles détecté une activité suspecte ?
  • Les points de Recovery valides ont-ils été faciles à identifier ?
  • Quelles étapes de validation ont pris plus de temps que prévu ?
  • À quel moment les workflows de restauration ont-ils ralenti ?
  • Les bonnes personnes ont-elles été impliquées au bon moment ?

Ces réponses peuvent révéler des lacunes qui ne sont pas toujours d’ordre technique. Recovery peut aboutir tout en mettant en évidence des problèmes liés à la prise de décision, à la communication, aux validations ou aux relais entre les équipes.

Ces conclusions doivent être directement intégrées à la prochaine version du plan de Recovery. Si une application critique dépendait d’un système non documenté, mettez à jour la cartographie des dépendances. Si les contrôles d’accès ont ralenti la restauration, clarifiez le processus de validation. Si les tests de Recovery ont omis une charge de travail clé, ajoutez-la au prochain exercice. Si les dirigeants n’avaient pas une visibilité suffisante sur ce qui avait été restauré et ce qui était encore hors ligne, améliorez les rapports et les procédures d’escalade.

La réalisation régulière de tests est ce qui assure la cohérence de ce travail. Les exercices sur table, les restaurations isolées, les tests de Recovery en conditions réelles et la validation de la Recovery inter-cloud aident les équipes à identifier les problèmes avant qu’un incident réel ne les oblige à apprendre sous pression. Ils permettent également de fournir aux dirigeants des indications plus précises sur les domaines dans lesquels l’organisation est prête et ceux où elle a encore du travail à accomplir.

À terme, l’objectif est de disposer d’un programme de Recovery qui gagne en efficacité après chaque test et chaque incident. Les équipes sont mieux préparées, les étapes de Recovery sont mieux comprises et l’organisation dispose d’une feuille de route plus claire pour maintenir les opérations essentielles en fonctionnement en cas de perturbation.


Faire de la Recovery dans le cloud un levier de résilience de l’entreprise

 Backup and Recovery dans le cloud joue désormais un rôle plus important que la simple protection traditionnelle des données. Il s’agit d’un processus intégré visant à détecter les risques liés à la Recovery, à protéger les données sauvegardées, à valider les options de Recovery fiables et à restaurer les services critiques lorsque les environnements de production ne sont plus fiables.

En cas de cyberincident, ces activités ne peuvent pas être traitées comme des étapes distinctes. Le contexte de la menace doit déterminer quelles sauvegardes doivent être examinées. La protection des sauvegardes doit préserver les options de restauration dont les équipes pourraient avoir besoin. La validation doit déterminer ce qui est prêt à être restauré. La restauration doit rétablir les services dont dépend l’entreprise selon un ordre contrôlé.

Une sauvegarde qui ne peut être considérée comme fiable, testée ou restaurée au bon moment risque de ne pas apporter à l’entreprise le résultat dont elle a besoin. Un processus de restauration qui ne tient pas compte des identités, des dépendances entre applications ou des priorités métier peut aboutir à des systèmes techniquement restaurés, mais incomplets sur le plan opérationnel.

La véritable opportunité consiste à considérer la reprise comme une pratique de résilience continue. Cela implique de tester les plans avant un incident, de mettre à jour les cartes de dépendances à mesure que les environnements évoluent, et de tirer parti de chaque exercice ou événement de Recovery pour améliorer la réponse suivante.

Les organisations qui se remettent plus rapidement ne sont pas nécessairement celles qui disposent du plus grand nombre de copies de données. Il est impératif de savoir quelles données sont exploitables, quels services sont les plus importants et comment les restaurer en situation de crise.

Le défi consiste à rendre la Readiness pour la reprise aussi opérationnelle que la détection et la réponse. Backup and Recovery dans le cloud constituent une base pratique pour ce travail lorsqu’elles sont considérées comme un processus continu, de la détection des risques à la restauration des activités.

Les organisations doivent renforcer cette capacité afin d’être mieux à même de restaurer des données intactes, de rétablir les services critiques et de maintenir l’activité en cas de perturbation.


Accélérer la Recovery sans perte de données après une cyberattaque

Découvrez comment les solutions de Backup and Recovery de Commvault peuvent aider les entreprises à détecter les menaces, à restaurer des données intactes et à réduire les temps d’arrêt.

Questions fréquemment posées

Quelle est la différence entre la sauvegarde dans le cloud et la reprise après sinistre ?

La sauvegarde dans le cloud vise principalement à créer des copies sécurisées des données en vue de leur restauration, tandis que la reprise après sinistre vise à restaurer les applications, les systèmes et les opérations métier après une panne ou une cyberattaque. Ensemble, ces deux processus contribuent à assurer la continuité d’activité et la résilience de l’entreprise.

Pourquoi les sauvegardes immuables sont-elles importantes pour la cyber-résilience ?

Les sauvegardes immuables et indélébiles sont conçues pour empêcher que les données sauvegardées ne soient modifiées, chiffrées ou supprimées dans le cadre des paramètres de conservation définis. Associées à Commvault AirGap et à l’identification automatisée Cleanpoint, les capacités de sauvegarde immuables de Commvault permettent aux entreprises de disposer d’une source de reprise vérifiée et intacte en cas de compromission des systèmes de production.

Que dois-je rechercher dans une solution de Backup and Recovery dans le cloud ?

Recherchez une plateforme qui unifie les environnements hybrides et multicloud, le stockage immuable, l’orchestration automatisée de la Recovery et la gestion centralisée. Commvault Cloud est conçu pour répondre à ces exigences, aidant ainsi les entreprises à protéger leurs infrastructures diversifiées tout en minimisant les temps d’arrêt liés à la Recovery et la complexité opérationnelle.

La solution de sauvegarde de Commvault offre-t-elle une protection contre les ransomwares et des sauvegardes en mode « air-gap » ?

Oui. Commvault aide les entreprises à renforcer leur cyber-résilience grâce à des sauvegardes immuables, des options de restauration en mode « air-gapped », la détection des menaces, des capacités de restauration « propre » et une protection multicouche contre les ransomwares, conçues pour réduire les risques liés à la Recovery et les temps d’arrêt.

Commvault propose-t-il des tests de sauvegarde automatisés et des rapports de conformité ?

Oui. Commvault propose des tests de Recovery automatisés, la validation des sauvegardes, des rapports de conformité et une visibilité prête pour les audits afin d’aider les entreprises à vérifier la restaurabilité, à démontrer leur conformité et à améliorer leur Readiness à la restauration.

Ressources connexes

Vidéo

Récupération après une cyberattaque : Comment parvenir à une viabilité minimale en quelques minutes et non en quelques jours ?

Lorsqu’une cyberattaque frappe, chaque minute coûte 14 000 $ et la Recovery complète prend en moyenne 24 jours. Mais que se passerait-il si vous pouviez atteindre une viabilité minimale en quelques minutes plutôt qu’en plusieurs jours ?
Regardez la vidéo sur la Recovery après une cyberattaque : comment atteindre un niveau de viabilité minimale en quelques minutes, et non en plusieurs jours
Solution

Commvault AirGap

Une cyberprotection renforcée grâce à un stockage immuable sur cloud .
Découvrez la solution sur Commvault AirGap

Points clés à retenir 

  • L’adoption de l’IA s’accélère, contribuant à rendre les collaborateurs plus efficaces, plus productifs et plus compétitifs. 
  • Les entreprises ont besoin de mécanismes de gouvernance et de garde-fous pour adopter l’IA de manière responsable et à grande échelle. 
  • La sécurité et la productivité ne sont pas nécessairement en concurrence : elles peuvent se renforcer mutuellement.  
  • L’IA deviendra l’un des outils les plus précieux en matière de sécurité pour gérer les risques cybernétiques.  
  • L’adoption de l’IA fonctionne mieux lorsque l’innovation et la sécurité vont de pair. 

L’un des aspects que j’ai particulièrement appréciés dans la série « Ready. Or Not. » est que chaque conversation s’appuie sur la précédente. Nous avons commencé par explorer les opportunités et les risques liés à l’IA agentique. Nous avons ensuite examiné comment les entreprises peuvent instaurer la confiance à mesure que l’IA s’intègre dans le quotidien de l’entreprise. Cet épisode aborde la question logique qui s’ensuit : comment utiliser concrètement l’IA en toute sécurité ? 

L’humoriste Nathan Macintosh s’entretient avec Rinki Sethi, RSSI et responsable de la sécurité chez Upwind Security, pour discuter de ce à quoi ressemble concrètement une adoption responsable de l’IA. Ils abordent tous les aspects, de la gouvernance de l’IA et des garde-fous à l’expérience utilisateur, en passant par le rôle croissant que l’IA jouera dans la cybersécurité.

Nathan continue de poser les questions que beaucoup d’entre nous se posent. Devrions-nous nous inquiéter ? À quel point devons-nous être plus productifs ? Et l’IA peut-elle réellement améliorer la sécurité ? Regardez l’épisode dans son intégralité sur Readiverse. Ce que j’ai le plus apprécié dans cette conversation, c’est que Rinki est sincèrement enthousiaste à l’égard des nouvelles technologies et de leur protection. Elle n’a pas présenté l’IA comme une source d’inquiétude pour les organisations. Au contraire, elle s’est attachée à encourager les entreprises à aller de l’avant en toute confiance en mettant en place les garde-fous appropriés. Voici les idées qui m’ont marqué. 

La poussée en faveur de l’adoption de l’IA  

Une chose ressort clairement de cette conversation : de nombreuses entreprises ne se contentent pas d’encourager leurs collaborateurs à adopter l’IA, elles leur imposent cette adoption. Ces entreprises reconnaissent que l’utilisation de l’IA aide les collaborateurs à résoudre les problèmes plus efficacement, ce qui est essentiel pour rester compétitives. 

« Chaque entreprise a une directive… nous devons utiliser l’IA partout dans l’entreprise. »

– Rinki Sethi 

La question n’est plus de savoir si l’IA a sa place sur le lieu de travail, mais si les employés disposent des garde-fous adéquats pour l’utiliser de manière responsable. À mesure que l’adoption de l’IA s’accélère, les organisations ont besoin de normes claires concernant les outils d’IA que les employés peuvent utiliser et la manière dont les données de l’entreprise sont protégées. 

Aperçu : la gouvernance de l’IA

Rinki explique que la gouvernance ne consiste pas seulement à se prémunir contre de nouveaux risques. Il s’agit de créer un cadre qui aide les employés à utiliser l’IA de manière responsable tout en s’adaptant à l’évolution des réglementations et des normes du secteur. 

L’avantage caché de la productivité 

Voici un aspect auquel je n’avais jamais pensé auparavant. Rinki explique que l’IA ne se contente pas d’aider les gens à travailler plus vite. Dans de nombreux cas, elle permet aux employés les plus performants de se démarquer.

Elle a pris l’exemple des développeurs logiciels. Lorsque les assistants de codage basés sur l’IA ont fait leur apparition, beaucoup ont supposé qu’ils n’aideraient que les développeurs moins expérimentés. Au contraire, certains des meilleurs ingénieurs ont commencé à les utiliser pour gagner en rapidité. Ils ont ainsi pu résoudre des problèmes plus complexes et consacrer davantage de temps à un travail créatif plutôt qu’à des tâches répétitives.

C’est précisément ce type de productivité qui explique pourquoi les entreprises imposent l’utilisation de l’IA. Elle ne limite pas les capacités des individus : elle leur offre davantage d’espace pour se concentrer sur des tâches à plus forte valeur ajoutée. 

« On peut faire preuve de bien plus de créativité dans sa façon de travailler… parce qu’on se crée les conditions pour cela. »

– Rinki Sethi 

Le rôle de l’IA dans la cybersécurité 

« Comment l’IA peut-elle être utilisée pour renforcer la sécurité sans être simplement considérée comme une menace venue pour nous anéantir ? » – Nathan Macintosh 

Lorsque l’on aborde l’IA et la sécurité, la discussion porte souvent sur les risques. Mais Rinki estime que l’IA deviendra l’un des plus grands atouts de la cybersécurité.

Les équipes de sécurité sont déjà submergées par le volume d’alertes, de journaux et de données qu’elles doivent analyser chaque jour. Les analystes humains ne peuvent tout simplement pas suivre le rythme. Plutôt que de remplacer les professionnels de la sécurité, l’IA les aide en filtrant d’énormes quantités de données en quelques secondes. Cela permet aux analystes d’identifier les faux positifs afin qu’ils puissent se concentrer sur l’analyse des menaces réelles.

Ma conclusion est que l’avenir de la cybersécurité ne se résume pas à un opposition entre les humains et l’IA : il s’agit plutôt pour les humains de travailler aux côtés de l’IA afin de prendre de meilleures décisions, de réagir plus rapidement et d’adapter leurs opérations à une échelle jusqu’alors impossible. 

Prêts pour la suite ? 

Chaque épisode de « Ready. Or Not. » m’a rappelé que les débats les plus importants sur l’IA portent souvent sur les personnes : comment nous nous adaptons, comment nous apprenons et comment nous acquérons la confiance nécessaire pour utiliser les nouvelles technologies de manière responsable. La véritable opportunité pour les organisations ne réside pas seulement dans l’adoption de l’IA. Elle consiste à créer un environnement dans lequel les employés peuvent utiliser l’IA pour travailler plus intelligemment, devenir plus créatifs et obtenir de meilleurs résultats pour l’entreprise. Regardez l’épisode dans son intégralité sur Readiverse. 

FAQ 

Q : Pourquoi les organisations adoptent-elles l’IA aussi rapidement ?

R : De nombreuses organisations considèrent l’IA comme un moyen d’améliorer la productivité, d’accroître l’efficacité et de donner aux employés plus de temps à consacrer à des tâches à plus forte valeur ajoutée.

Q : Qu’est-ce que la gouvernance de l’IA ?

R : La gouvernance de l’IA est l’ensemble des politiques, des processus et des mécanismes de contrôle qui aident les organisations à adopter l’IA de manière responsable tout en gérant les risques liés à la sécurité, à la confidentialité et à la conformité. 

Q : Pourquoi l’expérience utilisateur est-elle importante pour la sécurité ?

R : Les contrôles de sécurité qui créent des frictions inutiles incitent souvent les utilisateurs à trouver des solutions de contournement. Concevoir des systèmes sécurisés qui soient également faciles à utiliser contribue à améliorer à la fois l’adoption et la protection.

Q : L’IA peut-elle contribuer à améliorer la cybersécurité ?

R : L’IA peut aider les équipes de sécurité à analyser de grandes quantités de données, ce qui contribue à réduire les faux positifs. Cela permet ensuite aux équipes de hiérarchiser les menaces et de réagir plus efficacement aux incidents de sécurité.

Q : Faut-il avoir peur de l’IA ?

R : Selon Rinki, un scepticisme sain est précieux, mais la peur ne doit pas empêcher les organisations d’adopter cette technologie de manière responsable. La formation, la gouvernance et des pratiques de sécurité rigoureuses peuvent aider les organisations à utiliser l’IA en toute confiance. 

Q : Quel est le principal enseignement à retenir de cet épisode ? R : L’adoption de l’IA ne revient pas à choisir entre innovation et sécurité. Les organisations qui associent une gouvernance rigoureuse à des mesures de sécurité concrètes seront mieux à même de tirer parti des avantages de l’IA tout en gérant ses risques. Katherine Demacopoulos est directrice principale de la stratégie et des programmes de contenu mondiaux chez Commvault. 

More related posts


AI Data Resilience

Read more about AI Data Resilience

AI-Ready Data Protection

Read more about AI-Ready Data Protection

Comment Mythos et GPT-5.5-Cyber pourraient transformer la sécurité des données dans le cloud

Des modèles d’IA spécialisés dans la cybersécurité pourraient accélérer la détection des vulnérabilités et la mise en œuvre de scénarios d’attaques en plusieurs étapes. Au-delà de la prévention, les équipes chargées de la sécurité des données dans le cloud ont besoin d’une meilleure visibilité, d’une gouvernance renforcée et d’une capacité de Recovery sans faille. 

Points clés à retenir

L’IA cyber de pointe réduit le délai entre la détection et l’intervention, démontrant ainsi pourquoi les organisations ont besoin d’une sécurité des données dans le cloud axée sur la résilience, articulée autour d’une Recovery sans faille et des ResOps. 

  • Claude Mythos et GPT-5.5-Cyber restent des modèles à accès restreint, mais ils donnent un aperçu d’un avenir où l’IA pourra raisonner à travers des workflows cybernétiques complexes et accélérer à la fois les opérations de défense et, potentiellement, celles des attaquants.
  • À mesure que le délai entre la découverte d’une vulnérabilité et son exploitation se réduit, les entreprises ont besoin d’une meilleure visibilité sur leurs dépendances cloud, les risques liés aux identités et les chemins d’attaque interconnectés avant que des perturbations ne surviennent.
  • Recovery ne se résume plus à la restauration de sauvegardes. Les organisations doivent définir leur « entreprise minimale viable », valider des points de reprise fiables et restaurer les systèmes critiques dans le bon ordre.
  • Les opérations de résilience alignent les équipes de sécurité, informatiques et métier autour d’objectifs de Recovery mesurables, aidant ainsi les organisations à gouverner leurs données, à hiérarchiser la Recovery et à rétablir des opérations fiables avec davantage d’assurance.

 Claude Mythos et GPT-5.5-Cyber pourraient influencer la sécurité des données dans le cloud en accélérant la détection, le test et la gestion des risques. Leur impact reste incertain, mais ils soulignent la nécessité d’une meilleure visibilité des données, d’une gouvernance des accès renforcée et d’une Recovery sans faille dans tous les environnements cloud. 

Claude Mythos et GPT-5.5-Cyber donnent aux équipes de sécurité un aperçu précoce de ce qu’une IA cybernétique plus spécialisée pourrait signifier pour la sécurité des données dans le cloud. 

Aucun de ces modèles n’est encore largement disponible, et leur impact à long terme reste incertain. Mais leur existence est importante, car les environnements cloud sont déjà difficiles à défendre. Les données sensibles, les systèmes d’identité, les applications SaaS, les pipelines de développement, les charges de travail d’IA et les infrastructures de Recovery dépendent souvent les uns des autres selon des liens difficiles à percevoir jusqu’à ce qu’un incident survienne. 

L’évaluation de Claude Mythos Preview réalisée en avril 2026 par l’AI Security Institute britannique a mis en évidence une amélioration significative lors de simulations de cyberattaques en plusieurs étapes, notamment la capacité à mener des attaques en plusieurs phases contre des réseaux vulnérables lorsqu’elles sont explicitement ordonnées dans un environnement contrôlé.  

Cette même évaluation a toutefois souligné que ses conditions d’essai diffèrent des environnements réels et ne permettent pas de déterminer si Mythos serait capable d’attaquer des systèmes bien protégés. Elle montre néanmoins pourquoi les équipes chargées de la sécurité des données dans le cloud devraient prêter attention à la direction que prennent les choses. 

À mesure que les capacités de l’IA en matière de cybersécurité gagnent en maturité, la question n’est pas seulement de savoir si les attaques deviennent plus rapides. Il s’agit plutôt de déterminer si le délai entre la découverte d’une faille et son exploitation continue de se réduire. Lorsque ce délai se resserre, la sécurité des données dans le cloud ne se limite plus à la simple prévention des compromissions. La question devient alors de savoir si les organisations sont capables de comprendre les risques assez rapidement, de réguler les accès de manière cohérente et de rétablir des opérations fiables avant que la perturbation ne s’étende. 

Pourquoi Mythos et GPT-5.5-Cyber sont importants 

L’importance de Mythos et de GPT-5.5-Cyber ne réside pas dans le fait que toutes les organisations y auront soudainement accès. D’après les informations publiques actuellement disponibles, il s’agit de modèles contrôlés à accès restreint. Pour les équipes chargées de la sécurité des données dans le cloud, leur importance tient à ce qu’ils laissent entrevoir quant à l’orientation de l’IA cybernétique : des systèmes plus spécialisés, conçus pour prendre en charge des workflows de sécurité complexes. 

Cette distinction est importante. Un assistant IA polyvalent peut aider à résumer des alertes ou à rédiger un rapport d’incident. Un modèle d’IA cybernétique spécialisé est différent. Il peut être conçu pour analyser de manière cohérente les vulnérabilités, l’infrastructure, les voies d’attaque, les contrôles défensifs et les étapes de validation. Dans des environnements autorisés, cela pourrait aider les équipes de sécurité à tester les environnements, à hiérarchiser les expositions et à renforcer la planification de la Recovery avant qu’un incident ne se produise. 

Pour les équipes chargées de la sécurité des données dans le cloud, l’impact pratique tient moins aux noms des modèles qu’aux workflows qu’ils représentent. Les risques liés au cloud proviennent souvent des interconnexions entre les systèmes : une charge de travail mal configurée, un ensemble de données exposé, une identité aux autorisations trop larges, une dépendance à la sauvegarde ou un chemin de Recovery non testé. Une IA spécialisée en cybersécurité pourrait faciliter et accélérer l’évaluation de ces relations, en particulier dans les grands environnements où un examen manuel peut passer à côté de la manière dont un problème en affecte un autre. 

Cette évolution reflète un changement plus large qui s’opère dans le domaine de la cybersécurité. Le défi consiste désormais moins à identifier des vulnérabilités individuelles qu’à comprendre comment des systèmes interconnectés se comportent sous pression. L’IA pourrait bientôt aider les défenseurs à analyser simultanément les identités, les charges de travail dans le cloud, les sauvegardes, les applications SaaS, les pipelines d’IA et les dépendances métier — révélant non seulement des risques isolés, mais aussi la manière dont ces risques se combinent pour entraîner une défaillance opérationnelle. 

Cela modifie également la manière dont les organisations doivent envisager leur Readiness. Si l’IA peut aider les défenseurs à mener à bien des tâches cybernétiques complexes plus efficacement, des techniques similaires pourraient à terme influencer également les méthodes des attaquants. La préoccupation ne réside pas seulement dans le fait que les attaques deviennent plus rapides, mais aussi dans le fait que le délai entre la découverte d’une faille, son test et la mise en œuvre d’une réponse pourrait se réduire. 

Les équipes chargées de la sécurité des données dans le cloud doivent désormais se préparer à une question plus épineuse : que se passera-t-il lorsque les mêmes types de workflows assistés par l’IA qui aident les défenseurs à valider les risques faciliteront également la détection, le test et l’enchaînement des points faibles ? C’est là que l’environnement cloud lui-même devient le problème. 

L’IA rend la sécurité des données dans le cloud encore plus cruciale 

La plupart des entreprises ne disposent pas d’un environnement cloud unique et homogène. Elles exploitent plusieurs clouds, des plateformes SaaS, des lacs de données, des systèmes d’identité, des pipelines de développement, des référentiels de sauvegarde et des charges de travail d’IA qui dépendent tous les uns des autres.  

Cette complexité engendre déjà des failles : les données sensibles peuvent être surexposées, les autorisations d’accès peuvent dériver et les plans de Recovery peuvent ne pas refléter le fonctionnement réel de l’entreprise.  

Dans la pratique, ces failles restent rarement isolées. Un compartiment de stockage contenant des données sensibles peut ne pas sembler urgent en soi. Un compte de service aux autorisations trop larges peut passer pour un simple problème de configuration. Une dépendance de Recovery non testée peut passer inaperçue tant que le système fonctionne encore. Mais lorsque ces problèmes s’enchaînent, ils peuvent ouvrir la voie à une exposition aux risques, voire à une perturbation. 

Les attaquants connaissent bien ces vulnérabilités. Le rapport « 2026 M-Trends » de Mandiant souligne que les opérateurs de ransomware ciblent de plus en plus les infrastructures de sauvegarde, les services d’identité et les plans de gestion de la virtualisation. Il met également en évidence la manière dont les attaquants utilisent des jetons OAuth à longue durée de vie, des cookies de session, des clés codées en dur et des jetons d’accès personnels pour se déplacer d’un environnement à l’autre. 

Ajoutons à cela une IA cybernétique plus performante : si les modèles peuvent aider à détecter plus rapidement les vulnérabilités, à tester plus efficacement leur exploitabilité ou à relier des signaux faibles entre les systèmes, les défenseurs pourraient en tirer profit. Cependant, les attaquants pourraient eux aussi en bénéficier à terme, surtout si des capacités similaires deviennent plus accessibles ou sont reproduites ailleurs. 

22 secondes
Temps médian entre un événement d’accès initial et le transfert à un groupe de menaces secondaire  

Source : rapport M-Trends 2026 de Mandiant 

C’est pourquoi le débat ne peut se limiter à l’affirmation selon laquelle « l’IA accélère les attaques ». L’IA de pointe dans le domaine de la cybersécurité modifie le rythme de la sécurité. À mesure que le délai entre la découverte, la validation et l’exploitation se réduit, tout retard dans la compréhension des dépendances du cloud ou dans la préparation de Recovery devient plus coûteux. 

Comment l’IA cybernétique de nouvelle génération pourrait-elle transformer la défense du cloud ? 

Bien que l’impact global de Mythos et de GPT-5.5-Cyber reste encore inconnu, ces outils mettent en évidence trois évolutions concrètes que les équipes chargées de la sécurité des données dans le cloud devraient surveiller. Chacune d’entre elles revient à la même question : la sécurité des données dans le cloud dépend désormais de la rapidité avec laquelle les organisations sont capables de comprendre les risques, d’y faire face et de se remettre d’un incident. 

Les cyberdéfenseurs doivent prêter attention aux éléments suivants :

  • Rapidité : les outils assistés par IA peuvent aider les défenseurs autorisés à examiner le code, à trier les vulnérabilités, à analyser les logiciels malveillants, à valider les correctifs et à tester les contrôles plus rapidement que ne le permettent les workflows traditionnels. 
  • L’échelle : les risques liés au cloud se concentrent rarement en un seul endroit. Une vulnérabilité dans une application, une identité dotée de droits trop étendus, un compartiment de stockage mal configuré et un chemin de Recovery non testé peuvent former une seule et même chaîne d’attaque. 
  • Pression sur la reprise : si l’IA aide les attaquants à agir plus rapidement, les organisations doivent se remettre plus vite et de manière plus propre. Les sauvegardes ne suffisent pas à elles seules si les équipes ne savent pas quelles données sont saines, à quels systèmes d’identité elles peuvent faire confiance, ni si la reprise réintroduira des ressources compromises.

Pour les défenseurs, le changement le plus important réside peut-être dans l’enchaînement des tâches. Aujourd’hui, de nombreuses équipes passent de l’alerte à l’enquête, puis à la correction et enfin à la planification de Recovery, en étapes distinctes, souvent entre différentes équipes. L’IA appliquée à la cybersécurité pourrait condenser ce flux de travail en aidant les équipes à passer plus rapidement d’un signal à un ensemble d’actions recommandées. 

Cela ne signifie pas pour autant que les décisions doivent devenir automatiques. Cela signifie plutôt que les équipes pourraient avoir besoin de règles plus claires pour déterminer quand se fier à une recommandation, quand faire appel à un examinateur humain et quand passer de l’enquête à la préparation de la Recovery. Un modèle peut aider à identifier un chemin d’attaque possible, mais ce sont toujours les personnes qui doivent décider s’il faut bloquer l’accès, isoler une charge de travail, préserver les preuves, informer les parties prenantes ou préparer un chemin de Recovery propre. 

C’est là que le processus devient aussi important que les outils. L’IA cyber de nouvelle génération pourrait aider les défenseurs à agir plus rapidement, mais uniquement si les équipes disposent d’étapes de validation et de plans de Recovery clairs. Sans cette structure, la rapidité peut être source de confusion. Avec elle, les workflows assistés par l’IA pourraient aider les équipes à agir plus tôt tout en conservant le contrôle sur la manière dont le Risk est évalué et dont les décisions de Recovery sont prises. 

Pourquoi une Recovery propre revêt une importance accrue à mesure que les risques évoluent plus rapidement 

Lorsque les risques liés au cloud évoluent plus rapidement, la planification de la reprise doit gagner en précision. Il ne suffit pas de savoir que des copies de sauvegarde existent. Les équipes doivent avoir l’assurance que les données qu’elles restaurent sont fiables, que l’environnement de Recovery est isolé et que les systèmes remis en ligne ne réintroduiront pas la même menace que celle qui a provoqué la perturbation. 

Cela est essentiel car les environnements cloud sont fortement interconnectés. Une identité compromise, un ensemble de données corrompu, une machine virtuelle affectée ou une charge de travail mal configurée peuvent créer de l’incertitude au sein de plusieurs services. Lors d’un incident, les équipes peuvent avoir besoin de déterminer quels points de reprise sont « propres », quelles dépendances doivent être rétablies en priorité, et si les données restaurées peuvent soutenir les opérations métier en toute sécurité. 

Une Recovery « propre » modifie également la manière dont les équipes appréhendent les priorités. L’objectif n’est pas nécessairement de tout restaurer immédiatement, mais de restaurer suffisamment d’éléments de l’activité pour permettre un fonctionnement en toute sécurité. 

De nombreuses organisations savent quelles applications elles considèrent comme « critiques », mais elles sont bien moins nombreuses à avoir défini leur « entreprise minimale viable » : la plus petite combinaison d’identités, de services cloud, de données, d’applications et d’infrastructure nécessaire pour maintenir le fonctionnement de l’entreprise en cas de perturbation. Ces dépendances ne deviennent souvent visibles que lorsque Recovery est testé dans des conditions réalistes. 

Dans un paysage de menaces dominé par l’IA, il est crucial de déterminer la « société minimale viable ». Une détection plus rapide des vulnérabilités et un développement plus efficace des chaînes d’attaque pourraient exercer une pression accrue sur les équipes de Recovery, les obligeant à prendre des décisions hautement fiables dans des délais très serrés. 

De plus, les systèmes d’identité, les configurations cloud, les communications d’entreprise, les applications destinées aux clients et les données dont ils dépendent peuvent tous devoir être remis en service selon une séquence mûrement réfléchie — non pas simplement en fonction de la priorité technique, mais en fonction de ce dont l’entreprise a besoin en premier lieu pour fonctionner. 

Les organisations ont besoin de processus de Recovery capables de valider des données saines, de mettre en place la Recovery dans des environnements isolés, de protéger les dépendances d’identité critiques et de tester les plans de Recovery avant qu’un incident ne les y oblige. À mesure que les capacités de l’IA cybernétique gagnent en maturité, les équipes chargées de la sécurité des données dans le cloud devraient considérer la Recovery sans faille comme faisant partie intégrante de la stratégie de sécurité, et non comme une étape post-incident. 

Mettre en place une sécurité des données axée sur la résilience 

La sécurité des données dans le cloud s’est souvent concentrée sur la prévention des fuites : identifier les données sensibles, les classer, en contrôler l’accès et réduire les risques. Ce travail reste essentiel. En réalité, il prend encore plus d’importance à mesure que les systèmes d’IA exploitent les données d’entreprise via des invites, des systèmes de recherche, des pipelines d’entraînement, des workflows d’analyse et des outils automatisés d’aide à la décision. 

En effet, les données peuvent être transférées vers de nouveaux contextes sans pour autant être transférées vers un nouveau système d’enregistrement. Un ensemble de données sensibles peut alimenter un workflow de recherche, façonner la réponse d’un modèle ou apparaître dans un journal de requêtes. La gouvernance ne porte donc plus tant sur un emplacement spécifique que sur la manière dont les données sont consultées, réutilisées et récupérées à travers les différents workflows. 

Mais la prévention à elle seule ne suffit pas pour la prochaine étape de la sécurité des données dans le cloud. Si l’IA spécialisée en cybersécurité peut aider les équipes de sécurité à détecter les vulnérabilités, à tester les voies d’attaque et à relier plus rapidement les signaux faibles, les programmes de sécurité des données doivent alors prendre en compte ce qui se passe une fois qu’une exposition a été détectée ou exploitée. La visibilité et les contrôles d’accès ne constituent qu’une partie du tableau. Les équipes ont également besoin d’une voie claire vers une Recovery fiable. 

Définir cette voie nécessite plus que de simples outils de sécurité plus performants. Cela nécessite un modèle opérationnel de Recovery qui aligne les responsables de la sécurité, de l’informatique et de l’entreprise autour de priorités de Recovery communes avant même qu’un incident ne se produise. De plus en plus, les organisations qualifient cette discipline de « ResOps », ou opérations de résilience : une approche structurée visant à rendre la Recovery mesurable, reproductible et liée aux résultats commerciaux plutôt qu’à la seule réussite de la sauvegarde. 

Dans le cadre des ResOps, les organisations doivent comprendre : 

  • Quels ensembles de données sont les plus critiques pour les opérations métier ? 
  • Quelles identités, quels services cloud et quels workflows d’IA dépendent des ensembles de données critiques pour l’activité ? 
  • Les politiques de gouvernance et d’accès sont-elles alignées sur les risques métier ? 
  • Quel est l’état opérationnel minimum viable que l’entreprise doit rétablir en priorité ? 
  • Ces décisions de Recovery peuvent-elles être validées avant un incident plutôt que pendant celui-ci ? 

C’est le changement vers lequel tendent Mythos et GPT-5.5-Cyber. L’avenir de la sécurité des données dans le cloud ne sera pas défini par la seule prévention. À mesure que l’IA cybernétique réduit le délai entre la détection et l’action, les organisations devront avoir une confiance tout aussi grande dans leurs capacités de reprise. Cela implique de comprendre les dépendances du cloud avant un incident, de définir le niveau minimal de fonctionnement qu’elles doivent rétablir et de considérer la reprise comme une discipline opérationnelle plutôt que comme une considération technique secondaire. 

Mythos et GPT-5.5-Cyber sont importants non pas parce que toutes les entreprises utiliseront ces modèles dès demain, mais parce qu’ils révèlent la direction que prend la cybersécurité. Alors que l’IA accélère à la fois la défense et l’attaque, les entreprises les plus performantes ne seront pas simplement celles qui disposent des contrôles préventifs les plus solides. Ce seront celles qui pourront prouver qu’elles savent quoi restaurer, dans quel ordre, et comment rétablir des opérations fiables avant que l’incertitude ne se transforme en perturbation de l’activité. 

Questions fréquemment posées

Quand ces modèles spécialisés seront-ils rendus publics ?

Il n’y a pas de calendrier confirmé pour une mise à disposition au grand public. Selon les informations actuelles, Claude Mythos serait réservé à certaines organisations dans le cadre de programmes contrôlés, tandis qu’OpenAI précise que GPT-5.5-Cyber n’est accessible qu’aux défenseurs agréés via son programme « Trusted Access for Cyber ».

Les attaques basées sur l’IA sont-elles susceptibles de se multiplier ?

Pas nécessairement. Mais elles montrent que l’IA avancée peut prendre en charge des workflows cybernétiques plus complexes, ce qui signifie que les organisations doivent se préparer à des cycles de détection, de test et d’exploitation plus rapides.

Quels risques les équipes doivent-elles traiter en priorité ?

Commencez par assurer la visibilité sur les données sensibles, les chemins d’accès, les erreurs de configuration dans le cloud, les dépendances d’identité et l’état de Readiness à la restauration. Les fonctionnalités de sécurité des données et de l’IA de Commvault peuvent aider les équipes à classer les données, à réguler les accès et à identifier les risques dans les environnements cloud. 

Pourquoi la Recovery est-elle importante pour la sécurité des données dans le cloud ?

Parce que la prévention peut échouer. Les fonctionnalités de cyber-résilience de Commvault peuvent aider les entreprises à identifier des points de Recovery sains, à valider la Recovery dans des environnements isolés et à restaurer les données et les services critiques sans réintroduire d’actifs compromis. 

Commvault propose-t-il une détection des menaces assistée par l’IA ?

Oui. Commvault peut utiliser des fonctionnalités basées sur l’IA pour aider à identifier les menaces, détecter les activités anormales, hiérarchiser les risques et accélérer la réponse aux incidents. Associées à la cyber-résilience et aux workflows de Recovery, ces fonctionnalités permettent aux équipes d’améliorer leurs processus de réponse et de restaurer les données critiques en toute confiance.


Chez Commvault, nous parlons beaucoup de cyber-résilience, c’est-à-dire de la capacité à se remettre de toutes les difficultés qui se présentent. Mais pour un ingénieur du prestataire australien de services technologiques Perfekt, c’est sa résilience personnelle qui lui permet de réussir.

Viktor Trokhin a quitté l’Ukraine lorsque la guerre a éclaté, traversant cinq pays avant de retrouver finalement sa famille en Australie. Il apportait avec lui plus de six ans d’expérience dans les TIC, une expertise technique approfondie et la détermination de poursuivre sa carrière dans le secteur technologique.

Comme beaucoup de professionnels qualifiés qui repartent de zéro dans un nouveau pays, Viktor ne se contentait pas de s’adapter à un nouvel environnement de travail. Il devait acquérir une expertise dans les nouvelles technologies, communiquer dans une deuxième langue et trouver sa place dans un environnement professionnel différent.

Marcus Rolim, directeur général des services gérés chez Perfekt et responsable hiérarchique de Viktor, a immédiatement perçu son potentiel.

« Notre programme de développement en ingénierie est axé sur les personnes », explique Marcus. « Nous investissons massivement dans le mentorat et la création d’opportunités pour les ingénieurs issus de différents horizons. »

Au fil des ans, Perfekt a accueilli des ingénieurs provenant d’une dizaine de pays différents. Plutôt que de suivre un parcours de formation standard, l’entreprise se concentre sur les points forts de chacun, en proposant du mentorat, une expérience pratique et un soutien là où cela est le plus nécessaire.

Pour Viktor, cela signifiait s’appuyer sur son expertise existante tout en acquérant de l’expérience avec Commvault Cloud et la cyber-résilience.

Au fur et à mesure qu’il travaillait avec les clients, Arlie – l’assistant IA de Commvault Cloud – s’est naturellement intégrée à son flux de travail quotidien. Qu’il s’agisse d’explorer les fonctionnalités d’un produit, de résoudre un problème ou de rechercher des conseils, Arlie l’aidait à trouver rapidement des informations fiables sans interrompre son travail.

Puis est apparu un avantage inattendu.

Comme Arlie prend en charge plusieurs langues, Viktor pouvait assimiler des concepts complexes dans sa langue maternelle avant de passer à l’anglais lorsqu’il s’adressait à des clients ou à des collègues. Bien que ce ne fût pas le cas d’utilisation initialement envisagé par Perfekt, cela s’est rapidement révélé être un atout précieux pour l’apprentissage.

« Lorsqu’un ingénieur peut explorer une question complexe dans sa propre langue, comprendre le raisonnement qui sous-tend la réponse, puis la communiquer clairement en anglais, cela transforme l’expérience d’apprentissage », explique Marcus. « Cela permet à ses compétences techniques de s’exprimer pleinement sans que la langue ne constitue un obstacle. »

Aujourd’hui, Viktor est ingénieur en infrastructure et protection des données chez Perfekt ; il accompagne les clients tout en continuant à approfondir son expertise en matière de cyber-résilience.

Lorsque Viktor a quitté l’Ukraine, il emportait avec lui des années d’expérience, une expertise technique approfondie et une détermination inébranlable à poursuivre la carrière qu’il avait construite à la sueur de son front. Aujourd’hui, il aide les organisations à renforcer leur cyber-résilience, en s’appuyant sur cette même résilience qui l’a aidé à reconstruire sa propre vie.

C’est peut-être pour cela que cette histoire trouve un écho particulier. La résilience de Viktor a façonné son propre avenir. Aujourd’hui, elle lui permet de faire la différence pour les autres. Voilà à quoi ressemble le fait de donner la priorité aux personnes : des organisations comme Perfekt qui investissent dans les individus, et des technologies comme Commvault Cloud qui les aident à s’épanouir. Chris DiRado est directeur de l’expérience produit chez Commvault.
More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Comment les responsables de la sécurité peuvent-ils protéger leurs données les plus sensibles ?

La sécurité des données et de l’IA permet aux entreprises d’identifier, de classer et de contrôler l’accès aux données sensibles pour l’ensemble des utilisateurs, des systèmes et des solutions d’IA.

Points clés à retenir

Les données sont le moteur des entreprises modernes : elles aident à orienter les décisions clés et alimentent les initiatives en matière d’IA. Compte tenu de leur valeur, il est essentiel de connaître et de protéger vos données.

  • 90 % des organisations ont exposé des données sensibles dans le cloud qui peuvent être mises en évidence par l’IA. La visibilité sur les actifs de données constitue donc la première étape, et la plus cruciale, pour réduire les risques d’entreprise. 
  • 40 % des fichiers téléchargés ou partagés via des outils d’IA générative contiennent des informations d’identification personnelle (PII) ou des données relevant de la norme PCI (Payment Card Industry). Une telle utilisation abusive des données sensibles expose les entreprises à des risques importants en matière de confidentialité et de non-respect de la réglementation. 
  • La découverte et la classification des données constituent le fondement d’une sécurité efficace, en aidant les organisations à identifier les données sensibles dans des environnements structurés, semi-structurés et non structurés.
  • Un accès trop permissif constitue l’un des risques liés aux données les plus persistants pour les entreprises modernes. Les utilisateurs, les applications et les comptes de service conservant souvent un accès inutile aux données sensibles, la « surface d’attaque » s’élargit.
  • Pour contribuer à la protection de l’IA, il est nécessaire de réguler à la fois les données d’entraînement et les interactions en temps réel. Les organisations doivent s’assurer que les données sensibles ne sont pas exposées par le biais des entrées, des sorties ou du comportement des modèles.
  • La conformité réglementaire repose sur des bases solides en matière de données. Une classification rigoureuse et une gouvernance stricte des accès permettent aux organisations d’appliquer leurs politiques et de démontrer qu’elles exercent un contrôle.

Les données sensibles circulent désormais entre les clouds, les applications et les flux de travail d’IA sans visibilité claire, ce qui engendre des risques d’exposition que les contrôles de sécurité traditionnels ne peuvent à eux seuls contrer. La solution « Commvault Data and AI Security » aide les entreprises à identifier et à classer les données sensibles, à réguler l’accès tant pour les identités humaines que pour celles des machines, et à garantir la conformité aux normes RGPD, HIPAA et PCI DSS tout au long du cycle de vie des données.


Pourquoi la fuite de données sensibles constitue-t-elle la principale faille de sécurité ?

Les données constituent le carburant inestimable qui fait avancer les entreprises modernes. C’est pourquoi les organisations se sont fixé comme priorité d’investir massivement dans des outils de sécurité sophistiqués.

Cependant, selon le rapport « 2025 State of Data Security » de Varonis, 90 % des entreprises exposent encore des données sensibles dans le cloud. De même, 88 % des entreprises comptent des utilisateurs fantômes, c’est-à-dire des comptes inactifs mais toujours activés.

Mais ce n’est pas tout. Selon le rapport « Cost of a Data Breach Report 2025 » d’IBM, 53 % des entreprises victimes d’une violation ont signalé que les informations personnelles identifiables (PII) de leurs clients avaient été compromises. Ces statistiques brossent un tableau saisissant : bien que les données soient au cœur des activités des entreprises, leur visibilité et leur sécurité globale restent des enjeux critiques. 

Les données ne se limitent plus aux bases de données structurées. Elles se trouvent dans des fichiers, des e-mails, des plateformes cloud, des applications SaaS et des terminaux. Une grande partie de ces données est non structurée, dupliquée ou non gérée, ce qui rend leur suivi et leur protection difficiles.

L’IA amplifie ce problème. Environ 40 % des fichiers téléchargés vers des outils d’IA générative contiennent des informations sensibles, souvent sans gouvernance ni supervision. À mesure que l’adoption de l’IA progresse, le nombre de systèmes et d’identités interagissant avec les données augmente également.

Sans visibilité sur la nature des données existantes et leur emplacement, les entreprises ne peuvent pas les sécuriser efficacement. Ce manque de visibilité est à l’origine du problème actuel de sécurité des données.


Quels sont les piliers de la sécurité des données et de l’IA ?

Pour relever le défi de l’exposition des données, les organisations ont besoin d’une approche structurée qui apporte cohérence et contrôle à la gestion des données. La sécurité des données et de l’IA repose sur trois piliers fondamentaux : la découverte des données, la classification des données et la gouvernance de l’accès aux données et à l’IA.

Chaque pilier comble une lacune majeure :

  • La découverte offre une visibilité sur l’emplacement des données dans l’ensemble des environnements. Cela inclut les systèmes structurés tels que les bases de données, ainsi que les sources semi-structurées et non structurées qui sont souvent négligées.
  • La classification apporte du contexte en identifiant le type et le niveau de sensibilité des données. Elle permet aux entreprises de distinguer les données opérationnelles, les informations personnelles sensibles, les documents financiers, la propriété intellectuelle et d’autres catégories à haut risque.
  • La gouvernance des accès permet aux organisations de vérifier que les données sont utilisées de manière appropriée. Elle définit qui ou quoi peut accéder aux données, dans quelles conditions et avec quel niveau de contrôle.

Ces trois piliers n’existent pas indépendamment les uns des autres. Ils forment un système interconnecté qui couvre intégralement la sécurité des données et de l’IA. La découverte identifie l’ensemble du paysage des données, la classification définit le niveau de sensibilité approprié, et la gouvernance des accès applique des contrôles en fonction de ce contexte.

Ce modèle s’étend même au-delà des utilisateurs humains pour inclure les identités machines, telles que les modèles d’IA. Dans les environnements modernes, ces identités non humaines représentent souvent une part significative de l’activité d’accès aux données. La mise en commun de ces piliers peut aider les organisations à passer de contrôles de sécurité fragmentés à une approche unifiée, guidée par des politiques.


Comment les organisations peuvent-elles identifier et classer les données sensibles ?

La détection et la classification sont les fondements d’un modèle de sécurité des données efficace. Pourtant, ce sont souvent les aspects les plus difficiles à mettre en œuvre de manière efficace.

Cela s’explique par la forte fragmentation des environnements de données modernes. Les informations sensibles sont dispersées entre de multiples plateformes cloud, des systèmes sur site, des applications SaaS et des terminaux. Une part importante de ces données est non structurée, ce qui rend leur identification et leur catégorisation plus difficiles.

Parmi les défis les plus notables, on peut citer :

  • Les données « fantômes » qui existent à l’insu des responsables, sans autorisation et sans contrôle de sécurité.
  • Des formats incohérents entre les données structurées et non structurées.
  • Une croissance rapide des données due à l’adoption de l’IA, qui dépasse les efforts de classification manuelle.

Pour y remédier, les organisations ont besoin de capacités de découverte évolutives et de cadres de classification. Une classification adéquate permet de donner un sens aux vastes quantités de données existantes. Cela inclut généralement des catégories telles que les informations personnelles identifiables (PII), les informations de santé protégées (PHI), les données PCI, la propriété intellectuelle, ainsi que les clés et les secrets.

La valeur de la classification réside dans son utilisation. Une fois les données classifiées, les entreprises peuvent appliquer efficacement des politiques de conservation et de suppression, restreindre ou surveiller les accès, et mettre en place le masquage ou l’expurgation des champs sensibles.

À grande échelle, une approche aboutie de découverte et de classification ne se contente pas d’assurer une couverture complète, mais contribue également à produire des résultats significatifs. Cela peut se traduire par une exposition réduite, une meilleure application des politiques et une réduction mesurable des risques.


Quels sont les principaux risques liés à des droits d’accès trop larges ?

Selon une étude de ReliaQuest, 99 % des identités dans le cloud disposent de privilèges excessifs. Dans le même ordre d’idées, une étude réalisée en 2025 par le Ponemon Institute souligne que 61 % des entreprises américaines ont été victimes de fuites de données commises par des initiés au cours des deux dernières années, le coût moyen de ces incidents s’élevant à la somme astronomique de 2,7 millions de dollars.

Cela prouve que même lorsque les organisations maîtrisent leurs données, l’accès reste l’un des maillons faibles de la sécurité.

On parle d’accès trop permissif lorsque des utilisateurs, des applications ou des comptes de service disposent d’un accès aux données plus étendu que nécessaire. Ce problème est très répandu, car les contrôles d’accès sont souvent accordés de manière trop large pour des raisons de commodité et rarement réexaminés.

Les conséquences sont importantes. Des accès excessifs augmentent le risque de divulgation accidentelle, de menaces internes et d’exploitation en cas de violation.

Pour y remédier, les organisations doivent tout d’abord examiner minutieusement les schémas d’accès. Cela implique notamment de déterminer qui accède aux données sensibles, quels systèmes ou identités sont concernés, et si cet accès correspond aux besoins de l’entreprise.

Une attention particulière doit être accordée aux comptes privilégiés et aux identités de service. Ceux-ci disposent souvent d’autorisations étendues et peuvent accéder à de grands volumes de données sensibles sur l’ensemble des systèmes.

Dans ce contexte, une gouvernance efficace des accès est essentielle. Cela nécessite :

  • d’aligner les politiques d’accès sur la classification des données ;
  • De surveiller en permanence les habitudes d’utilisation.
  • D’identifier et de corriger les dérives d’accès au fil du temps.

En réduisant les accès inutiles, les organisations contribuent à limiter leur surface d’attaque et à améliorer la protection globale des données.


Comment les organisations doivent-elles gérer les données utilisées par les systèmes d’IA ?

L’adoption de l’IA se généralise rapidement dans tous les domaines de l’entreprise moderne. Cela ajoute un nouveau niveau de complexité à la manière dont les données sont consultées, traitées et divulguées.

Les ensembles de données d’apprentissage comprennent souvent de grands volumes de données provenant de l’ensemble de l’organisation. Sans classification ni gouvernance adéquates, ces ensembles de données peuvent contenir des informations sensibles ou soumises à une réglementation.

Cela engendre des risques à plusieurs étapes :

  • lors de la préparation des données et de l’entraînement ;
  • Lorsque les modèles interagissent avec des données en temps réel.
  • Au travers de résultats susceptibles de divulguer involontairement des informations sensibles.

La classification doit donc précéder l’entraînement des modèles. Cela implique de valider et de classer toutes les données utilisées dans les ensembles de données, et de supprimer les informations sensibles lorsque cela est nécessaire.

De même, après le déploiement des outils d’IA, les équipes chargées des données doivent évaluer en permanence la manière dont les modèles utilisent et exposent les données. Elles doivent également mettre en œuvre des mécanismes de contrôle appropriés, tels que le masquage ou la caviardage, lorsque cela s’avère nécessaire.

Les systèmes d’IA ne doivent pas être considérés comme distincts de la sécurité des données. Ils constituent une extension de la manière dont les données sont utilisées et doivent être gérés en conséquence. En intégrant ces capacités de sécurité des données et de l’IA dans le cycle de vie plus large du développement de l’IA, les organisations peuvent contribuer à réduire les risques tout en favorisant l’innovation.


En quoi la classification des données favorise-t-elle la conformité réglementaire ?

La conformité réglementaire repose sur la capacité à identifier et à contrôler les données sensibles. Des cadres réglementaires tels que le RGPD, la loi HIPAA et la norme PCI DSS définissent des exigences spécifiques concernant le traitement des données. Cependant, ces exigences ne peuvent être respectées sans avoir préalablement identifié où se trouvent les données soumises à réglementation.

C’est pourquoi les programmes de conformité échouent en l’absence d’une base de données adéquate.

Dans ce cas, la classification des données sert de pilier à la conformité, en associant les données à des catégories réglementaires. Elle permet aux organisations d’appliquer des contrôles ciblés en fonction de la sensibilité des données et de faire respecter les politiques essentielles relatives au cycle de vie des données.

Cela ouvre la voie à une multitude de fonctionnalités essentielles :

  • Application des politiques de conservation et de suppression
  • Restriction de l’accès aux données réglementées
  • Mise en œuvre de contrôles essentiels en matière de confidentialité

Cela simplifie également les processus d’audit. Les organisations peuvent démontrer où se trouvent les données sensibles, comment elles sont protégées et qui y a accès. La gouvernance des accès renforce encore davantage la conformité en garantissant que seules les identités autorisées puissent interagir avec les données réglementées.

Ensemble, la classification des données et les contrôles d’accès redéfinissent la conformité à l’ère moderne, marquée par l’intelligence artificielle.


Conclusion : Quelles sont aujourd’hui les conditions indispensables à une sécurité efficace des données et de l’IA ?

La sécurité moderne des données et de l’IA ne se limite plus à des défenses périmétriques ou à des contrôles isolés. Elle nécessite une approche continue et unifiée qui associe visibilité, classification et gouvernance des accès tout au long du cycle de vie des données.

Pour mettre en œuvre une telle approche, les entreprises doivent d’abord comprendre leurs données et identifier précisément où elles se trouvent. Elles doivent ensuite contrôler les modes d’accès à ces données. Enfin, elles doivent s’assurer que les systèmes d’IA les utilisent de manière responsable. Ces capacités doivent fonctionner de concert, et non de manière indépendante, afin de réduire les risques d’exposition et de préserver la confiance.

À mesure que les volumes de données augmentent et que l’adoption de l’IA s’accélère, le défi ne consistera pas seulement à sécuriser les données, mais à démontrer où se trouvent les données sensibles, qui peut y accéder et comment elles sont protégées sur l’ensemble des systèmes. Les entreprises qui mettront en place une approche structurée et fondée sur des politiques seront mieux à même de réduire les risques, de répondre aux exigences réglementaires et de favoriser l’innovation en toute confiance.

Questions fréquemment posées

Qu’est-ce que la sécurité des données et de l’IA ?

La sécurité des données et de l’IA consiste à identifier, classer et contrôler l’accès aux données sensibles à travers les systèmes, les utilisateurs et les modèles d’IA. La solution Commvault Data and AI Security offre ces fonctionnalités dans les environnements hybrides, permettant ainsi aux entreprises de s’assurer que les données restent visibles, contrôlées et protégées tout au long de leur cycle de vie, y compris lors de leur utilisation dans l’entraînement des modèles d’IA et dans les résultats générés.

Pourquoi l’exposition des données sensibles constitue-t-elle un risque majeur ?

L’exposition des données sensibles constitue un risque majeur car les entreprises manquent souvent de visibilité sur l’emplacement des données et les personnes qui y ont accès, ce qui augmente le risque de fuites, d’utilisation abusive et de non-respect des réglementations. Commvault contribue à atténuer ce risque grâce à une approche unifiée combinant la découverte des données, leur classification et la gouvernance des accès dans les environnements hybrides.

Quels sont les piliers fondamentaux de la sécurité des données ?

Les trois piliers fondamentaux de la sécurité des données sont la découverte, la classification et la gouvernance des accès. Commvault répond à chacun d’entre eux : la découverte des données identifie où se trouvent les données sensibles dans tous les environnements, la classification des données définit leur sensibilité et leur type, et la gouvernance des accès aux données et à l’IA applique un contrôle d’accès conforme aux politiques métier et réglementaires.

Pourquoi un accès trop permissif est-il dangereux ?

Un accès trop permissif permet aux utilisateurs, aux applications et aux comptes de service d’accéder à plus de données que nécessaire, ce qui augmente le risque d’exposition accidentelle, de menaces internes et d’exploitation. La gouvernance des accès aux données et à l’IA de Commvault résout ce problème en surveillant en permanence les modèles d’accès, en alignant les autorisations sur la classification des données, ainsi qu’en identifiant et en corrigeant les dérives d’accès dans les environnements hybrides.

Comment les organisations doivent-elles contribuer à la protection des données utilisées par l’IA ?

Les entreprises peuvent protéger les données d’IA en classifiant les ensembles de données avant l’entraînement et en surveillant en permanence la manière dont les modèles accèdent aux données et les exposent. Commvault Data and AI Security soutient cette démarche grâce à des contrôles de découverte, de classification et de gouvernance, notamment le masquage, la caviardage et les restrictions d’accès, contribuant ainsi à garantir que les données sensibles ne soient pas exposées lors de l’entraînement de l’IA, du comportement des modèles ou de leurs résultats.

Comment la classification des données contribue-t-elle à la conformité ?

La classification des données favorise la conformité en identifiant les données réglementées, telles que les informations personnelles identifiables (PII), et en les associant aux contrôles appropriés. Commvault Data Classification aide les organisations à appliquer des politiques de conservation et de suppression conformes au RGPD, à la loi HIPAA et à la norme PCI DSS, et fournit les preuves prêtes pour un audit nécessaires pour démontrer comment les données sensibles sont identifiées, protégées et gérées.

Découvrez les ressources associées

Explorer

Quels sont les principaux risques liés à la sécurité des données et de l’IA ?

Découvrez comment l’IA introduit de nouvelles vulnérabilités liées aux données – de l’entraînement des modèles à l’exposition aux risques d’exécution – ainsi que les pratiques à plusieurs niveaux mises en œuvre par les entreprises pour gérer leurs charges de travail de manière responsable.
Lire l’article sur « Quels sont les principaux risques liés à la sécurité des données et de l’IA ? »
Livre blanc

Risk Analysis for IA Security Risks

Un rapport de Readiness destiné à votre RSSI et à votre DSI pour comprendre ce qui a changé avec MCP 2.0 et ce qu’il faut faire pour que votre organisation soit prête.
Lire le livre blanc sur l’analyse des risques liés à la sécurité de l’IA


Points clés à retenir

  • Remplacer les affirmations subjectives concernant la « facilité d’utilisation » par un ratio de protection des données mesurable : la capacité protégée divisée par le nombre d’administrateurs à temps plein.
  • La mesure de la capacité protégée par ETP offre une vision plus pertinente de l’efficacité opérationnelle que les indicateurs traditionnels, tels que le nombre de tâches de sauvegarde par administrateur.
  • Le ratio de protection des données doit servir de référence avant la migration vers une nouvelle plateforme, puis être mesuré à nouveau après celle-ci afin de valider les améliorations opérationnelles.
  • Des facteurs tels que les environnements multicloud, les exigences en matière de reprise après sinistre informatique et les obligations de conformité peuvent influencer ce ratio ; il convient donc de l’évaluer dans le contexte propre à chaque environnement.
  • Les entreprises devraient demander aux fournisseurs de s’engager à atteindre des résultats opérationnels mesurables plutôt que de se fier à des affirmations qualitatives concernant la simplicité.

Toutes les évaluations de fournisseurs auxquelles j’ai participé finissent par aboutir au même impasse. D’un côté, on affirme que la plateforme est simple à utiliser. De l’autre, on prétend que c’est la sienne qui est la plus simple.

Personne ne peut prouver l’une ou l’autre de ces affirmations ; la conversation dérive alors vers la démonstration, l’entretien de référence ou l’intuition générale qui règne dans la salle. Ce n’est pas ainsi que vous devriez prendre une décision qui déterminera la manière dont votre équipe passera les cinq prochaines années.

J’ai géré des environnements de protection des données en production. J’ai vu des équipes crouler sous le poids d’outils fragmentés qui promettaient l’automatisation et ne faisaient que générer des tickets d’incident.

La « complexité réduite » n’est pas une impression que vous devriez accepter sur la foi de paroles. C’est quelque chose que vous devriez pouvoir calculer.

L’indicateur qui manquait au secteur

Nous avons commencé à utiliser un ratio simple en interne et auprès de nos clients : la capacité totale protégée divisée par le nombre d’employés à temps plein nécessaires à son fonctionnement. Nous l’appelons le « ratio de rentabilité de la protection des données ».

Capacité protégée (PB) / ETP = Ratio de rentabilité de la protection des données

C’est tout. Pas de questions d’enquête sur la satisfaction. Pas d’adjectifs. Un chiffre, calculé à partir des données dont vous disposez déjà.

Voici pourquoi cet indicateur est plus pertinent que ceux qu’il remplace. Calculer le nombre de tâches de sauvegarde par personne avait du sens il y a dix ans, lorsqu’une tâche représentait une unité distincte d’effort manuel. Cela ne reflète pas le fonctionnement des plateformes modernes d’aujourd’hui, où l’automatisation prend en charge le travail routinier et où un seul administrateur peut être responsable de pétaoctets, et non plus d’un nombre de tâches.

Mesurer le nombre de tâches par personne dans un environnement automatisé ne vous indique en rien si l’automatisation fonctionne réellement.

Concrètement

Une précision avant de passer aux chiffres, car cela prête souvent à confusion. La « capacité protégée » désigne la taille totale, non compressée et non dédupliquée, des applications protégées, et non celle du disque physique qui les héberge.

Cette distinction est importante, car c’est là tout l’intérêt. L’environnement de production de Commvault protège 42,39 PB de données d’applications sur 9,26 PB de disques physiques, soit un gain d’espace de 81,91 % grâce à la déduplication et à la compression.

Ce ratio ne se limite pas à mesurer le nombre de pétaoctets qu’une personne peut superviser. Il mesure la part du travail effectuée par l’architecture avant même que les effectifs n’entrent en ligne de compte.

Dans cette optique : Commvault exploite son propre environnement de sauvegarde en production sur une capacité protégée de 42,39 PB avec deux ETP. Cela correspond à un ratio de 21,20 PB par ETP. Les références du secteur pour les plateformes modernes se situent généralement entre 5 et 25 PB par ETP, en fonction de la complexité de l’environnement ; ce chiffre se situe donc dans le haut de la fourchette de ce qui est réalisable aujourd’hui.

Indicateur  Valeur  Définition 
Capacité protégée (front-end)  42,39 PB  Taille totale, non compressée et non dédupliquée, de l’application protégée dans notre environnement 
Capacité totale des disques  9,26 PB  Stockage physique cible 
Espace total utilisé  7,89 PB  Utilisation actuelle 
Volume total de données écrites  7,67 PB  Données logiques écrites sur le disque 
Économies d’espace  81,91 %  Efficacité de la déduplication et de la compression 
Effectifs équivalents temps plein (ETP) dédiés à la protection des données  2  Nombre d’administrateurs à temps plein gérant le parc de sauvegarde de production de Commvault 

Ratio de protection des données = 42,39 PB / 2 ETP = 21,20 PB par ETP

Je tiens à préciser clairement ce que ce chiffre ne reflète pas. Il ne tient pas compte d’une infrastructure multicloud, des exigences en matière de Recovery après cyberattaque, ni d’un ensemble d’applications soumises à de strictes contraintes de conformité, autant de facteurs qui feront baisser ce ratio pour des raisons n’ayant rien à voir avec la qualité de la plateforme.

Un ratio pris isolément ne constitue pas un verdict. En revanche, un ratio mesuré avant et après une migration en est un.

C’est là le véritable cas d’utilisation. Établissez une base de référence de votre environnement actuel à l’aide de vos outils actuels. Fixez un ratio cible en fonction de vos prévisions de croissance et de la capacité de votre équipe. Puis veillez à ce que votre fournisseur s’y conforme une fois la mise en œuvre terminée, et pas seulement pendant le cycle de vente.

Les implications au niveau du conseil d’administration

Si vous êtes chargé de valider la migration vers une nouvelle plateforme, on ne vous demande pas simplement de croire que cette nouvelle plateforme est plus facile à gérer. On vous demande de financer un résultat opérationnel spécifique. Un objectif de ratio de protection des données vous permet d’intégrer ce résultat dans l’analyse de rentabilité et de le vérifier 12 mois plus tard.

C’est la même rigueur que nous appliquons au temps moyen de récupération après nettoyage (MTCR). La capacité de récupération ne se revendique pas, elle se mesure et se remet à l’épreuve jusqu’à ce que les chiffres reflètent la réalité. L’efficacité opérationnelle mérite d’être évaluée selon les mêmes critères.

Le défi

Demandez à votre fournisseur actuel quel est le ratio de rentabilité de votre propre environnement aujourd’hui. S’il ne peut pas vous le fournir, cela en dit long sur sa compréhension de ce que signifie « simple à gérer » pour votre équipe.

Et si vous évaluez une nouvelle plateforme, ne vous contentez pas d’une réponse du type « plus facile à utiliser ». Demandez quel ratio le fournisseur s’engage à atteindre, et posez à nouveau la question au bout d’un an.

FAQ

Q : Qu’est-ce que le ratio de protection des données ?

R : Le ratio de protection des données mesure la quantité de capacité de données protégées gérée par chaque administrateur à temps plein. Il offre un moyen objectif d’évaluer l’efficacité opérationnelle plutôt que de se fier à des impressions subjectives sur la facilité d’utilisation de la plateforme.

Q : Pourquoi cet indicateur est-il plus utile que le nombre de tâches de sauvegarde par administrateur ?

R : Les plateformes modernes de protection des données automatisent une grande partie du travail de routine qui nécessitait auparavant une intervention manuelle. Par conséquent, le décompte des tâches de sauvegarde ne reflète plus la charge de travail réelle ni l’efficacité d’une équipe opérationnelle.

Q : Que signifie « capacité protégée » dans ce calcul ?

R : La capacité protégée désigne la taille totale, non compressée et non dédupliquée, des données d’application protégées. Cette mesure reflète la charge de travail réelle gérée par la plateforme plutôt que l’espace de stockage physique consommé après optimisation.

Q : Un ratio de démultiplication plus élevé est-il toujours le signe d’une meilleure plateforme ?

R : Pas nécessairement. La complexité de l’environnement, notamment les déploiements multicloud, les exigences en matière de cyber-résilience et les obligations réglementaires, peut réduire ce ratio même lorsque la plateforme fonctionne bien. Cet indicateur est particulièrement utile pour comparer un même environnement avant et après une migration.

Q : Comment les entreprises doivent-elles utiliser le ratio de protection des données lors de l’évaluation des fournisseurs ?

R : Les entreprises doivent établir une base de référence à partir de leur environnement actuel, définir un ratio cible en adéquation avec leur croissance future et demander aux fournisseurs de s’engager à réaliser des améliorations mesurables après la mise en œuvre. Cette approche permet de déplacer le débat des arguments marketing vers des résultats commerciaux vérifiables.

Q : Quelle est la valeur métier globale de cet indicateur ?

R : Le ratio de protection des données permet aux dirigeants de quantifier les gains d’efficacité opérationnelle attendus et de les intégrer dans l’analyse de rentabilité d’un investissement dans une plateforme. Il fournit également un point de référence pouvant être examiné après le déploiement afin de confirmer que les résultats promis ont bien été atteints.

Rajiv Kottomtharayil est directeur des produits chez Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.