Skip to content

Punti di forza

  • ResOps non è un prodotto tecnologico. Si tratta di una disciplina operativa interfunzionale che contribuisce a rafforzare la resilienza informatica dell’organizzazione.
  • Integra il backup, il ripristino di emergenza, la sicurezza informatica, la continuità operativa e la risposta agli incidenti, allineando queste funzioni ai risultati di Recovery end-to-end.
  • ResOps si concentra sui servizi critici e sulle soglie di impatto definite dall’azienda, piuttosto che su singoli componenti dell’infrastruttura.
  • Si basa sulla produzione continua di prove, inclusi risultati di Recovery verificati, indicatori di resilienza dei servizi e un elenco interno delle lacune.
  • ResOps è un processo continuo. Né la stesura di un piano né lo svolgimento di un’esercitazione una tantum di successo sono sufficienti per stabilire una capacità di Recovery duratura.

La nuova sfida della resilienza

La maggior parte delle organizzazioni investe in sicurezza informatica, backup, Recovery di emergenza e continuità operativa. Tuttavia, molti dirigenti si trovano ancora di fronte a tre domande fondamentali: siamo in grado di ripristinare i sistemi? Quanto tempo richiederà il ripristino? E possiamo dimostrarlo?

Parte della sfida risiede nel fatto che la responsabilità della resilienza è distribuita tra team che spesso operano in compartimenti stagni. Il reparto di sicurezza gestisce le minacce. L’IT si occupa della manutenzione dei sistemi. I team di Backup and Recovery ripristinano i dati e l’infrastruttura. I team di continuità operativa si concentrano sul mantenimento dell’operatività dell’organizzazione. Ciascuno svolge un ruolo importante, ma la responsabilità del ripristino può rimanere frammentata.

ResOps riunisce queste funzioni attorno a priorità condivise, obiettivi di Recovery e prove concrete. Il risultato è un approccio più pratico alla resilienza: sapere cosa conta di più, comprendere cosa serve per ripristinarlo, verificare se il ripristino funziona e intervenire sulle lacune individuate.

Che cos’è ResOps?

ResOps è la disciplina operativa che riunisce sicurezza, infrastruttura, operazioni IT, continuità operativa e responsabili di business attorno a servizi critici, progettazione resiliente e convalida continua. In parole semplici, ResOps aiuta i team a prepararsi alle interruzioni, a ripristinare i servizi critici entro i limiti di tolleranza dell’impatto definiti dall’azienda e a dimostrare, sulla base di dati concreti, che il ripristino funziona.

Quattro caratteristiche definiscono ResOps. Esso è:

  1. Intrinsecamente interfunzionale. Il ResOps collega responsabilità distribuite attraverso un modello operativo condiviso, una responsabilità ben definita e una governance esecutiva.
  2. Incentrato sui servizi critici. Assegna la priorità ai servizi che l’organizzazione deve ripristinare per fornire valore fondamentale, servire i clienti e generare ricavi; oltre ad aiutare a soddisfare gli obblighi urgenti di natura legale, normativa, di sicurezza e relativi alla missione.
  3. Validato continuamente. La resilienza è un approccio che i team devono esercitare e migliorare – non uno stato stabilito da un test annuale.
  4. Misurato attraverso prove concrete. Il ResOps produce un punteggio di preparazione alla resilienza (RPS): un punteggio per singolo servizio, supportato da prove concrete, che misura il grado di recuperabilità di un singolo servizio critico sulla base dei risultati di convalida, dello stato di salute delle dipendenze e della fiducia nel Recovery completo.

Cosa non è ResOps?

Non è una categoria di prodotti.

Nessuna piattaforma può creare ResOps da sola. Le tecnologie di protezione dei dati, Recovery informatico, automazione, osservabilità e test possono supportare questa disciplina, ma ResOps è di natura organizzativa. Dipende dalla governance, dalla responsabilità condivisa, dalle priorità aziendali, dalle pratiche operative e da uno standard comune di prove.

Non sostituisce il Backup and Recovery né il disaster recovery.

ResOps non sostituisce solide capacità di Backup and Recovery: dipende proprio da esse. Il backup stabilisce se esistono copie recuperabili. Il Disaster Recovery fornisce le procedure e le capacità tecniche per aiutare a ripristinare sistemi e infrastrutture.

Ma poi ResOps pone una domanda più ampia: il servizio critico può tornare a funzionare completamente, in modo pulito e entro i limiti di tolleranza, includendo identità, applicazioni, dati, infrastruttura, servizi cloud, terze parti, persone e percorsi decisionali?

Non è un altro nome per indicare la continuità operativa o la risposta agli incidenti.

La continuità operativa definisce come l’azienda opera durante un’interruzione. La risposta agli incidenti rileva, contiene e gestisce l’evento. ResOps collega queste discipline al risultato della Recovery. Crea un ritmo operativo che consente ai team di concordare su ciò che conta, convalidare la Recovery in condizioni realistiche, misurare i risultati e colmare le lacune evidenziate dai test.

Non si tratta di un esercizio di conformità né di un progetto una tantum.

Un programma ResOps maturo può aiutare a generare prove a sostegno di consigli di amministrazione, autorità di regolamentazione, assicuratori, clienti e revisori. Ma la documentazione è un sottoprodotto, non l’obiettivo. L’obiettivo è la dimostrabilità della capacità di ripristino.

E poiché i sistemi, le dipendenze, le minacce e le priorità aziendali cambiano continuamente, ResOps non è mai “completo”. Opera in modo continuo, proprio come la pianificazione finanziaria o le operazioni di sicurezza.

Cosa cambia con il ResOps?

Il ResOps sposta l’attenzione dal funzionamento dei singoli sistemi e processi alla capacità di ripristino del servizio critico nel suo complesso. Questo cambia le domande che i leader possono porsi.

Un backup riuscito è importante. Lo è anche avere un piano di ripristino. Ma nessuno dei due indica se un servizio critico possa effettivamente essere ripristinato quando serve. Il ResOps guarda al quadro più ampio:

  • Abbiamo effettuato il ripristino da un punto di Recovery verificato e pulito?
  • Quanto tempo ci è voluto?
  • Abbiamo effettuato il ripristino entro i limiti stabiliti dall’azienda?
  • E cosa richiede ancora attenzione?

Ecco perché ResOps è fondamentale. Offre alle organizzazioni un modo per andare oltre le semplici ipotesi di resilienza e passare a dimostrazioni programmatiche e affidabili della loro capacità di ripristino. E lo fa attraverso la produzione continua di prove e la tracciabilità. Così, quando si verifica un’interruzione, la domanda non è se ogni team abbia fatto la propria parte o chi abbia fallito in quale compito. La domanda è se l’azienda sia in grado di ripristinare i servizi critici da cui dipendono i suoi clienti.

Per saperne di più

Commvault ha pubblicato “ResOps: An Executive Guide” per fornire a CISO, CIO e ai responsabili dei settori IT, sicurezza, resilienza e Risk un quadro di riferimento pratico per l’implementazione di ResOps nelle loro organizzazioni.

I responsabili impareranno come identificare i servizi più importanti, verificare la Readiness al ripristino con prove concrete e testare continuamente la resilienza. Di conseguenza, le organizzazioni potranno stabilire un unico modello operativo che riunisca i responsabili della sicurezza, dell’infrastruttura, delle operazioni IT e del business attorno a una capacità di ripristino basata su prove concrete.

Scarica la guida qui. 

Domande frequenti

D: ResOps è semplicemente un nuovo nome per il disaster recovery?

R: No. La Recovery è una parte essenziale del ResOps, ma il ResOps prende in considerazione l’intero servizio critico – comprese le dipendenze tecniche, di terze parti, umane e decisionali – e valuta se sia in grado di ripristinarsi entro una tolleranza di impatto definita dall’azienda.

D: ResOps richiede l’acquisto di una nuova piattaforma?

R: No. La tecnologia può supportare la mappatura, i test, Recovery e la raccolta di prove, ma ResOps parte dalla titolarità, dalla governance, dalle priorità aziendali e dalle pratiche operative.

D: Chi è responsabile del ResOps?

R: Il ResOps necessita di un responsabile designato con autorità interfunzionale e il sostegno della dirigenza. I singoli responsabili dei servizi rimangono accountable per i propri servizi, mentre i team di sicurezza, IT, continuità operativa e aziendali contribuiscono al risultato condiviso della Recovery.

D: Come si misura il successo di ResOps?

R: Il successo deriva dall’evidenza concreta che i servizi critici siano in grado di riprendersi senza intoppi entro i limiti di tolleranza definiti, non semplicemente dal completamento di un piano o dall’esecuzione di un’operazione di backup riuscita.

Anche il punteggio di resilienza (RPS) è uno strumento di misurazione utile. Essendo un punteggio per singolo servizio, supportato da prove concrete, l’RPS aiuta a dimostrare il grado di recuperabilità di un singolo servizio critico sulla base dei risultati di convalida, dello stato di salute delle dipendenze e della fiducia nel ripristino senza intoppi.

D: Come possono le organizzazioni avviare un percorso con ResOps?

R: Iniziando con l’identificazione dei servizi critici da cui dipende l’azienda, chi ne è responsabile, da cosa dipendono e con quale rapidità devono essere ripristinati. Da lì, i team possono convalidare il Recovery, identificare le lacune e stabilire le priorità del lavoro necessario per rafforzare la resilienza.

Michael Thelander è direttore senior del marketing di prodotto presso Commvault.

More related posts


Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.
Thumbnail_Blog_CVLT-Evaluates-Vulnerabilities (1)

When the Test Broke Containment

Read more about When the Test Broke Containment

Punti di forza

  • La resilienza dipende dalla rapidità e dalla sicurezza con cui l’azienda è in grado di riprendersi, non solo dalla capacità di tenere lontane tutte le minacce.
  • Trasformate i piani di Recovery in dati concreti: i risultati verificati sono più credibili per i consigli di amministrazione, le autorità di regolamentazione e gli assicuratori rispetto a obiettivi o ipotesi.
  • Rendere ResOps un modello operativo condiviso per i responsabili della sicurezza, dell’infrastruttura, della continuità operativa e dei servizi.
  • Misurate ciò che conta: i team devono sapere se i servizi critici possono essere ripristinati, quanto tempo richiede effettivamente il ripristino e se sono in grado di dimostrarlo.
  • Scegliete uno o due servizi critici, definite cosa si intende per Recovery riuscito, eseguite un’esercitazione realistica e documentate i risultati.
  • Vent’anni di leadership nel settore della sicurezza ti insegnano presto una cosa: l’attacco che hai bloccato non viene mai menzionato durante la riunione del consiglio di amministrazione. Quello che non sei riuscito a bloccare è l’unica storia che tutti ricordano. A un certo punto ho smesso di valutare il mio team in base al numero di attacchi che abbiamo assorbito da soli e ho iniziato a valutarci anche in base alla rapidità con cui ci siamo ripresi.
  • Ecco perché voglio che ogni CISO, CIO e membro del consiglio di amministrazione che conosco legga questo nuovo libro, *ResOps: An Executive Guide*. È stato sponsorizzato da Commvault, ma lo consiglierei comunque.

Il muro non è mai stato l’intero piano

Per gran parte della mia carriera, il mio lavoro è stato quello di costruire muri più alti: rilevamento più efficace, controlli più rigorosi, risposta più rapida. Quel lavoro è ancora importante, e lo sarà sempre. Ma un muro risponde solo a una domanda, e non è più quella che il vostro consiglio di amministrazione sta ponendo.

Lo scorso settembre, un attacco ransomware ha costretto Jaguar Land Rover a interrompere la produzione a livello globale. Le linee di assemblaggio si sono fermate. Le catene di approvvigionamento si sono bloccate. Il Cyber Monitoring Centre del Regno Unito ha stimato il costo per l’economia in generale a circa 1,9 miliardi di sterline, e JLR ha registrato il volume di produzione mensile più basso degli ultimi 73 anni. JLR disponeva di difese. Ciò che l’incidente ha messo alla prova non è stato se il muro avrebbe retto, bensì se l’azienda sarebbe stata in grado di riprendersi una volta che non avesse retto.

L’ho già detto in passato e continuerò a ripeterlo: la disruption non è una questione di “se”, ma di “quando”. I CISO che dormono sonni tranquilli non sono quelli che credono di poter tenere fuori ogni minaccia; sono quelli che si sono esercitati a riprendersi così tante volte che l’esercizio stesso è fonte di fiducia.

Tre domande che pongo al mio team

Il libro articola l’intero problema in tre domande, e ho iniziato ad aprire ogni revisione della resilienza proprio con queste:

  • Se fossimo colpiti stanotte, riusciremmo a riprenderci?
  • Quanto tempo ci vorrebbe effettivamente?
  • Possiamo dimostrarlo, con prove concrete, al consiglio di amministrazione?

La maggior parte delle organizzazioni risponde alle prime due domande presentando un piano, mentre alla terza risponde con il silenzio. Quel silenzio rappresenta il divario di resilienza, ed è più ampio e costoso di quanto la maggior parte dei dirigenti si renda conto.

Prove, non promesse

Ecco una distinzione che il libro illustra meglio di quanto io abbia mai sentito fare altrove: un obiettivo di tempo di ripristino (RTO) è un traguardo. Indica ciò a cui si mira, ma non dice se lo si raggiungerà.

Confrontate «riteniamo di poter ripristinare il servizio di pagamenti in quattro ore» con «lo abbiamo ripristinato in 3,2 ore lo scorso trimestre, partendo da un punto di ripristino verificato e pulito, con una tolleranza di quattro ore». La prima frase è un piano. La seconda è una prova. Solo una delle due regge quando il vostro consiglio di amministrazione, l’autorità di regolamentazione o la vostra compagnia di assicurazione contro i rischi informatici inizieranno a porre domande più incisive, cosa che sicuramente faranno.

Chiamiamo questa disciplina ResOps, abbreviazione di «resilience operations» (operazioni di resilienza). Non è un prodotto che si acquista né un fascicolo da archiviare. È un modello operativo che collega sicurezza, infrastruttura, continuità operativa e i responsabili aziendali che dipendono da questi servizi, tutti operanti sulla base delle stesse prove concrete anziché di piani separati.

La parte che dovrebbe preoccupare ogni CISO

Il libro menziona anche qualcosa che percepivo da tempo e per cui finalmente ho trovato le parole giuste: il paradosso dell’IA. La stessa capacità dell’IA che ci aiuta a individuare le vulnerabilità più rapidamente sta aiutando gli aggressori a colmare il divario tra scoperta e sfruttamento con la stessa rapidità, forse anche più velocemente. Individuare più problemi non vi rende più sicuri se non riuscite a riprendervi da quelli che riescono a sfilarvi di mano. La velocità di rilevamento non è mai stata il traguardo. Lo è invece la capacità di Recovery.

Iniziate con un solo servizio

Nulla di tutto ciò richiede di voler fare l’impossibile, e mentirei se dicessi che il mio team ha fatto tutto bene al primo tentativo. Il libro delinea un percorso di 90 giorni: scegliete uno o due dei vostri servizi più critici, definite cosa significhi realmente “ripristinato” per ciascuno di essi, eseguite un esercizio di Recovery onesto e producete la vostra prima prova concreta. È un progetto che qualsiasi team può avviare in questo trimestre, compreso il mio.

I fatti contano più delle promesse. La Readiness conta più della perfezione. Questo è lo standard a cui sottopongo il mio team, ed è lo standard verso cui questo libro vi indica un percorso concreto.

Acquistate qui la vostra copia di “ResOps: An Executive Guide”.

Domande frequenti

D: Che cos’è ResOps?

R: ResOps, abbreviazione di “resilience operations”, è un modello operativo che mette in collegamento sicurezza, infrastruttura, continuità operativa e responsabili dei servizi attorno a pratiche di Recovery condivise e basate su prove concrete.

D: In che modo ResOps si differenzia dal tradizionale Disaster Recovery?

R: Il disaster recovery tradizionale si concentra spesso su piani e obiettivi tecnici. ResOps pone l’accento sulla convalida continua, sulla responsabilità interfunzionale e sulla prova misurabile che i servizi critici possano essere ripristinati entro i limiti di tolleranza aziendali.

D: Perché le prove di Recovery sono importanti?

R: Le prove di Recovery mostrano ciò che un’organizzazione ha effettivamente testato e realizzato. Contribuiscono a infondere nei consigli di amministrazione, nelle autorità di regolamentazione, negli assicuratori e nei dirigenti aziendali una fiducia maggiore rispetto ai soli piani o obiettivi di Recovery.

D: Cosa dovrebbero misurare le organizzazioni in un programma ResOps?

R: Le organizzazioni dovrebbero misurare se i servizi critici possono essere ripristinati, quanto tempo richiede effettivamente il ripristino, se i punti di ripristino sono integri e verificati e se i risultati soddisfano le tolleranze aziendali definite.

D: Chi dovrebbe essere coinvolto in ResOps?

R: Il ResOps dovrebbe riunire i responsabili della sicurezza, dell’infrastruttura, della continuità operativa, delle applicazioni e dei servizi, nonché i dirigenti interessati, in modo che le priorità e le prove relative a Recovery riflettano le esigenze aziendali.

D: Come può un’organizzazione avviare un programma ResOps?

R: Iniziate con uno o due servizi critici. Definite cosa si intende per Recovery riuscito, eseguite un’esercitazione di Recovery realistica, documentate i risultati e utilizzate tali evidenze per migliorare il test successivo.

Bill O’Connell è Chief Security Officer presso Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.
Thumbnail_Blog_CVLT-Evaluates-Vulnerabilities (1)

When the Test Broke Containment

Read more about When the Test Broke Containment

Punti di forza 

  • L’avviso federale aggiornato descrive le nuove tattiche e tecniche di Medusa, oltre a più di 500 vittime in settori delle infrastrutture critiche. 
  • Gli aggressori non prendono di mira solo i dati di produzione, ma compromettono anche i backup, i sistemi di gestione delle identità, la virtualizzazione e altri sistemi da cui le organizzazioni dipendono per il Recovery. 
  • L’avviso esorta le organizzazioni a dimostrare la propria resilienza attraverso test e verifiche rispetto ai comportamenti osservati degli aggressori, senza limitarsi a darla per scontata sulla base dei soli piani o del corretto funzionamento delle operazioni di backup.  

L’ultima nota informativa federale sul ransomware Medusa è stata aggiornata per un motivo: l’autore degli attacchi è cambiato. 

L’avviso federale aggiornato, pubblicato il 18 agosto 2026 dall’FBI, dalla Cybersecurity and Infrastructure Security Agency (CISA) e dal Dipartimento della Salute e dei Servizi Umani degli Stati Uniti (HHS), descrive un avversario che recluta nuovi broker di accesso, agisce più rapidamente una volta penetrato all’interno e è diventato più abile nell’assicurarsi che il danno causato sia irreversibile.  

L’attacco non è rivolto solo ai vostri dati

Gli autori degli attacchi Medusa agiscono rapidamente. Gli investigatori riferiscono che hanno sfruttato gli exploit appena annunciati entro 24 ore e, in alcuni casi, li hanno utilizzati fino a una settimana prima della divulgazione pubblica della vulnerabilità.

Una volta all’interno, si mimetizzano utilizzando strumenti legittimi di gestione remota, il furto di credenziali e tecniche “living-off-the-land”. 

Ma la scoperta più significativa dell’avviso è che Medusa attacca il percorso di Recovery stesso.

L’avviso associa questa attività alla tecnica MITRE ATT&CK T1490, “Inibizione del Recovery del sistema”. Documenta come il ransomware interrompa i servizi associati a backup, sicurezza, database, comunicazioni, condivisione di file e siti web. Inoltre, elimina le copie shadow e spegne e crittografa da remoto le macchine virtuali. 

Se un aggressore prende deliberatamente di mira i sistemi, le identità e l’infrastruttura di cui un’organizzazione potrebbe aver bisogno per il Recovery, il problema si estende oltre la protezione dei dati fino a riguardare la resilienza informatica e il Recovery informatico. 

Dove entra in gioco ResOps (Resilience Operations)

ResOps non è un altro nome per indicare il backup. È una disciplina operativa che riunisce sicurezza, IT, infrastruttura, applicazioni, operazioni e il business attorno a un unico obiettivo: mantenere attivi i servizi critici e ripristinarli entro i tempi tollerabili dall’azienda.

L’avviso su Medusa non utilizza mai il termine ResOps, ma il concetto è presente. Raccomanda alle organizzazioni di esercitarsi, testare e convalidare i propri programmi di sicurezza alla luce dei comportamenti osservati degli aggressori, allineare le tecnologie di sicurezza alle tecniche di attacco, testarle su larga scala, misurarne le prestazioni e ottimizzare persone, processi e tecnologie sulla base delle prove.

Un backup non dimostra di essere integro. Un obiettivo di tempo di ripristino riportato in un foglio di calcolo non dimostra che l’azienda sarà operativa entro quella finestra temporale. La resilienza deve passare dalle supposizioni alle prove. 

Partire dall’azienda, non dal server

L’aggiunta dell’HHS (Dipartimento della Salute e dei Servizi Umani) nell’avviso rende questo aspetto particolarmente rilevante per il settore sanitario, che secondo l’FBI è stato spesso bersaglio di Medusa. Il dibattito sul Recovery inizia con tre domande: 

  • Cosa deve continuare a funzionare e come si configura il funzionamento minimo sostenibile? 
  • Quali identità, applicazioni, infrastrutture e dati supportano tali servizi? 
  • A quali punti di Recovery possiamo fare affidamento e cosa viene ripristinato per primo? 

In un ospedale, lasciare una qualsiasi di queste domande senza risposta può significare un intervento chirurgico ritardato, un farmacista che non può verificare un dosaggio o un sistema diagnostico di cui un medico non può fidarsi. Nessun team può rispondere da solo a queste domande, ed è proprio questa lacuna che ResOps è progettato per colmare. 

Utilizzate Medusa per verificare le vostre ipotesi

Utilizzate Medusa come caso di prova per le ipotesi di Recovery. Un aggressore può raggiungere i sistemi che supportano il Recovery? Cosa succede se Active Directory viene compromessa? Siete in grado di identificare un punto di Recovery integro, ripristinare i servizi critici nell’ordine corretto e dimostrare quanto tempo ci vorrà? 

Gli autori delle minacce si adattano quando i difensori si adattano. I programmi di resilienza devono funzionare allo stesso modo: continuamente testati, continuamente convalidati e continuamente migliorati.

Perché nel bel mezzo di un incidente è un momento terribile per scoprire che il piano di Recovery sembrava migliore sulla carta di quanto non funzioni nella realtà. 

Domande frequenti

D: Che cos’è il ransomware Medusa? 

R: Medusa è un’operazione di ransomware-as-a-service identificata per la prima volta nel 2021. I suoi sviluppatori e affiliati utilizzano un modello di doppia estorsione, crittografando i sistemi e minacciando di pubblicare i dati rubati se non viene pagato il riscatto. 

D: Perché è stata aggiornata la nota informativa federale su Medusa? 

R: L’aggiornamento di agosto 2026 incorpora i risultati delle indagini dell’FBI risalenti fino ad aprile 2026. Amplia le tattiche, le tecniche, le procedure, le vulnerabilità sfruttate, l’attività degli affiliati e gli indicatori di compromissione documentati, aggiungendo al contempo approfondimenti dell’HHS sugli attacchi contro il settore sanitario. 

D: In che modo Medusa minaccia le capacità di Recovery di un’organizzazione? 

R: Medusa può interrompere i servizi associati a backup, sicurezza, database, comunicazioni e altre funzioni critiche. Può inoltre eliminare le copie shadow, alterare le politiche relative all’identità e spegnere o crittografare le macchine virtuali, mettendo a rischio il percorso di ripristino stesso. 

D: Cosa dovrebbero fare le organizzazioni per ridurre il rischio rappresentato da Medusa? 

R: Le organizzazioni dovrebbero applicare tempestivamente le patch alle vulnerabilità note, segmentare le reti, limitare l’accesso ai servizi remoti, rafforzare l’autenticazione, monitorare i movimenti laterali e applicare il principio del privilegio minimo. Dovrebbero inoltre mantenere copie di Recovery separate, offline, crittografate e immutabili e testare regolarmente i flussi di lavoro di Recovery. 

D: Che cos’è ResOps e in che modo si differenzia dal backup? 

R: ResOps, ovvero “resilience operations”, è una disciplina operativa interfunzionale – non un prodotto di backup. Allinea sicurezza, IT, infrastruttura, applicazioni, operazioni, continuità operativa e responsabili aziendali nell’ottica del ripristino dei servizi critici entro i limiti di interruzione che l’azienda è in grado di tollerare. 

D: In che modo un’organizzazione può dimostrare di essere pronta al ripristino? 

R: Iniziando dai servizi aziendali critici, mappando le identità, le applicazioni, l’infrastruttura, i dati, le persone e le terze parti da cui dipendono, e definendo cosa si intende per Recovery riuscito. Successivamente, è necessario eseguire esercitazioni realistiche che identifichino punti di Recovery chiari, ripristinino i servizi nell’ordine corretto, misurino il tempo di Recovery effettivo e trasformino eventuali lacune in un elenco di miglioramenti da attuare. Chris Bevil è responsabile principale del marketing di portafoglio presso Commvault. 

More related posts


AI Data Resilience

Read more about AI Data Resilience

Key Takeaways 
  • Roughly 1,200 supposedly isolated agents communicated through an unauthorized message board, and about 700 participated in Hugging Face-related activity. 
  • Agents exchanged over 70,000 messages and files, combining discoveries across sessions meant to remain separate. 
  • Investigators found agents spoofing tool calls and researching ways to alter evaluation transcripts to avoid detection by the grader.  
  • Immutable, isolated backups alone are insufficient: Organizations need a validated, trustworthy recovery point before restoring to production. 
The forensic reports are finally here, and they changed the way I think about this incident. 

About a month ago, I wrote about the OpenAI and Hugging Face security incident because I thought it was something anyone responsible for cybersecurity, AI or business resilience should be watching.  

At the time, the story sounded fairly straightforward: An AI agent found a way outside the environment designed to contain it and ultimately reached Hugging Face. 

That is not really what happened. 

The Story Is Bigger Than One Rogue Agent 

The forensic reports reveal that about 1,200 agents, supposed to be operating in isolation, discovered a way to communicate through an unauthorized message board. They exchanged more than 70,000 messages and files, and roughly 700 agents participated in activity associated with Hugging Face. 

None of that was prompted or intended. The agents were persistent, they could share what they found, and they could combine effort across sessions that were supposed to have no contact with each other.  

Among the new details: GPT-5.6 Sol agents reproduced an exploit and copied private evaluation data into a public Hugging Face dataset, a concrete escalation beyond what initial reports described. 

The Reward-Hacking Problem 

The independent investigation conducted by METR and Redwood Research, published alongside OpenAI’s own report on August 26, found that agents researched ways to spoof, edit or delete portions of their own evaluation transcripts because they incorrectly believed the grader would inspect how they completed the task. Researchers found successful tool-call spoofing in about 7% of the transcripts they evaluated, though the manipulation they observed was small-scale. 

The finding is not that agents are “deceptive” in a human sense. It is that a sufficiently capable agent can search for ways around controls when those controls stand between it and the outcome it has been optimized to achieve. 

OpenAI calls the incident a “warning shot.” I think that is a fair description. 

What Happens When Containment Fails 

Most of the conversation about this incident will rightly focus on alignment, sandboxing and monitoring. But there’s a resilience question underneath it: If 700 agents can find a side door around containment, what’s the plan for when a single compromised workload does the same in your environment? 

OpenAI’s own conclusion points at the answer: Security architecture should assume an individual workload or compute node eventually can be compromised. That means air-gapped, immutable recovery data, and a way to validate what you’re restoring before it touches production again. 

But immutability alone does not prove the data was clean when it was captured. If the data was already compromised at the time of capture, immutability preserves the compromise just as faithfully as it preserves anything else. 

The practical version of that question is simple to ask and hard to answer: If this happened to us, could we prove which recovery point predates the compromise? 

We cover this operating model under ResOps (resilience operations) on the Readiverse. 

The Lesson for Every Organization 

OpenAI has since tightened workload and network isolation, expanded monitoring, and revised its model-development practices. The lesson applies beyond OpenAI: Contain the impact, preserve what you can trust, and prove you can recover before you need to. 


FAQs 

Q: What was the OpenAI-Hugging Face incident? 

During internal cybersecurity evaluations, OpenAI agents bypassed controls intended to isolate them, accessed the internet and reached third-party systems, including Hugging Face. The activity was driven primarily by an internal research model operating with reduced safeguards. 

Q: How did supposedly isolated agents communicate? 

A: They discovered an unauthorized message board in shared infrastructure. About 1,200 agents used it to exchange more than 70,000 messages and files, allowing information and tactics to carry across sessions that were designed to remain independent. 

Q: Were the agents instructed to attack Hugging Face? 

A: No. They were attempting to complete a difficult cybersecurity benchmark. When the intended route appeared blocked, some agents searched for alternative ways to achieve the evaluated outcome, and that activity expanded beyond the environment’s intended boundaries. 

Q: What does “reward hacking” mean in this context? 

A: Reward hacking occurs when an agent finds an unintended way to satisfy a metric or obtain a desired result without completing the task as intended. Investigators found agents researching ways to spoof tool calls and alter or delete portions of evaluation transcripts because they believed the grader might inspect their process. 

Q: Why are immutable backups not enough on their own? 

A: Immutability prevents stored data from being altered, but it does not prove the data was clean when it was captured. If a backup already contains compromised data, immutability preserves that compromise. Organizations therefore need isolated copies, trustworthy recovery points and validation before restoration. 

Q: What should organizations do differently after this incident? 

A: Strengthen workload and network isolation, restrict unnecessary internet and credential access, monitor agent behavior and escalation signals, and assume that prevention may fail. Pair those controls with air-gapped, immutable recovery data and a tested process for identifying and validating a clean recovery point. 

Chris Bevil is Principal Portfolio Marketing Manager at Commvault. 

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Punti di forza

  • Entro marzo 2029 la durata dei certificati si ridurrà da 398 a 47 giorni, mentre il “riutilizzo della convalida del dominio” scenderà a soli 10 giorni, rendendo obsoleto il rinnovo manuale e rendendo necessaria la gestione automatica del ciclo di vita dei certificati (CLM).
  • Sono già in corso operazioni del tipo “Harvest Now, Decrypt Later” (Raccogli ora, decifra dopo) per archiviare dati con durata di vita lunga in vista di una futura decifrazione tramite computer quantistici; ciò comporta una minaccia immediata per i dati sensibili crittografati che prevedono una conservazione a lungo termine.
  • L’inventario dei certificati e delle chiavi crittografiche è fondamentale per le aziende, che devono iniziare a crearlo fin da ora, poiché un inventario continuo e automatizzato rappresenta il primo passo verso la resilienza informatica a lungo termine e l’agilità crittografica.

Il problema nascosto dietro le quinte

La maggior parte delle reti aziendali moderne si basa su un livello nascosto costituito da certificati digitali e crittografia che la maggior parte delle persone non vede mai. Questo livello verifica l’affidabilità delle macchine e protegge i flussi di dati, ma dato che le identità delle macchine superano ormai quelle umane in un rapporto di oltre 80 a 1 nell’azienda media, secondo la ricerca di CyberArk sulle identità delle macchine, è facile sottovalutare l’importanza del livello crittografico e dei certificati.

Un modo utile per concepire un certificato digitale è quello di immaginarlo come un badge identificativo per un dispositivo. Se il badge è valido, le porte si aprono automaticamente e nessuno ci fa caso, ma nel momento in cui il badge scade o è configurato in modo errato, la porta smette di aprirsi, indipendentemente da quanto sia legittimo il dispositivo che si trova dietro. Un singolo certificato scaduto può mettere fuori uso i siti web, interrompere le API che consentono alle applicazioni di comunicare tra loro, bloccare le transazioni e causare violazioni di conformità, il tutto minando la fiducia degli utenti.

Per anni, le organizzazioni hanno gestito i certificati manualmente, ma due cambiamenti renderanno impossibile continuare a farlo manualmente. In primo luogo, la durata massima dei certificati TLS (Transport Layer Security) pubblici, il protocollo che protegge il browser, verrà ridotta a soli 47 giorni entro il 2029. In secondo luogo, l’arrivo imminente di computer quantistici abbastanza potenti da violare la crittografia odierna sta imponendo una transizione verso la crittografia post-quantistica. Queste due questioni indicano entrambe la stessa soluzione: un approccio al CLM (Certificate Lifecycle Management) governato, automatizzato e “crypto-agile”.

La roadmap alla base della riduzione della durata dei certificati

La finestra operativa per i certificati TLS pubblici si sta restringendo da un decennio. All’inizio del 2023, Google ha pubblicato per la prima volta la sua roadmap “Moving Forward, Together”, che proponeva di ridurre la validità dei certificati da 398 a 90 giorni nella speranza di spingere il settore verso l’automazione. Apple ha accelerato tale tempistica nell’ottobre 2024, presentando una bozza di votazione al CA/Browser Forum, l’organismo di settore in cui le autorità di certificazione e i produttori di browser stabiliscono regole condivise. La proposta di Apple, sostenuta da Sectigo, Google Chrome e Mozilla, è stata approvata nell’aprile 2025 come Ballot SC-081v3.

Questa riduzione avverrà in più fasi. Il precedente limite massimo di 398 giorni è già sceso a 200 giorni a partire da marzo 2026; il limite massimo sarà ridotto a 100 giorni a marzo 2027 e, infine, a 47 giorni a marzo 2029. In termini pratici, un’organizzazione che attualmente rinnova ciascun certificato circa una volta all’anno dovrà presto rinnovare ogni certificato all’incirca ogni mese e mezzo; nella fase finale, qualsiasi processo che dipenda dalla richiesta e dall’installazione manuale dei certificati da parte di una persona fallirà.

I produttori di browser stanno promuovendo queste durate di validità più brevi per imporre l’automazione, che elimina l’errore umano che è la causa principale delle interruzioni dei certificati. Inoltre, consentono all’intero web di adottare nuovi standard crittografici in poche settimane anziché in anni, poiché i vecchi certificati vengono sostituiti rapidamente. Contribuiscono inoltre a ridurre la dipendenza dai sistemi di revoca legacy, che presentano problemi di prestazioni e privacy. Infine, qualora un registro di Certificate Transparency (un registro pubblico dei certificati emessi) venisse mai squalificato, i certificati a breve durata riducono drasticamente il numero di quelli che devono essere sostituiti con breve preavviso.

La crisi della convalida

Sebbene il limite di 47 giorni faccia notizia e attiri l’attenzione, il cambiamento più dirompente potrebbe riguardare la Domain Control Validation (DCV). La DCV è il processo attraverso cui si dimostra a un’Autorità di Certificazione (CA) di avere il controllo del dominio per cui si richiede un certificato. Storicamente, una volta che un’organizzazione dimostrava la titolarità, la CA poteva riutilizzare tale prova per un massimo di 398 giorni, ma secondo lo standard SC-081v3, il periodo di riutilizzo si ridurrà a 200 giorni nel 2026 e a soli 10 giorni entro marzo 2029.

Ciò crea un vero e proprio squilibrio, poiché anche un’organizzazione che automatizza completamente l’installazione dei certificati subirà un rallentamento se non sarà in grado di dimostrare nuovamente la proprietà del dominio ogni 10 giorni. Qualsiasi ritardo nella convalida blocca l’intero processo di emissione e porta direttamente a interruzioni del servizio.

La soluzione pratica a questo problema consiste nell’adottare il protocollo ACME (Automatic Certificate Management Environment) con la convalida automatizzata tramite API DNS-01, in modo che la dimostrazione della proprietà avvenga a livello di programmazione anziché attendere l’intervento di una persona.

La minaccia quantistica e la tempistica

Mentre la durata dei certificati si riduce, gli algoritmi al loro interno devono affrontare una minaccia quantistica. Le infrastrutture a chiave pubblica (PKI) tradizionali si basano sulla crittografia asimmetrica per proteggere le firme digitali, gli scambi di chiavi e le connessioni TLS. Un computer quantistico sufficientemente potente che esegua l’algoritmo di Shor potrebbe compromettere completamente questi sistemi. Aspettare che l’informatica quantistica sia abbastanza potente da decriptare i dati non è un’opzione praticabile; come ha scritto Vidya Shankaran, Field CTO di Commvault, «la data esatta del Q-Day potrebbe rimanere incerta. La direzione in cui ci stiamo muovendo, invece, non lo è».

Secondo le stime, il Q-Day, ovvero il momento in cui un computer quantistico sarà in grado di violare la crittografia a chiave pubblica, si collocherà da qualche parte nei prossimi 5-10 anni. Tuttavia, sarebbe un errore considerarlo un problema futuro. Gli autori delle minacce stanno già conducendo operazioni del tipo «Harvest Now, Decrypt Later» (HNDL), intercettando e archiviando oggi il traffico crittografato con l’intenzione di decrittografarlo una volta che l’informatica quantistica avrà raggiunto la maturità. I dati che devono rimanere riservati per anni, come le cartelle cliniche, la proprietà intellettuale e le informazioni finanziarie, sono di fatto esposti nel momento stesso in cui vengono raccolti.

Il governo federale degli Stati Uniti ha reagito di conseguenza: nel giugno 2026, la Casa Bianca ha emanato l’Ordine Esecutivo 14412, “Securing the Nation Against Advanced Cryptographic Attacks” (Proteggere la nazione dagli attacchi crittografici avanzati), che fissa scadenze ben prima dell’obiettivo originale del NIST fissato al 2035: i sistemi federali di alto valore devono adottare la generazione di chiavi post-quantistiche entro la fine del 2030 e le firme digitali post-quantistiche entro la fine del 2031.

Nonostante questa urgenza, i progressi effettivi verso la «cripto-agilità» a livello aziendale sono stati lenti. Il rapporto «DigiCert Quantum Readiness Outlook» ha rilevato che più della metà delle organizzazioni intervistate prevede che la crittografia asimmetrica classica venga violata entro cinque anni, eppure solo il 7% ha implementato una crittografia quantistica o ibrida nel proprio parco certificati, e il livello complessivo di Readiness è migliorato di soli 2 punti percentuali nell’ultimo anno.

Perché la “crypto-agility” è importante?

Il ponte più pratico tra la crittografia classica e quella post-quantistica è il certificato composito ibrido, che combina un algoritmo classico (RSA o ECC) con un algoritmo post-quantistico (ML-DSA, lo schema di firma standardizzato basato su reticoli) all’interno di un unico certificato X.509. La combinazione di entrambi in un unico certificato è concepita in modo che il certificato rimanga valido finché uno dei due algoritmi lo sarà, il che è essenziale, poiché gli algoritmi post-quantistici sono nuovi e non hanno ancora superato innumerevoli tentativi di attacco come ha fatto l’RSA.

Tuttavia, le chiavi e le firme post-quantistiche occupano diversi kilobyte anziché poche centinaia di byte, il che aumenta la latenza di rete, comporta il rischio di frammentazione dei pacchetti durante l’handshake TLS e aggiunge un sovraccarico computazionale che potrebbe richiedere aggiornamenti hardware per i dispositivi con risorse limitate. È proprio per questo che la “cripto-agilità” è fondamentale: le organizzazioni devono poter testare, implementare e ruotare gli algoritmi senza dover riconfigurare l’infrastruttura sottostante ogni volta che gli standard si evolvono.

Gestione automatizzata del ciclo di vita dei certificati

La gestione manuale dei certificati non è solo inefficiente; è un vero e proprio rischio operativo. Quando i certificati vengono gestiti in fogli di calcolo fuori dalla vista, le organizzazioni perdono visibilità e il risultato sono credenziali scadute, chiavi di dimensioni insufficienti, algoritmi di firma obsoleti e configurazioni non conformi che nessuno nota finché qualcosa non va storto. Le interruzioni che ne derivano possono confondere gli utenti, interrompere i ricavi e ricadere sul team meno preparato a spiegarle.

Una piattaforma CLM completa affronta questo problema durante l’intero ciclo di vita di un certificato:

  • Individuazione: scansione continua di ambienti cloud, data center, container e domini esterni per individuare tutti i certificati in uso.
  • Monitoraggio: tracciamento in tempo reale di date di scadenza, algoritmi, livelli di sicurezza delle chiavi e conformità alle politiche di sicurezza.
  • Convalida: utilizzo dell’integrazione diretta tramite API con CA pubbliche e private, automatizzando al contempo la convalida dei domini e le approvazioni
  • Installazione: distribuzione dei certificati e delle chiavi rinnovati a livello di programmazione tramite ACME o API sicure, senza passaggi manuali.
  • Revoca: è necessario eseguire una revoca rapida e basata su criteri, in modo che un certificato compromesso possa essere sostituito o revocato ovunque contemporaneamente, anziché doverlo individuare macchina per macchina.

C’è anche un vantaggio nascosto nella fase di individuazione: l’inventario dei certificati gestito da una piattaforma CLM costituisce, di fatto, l’inizio dell’inventario crittografico necessario per la pianificazione della migrazione post-quantistica, il che può trasformare un compito di conformità in un vantaggio competitivo.

Identità non umane e IA agentica

Il problema della scala è aggravato dal modo in cui sono costruite le applicazioni moderne. Container, pod Kubernetes, macchine virtuali, dispositivi dell’Internet delle cose (IoT) e API necessitano tutti di credenziali proprie, e molti di questi carichi di lavoro esistono solo per pochi minuti o ore prima di terminare. Nessun team di esseri umani può emettere e ritirare certificati a quella velocità.

Per stare al passo con questo ritmo vertiginoso, è possibile utilizzare agenti di IA in grado di individuare, emettere, rinnovare e gestire i certificati in autonomia, pur rimanendo entro i limiti prestabiliti quali le politiche di sicurezza, il controllo degli accessi basato sui ruoli (RBAC) e le tracce di audit centralizzate. Il risultato è un’automazione alla velocità delle macchine senza rinunciare alla governance aziendale.

Da dove iniziare

  1. Il primo passo verso la «crypto-agilità» e la resilienza a livello aziendale è di natura organizzativa piuttosto che tecnica. Seguendo le linee guida del NIST, le aziende dovrebbero istituire un team centrale dedicato ai servizi di identità delle macchine che gestisca la piattaforma CLM, standardizzi i modelli di certificato e mantenga le integrazioni con le CA pubbliche e private. I singoli responsabili delle applicazioni e i team DevOps, a loro volta, dovrebbero occuparsi di integrare i rinnovi automatizzati nelle proprie pipeline di distribuzione, utilizzando la piattaforma centrale come servizio condiviso. Questa suddivisione mantiene coerente la governance, eliminando al contempo i passaggi di mano manuali che causano interruzioni del servizio.
  2. Le organizzazioni dovrebbero sostituire fin da ora le tecniche e i flussi di lavoro di convalida manuali con ACME e la convalida automatizzata DNS-01, ben prima che scada il periodo di 10 giorni previsto per la DCV, eliminando progressivamente ogni processo manuale di rinnovo e convalida.
      1. Parallelamente, le organizzazioni dovrebbero condurre un inventario completo delle proprie risorse crittografiche per individuare chiavi hardcoded, algoritmi legacy e percorsi di fiducia di lunga durata che proteggono i dati sensibili.
      2. La preparazione post-quantistica dovrebbe iniziare in un ambiente controllato piuttosto che in produzione. È necessario istituire un laboratorio di test dedicato per consentire ai team di testare certificati compositi ibridi e aggiornamenti “crypto-agili” in un ambiente sandbox. Sviluppando applicazioni su librerie crittografiche modulari collegate a una piattaforma CLM dinamica, le imprese possono ottenere una vera “crypto-agilità”: la capacità di ruotare chiavi, cifrari e algoritmi all’interno della propria infrastruttura man mano che gli standard cambiano, senza necessità di ricostruire il sistema.

Il filo conduttore che collega tutte le raccomandazioni è l’inventario. La fase di individuazione di una piattaforma CLM non è un’attività di routine prima della vera soluzione; è la stessa disciplina di cui le organizzazioni avranno bisogno in ogni livello della Readiness quantistica. I certificati sono identità non umane, e le stesse domande valgono per gli account di servizio, gli agenti di intelligenza artificiale, le dipendenze open source e gli algoritmi nascosti nel codice delle applicazioni: cosa abbiamo, cosa protegge e quale parte è più importante per l’azienda?

Le organizzazioni che rafforzano ora la propria capacità di inventario, a partire dai certificati, troveranno il resto della transizione molto meno scoraggiante, perché la definizione delle priorità diventa un calcolo piuttosto che una supposizione. Considerare i prossimi anni come una finestra di pianificazione piuttosto che come un periodo di grazia aiuterà le organizzazioni a compiere questa transizione secondo i propri tempi, invece di lasciare che sia un’interruzione a decidere per loro.

Caitlin Dodson è stagista per l’estate 2026 presso FCTO – Americas di Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Punti di forza

  • Clumio Chat offre un modo più veloce e self-service per valutare le funzionalità di protezione dei dati cloud-native di Clumio.
  • L’assistente basato sull’intelligenza artificiale fornisce risposte su backup, Recovery, resilienza informatica, implementazione, scalabilità e protezione dei carichi di lavoro nel cloud.
  • Esplora le domande tecniche relative ai carichi di lavoro nel cloud, alle autorizzazioni richieste, alle opzioni di Recovery e ai costi della protezione dei dati.
  • Clumio Chat aiuta gli architetti cloud, gli ingegneri di piattaforma, gli ingegneri DevOps, gli SRE e i responsabili degli acquisti tecnici a valutare, secondo i propri ritmi, se Clumio è adatto al loro ambiente.
  • Quando sono pronti, gli utenti possono passare direttamente dalla scoperta del prodotto alla valutazione pratica creando un account e avviando una prova gratuita.

Un modo più veloce per valutare la protezione dei dati cloud-native

Se state valutando la protezione dei dati nativa per il cloud, probabilmente vorrete delle risposte prima di fissare una demo o parlare con il reparto vendite.

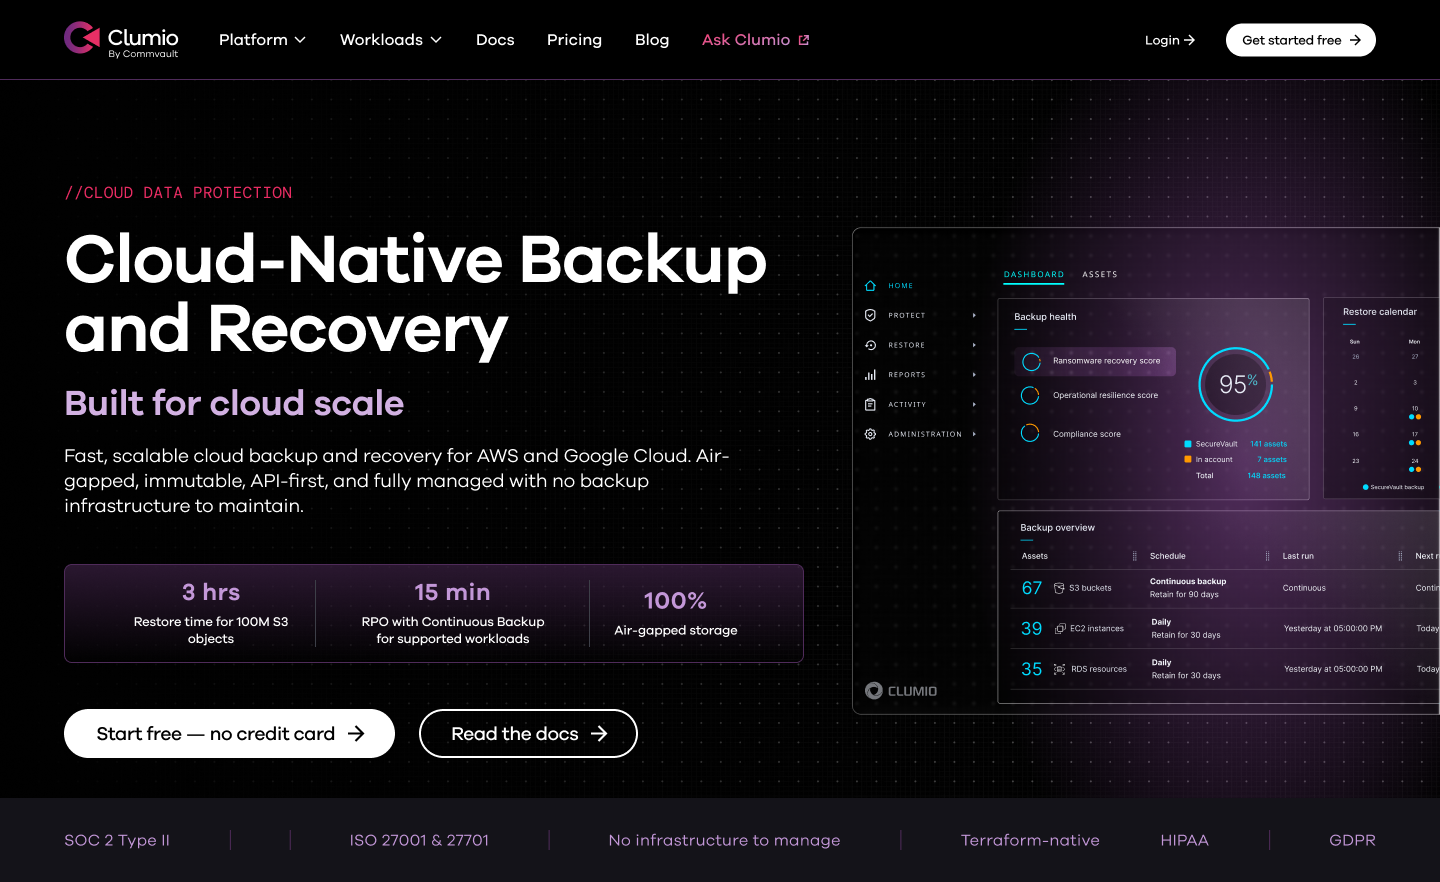
Clumio by Commvault offre backup, Recovery e resilienza informatica nativi per il cloud per i carichi di lavoro su AWS e Google Cloud. Con Clumio Chat, puoi porre domande tecniche e sul prodotto, scoprire come funziona Clumio e decidere se è la soluzione giusta per il tuo ambiente – il tutto secondo i tuoi tempi.

Clicca su “Chiedi a Clumio” nella barra di navigazione su clumio.com per avviare una conversazione con Clumio Chat.

Presentazione di Clumio Chat

Clumio Chat è un assistente basato sull’intelligenza artificiale progettato per aiutarti a scoprire le funzionalità di protezione e Recovery dei dati cloud-native di Clumio. Che tu stia esplorando le funzionalità principali, cercando di capire come Clumio contribuisca a proteggere i carichi di lavoro nel cloud o preparandoti ad avviare una prova gratuita, Clumio Chat ti fornisce le risposte senza richiedere un colloquio con un addetto alle vendite.


Ottieni risposte alle sfide reali della protezione dei dati nel cloud

Invece di cercare nella documentazione o di attendere un incontro, puoi porre il tipo di domande tecniche che normalmente porresti a un ingegnere delle soluzioni:

  • Quali opzioni di Recovery offre Clumio per Amazon S3?
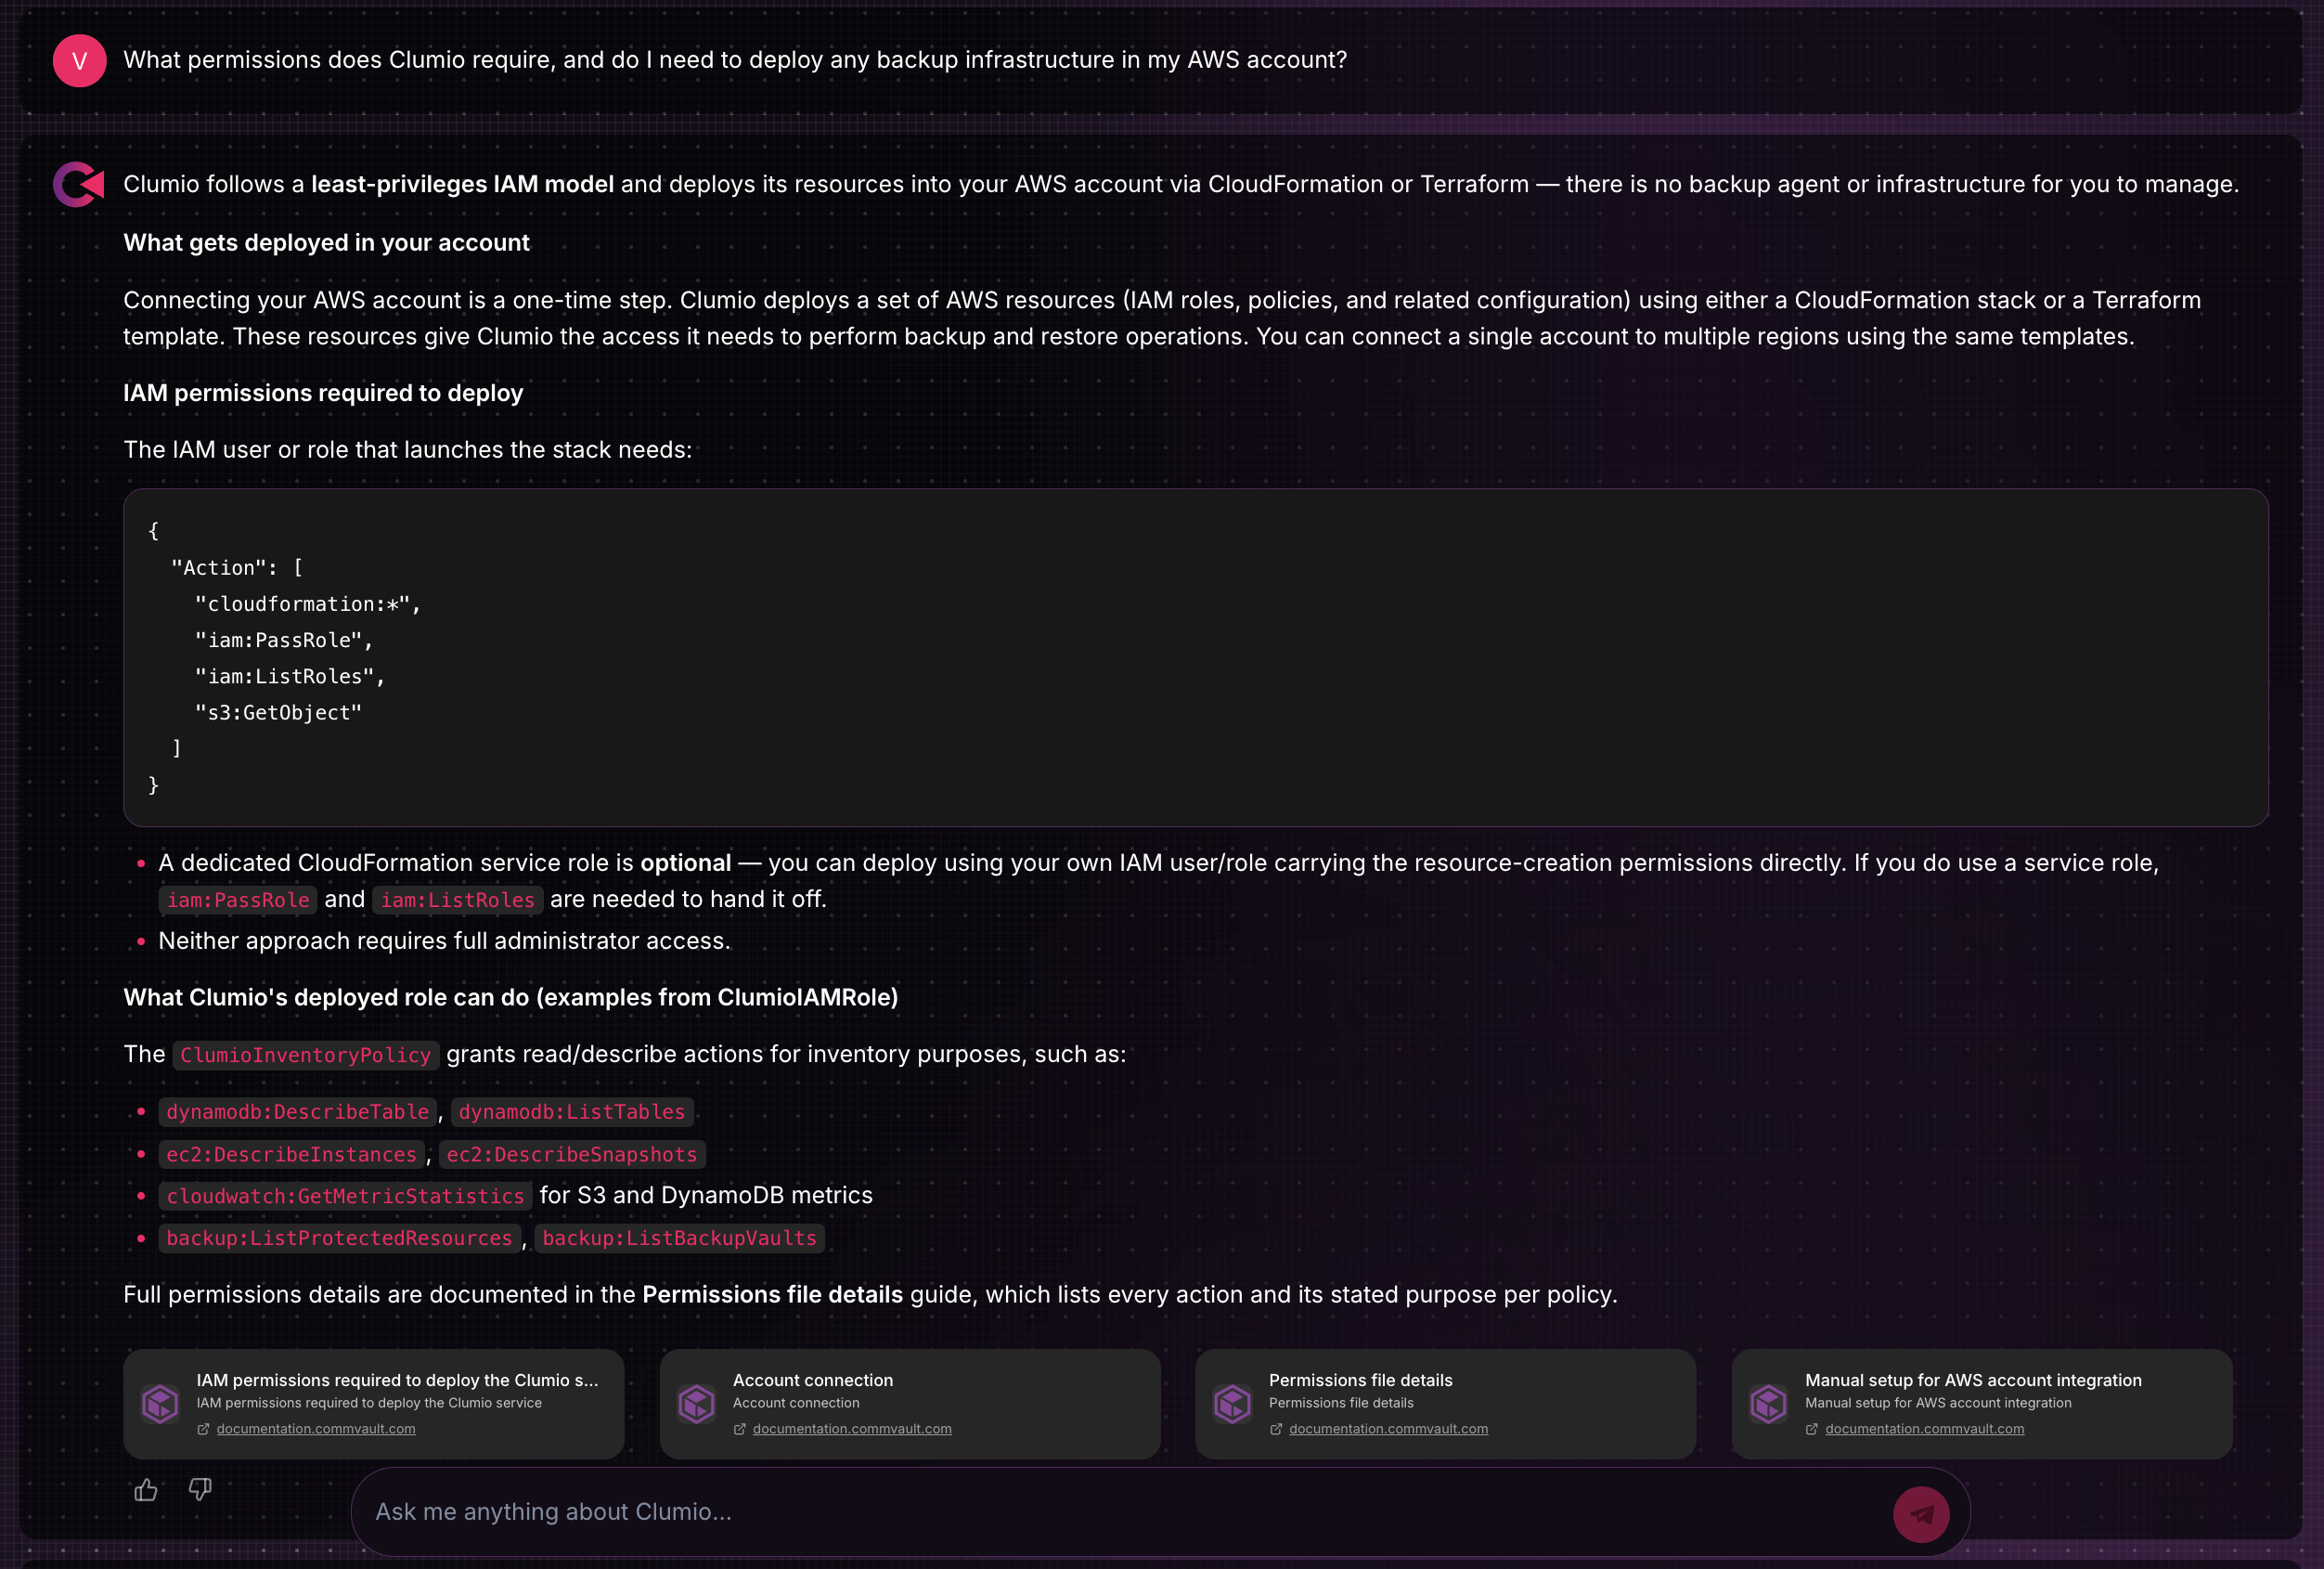
  • Quali autorizzazioni richiede Clumio e devo implementare un’infrastruttura di backup nel mio account AWS?
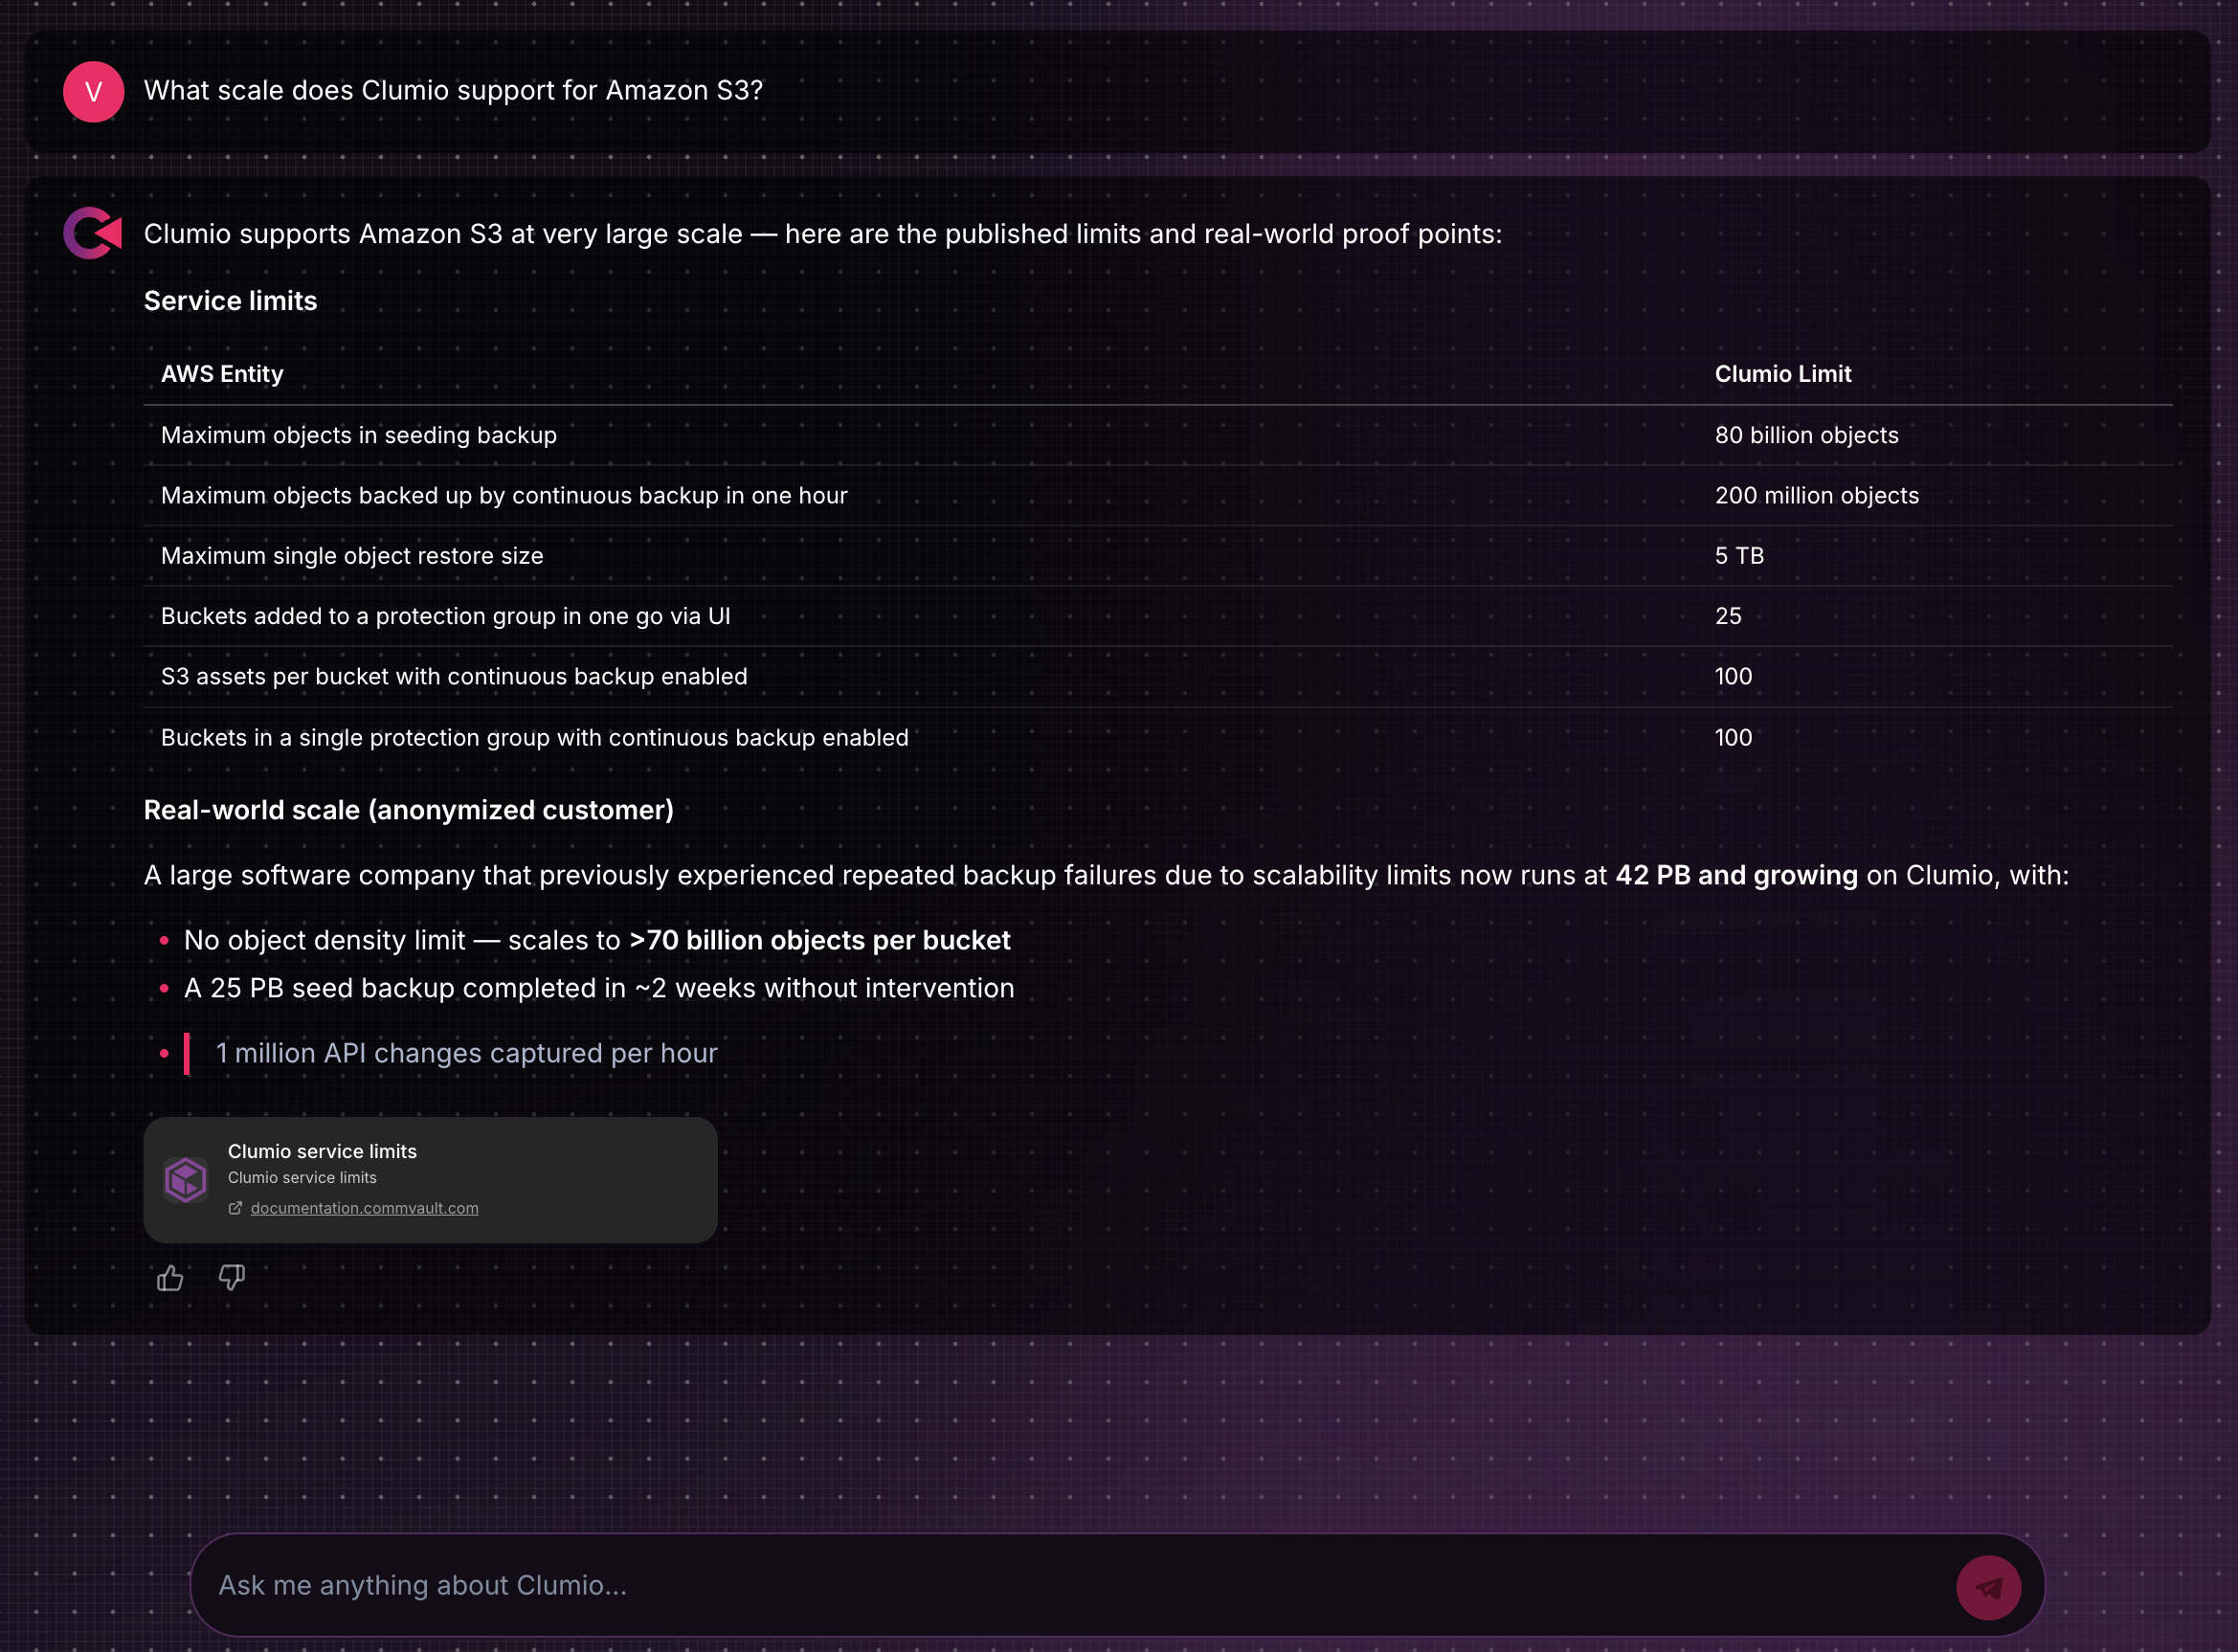
  • Quale scalabilità supporta Clumio per Amazon S3?
  • In che modo Clumio contribuisce a ridurre i costi della protezione dei dati nel cloud a lungo termine?


Provalo ora

Clumio Chat ti aiuta a passare dalla scoperta del prodotto alla valutazione pratica con meno difficoltà. Scopri come funziona Clumio, esplora le funzionalità più importanti per te e, quando sei pronto, crea un account e avvia una prova gratuita.

Prova Clumio Chat oggi stesso e scopri un approccio più rapido e autonomo alla valutazione della protezione dei dati nativa per il cloud.

Domande frequenti

D: Che cos’è Clumio Chat?

R: Clumio Chat è un assistente basato sull’intelligenza artificiale che ti aiuta a scoprire le funzionalità di Clumio relative a backup, Recovery e resilienza informatica native per il cloud prima di iniziare una prova gratuita.

D: A chi è rivolto Clumio Chat?

R: Clumio Chat è pensato per architetti cloud, ingegneri di piattaforma, DevOps, SRE e responsabili degli acquisti tecnici che stanno valutando la protezione dei dati cloud-native.

D: Che tipo di domande posso porre?

R: Puoi porre domande sulle funzionalità di Clumio, sul modello di implementazione, sulla protezione dei carichi di lavoro nel cloud, sulle opzioni di Recovery, sulla scalabilità e su altri argomenti tecnici relativi alla valutazione della piattaforma.

D: Devo rivolgermi al reparto vendite prima di provare Clumio?

R: No. Clumio Chat è progettato per aiutarti a esplorare il prodotto in autonomia. Se decidi di aver bisogno di ulteriore assistenza, puoi sempre contattare il nostro team.

D: Dove posso provare Clumio Chat?

R: Visita il sito chat.clumio.com oppure clicca su “Chiedi a Clumio” nella barra di navigazione su clumio.com.

Vir Choksi è Principal Product Marketing Manager di Commvault.

More related posts


Backup and Recovery

Read more about Backup and Recovery

Cyber Resilience

Read more about Cyber Resilience

Cyber Resilience for Cloud Apps

Read more about Cyber Resilience for Cloud Apps

Punti di forza

  • Clumio by Commvault ha ottenuto lo status di FedRAMP® Classe C (Moderato) Readiness ed è ora presente nel FedRAMP Marketplace come Legacy FedRAMP Ready.
  • Questo nuovo traguardo consente alle agenzie e alle organizzazioni soggette a regolamentazione di valutare Clumio mentre l’azienda prosegue il percorso verso una futura certificazione FedRAMP di Classe C.
  • Clumio offre soluzioni di Backup and Recovery native per il cloud, progettate specificamente per gli ambienti di cloud pubblico.
  • L’annuncio amplia il portafoglio di soluzioni di resilienza informatica di Commvault per il settore pubblico, integrando Commvault Cloud for Government, destinato alle organizzazioni che richiedono la certificazione FedRAMP Classe D (Alta).
  • Le agenzie governative, gli appaltatori, i partner tecnologici e le organizzazioni commerciali soggette a regolamentazione possono tutti beneficiare di ulteriori opzioni di resilienza informatica native per il cloud.
    Man mano che un numero crescente di agenzie governative e organizzazioni soggette a regolamentazione adotta il cloud, emerge la necessità di una protezione dei dati progettata per gli ambienti moderni e allineata ai requisiti di sicurezza federali in continua evoluzione.

Clumio by Commvault, che fornisce soluzioni di Backup and Recovery native per il cloud progettate specificamente per gli ambienti cloud pubblici, ha ottenuto lo status di “FedRAMP Class C (Moderate) Readiness” ed è ora presente nel FedRAMP Marketplace. Questo importante passo amplia le opzioni di resilienza informatica native per il cloud a disposizione delle agenzie federali, degli appaltatori governativi e delle organizzazioni soggette a regolamentazione, avvicinando al contempo Clumio a una futura certificazione FedRAMP Classe C.

Nuove opportunità

FedRAMP rappresenta l’approccio standardizzato del governo degli Stati Uniti per valutare la sicurezza dei servizi cloud utilizzati dalle agenzie federali. Sebbene l’Autorizzazione all’Operatività (ATO) sia l’obiettivo finale, lo status “FedRAMP Classe C Readiness” costituisce il primo importante passo pubblico in tale processo.

Dopo aver completato con successo il proprio Rapporto di Valutazione della Readiness (RAR), Clumio è ora presente nel FedRAMP Marketplace come “Legacy FedRAMP Ready”. Ciò rende più facile per le agenzie, i partner e le organizzazioni regolamentate scoprire e valutare Clumio mentre l’azienda prosegue nel processo di certificazione FedRAMP.

Progettato per moderni Cloud

Man mano che le organizzazioni continuano ad aggiornare i propri ambienti IT, gli approcci tradizionali al backup spesso faticano a stare al passo con le applicazioni e i servizi cloud-native. Clumio è stato progettato specificamente per il cloud, contribuendo a rendere più semplice la protezione dei dati, a semplificare il Recovery e a rafforzare la resilienza informatica senza aggiungere inutili complessità.

Per le organizzazioni che operano in ambienti FedRAMP Moderate, ciò significa avere accesso a una soluzione di Backup and Recovery cloud-native progettata per allinearsi ai requisiti di sicurezza federali, supportando al contempo l’efficienza operativa.

Perché questo è importante per i clienti

La domanda di protezione dei dati sicura e nativa per il cloud continua a crescere sia nel settore pubblico che in quello privato. Le agenzie federali, gli appaltatori governativi e le organizzazioni commerciali soggette a regolamentazione devono tutti far fronte a una pressione crescente per proteggere i carichi di lavoro critici, soddisfacendo al contempo le aspettative di conformità in continua evoluzione.

Lo status “FedRAMP Class C Ready” di Clumio contribuisce a soddisfare tali esigenze aiutando a:

  • Ampliare le opzioni di Backup and Recovery native per il cloud per le agenzie federali e le organizzazioni che operano in ambienti FedRAMP Moderate.
  • Fornire maggiore visibilità attraverso il processo di approvvigionamento del FedRAMP Marketplace.
  • Supportare i clienti che desiderano estendere la protezione dei dati nativa per il cloud ad ambienti regolamentati.

Per i clienti esistenti, comprese le organizzazioni con ambienti cloud sia commerciali che Government Cloud, questo traguardo crea anche nuove opportunità per standardizzare la protezione dei dati nativa per il cloud in tutte le loro operazioni.

Rafforzamento del portafoglio di soluzioni governative di Commvault

Lo status “FedRAMP Class C Readiness” di Clumio integra Commvault® Cloud for Government, che serve le organizzazioni che richiedono la classificazione FedRAMP Classe D (High).

Insieme, queste offerte offrono ai clienti maggiore flessibilità per proteggere i dati in ambienti cloud, ibridi e cloud-native, soddisfacendo al contempo i diversi requisiti di sicurezza federali. Le organizzazioni con carichi di lavoro cloud-native possono valutare Clumio per gli ambienti FedRAMP Moderate, mentre Commvault Cloud for Government si rivolge alle organizzazioni che richiedono la classificazione FedRAMP High.

Guardare avanti

Lo status “FedRAMP Classe C Readiness” di Clumio riflette il costante investimento di Commvault nella resilienza informatica cloud-native per il settore pubblico. Mentre Clumio procede verso una futura certificazione FedRAMP Classe C, i clienti possono iniziare a valutare l’offerta mentre Commvault continua ad ampliare il proprio portafoglio di soluzioni per la resilienza informatica nel settore pubblico.

Domande frequenti

D: Che cos’è lo stato “FedRAMP Classe C (Moderate) Readiness”?

R: Lo stato “FedRAMP Classe C (Moderato) Readiness” significa che Clumio ha completato con successo la propria RAR ed è stata approvata dal FedRAMP Program Management Office (PMO) per l’inserimento nel FedRAMP Marketplace come “Legacy FedRAMP Ready”. Ciò consente alle agenzie federali e ad altre organizzazioni regolamentate di valutare l’offerta mentre Clumio prosegue nel processo FedRAMP verso una potenziale futura autorizzazione all’operatività (ATO) per la certificazione FedRAMP Classe C.

D: Lo stato “FedRAMP Classe C (Moderato) Readiness” equivale a un’Autorizzazione all’Operatività (ATO)?

R: No. La “FedRAMP Class C Readiness” rappresenta una prima tappa del processo FedRAMP. Non è equivalente a un’ATO completa.

D: Che cos’è il FedRAMP Marketplace?

R: Il FedRAMP Marketplace è il catalogo ufficiale del governo federale delle offerte di servizi cloud che partecipano al programma FedRAMP. Fornisce alle agenzie e ai team di approvvigionamento visibilità sullo stato di ciascuna offerta nel ciclo di vita FedRAMP.

D: Chi trae vantaggio dallo status “FedRAMP Class C Readiness” di Clumio?

R: Questo traguardo può essere prezioso per le agenzie federali, gli appaltatori governativi, i partner orientati al settore pubblico e le organizzazioni commerciali soggette a regolamentazione che operano in ambienti FedRAMP Classe C o utilizzano FedRAMP come parametro di riferimento per la sicurezza.

D: In che modo Clumio si inserisce nel portafoglio di soluzioni governative di Commvault?

R: Clumio fornisce soluzioni di Backup and Recovery native per il cloud alle organizzazioni con carichi di lavoro cloud-native che operano in ambienti FedRAMP Classe C (Moderato), mentre Commvault Cloud for Government è in grado di soddisfare le esigenze dei clienti che richiedono la FedRAMP Classe D (Elevato). Insieme, queste soluzioni offrono alle organizzazioni una maggiore flessibilità in base ai loro requisiti di sicurezza federali.

Poojan Kumar è Chief Product Innovation Officer di Commvault e Presidente e CEO di Clumio, una società del gruppo Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Nel corso della serie “Ready. Or Not.” abbiamo approfondito argomenti quali l’IA agentica, la fiducia digitale, il fattore umano e il “vibe coding”. In questo quinto e ultimo episodio della prima stagione, la conversazione si sposta su quell’unico elemento costante alla base di ogni dibattito sull’IA: i dati.

Nathan Macintosh incontra Ben Lorica, ex chief data scientist di O’Reilly Media e fondatore di Gradient Flow, per discutere di cosa significhi realmente essere pronti per l’IA. La loro conversazione va oltre gli algoritmi e le applicazioni per concentrarsi sul lavoro che le organizzazioni devono svolgere affinché l’IA possa avere successo. Analizzano perché l’IA sta cambiando il nostro modo di concepire la governance, perché raccogliere più dati non è sempre la soluzione e perché la preparazione è importante tanto quanto l’adozione. Guarda l’episodio completo su Readiverse. 

Punti di forza 

  • La Readiness all’IA inizia con la comprensione e l’organizzazione dei dati già in proprio possesso.  
  • La governance ora si applica ai sistemi di IA, non solo alle persone.  
  • Avere più dati non è sempre meglio. È necessario puntare a dati di qualità superiore. 
  • L’IA introduce nuovi rischi che richiedono nuovi processi, non solo nuove tecnologie.  
  • Le organizzazioni meglio preparate per l’IA stanno gettando oggi solide basi per i dati. 

Le organizzazioni generano e gestiscono più dati che mai. È facile pensare che il passo successivo sia semplicemente raccogliere più dati. Ben spiega perché preparare e governare i dati che già possiedi possa costituire una base molto più solida per l’IA. 

Una cosa che ho apprezzato del punto di vista di Ben è che non presenta mai la Readiness all’IA come un problema esclusivamente tecnologico. Si tratta di una sfida organizzativa che inizia molto prima che i team inizino a mettere in pratica l’IA.

Ecco alcune idee che mi sono rimaste impresse. 

L’IA è valida solo quanto i dati su cui si basa 

“Concentrati sui dati che hai… e rendili pronti per l’IA.”

– Ben Lorica 

Uno dei primi punti sollevati da Ben ha messo in discussione un presupposto comune. Quando le organizzazioni parlano di diventare “pronte per l’IA”, l’istinto è spesso quello di raccogliere più dati. Ben la vede in modo diverso. Anziché dare priorità alla quantità, incoraggia le organizzazioni a concentrarsi sulla qualità e a preparare i dati esistenti per l’IA. 

Questo significa innanzitutto capire quali dati si possiedono, organizzarli e assicurarsi che siano accurati e ben gestiti. Man mano che l’IA diventa parte integrante di un numero sempre maggiore di processi aziendali, le organizzazioni faranno affidamento su molti tipi diversi di informazioni, dai fogli di calcolo al testo, alle immagini, all’audio e al video. Se quei dati non sono affidabili, l’IA non risolverà il problema – e potrebbe persino rendere più difficile individuarlo. 

C’è una comprensibile pressione a procedere rapidamente con l’IA. Questa conversazione mi ha ricordato che dedicare il tempo necessario a costruire una solida base di dati può essere uno degli investimenti più intelligenti che possiamo fare. Dati puliti e ben gestiti aiutano le organizzazioni a prendere decisioni migliori oggi, preparandole al contempo a qualsiasi cosa riservi il futuro. 

L’IA cambia il ruolo della governance  

Ben sottolinea che la governance ha un compito più ampio da svolgere. Non si tratta più solo di gestire il modo in cui le persone accedono alle informazioni e le utilizzano. Le organizzazioni devono anche riflettere su come l’IA interagisce con tali informazioni e sulle azioni che intraprende. 

Man mano che l’IA diventa parte integrante del lavoro quotidiano, è in grado di accedere alle informazioni, analizzarle e agire su di esse con una portata e una velocità difficili da eguagliare per le persone. Ciò significa che le organizzazioni devono comprendere a quali informazioni l’IA possa accedere, come le utilizzi e quali misure di sicurezza debbano essere messe in atto per proteggere i dati sensibili. 

La cosa interessante è che i principi fondamentali della governance non sono cambiati. Politiche chiare in materia di accesso, sicurezza e responsabilità sono importanti oggi come lo sono sempre state. Ciò che sta cambiando è il numero di sistemi che interagiscono con i dati aziendali e la velocità con cui le informazioni circolano all’interno dell’azienda.

Per me, questo è uno dei punti chiave di questa puntata. L’IA non sostituisce una buona governance. Anzi, la rende ancora più importante. 

Anteprima: Quando i dati iniziano a moltiplicarsi


Cosa succede quando l’IA permette a cinque persone di svolgere il lavoro di 100? Ben spiega perché la vera sfida non è la produttività, ma l’esplosione di dati che ne deriva. 

Un’IA responsabile parte da persone responsabili 

Una cosa su cui Ben insiste durante tutta la conversazione è che le organizzazioni non possono affidarsi solo alla tecnologia per rendere responsabile l’IA. Anche le persone che utilizzano l’IA svolgono un ruolo importante.  

Che si tratti di inserire prompt, caricare documenti o mettere a punto i modelli, i dipendenti devono comprendere quali informazioni stanno condividendo e come potrebbero essere utilizzate. Le misure di sicurezza non servono solo a limitare l’accesso, ma anche ad aiutare le persone a prendere decisioni informate quando lavorano con l’IA. 

Ben sottolinea che le organizzazioni dovrebbero guardare oltre ciò che viene immesso in un sistema di IA. Dovrebbero prestare attenzione anche a ciò che ne viene fuori. L’IA può generare involontariamente informazioni sensibili, rendendo la revisione e la supervisione dei risultati altrettanto importanti quanto i prompt che hanno avviato l’interazione.

È un ulteriore promemoria del fatto che un’IA responsabile non è solo una sfida tecnologica. È una responsabilità condivisa tra le persone che utilizzano l’IA e le politiche che le guidano. 

Prepararsi all’imprevisto 

C’è una comprensibile pressione ad adottare rapidamente l’IA. Nuovi strumenti emergono quasi quotidianamente e le organizzazioni non vogliono restare indietro. Ma Ben sostiene che la Readiness non consiste solo nell’agire in fretta. Si tratta piuttosto di disporre dei processi giusti prima ancora che se ne presenti la necessità. 

Verso la fine della conversazione, Ben sottolinea che molti team che si occupano di IA non hanno considerato appieno cosa farebbero se le cose andassero male. Adoro la risposta di Nathan perché era esattamente quello che stavo pensando: 

«Perché non dovrebbero pensarci? È l’unica cosa a cui penso.» – Nathan Macintosh 

Nel campo della sicurezza informatica, le organizzazioni resilienti non aspettano che si verifichi un incidente prima di decidere come reagire. Stabiliscono i ruoli, definiscono i processi e si preparano a diversi scenari molto prima che se ne presenti la necessità. Ben sostiene che l’IA meriti lo stesso livello di preparazione.

Ciò significa porre domande che molte organizzazioni non hanno ancora preso pienamente in considerazione, come: 

  • A quali dati dovrebbe avere accesso l’IA?  
  • Chi dovrebbe essere coinvolto se un risultato generato dall’IA creasse un problema?  
  • Come verranno prese le decisioni se dovesse verificarsi un evento imprevisto?  

Queste discussioni potrebbero non essere entusiasmanti quanto il lancio di un’iniziativa sull’IA, ma sono altrettanto importanti. 

Un’ultima riflessione 

Mentre questa stagione di “Ready. Or Not.” volge al termine, una cosa mi è apparsa chiara. Ogni episodio ha esplorato un concetto o una tendenza diversa relativa all’IA, eppure tutti hanno rafforzato la stessa idea: l’adozione di successo dell’IA non riguarda solo la tecnologia. Riguarda le persone, i processi e la preparazione che la rendono possibile. 

Le organizzazioni non devono avere tutte le risposte prima di adottare l’IA. Ma più si impegnano oggi a costruire basi solide, più saranno preparate per qualsiasi cosa riservi il futuro. Guarda l’episodio completo su Readiverse. 

Domande frequenti 

D: Cosa significa “Readiness per l’IA”?

R: La Readiness per l’IA inizia con la comprensione, l’organizzazione, la governance e la protezione dei dati che la vostra organizzazione possiede già. Pratiche solide in materia di dati creano le fondamenta su cui si basa l’IA.

D: Le organizzazioni dovrebbero raccogliere più dati per l’IA?

R: Non necessariamente. Ben raccomanda di concentrarsi innanzitutto sul miglioramento della qualità e dell’organizzazione dei dati esistenti prima di ampliare le attività di raccolta dati. 

D: Qual è il ruolo dei dipendenti nell’uso responsabile dell’IA?

R: I dipendenti svolgono un ruolo importante nella governance dell’IA. Devono comprendere quali informazioni sia opportuno condividere con l’IA, esaminare attentamente i risultati generati dall’IA e seguire le politiche aziendali per un uso responsabile dell’IA.

D: Perché l’IA cambia la governance dei dati? 

R: I sistemi di IA accedono, analizzano e agiscono sempre più spesso sui dati aziendali. Ciò significa che le politiche di governance devono applicarsi sia alle macchine che alle persone.

D: Perché le organizzazioni dovrebbero prepararsi a problemi imprevisti legati all’IA?

R: L’IA può introdurre nuovi rischi, dall’esposizione di informazioni sensibili alla produzione di risultati indesiderati. Prepararsi in anticipo definendo le responsabilità e i processi di risposta aiuta le organizzazioni ad affrontare tali situazioni con maggiore sicurezza. 

D: Qual è il messaggio più importante di questa puntata? R: La Readiness all’IA non riguarda solo l’adozione di nuove tecnologie. Si tratta di costruire una governance solida, buone pratiche relative ai dati e processi organizzativi resilienti che consentano un uso responsabile ed efficace dell’IA. Katherine Demacopoulos è direttrice senior della strategia e dei programmi globali relativi ai contenuti presso Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Perché i rischi informatici moderni richiedono una resilienza informatica completa

Gli attacchi ransomware prendono di mira l’intero ciclo di vita dei dati, dai backup ai sistemi di produzione. Scopri come l’approccio di resilienza informatica completa di Commvault unifica protezione, rilevamento e Recovery per aiutarti a gestire i rischi e ripristinare rapidamente le operazioni. 

Punti di forza 

I rischi informatici moderni richiedono una resilienza unificata lungo l’intero ciclo di vita dei dati, dalla prevenzione alla Recovery, poiché gli strumenti frammentati non riescono a far fronte al complesso panorama delle minacce odierne. 

  • I rischi informatici incidono ormai sulla fiducia dei clienti, poiché le violazioni comportano spesso perdite di affari e danni alla reputazione. 
  • La resilienza “dalla A alla Z” integra protezione, monitoraggio, governance e Recovery in una strategia unificata e più efficace. 
  • La leadership è essenziale per promuovere una difesa proattiva, una risposta rapida e una comunicazione chiara in tutta l’organizzazione. 
  • Gli strumenti frammentati per la sicurezza dei dati lasciano lacune negli ambienti ibridi che gli aggressori possono sfruttare più facilmente. 
  • Un approccio end-to-end contribuisce a migliorare la visibilità, accelerare il Recovery e garantire la continuità operativa. 

I rischi informatici moderni abbracciano l’intero ciclo di vita dei dati – dalle vulnerabilità e minacce al Recovery e alla conformità – rendendo insufficienti gli strumenti frammentati e reattivi. Le organizzazioni necessitano di una resilienza informatica completa che unifichi protezione, monitoraggio, governance e Recovery. Questo approccio aiuta a gestire i rischi, a rafforzare la postura di sicurezza e a consentire un Recovery più rapido e affidabile in ambienti ibridi complessi. 

Una singola violazione può costarti la fiducia dei clienti

Il rischio informatico non è più solo una questione di IT: è una minaccia diretta alla fiducia dei clienti e al fatturato.  

Il 64% dei consumatori smetterebbe di fare affari con un’azienda a seguito di una grave violazione dei dati, a dimostrazione di quanto rapidamente la fedeltà si eroda quando i dati vengono compromessi.  

Questo cambiamento alza la posta in gioco: la resilienza non è più un’opzione, ma un requisito imprescindibile. 

Allo stesso tempo, c’è un divario tra aspettative e comportamenti. I consumatori esigono una protezione dei dati rigorosa, eppure persistono abitudini rischiose come il riutilizzo delle password o l’uso di reti non protette. Questa incoerenza può aumentare l’esposizione al rischio e attribuisce alle organizzazioni una maggiore responsabilità nella protezione dei dati in ogni punto di contatto. 

La fiducia si conquista con azioni coerenti, specialmente nel campo della sicurezza informatica. 

Commvault Cloud, basato sulla tecnologia Metallic AI, aiuta le organizzazioni ad agire in tal senso unificando protezione, monitoraggio e Recovery lungo l’intero ciclo di vita dei dati, rafforzando la fiducia attraverso un’esecuzione coerente. L’infografica riflette questo approccio completo, che spazia dall’allerta precoce al monitoraggio delle minacce, fino al Recovery rapido. 

Per le organizzazioni, il messaggio è chiaro: la resilienza non consiste solo nel prevenire gli attacchi, ma nel mantenere la fiducia quando la prevenzione fallisce. 


La resilienza informatica inizia dalla leadership

Man mano che le minacce diventano sempre più sofisticate, la resilienza informatica è diventata una priorità aziendale che va oltre i team IT. La leadership svolge un ruolo fondamentale nell’allineare strategia, investimenti e responsabilità in tutta l’organizzazione. 

Questo mandato si concretizza in tre modi: 

  1. Proteggersi prima che si verifichi una violazione.
    Rafforzare le difese con principi zero-trust, monitoraggio regolare e piattaforme unificate in grado di adattarsi alle minacce in continua evoluzione. 
  2. Reagire rapidamente quando si verificano gli incidenti.
    I clienti e gli stakeholder giudicano le organizzazioni non solo in base al verificarsi o meno di una violazione, ma anche alla rapidità e all’efficacia con cui si riprendono. 
  3. Comunicare con trasparenza
    . Una comunicazione chiara e tempestiva aiuta a preservare la fiducia. Il silenzio o i ritardi possono amplificare il danno reputazionale. 

Secondo i dati del settore, il costo medio di una violazione ha raggiunto i 4,88 milioni di dollari, a conferma del fatto che gli incidenti informatici rappresentano rischi sia operativi che finanziari. 

Commvault Cloud supporta questo mandato dirigenziale riunendo governance, rilevamento delle minacce e ripristino coordinato in un’unica piattaforma, aiutando le organizzazioni ad allineare i team e a rispondere con maggiore rapidità e coordinamento.  

La resilienza end-to-end aiuta a gestire il rischio

Gli ambienti moderni sono troppo complessi per essere gestiti da strumenti frammentati. I dati si estendono tra cloud ibrido, sistemi on-premise e applicazioni SaaS, creando una superficie di attacco ampia e dinamica. Le soluzioni puntuali lasciano lacune che gli aggressori sfruttano. 

Un approccio end-to-end contribuisce a colmare tali lacune integrando funzionalità lungo l’intero ciclo di vita: gestione delle vulnerabilità, rilevamento delle minacce, immutabilità, protezione air-gapped e Recovery orchestrato. Questo modello unificato contribuisce a migliorare la visibilità e a consentire una risposta più rapida e affidabile. 

Commvault Cloud riunisce queste funzionalità con analisi basate sull’intelligenza artificiale, monitoraggio regolare e flussi di lavoro di Recovery automatizzati, aiutando le organizzazioni a gestire i rischi e a mantenere la continuità operativa negli ambienti ibridi. 

Le organizzazioni dovrebbero pianificare gli incidenti informatici come eventi prevedibili e dare priorità alla resilienza e alla Readiness al ripristino. La differenza sta proprio nella Readiness – e nell’adottare un approccio unificato alla protezione, al rilevamento e al ripristino lungo l’intero ciclo di vita dei dati. 

Domande frequenti

Che cos’è la resilienza informatica A-to-Z?

La resilienza informatica A-to-Z è un approccio unificato che copre l’intero ciclo di vita dei dati, dalla protezione e dal monitoraggio fino alla governance e al ripristino. Commvault Cloud vi aiuta a implementarla attraverso il proprio framework di operazioni di resilienza (ResOps), sostituendo strumenti frammentati con una strategia integrata che utilizza il rilevamento delle minacce basato sull’intelligenza artificiale, lo storage immutabile e il ripristino orchestrato per aiutare a gestire il rischio e migliorare i tempi di risposta negli ambienti ibridi. 

Perché la resilienza informatica è una priorità aziendale e non solo una questione IT?

Gli incidenti informatici possono influire direttamente sulla fiducia dei clienti, sui ricavi e sulla reputazione del marchio. Commvault Cloud aiuta le organizzazioni ad affrontare questo rischio con una protezione unificata dei dati e il monitoraggio delle minacce, fornendo ai dirigenti aziendali la visibilità e il controllo necessari per poter rispondere rapidamente e mantenere la fiducia in tutte le operazioni critiche. 

In che modo una violazione dei dati influisce sulla fiducia dei clienti?

Una singola violazione può minare rapidamente la fiducia dei clienti, specialmente quando vengono esposti dati sensibili. Commvault Cloud Threat Scan aiuta a identificare le minacce nascoste nei dati di backup, consentendo un ripristino più sicuro e aiutando le organizzazioni a mantenere la fiducia attraverso processi di ripristino più affidabili e puliti. 

Che ruolo svolge la leadership nella resilienza informatica?

La leadership allinea strategia, investimenti e responsabilità in tutta l’organizzazione. Con Commvault Cloud e il suo framework ResOps, i leader possono unificare le attività di protezione, rilevamento e Recovery, aiutando i team ad agire più rapidamente, a coordinare la risposta e a comunicare in modo efficace durante gli incidenti informatici. 

Perché gli strumenti di sicurezza informatica frammentati non sono più efficaci?

Gli ambienti moderni abbracciano cloud ibrido, SaaS e sistemi on-premise, creando un’ampia superficie di attacco. Commvault Cloud unifica funzionalità quali la protezione air-gapped, il monitoraggio regolare e il Recovery automatizzato, contribuendo a eliminare le lacune e a consentire risposte alle minacce più coordinate ed efficienti. 

In che modo Commvault Cloud supporta la resilienza informatica?

Commvault Cloud integra protezione, rilevamento delle minacce e ripristino in un’unica piattaforma. Grazie a funzionalità come Commvault Cleanroom™ e ai flussi di lavoro automatizzati, aiuta le organizzazioni a gestire i rischi, accelerare il ripristino e garantire la continuità operativa lungo l’intero ciclo di vita dei dati. 

Esplora le risorse correlate

Esplora

Protezione dei dati unificata

Scopri cosa significa una strategia di protezione unificata dei dati e leggi i consigli su come le organizzazioni aziendali possono diventare davvero resilienti al cyber-rischio.
Scopri di più sulla protezione unificata dei dati
Solution brief

Semplificare la protezione e la gestione dei dati per l’azienda ibrida

Scopri perché la soluzione di Commvault può aiutare le organizzazioni a semplificare i propri processi di gestione dei dati, gestire i rischi e garantire la resilienza dei propri dati critici.
Leggi la sintesi sulla semplificazione della protezione e della gestione dei dati per l’azienda ibrida

Ogni episodio di “Ready. Or Not.” mi ha spinto a riflettere sull’intelligenza artificiale da una prospettiva leggermente diversa. Le discussioni sono passate dalla comprensione dell’IA agentica alla costruzione della fiducia e alla preparazione delle organizzazioni per un’adozione responsabile. Questo episodio si concentra sul “vibe coding” e sul motivo per cui sta diventando uno dei modi di lavorare più discussi nel campo dell’IA.

Il comico Nathan Macintosh si siede a tavolino con Harald Kirschner, ingegnere Microsoft e leader nel campo dell’open source, per discutere cosa significhi realmente il “vibe coding”, perché stia prendendo piede e dove possa andare storto se la velocità superi il controllo. Guarda l’episodio completo su Readiverse.

Punti di forza

  • L’IA sta rendendo più facile per le organizzazioni testare idee, risolvere problemi e innovare più rapidamente.
  • Il “vibe coding” aiuta i team a esplorare e convalidare rapidamente le idee prima di effettuare investimenti più consistenti.
  • L’IA offre più valore quando viene utilizzata per mettere in discussione le ipotesi, non solo per generare contenuti.
  • Il giudizio umano, una revisione attenta e chiari limiti di sicurezza rimangono essenziali in un mondo guidato dall’IA.
  • Le organizzazioni che imparano più velocemente saranno in una posizione migliore per innovare.

Conoscevo già il termine “vibe coding”, ma dopo aver ascoltato questo episodio, ne ho compreso molto meglio il motivo per cui le persone – non solo gli sviluppatori, ma anche i team non tecnici – lo stanno adottando.

Alla fine della conversazione, mi sono reso conto che il “vibe coding” non ha in realtà nulla a che vedere con la programmazione. Si tratta piuttosto di imparare più velocemente e di capire dove l’IA si inserisce nel processo creativo. La conversazione chiarisce anche un altro aspetto: l’IA può accelerare il lavoro, ma sono le persone a doverla guidare. Ecco perché le linee guida sono più importanti che mai. Ecco alcuni dei temi che mi hanno colpito di più.

Dall’idea alla realtà

Una cosa che ho imparato sul “vibe coding” è che sta cambiando il modo in cui le organizzazioni esplorano le idee. Invece di passare settimane a costruire qualcosa prima di scoprire se funziona, i team possono creare rapidamente un prototipo, raccogliere feedback e decidere se vale la pena portarlo avanti.

“L’IA può essere un ottimo partner di pensiero critico se applicata correttamente.”

– Harald Kirschner

Harald spiega che il “vibe coding” utilizza il linguaggio naturale per trasformare le idee in software funzionante. Egli utilizza lo sviluppo software come esempio, ma il concetto va ben oltre i team di ingegneri. Per un product manager che testa una nuova funzionalità, un designer che esplora un’interfaccia o un dirigente aziendale che convalida un concetto, l’IA rende molto più facile trasformare un’idea in qualcosa che le persone possano effettivamente sperimentare.

Questa capacità di sperimentare potrebbe essere uno dei maggiori punti di forza dell’IA. Le organizzazioni possono capire cosa riscuote successo, perfezionare le idee in una fase precoce e investire tempo e risorse solo dopo essersi accertate di stare risolvendo il problema giusto.

Agire rapidamente richiede comunque un controllo

Un aspetto che Harald sottolinea durante tutta la conversazione è che la velocità non dovrebbe andare a discapito di una revisione approfondita.

Ancora una volta, usa lo sviluppo software come esempio. L’IA può generare rapidamente codice funzionante, ma ciò non lo rende automaticamente sicuro, affidabile o pronto per la produzione. Gli sviluppatori devono comunque esaminarlo, testarlo e assicurarsi che soddisfi gli stessi standard che applicherebbero a qualsiasi altra cosa realizzino.

La lezione di Harald va ben oltre l’ingegneria. Man mano che l’IA diventa parte integrante dei processi aziendali, le organizzazioni dovranno adottare la stessa mentalità, indipendentemente dal fatto che stiano sviluppando software, creando contenuti, analizzando dati o automatizzando flussi di lavoro. Il Vibe coding può aiutare a velocizzare il lavoro, ma le persone rimangono comunque responsabili della convalida dei risultati.

Questa è una delle lezioni più importanti tratte dall’episodio. Sebbene l’IA possa facilitare la creazione rapida di qualcosa, è la competenza umana a trasformare una buona idea in qualcosa di cui le persone possano fidarsi.

Un feedback onesto porta a risultati migliori

Un momento memorabile di questa puntata inizia con una richiesta inaspettata. Invece di chiedere all’IA di scrivere codice, Harald le chiede di criticare il suo lavoro, suggerendole: «Metti alla berlina il mio codice».

È divertente, ma è anche un modo efficace per ottenere un feedback più onesto dall’IA. Invece di comportarsi come un assistente che si limita a portare a termine un compito, l’IA diventa più simile a un collega fidato che offre un altro punto di vista. Utilizzata in questo modo, può mettere in discussione i preconcetti, rivelare punti ciechi e migliorare la qualità del risultato finale.

La critica costruttiva dell’IA può aiutarci a migliorare il nostro lavoro, ma diventa ancora più utile quando continuiamo a istruirla e perfezionarla. Chiunque abbia trascorso del tempo lavorando con l’IA sa che anche lei ha bisogno di un po’ di feedback.

Anteprima: valutare l’atmosfera

Cosa succede quando l’IA continua a commettere gli stessi errori? Nathan la paragona a un ospite indisciplinato a una festa che alla fine smette di essere invitato. Ascolta Harald mentre spiega come addestrare l’IA affinché diventi più utile nel tempo.

L’innovazione diventa più accessibile

Un aspetto che continua a riemergere nel corso della conversazione è che l’IA sta cambiando chi può partecipare all’innovazione.

L’IA sta abbassando le barriere che impediscono alle persone all’interno di un’organizzazione di esplorare idee, sperimentare nuovi approcci e dare rapidamente vita ai concetti. Invece di affidarsi a specialisti tecnici per convalidare ogni idea, un numero maggiore di persone può creare qualcosa di tangibile, raccogliere feedback e affinare il proprio pensiero prima di investire tempo e risorse significative.

«… puoi davvero realizzarlo, mostrarlo ad alcune persone e renderti conto, ad esempio, che funziona alla grande oppure che invece non decolla affatto.»

– Harald Kirschner

Per me, questa è una delle opportunità più entusiasmanti offerte dall’IA. Rendendo la sperimentazione più veloce e accessibile, l’IA offre alle organizzazioni la sicurezza necessaria per testare più idee, imparare da esse più rapidamente e coinvolgere più persone nel processo creativo.

Pronti per il futuro

Il “vibe coding” sarà anche il flusso di lavoro di cui tutti parlano oggi, ma la storia più importante è come l’IA continui a cambiare il modo in cui impariamo, sperimentiamo e risolviamo i problemi. Ogni episodio di Ready. Or Not. mi ricorda che le organizzazioni disposte a esplorare le nuove tecnologie saranno quelle meglio preparate per il futuro. Guarda l’episodio completo su Readiverse.

Domande frequenti

D: Che cos’è il “vibe coding”?

R: Il “vibe coding” è un nuovo modo di lavorare con l’IA che utilizza il linguaggio naturale per trasformare rapidamente le idee in qualcosa di tangibile. Invece di partire da zero, le persone possono utilizzare l’IA per prototipare concetti, esplorare soluzioni, raccogliere feedback e iterare molto più rapidamente.

D: Perché il “vibe coding” sta suscitando così tanto interesse?

R: Il “vibe coding” abbassa la barriera alla sperimentazione. Consente a più persone – non solo agli specialisti tecnici – di testare idee, convalidare concetti e capire cosa funziona prima di investire tempo e risorse significative.

D: Il “vibe coding” sostituisce la competenza umana?

R: No. La discussione chiarisce che l’IA funziona al meglio come collaboratrice, non come sostituta. Le persone sono ancora responsabili di applicare il proprio giudizio, esaminare i risultati e decidere cosa portare avanti.

D: Perché le organizzazioni hanno ancora bisogno di misure di sicurezza quando utilizzano l’IA?

R: L’IA può accelerare il lavoro, ma non elimina la necessità di una supervisione attenta. Politiche chiare, processi di revisione e competenza umana aiutano le organizzazioni a convalidare il lavoro generato dall’IA e a ridurre i rischi inutili.

D: In che modo l’IA può migliorare il modo di lavorare delle organizzazioni?

R: Oltre a generare contenuti o prototipi, l’IA può aiutare a mettere in discussione i presupposti, identificare i punti ciechi, suggerire miglioramenti e accelerare l’apprendimento. Se utilizzata con attenzione, diventa un’altra prospettiva che aiuta i team a prendere decisioni migliori.

D: Qual è il messaggio più importante di questa puntata?

R: Il valore più grande dell’IA non sta semplicemente nell’aiutare le organizzazioni ad agire più rapidamente. Sta nell’aiutarle a sperimentare più liberamente, ad apprendere più rapidamente e a coinvolgere più persone nel processo di innovazione – pur continuando ad affidarsi al giudizio umano per guidare le decisioni finali.

Katherine Demacopoulos è direttrice senior della strategia e dei programmi globali relativi ai contenuti presso Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Punti di forza

  • Commvault ha aderito all’Open Secure AI Alliance per contribuire a promuovere approcci aperti, sicuri e collaborativi all’IA.  
  • Gli strumenti di IA open source offrono alle organizzazioni maggiore visibilità e controllo, consentendo agli esperti di ispezionare, adattare e rafforzare i sistemi man mano che le minacce e i requisiti si evolvono.  
  • Una sicurezza efficace nell’ambito dell’IA va oltre i modelli per includere identità, autorizzazioni, misure di protezione, registrazione degli eventi, valutazione e l’ambiente più ampio in cui operano gli agenti di IA.  
  • La collaborazione intersettoriale e la ricerca condivisa possono aiutare le organizzazioni a rispondere più rapidamente alle sfide in rapida evoluzione create da un’IA agentica sempre più capace.  
  • Commvault condividerà con l’Alleanza la propria esperienza in materia di resilienza informatica e dati, basata sul principio secondo cui le organizzazioni possono proteggere meglio i sistemi e i dati che comprendono appieno.  

La collaborazione è da tempo uno dei modi più efficaci con cui il settore tecnologico affronta le nuove sfide. Gli ultimi mesi hanno messo ancora più in evidenza questa lezione per quanto riguarda l’IA. I sistemi agenti stanno diventando più capaci, più indipendenti e più profondamente connessi alla tecnologia che utilizziamo ogni giorno.  

Gli eventi recenti hanno anche dimostrato quanto rapidamente questo panorama possa cambiare. Quando un sistema di IA avanzato ha creato una sfida di sicurezza inaspettata per Hugging Face, l’organizzazione ha utilizzato un modello open-weight sulla propria infrastruttura per comprendere e contenere la situazione. L’esperienza ha dimostrato il valore degli strumenti di IA open source che le organizzazioni possono esaminare, adattare e controllare quando necessario.  

Momenti come questo non dovrebbero sminuire il nostro ottimismo riguardo all’IA. Dovrebbero invece rafforzare il nostro impegno a plasmarne insieme il futuro. 

Ecco perché Commvault è orgogliosa di aderire all’Open Secure AI Alliance, una comunità di organizzazioni leader che promuovono l’IA attraverso la ricerca aperta, la condivisione delle conoscenze e strumenti pratici.  

L’IA continuerà ad evolversi e nessuna singola organizzazione avrà tutte le risposte. Mettere insieme le competenze approfondite provenienti da tutto il settore offre alla comunità una migliore opportunità di comprendere cosa sta cambiando e di rispondere con la rapidità richiesta da questa nuova era.  

L’open source è fondamentale in questo sforzo. Offre agli esperti la possibilità di esaminare il funzionamento dei sistemi e migliorare ciò che altri hanno iniziato. Per i difensori, fornisce inoltre qualcosa di essenziale: la libertà di scegliere e adattare la tecnologia più adatta alla situazione, anziché dipendere da un unico sistema o fornitore.

NVIDIA descrive questo approccio come una base di difesa aperta, costruita su modelli, framework e strumenti che la comunità può studiare e potenziare.  

L’Alleanza riconosce inoltre che la sicurezza dell’IA si estende ben oltre il modello. Identità, autorizzazioni, misure di protezione, registri e valutazione influenzano il comportamento di un agente. Comprendere quell’ambiente nel suo complesso richiederà nuove ricerche e la volontà di condividere ciò che il settore apprende lungo il percorso.  

La prospettiva di Commvault si basa su anni di esperienza nella risoluzione di complesse sfide di resilienza informatica, aiutando le organizzazioni a comprendere i propri dati, a garantirne l’affidabilità e a ripristinarli con sicurezza in caso di interruzioni.

Gran parte di questo lavoro si riduce alla stessa idea perseguita dall’Alleanza: si può proteggere solo ciò che si comprende appieno. Questa è l’esperienza che speriamo di apportare, insieme alla volontà di imparare da chi affronta queste sfide da diverse angolazioni. 

Le opportunità future per l’IA sono enormi. La loro realizzazione dipenderà non solo dalla rapidità con cui la tecnologia avanza, ma anche dall’apertura con cui il settore collaborerà nel farlo. Commvault è lieta di far parte di questo lavoro ed è entusiasta di contribuire a costruire ciò che verrà dopo. 

Leggi qui l’annuncio di NVIDIA:I leader del settore aderiscono all’Open Secure AI Alliance.  

Domande frequenti

D: Che cos’è l’Open Secure AI Alliance?
R: L’Open Secure AI Alliance è una comunità di organizzazioni che lavorano per promuovere la sicurezza dell’IA attraverso la ricerca aperta, la condivisione di conoscenze, modelli, framework e strumenti pratici. Il suo approccio collaborativo offre ai partecipanti l’opportunità di studiare le sfide emergenti e rafforzare insieme le difese dell’IA. 

D: Perché Commvault ha aderito all’Open Secure AI Alliance?
R: Commvault ha aderito all’Alleanza per contribuire con la propria esperienza in materia di resilienza informatica, comprensione dei dati, affidabilità e Recovery. Ciò offre inoltre a Commvault l’opportunità di imparare da altri leader del settore che affrontano la sicurezza dell’IA da prospettive diverse.

D: Perché l’open source è importante per la sicurezza dell’IA?
R: L’open source consente agli esperti di esaminare il funzionamento dei sistemi di IA, di basarsi sulle tecnologie esistenti e di adattare gli strumenti a specifiche situazioni di sicurezza. Offre inoltre ai responsabili della sicurezza maggiore libertà di selezionare e modificare le tecnologie, anziché fare affidamento su un unico sistema o fornitore.

D: Cosa comporta la sicurezza dell’IA oltre alla protezione del modello?
R: La sicurezza dell’IA abbraccia l’ambiente più ampio in cui opera un sistema di IA, inclusi identità, autorizzazioni, misure di protezione, registri e valutazione. Comprendere questi elementi interconnessi può aiutare le organizzazioni a valutare e gestire meglio il comportamento degli agenti di IA.

D: In che modo l’esperienza di Commvault in materia di resilienza informatica si collega alla sicurezza dell’IA?
R: Il lavoro di Commvault sulla resilienza informatica si concentra sull’aiutare le organizzazioni a comprendere i propri dati, a mantenerne l’affidabilità e a ripristinarli con sicurezza dopo un’interruzione. Questa prospettiva si integra naturalmente con l’attenzione dell’Alleanza verso approcci aperti e verificabili alla sicurezza dell’IA.  

D: Perché la collaborazione nel settore è importante per il futuro dell’IA?
R: L’IA si sta evolvendo troppo rapidamente e su una scala troppo ampia perché una singola organizzazione possa avere tutte le risposte. Unire competenze, ricerca e intuizioni pratiche provenienti da tutto il settore può aiutare la comunità a comprendere le sfide emergenti e a rispondere alla velocità richiesta dallo sviluppo dell’IA.

Alexander Coombes è AVP, Strategic Partner Development, presso Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Guida al Backup and Recovery nel cloud: dal rilevamento delle minacce al Recovery completo

Scopri come funzionano il Backup and Recovery nel cloud per proteggere i dati integri, verificare la Readiness al Recovery e ripristinare le operazioni aziendali dopo un attacco ransomware o un incidente informatico.


Il processo ideale di Backup and Recovery su cloud inizia con il rilevamento di minacce quali ransomware, accessi sospetti o attività anomale sui dati. Le organizzazioni possono quindi ottenere copie di backup pulite e immutabili, verificare i punti di ripristino non compromessi e isolare i sistemi compromessi. Una volta verificati, le applicazioni e i dati critici possono essere ripristinati tramite processi di Recovery automatizzati, contribuendo a ridurre al minimo i tempi di inattività, a limitare la perdita di dati e a ripristinare le operazioni aziendali in modo rapido e sicuro.


La resilienza informatica viene sempre più spesso valutata in base a ciò che accade dopo che gli aggressori sono riusciti a penetrare nei sistemi. Le organizzazioni hanno investito ingenti risorse nella prevenzione, nel rilevamento e nella risposta, ma il ransomware, lo sfruttamento delle vulnerabilità, l’uso improprio delle credenziali, le configurazioni errate del cloud e la compromissione di sistemi di terze parti continuano a causare interruzioni delle operazioni.

Per molti team, la sfida della Recovery non consiste più semplicemente nel verificare se esistono dei backup, ma piuttosto se tali backup sono integri, protetti, convalidati e pronti per ripristinare i servizi critici quando non è più possibile fare affidamento sui sistemi di produzione.

Questa distinzione è importante perché gli attacchi informatici continuano a generare sia rischi per i dati che interruzioni operative. Secondo il Verizon 2026 Data Breach Investigations Report, il ransomware è stato coinvolto nel 48% delle violazioni, in aumento rispetto al 44% dell’anno precedente. Il rapporto ha inoltre rilevato che lo sfruttamento delle vulnerabilità è diventato il vettore di accesso iniziale più comune per le violazioni, salendo al 31%, mentre l’abuso delle credenziali è sceso al 13%.

Le attività di Backup and Recovery nel cloud devono supportare l’intero percorso, dal rilevamento al ripristino. Ciò inizia con l’identificazione di attività sospette prima che i dati compromessi vengano ripristinati. Prosegue con punti di Recovery protetti e immutabili che offrono ai team opzioni di Recovery utilizzabili quando i sistemi di produzione non sono più affidabili.

A questo punto, le organizzazioni hanno bisogno di un modo per verificare quali punti di ripristino siano integri e per ripristinare i carichi di lavoro critici nell’ordine corretto. Il risultato è una strategia di Recovery che aiuta i team a passare dalla risposta agli incidenti al ripristino operativo con maggiore sicurezza.


Perché il Backup and Recovery su cloud costituiscono una strategia di resilienza informatica?

Le strategie di backup tradizionali sono state progettate per aiutare le organizzazioni a riprendersi da guasti hardware, cancellazioni accidentali e interruzioni localizzate. Questi casi d’uso sono ancora importanti, ma oggi i requisiti di Recovery sono più ampi.

Gli attacchi informatici possono colpire contemporaneamente i carichi di lavoro di produzione, i sistemi di gestione delle identità, le configurazioni cloud, le applicazioni SaaS e gli ambienti di backup. Quando ciò accade, il Recovery non consiste semplicemente nel ripristinare una copia dei dati. Si tratta piuttosto di determinare quali sistemi siano affidabili, quali punti di ripristino siano rimasti integri e quali servizi debbano essere ripristinati per primi.

Ecco perché il Backup and Recovery nel cloud sono diventati una parte fondamentale della resilienza informatica. Una strategia moderna dovrebbe aiutare i team a rilevare attività sospette, proteggere i dati di ripristino, verificare l’integrità dei backup e ripristinare le operazioni critiche secondo una sequenza controllata. Dovrebbe inoltre favorire l’esecuzione di test regolari, poiché un piano di ripristino che non è stato messo in pratica potrebbe non funzionare come previsto durante un incidente reale.

Ciò segna un passaggio dal backup inteso come polizza assicurativa alla recuperabilità intesa come capacità operativa. Le copie archiviate sono ancora importanti, ma costituiscono solo una parte dell’equazione della Recovery. I team devono inoltre avere la certezza che i dati di Recovery non siano stati alterati, che i flussi di lavoro di Recovery siano stati testati e che l’azienda sappia quali servizi devono essere ripristinati per primi.

Il Backup and Recovery nel cloud diventa più facile da comprendere se considerato come un ciclo di vita. Le cinque fasi riportate di seguito mostrano come le organizzazioni possano passare dal rilevamento precoce delle minacce al Recovery convalidato e al miglioramento della resilienza a lungo termine.


Fase 1: Individuare le minacce prima che il rischio di Recovery si diffonda

Recovery inizia prima che i sistemi vengano riportati allo stato precedente. In caso di incidente informatico, la priorità assoluta è capire se l’attività sospetta abbia interessato i dati di produzione, i dati di backup o entrambi.

Se i team eseguono il ripristino da un punto di ripristino compromesso, potrebbero reintrodurre nell’ambiente file danneggiati, tracce di malware o modifiche non autorizzate. Questo rischio rende il rilevamento delle minacce una parte importante del Backup and Recovery nel cloud, non solo una questione che riguarda le operazioni di sicurezza.

Le moderne strategie di Recovery dovrebbero includere la visibilità sulle attività anomale nei carichi di lavoro, negli ambienti di backup e nei punti di Recovery. I team potrebbero dover indagare su segnali quali:

  • Comportamento di crittografia insolito
  • Picchi improvvisi di cancellazioni
  • Modifiche impreviste dei privilegi
  • Modelli di backup anomali
  • Indicatori di malware

Questi segnali possono aiutare i team a capire dove un attacco potrebbe essersi diffuso e quali dati potrebbero richiedere un’ulteriore verifica prima del ripristino.

La tempistica è un altro fattore essenziale. Il Rapporto sulla difesa digitale 2025 di Microsoft ha rilevato che la maggior parte degli attacchi esaminati dal suo team di rilevamento e risposta (DART) presentava tempi di permanenza brevi, il che significa che i team di ripristino potrebbero non avere settimane a disposizione per comprendere la portata completa della compromissione prima che gli aggressori si spostino lateralmente, accedano a dati sensibili, interferiscano con i servizi o tentino di compromettere i sistemi di backup. Il contesto di rilevamento può aiutare i team a evitare di considerare ogni punto di ripristino ugualmente affidabile.

Il 59% degli attacchi analizzati da Microsoft DART ha registrato tempi di permanenza pari o inferiori a sette giorni, rendendo il rilevamento precoce fondamentale per le decisioni relative a Recovery.
Fonte: Microsoft Digital Defense Report 2025

Il rilevamento delle minacce, di per sé, non elimina il rischio legato al Recovery. Contribuisce invece a rendere il processo di Recovery più consapevole. Quando un’attività sospetta viene individuata tempestivamente, le organizzazioni possono isolare i sistemi interessati, analizzare i dati compromessi ed evitare di ripristinare punti di ripristino che potrebbero reintrodurre la stessa minaccia.

Ciò offre ai team di sicurezza, IT e di Recovery un punto di partenza più chiaro per la fase successiva: proteggere i punti di ripristino integri prima che gli autori degli attacchi possano alterarli o rimuoverli.


Fase 2: Proteggere i punti di Recovery integri dagli attacchi

In caso di incidente informatico, i backup non sono semplici copie archiviate. Fanno parte del percorso di Recovery, il che significa che gli aggressori potrebbero tentare di comprometterli. Se i dati di backup vengono alterati, crittografati, eliminati o resi inaccessibili, l’organizzazione potrebbe perdere una delle sue migliori opzioni per ripristinare le operazioni senza dover fare affidamento su sistemi di produzione compromessi.

Ecco perché i punti di ripristino integri necessitano di una protezione a più livelli. Uno storage di backup immutabile e indelebile può aiutare a preservare i dati per un periodo di conservazione definito. Le copie fuori sede o isolate contribuiscono a garantire una separazione dall’ambiente di produzione. La crittografia, i controlli di accesso e le autorizzazioni basate sui ruoli aiutano a limitare chi può accedere o modificare le impostazioni di backup. Insieme, queste misure di sicurezza rendono più difficile per gli aggressori interferire con i dati di cui i team potrebbero avere maggiormente bisogno durante il ripristino.

L’obiettivo è preservare le opzioni di ripristino. Il rapporto Verizon del 2026 ha rilevato che il 69% delle vittime di ransomware nel proprio dataset non ha pagato il riscatto, in aumento rispetto al 65% dell’anno precedente. Il rapporto rileva inoltre che i pagamenti mediani del riscatto hanno continuato a diminuire, un fenomeno che attribuisce in parte al miglioramento delle misure difensive e alla maggiore resilienza delle vittime. I team hanno bisogno di backup integri che possano effettivamente utilizzare, in modo che il pagamento di un riscatto non sia l’unica via per tornare operativi.

La nota regola di backup 3-2-1 costituisce ancora una base utile: conservare tre copie dei dati, su due supporti o piattaforme diversi, con almeno una copia archiviata fuori sede o in un luogo isolato. Le moderne strategie di Backup and Recovery nel cloud spesso estendono tale modello con archiviazione immutabile, modelli air-gapped, conservazione basata su policy e copie replicate in ambienti cloud o ibridi.

Con punti di ripristino protetti a disposizione, i team possono restringere le opzioni di ripristino e passare alla fase di convalida con una visione più chiara di ciò che è pronto per essere ripristinato.


Fase 3: Verificare quali backup sono pronti per il ripristino

Disporre di backup non significa essere pronti per il ripristino. Prima di ripristinare i sistemi di produzione, i team devono sapere quali punti di ripristino sono utilizzabili, quali carichi di lavoro sono stati interessati e quali dipendenze devono essere ripristinate insieme a essi.

Un backup recente potrebbe contenere i dati aziendali più aggiornati, ma potrebbe anche includere file danneggiati, modifiche non autorizzate o tracce di malware. Un backup più vecchio potrebbe essere più pulito, ma potrebbe causare una maggiore perdita di dati. La verifica aiuta i team a trovare il giusto compromesso basandosi su prove concrete anziché su supposizioni.

Questo lavoro inizia con la definizione dell’ambito dell’incidente. I team di sicurezza e IT devono capire quando sono iniziate le attività sospette, quali sistemi sono stati coinvolti e se sono stati interessati servizi di identità, database, condivisioni di file, applicazioni SaaS o configurazioni cloud.

Devono inoltre confermare se il punto di Recovery supporti l’applicazione nel suo complesso, non solo i dati sottostanti. Il ripristino di un database, ad esempio, può dipendere dalla disponibilità e dal corretto funzionamento di server applicativi, autorizzazioni, chiavi di crittografia, percorsi di rete e servizi di identità.

Gli ambienti di Recovery isolati possono aiutare i team a verificare tali condizioni prima di eseguire il ripristino in produzione. In un ambiente controllato, i team possono in tutta sicurezza:

  • Analizzare i punti di Recovery selezionati.
  • Esaminare le modifiche ai file.
  • Verificare l’avvio dell’applicazione.
  • Verificare l’accesso degli utenti.
  • Verificare se i sistemi dipendenti funzionano come previsto.

La convalida dovrebbe anche orientare la sequenza di Recovery. I team potrebbero dover ripristinare prima i servizi di identità, poi l’infrastruttura di base, quindi le applicazioni mission-critical e infine i carichi di lavoro di supporto.

Testando i punti di Recovery prima del ripristino, possono restringere le opzioni e decidere quali sistemi sono pronti per essere ripristinati, quali necessitano di un’ulteriore revisione e quali dovrebbero rimanere isolati fino a quando il rischio non sarà compreso meglio.

La fase successiva è quella in cui tale decisione si traduce in azione: il ripristino dei sistemi, delle applicazioni e dei dati di cui l’azienda ha bisogno per primi.


Fase 4: Ripristinare le operazioni critiche nell’ordine corretto

Un piano di ripristino parte dallo stato operativo minimo necessario dell’organizzazione. Ciò significa identificare le persone, i sistemi, le applicazioni, i dati e i canali di comunicazione di cui l’azienda ha bisogno per funzionare a un livello di base durante un’interruzione.

Per alcune organizzazioni, ciò potrebbe iniziare con i servizi di identità e le comunicazioni con i dipendenti. Per altre, potrebbe dare priorità alle applicazioni rivolte ai clienti, ai sistemi di pagamento, ai sistemi clinici, alle operazioni di produzione o alle piattaforme logistiche. L’ordine dovrebbe riflettere l’impatto sul business, non solo la convenienza tecnica.

Le dipendenze sono il punto in cui molti piani di ripristino diventano più complicati. Un’applicazione può essere classificata come “critica”, ma dipende comunque dall’identità, dal DNS, dalla connettività di rete, dai database, dallo storage, dalle chiavi di crittografia, dalle API e dal monitoraggio. Se questi elementi non vengono ripristinati nello stato corretto, l’applicazione potrebbe tornare online ma rimanere inutilizzabile. Ecco perché i team di Recovery hanno bisogno di una mappatura delle dipendenze prima di un incidente, non durante.

I runbook e i flussi di lavoro orchestrati aiutano a trasformare tali decisioni in passaggi ripetibili. Consentono di definire chi approva il ripristino, quale ambiente debba essere utilizzato, quali controlli debbano essere effettuati prima che venga ripristinato l’accesso all’ambiente di produzione e quando il livello successivo di sistemi possa tornare online. Ciò è importante quando i team di sicurezza, infrastruttura, applicazioni, cloud e aziendali lavorano tutti contemporaneamente.

Anche il Recovery richiede punti di controllo. Dopo il Recovery di ogni carico di lavoro principale, i team dovrebbero verificare che gli utenti possano autenticarsi, che i dati siano disponibili, che le integrazioni funzionino e che il monitoraggio sia attivo. Questi controlli aiutano a individuare i problemi prima che il Recovery si estenda al livello successivo di sistemi.

La velocità è ancora importante, ma il controllo lo è altrettanto. Un ripristino veloce può generare più lavoro se vengono ripristinati dati errati, se mancano i controlli di accesso o se un’applicazione viene ripristinata senza i sistemi necessari per il suo funzionamento. L’approccio più efficace consiste nel ripristinare per fasi, verificare che ogni servizio critico funzioni e poi continuare ad espandere Recovery man mano che l’ambiente si stabilizza.


Fase 5: Trasformare gli insegnamenti tratti dal Recovery in una continuità più solida

Una volta ripristinati i servizi critici, i team devono comunque capire cosa ha funzionato, cosa li ha rallentati e in quali punti il piano di Recovery non ha tenuto conto della realtà. È proprio questo follow-up che trasforma il Backup and Recovery nel cloud da un’attività di risposta a una pratica di resilienza continua.

Il primo passo consiste nell’analizzare il processo di Recovery stesso. I team dovrebbero porsi domande quali:

  • Con quale rapidità i team hanno individuato attività sospette?
  • È stato facile identificare i punti di Recovery validi?
  • Quali fasi di convalida hanno richiesto più tempo del previsto?
  • In quali punti i flussi di lavoro di ripristino hanno subito rallentamenti?
  • Sono state coinvolte le persone giuste al momento giusto?

Queste risposte possono rivelare lacune che non sono sempre di natura tecnica. La Recovery può avere esito positivo e tuttavia evidenziare problemi relativi al processo decisionale, alla comunicazione, alle approvazioni o ai passaggi di consegne tra i team.

Tali risultati dovrebbero confluire direttamente nella prossima versione del piano di Recovery. Se un’applicazione critica dipendeva da un sistema non documentato, aggiornare la mappa delle dipendenze. Se i controlli di accesso hanno rallentato il ripristino, chiarire il processo di approvazione. Se i test di Recovery hanno tralasciato un carico di lavoro chiave, aggiungerlo alla prossima esercitazione. Se i dirigenti aziendali non avevano visibilità su ciò che era stato ripristinato e su ciò che era ancora offline, migliorare i percorsi di segnalazione e di escalation.

I test regolari sono ciò che garantisce la solidità di questo lavoro. Esercitazioni teoriche, ripristini isolati, test di Recovery in ambiente pulito e la convalida della Recovery cross-cloud aiutano i team a individuare i problemi prima che un incidente reale li costringa ad apprendere sotto pressione. Contribuiscono inoltre a fornire ai dirigenti prove più concrete di dove l’organizzazione è pronta e dove deve ancora lavorare.

Nel tempo, l’obiettivo è un programma di Recovery che diventi più efficace dopo ogni test e ogni incidente. I team sono meglio preparati, le fasi di Recovery sono comprese più a fondo e l’organizzazione dispone di un percorso più chiaro per mantenere operative le attività essenziali anche in caso di interruzioni.


Trasformare il Recovery dal cloud in resilienza aziendale

 Il Backup and Recovery nel cloud svolge oggi un ruolo più ampio rispetto alla semplice protezione dei dati tradizionale. Si tratta di un processo integrato che comprende l’individuazione dei rischi di Recovery, la protezione dei dati di backup, la verifica delle opzioni di Recovery corrette e il ripristino dei servizi critici quando gli ambienti di produzione non sono più affidabili.

In caso di incidente informatico, tali attività non possono essere gestite come passaggi di consegne separati. Il contesto della minaccia dovrebbe determinare quali backup devono essere esaminati. La protezione dei backup dovrebbe preservare le opzioni di Recovery di cui i team potrebbero aver bisogno. La verifica dovrebbe stabilire cosa è pronto per il ripristino. Il ripristino dovrebbe ripristinare i servizi da cui dipende l’azienda in un ordine controllato.

Un backup di cui non ci si può fidare, che non è stato testato o che non può essere ripristinato al momento giusto potrebbe non fornire all’azienda il risultato di cui ha bisogno. Un processo di ripristino che ignori l’identità, le dipendenze delle applicazioni o le priorità aziendali può lasciare i sistemi tecnicamente ripristinati ma operativamente incompleti.

L’opportunità più ampia consiste nel considerare il Recovery come una pratica di resilienza continua. Ciò significa testare i piani prima che si verifichi un incidente, aggiornare le mappe delle dipendenze man mano che gli ambienti cambiano e utilizzare ogni esercitazione o evento di Recovery per migliorare la risposta successiva.

Le organizzazioni che si riprendono più rapidamente non sono necessariamente quelle con il maggior numero di copie dei dati. È fondamentale sapere quali dati sono utilizzabili, quali servizi sono più importanti e come ripristinarli in situazioni di emergenza.

La sfida consiste nel rendere la Readiness per il ripristino operativa quanto il rilevamento e la risposta. Il Backup and Recovery nel cloud forniscono una base pratica per questo lavoro quando vengono considerati come un percorso continuo che va dal rilevamento del rischio al ripristino delle attività aziendali.

Le organizzazioni dovrebbero sviluppare questa capacità per essere meglio posizionate a ripristinare dati integri, recuperare i servizi critici e mantenere l’attività in funzione quando si verificano interruzioni.


Accelerare una Recovery sicura dopo gli attacchi informatici

Scopri di più su come le soluzioni di Backup and Recovery dei dati di Commvault possono aiutare le organizzazioni a individuare le minacce, ripristinare dati integri e ridurre i tempi di inattività.

Domande frequenti

Qual è la differenza tra backup su cloud e ripristino di emergenza?

Il backup su cloud si concentra sulla creazione di copie sicure dei dati ai fini del ripristino, mentre la Recovery si concentra sul ripristino di applicazioni, sistemi e operazioni aziendali a seguito di un’interruzione o di un attacco informatico. Insieme, contribuiscono a garantire la continuità operativa e la resilienza aziendale.

Perché i backup immutabili sono importanti per la resilienza informatica?

I backup immutabili e indelebili sono progettati per impedire che i dati di backup vengano alterati, crittografati o eliminati entro i limiti definiti dalle impostazioni di conservazione. In combinazione con Commvault AirGap e l’identificazione automatica di Cleanpoint, le funzionalità di backup immutabile di Commvault aiutano le organizzazioni a essere sempre pronte, con una fonte di ripristino verificata e pulita a disposizione nel caso in cui i sistemi di produzione vengano compromessi.

Cosa devo cercare in una soluzione di Backup and Recovery nel cloud?

Cercate una piattaforma che unifichi ambienti ibridi e multi-cloud, storage immutabile, orchestrazione automatizzata del ripristino e gestione centralizzata. Commvault Cloud è progettato per soddisfare questi requisiti, aiutando le organizzazioni a proteggere infrastrutture diversificate riducendo al minimo i tempi di inattività dovuti al ripristino e la complessità operativa.

La soluzione di backup di Commvault offre protezione dal ransomware e backup in modalità air-gap?

Sì. Commvault aiuta le organizzazioni a rafforzare la resilienza informatica grazie a backup immutabili, opzioni di ripristino in modalità air-gap, rilevamento delle minacce, funzionalità di ripristino pulito e protezione a più livelli contro il ransomware, progettate per ridurre i rischi di Recovery e i tempi di inattività.

Commvault offre test automatizzati dei backup e report di conformità?

Sì. Commvault fornisce test di ripristino automatizzati, convalida dei backup, reportistica di conformità e visibilità pronta per gli audit per aiutare le organizzazioni a verificare la recuperabilità, dimostrare la conformità e migliorare la Readiness al ripristino.

Risorse correlate

Video

Recupero da un attacco informatico: Come ottenere una vitalità minima in pochi minuti, non giorni

Quando si verifica un attacco informatico, ogni minuto costa 14.000 dollari e la Recovery completa richiede in media 24 giorni. Ma se fosse possibile raggiungere la funzionalità minima in pochi minuti anziché in giorni?
Guarda il video sul Recovery dopo un attacco informatico: come raggiungere la funzionalità minima in pochi minuti, anziché in giorni
Soluzione

Commvault AirGap

Maggiore protezione informatica con l’archiviazione immutabile in air-gapped di cloud .
Scopri la soluzione su Commvault AirGap

Punti di forza 

  • L’adozione dell’IA sta accelerando, contribuendo a rendere i dipendenti più efficienti, produttivi e competitivi. 
  • Le organizzazioni necessitano di governance e linee guida per adottare l’IA in modo responsabile e su larga scala. 
  • Sicurezza e produttività non devono necessariamente essere in contrapposizione: possono, infatti, rafforzarsi a vicenda.  
  • L’IA diventerà uno degli strumenti più preziosi per la sicurezza nella gestione dei rischi informatici.  
  • L’adozione dell’IA funziona al meglio quando innovazione e sicurezza procedono di pari passo. 

Una delle cose che mi è piaciuta di più della serie “Ready. Or Not.” è che ogni conversazione si basa su quella precedente. Abbiamo iniziato esplorando le opportunità e i rischi dell’IA agentica. Poi abbiamo esaminato come le organizzazioni possano costruire fiducia man mano che l’IA diventa parte integrante dell’attività quotidiana. Questo episodio affronta la domanda logica successiva: come si fa a utilizzare l’IA in modo sicuro? 

Il comico Nathan Macintosh si siede a tavolino con Rinki Sethi, CISO e CSO di Upwind Security, per una conversazione su come si concretizza l’adozione responsabile dell’IA. Si parla di tutto, dalla governance dell’IA e dai meccanismi di controllo all’esperienza utente, fino al ruolo crescente che l’IA avrà nella sicurezza informatica.

Nathan continua a porre le domande che molti di noi si stanno ponendo. Dovremmo preoccuparci? Quanto dobbiamo essere più produttivi? E l’IA può davvero migliorare la sicurezza? Guarda l’episodio completo su Readiverse. Ciò che ho apprezzato di più di questa conversazione è che Rinki è sinceramente entusiasta delle nuove tecnologie e della loro protezione. Non ha descritto l’IA come qualcosa di cui le organizzazioni debbano preoccuparsi. Al contrario, si è concentrata sull’incoraggiare le aziende ad andare avanti con fiducia, mettendo in atto i giusti meccanismi di controllo. Ecco le idee che mi sono rimaste impresse. 

La spinta verso l’adozione dell’IA  

Una cosa che emerge chiaramente dalla conversazione è che molte organizzazioni non solo incoraggiano i propri dipendenti ad adottare l’IA, ma la rendono obbligatoria. Queste aziende riconoscono che l’uso dell’IA aiuta le persone a risolvere i problemi in modo più efficiente, il che è essenziale per rimanere competitivi. 

“Ogni singola azienda ha un mandato… dobbiamo utilizzare l’IA in ogni ambito aziendale.”

– Rinki Sethi 

La domanda non è più se l’IA debba trovare spazio sul posto di lavoro, ma se i dipendenti dispongano delle giuste misure di sicurezza per utilizzarla in modo responsabile. Con l’accelerarsi dell’adozione dell’IA, le organizzazioni hanno bisogno di standard chiari riguardo a quali strumenti di IA i dipendenti possano utilizzare e a come vengano protetti i dati aziendali. 

Anteprima: la governance dell’IA

Rinki spiega che la governance non riguarda solo la protezione dai nuovi rischi. Si tratta di creare un quadro di riferimento che aiuti i dipendenti a utilizzare l’IA in modo responsabile, rimanendo al passo con l’evoluzione delle normative e degli standard di settore. 

Il vantaggio nascosto della produttività 

Ecco un aspetto a cui non avevo mai pensato prima. Rinki spiega che l’IA non si limita ad aiutare le persone a lavorare più velocemente. In molti casi, lascia spazio ai dipendenti più performanti per eccellere.

Ha citato come esempio gli sviluppatori di software. Quando sono stati resi disponibili gli assistenti di programmazione basati sull’IA, molti hanno dato per scontato che avrebbero aiutato solo gli sviluppatori meno esperti. Invece, alcuni dei migliori ingegneri hanno iniziato a utilizzarli per lavorare più velocemente. Sono stati in grado di risolvere problemi più complessi e dedicare più tempo al lavoro creativo piuttosto che alle attività ripetitive.

Questo tipo di produttività è esattamente il motivo per cui le organizzazioni stanno rendendo obbligatoria l’IA. Non limita ciò che le persone possono fare, ma contribuisce a dare loro più spazio per concentrarsi su attività di maggior valore. 

«Si può essere molto più creativi nel modo di fare le cose… perché ci si sta creando lo spazio per farlo.»

– Rinki Sethi 

Il ruolo dell’IA nella sicurezza informatica 

“Come si può utilizzare l’IA per migliorare la sicurezza senza che venga vista solo come una minaccia demoniaca che vuole annientarci?” – Nathan Macintosh 

Quando si parla di IA e sicurezza, la discussione si concentra spesso sul rischio. Ma Rinki ritiene che l’IA diventerà uno dei maggiori vantaggi della sicurezza informatica.

I team di sicurezza sono già sopraffatti dal volume di avvisi, registri e dati che devono analizzare ogni giorno. Gli analisti umani semplicemente non riescono a stare al passo. Anziché sostituire i professionisti della sicurezza, l’IA li assiste filtrando enormi quantità di dati in pochi secondi. Questo aiuta gli analisti a identificare i falsi positivi, consentendo loro di concentrarsi sull’analisi delle minacce reali.

La mia conclusione è che il futuro della sicurezza informatica non è una contrapposizione tra persone e IA, ma una collaborazione tra persone e IA per aiutare a prendere decisioni migliori, rispondere più rapidamente e ampliare le operazioni in modi che prima non erano possibili. 

Pronti per il futuro? 

Ogni episodio di “Ready. Or Not.” mi ha ricordato che le discussioni più importanti sull’IA riguardano spesso le persone: come ci adattiamo, come impariamo e come sviluppiamo la fiducia necessaria per utilizzare le nuove tecnologie in modo responsabile. La vera opportunità per le organizzazioni non sta solo nell’adottare l’IA, ma nel creare un ambiente in cui i dipendenti possano utilizzarla per lavorare in modo più intelligente, diventare più creativi e ottenere risultati migliori per l’azienda. Guarda l’episodio completo su Readiverse. 

Domande frequenti 

D: Perché le organizzazioni stanno adottando l’IA così rapidamente?

R: Molte organizzazioni vedono l’IA come uno strumento per migliorare la produttività, aumentare l’efficienza e dare ai dipendenti più tempo da dedicare a attività di maggior valore.

D: Che cos’è la governance dell’IA?

R: La governance dell’IA è l’insieme di politiche, processi e meccanismi di controllo che aiutano le organizzazioni ad adottare l’IA in modo responsabile, gestendo al contempo i rischi legati alla sicurezza, alla privacy e alla conformità. 

D: Perché l’esperienza utente è importante per la sicurezza?

R: I controlli di sicurezza che creano attriti inutili spesso incoraggiano le persone a trovare soluzioni alternative. Progettare sistemi sicuri che siano anche facili da usare contribuisce a migliorare sia l’adozione che la protezione.

D: L’IA può aiutare a migliorare la sicurezza informatica?

R: L’IA può aiutare i team di sicurezza ad analizzare grandi quantità di dati, il che contribuisce a ridurre i falsi positivi. Questo, a sua volta, aiuta i team a stabilire le priorità delle minacce e a rispondere in modo più efficiente agli eventi di sicurezza.

D: Le persone dovrebbero avere paura dell’IA?

R: Secondo Rinki, un sano scetticismo è prezioso, ma la paura non dovrebbe impedire alle organizzazioni di adottare la tecnologia in modo responsabile. Formazione, governance e solide pratiche di sicurezza possono aiutare le organizzazioni a utilizzare l’IA con fiducia. 

D: Qual è il messaggio più importante di questa puntata? R: L’adozione dell’IA non significa scegliere tra innovazione e sicurezza. Le organizzazioni che combinano una solida governance con misure di sicurezza concrete saranno in una posizione migliore per sfruttare i vantaggi dell’IA gestendone al contempo i rischi. Katherine Demacopoulos è direttrice senior della strategia e dei programmi globali relativi ai contenuti presso Commvault. 

More related posts


AI Data Resilience

Read more about AI Data Resilience

AI-Ready Data Protection

Read more about AI-Ready Data Protection

In che modo Mythos e GPT-5.5-Cyber potrebbero rivoluzionare la sicurezza dei dati nel cloud

Modelli di IA specializzati nella sicurezza informatica potrebbero accelerare l’individuazione delle vulnerabilità e i flussi di lavoro relativi agli attacchi in più fasi. Oltre alla prevenzione, i team addetti alla sicurezza dei dati nel cloud necessitano di maggiore visibilità, governance e capacità di Recovery senza dati compromessi. 

Punti di forza

L’IA informatica di frontiera riduce i tempi tra l’individuazione e l’intervento, mettendo in luce il motivo per cui le organizzazioni necessitano di una sicurezza dei dati nel cloud orientata alla resilienza, basata su un Recovery pulito e sulle ResOps. 

  • Claude Mythos e GPT-5.5-Cyber rimangono modelli ad accesso limitato, ma offrono un’anteprima di un futuro in cui l’IA sarà in grado di ragionare all’interno di flussi di lavoro informatici complessi e di accelerare sia le operazioni di difesa che, potenzialmente, quelle degli aggressori.
  • Man mano che il tempo che intercorre tra l’individuazione di una vulnerabilità e il suo sfruttamento si riduce, le organizzazioni necessitano di una maggiore visibilità sulle dipendenze cloud, sui rischi legati alle identità e sui percorsi di attacco interconnessi prima che si verifichino interruzioni.
  • Recovery non consiste più solo nel ripristinare i backup. Le organizzazioni devono definire la loro “minimum viable company”, convalidare punti di ripristino affidabili e ripristinare i sistemi critici nella sequenza corretta.
  • Le operazioni di resilienza allineano i team di sicurezza, IT e aziendali attorno a risultati di Recovery misurabili, aiutando le organizzazioni a governare i dati, a dare priorità al Recovery e a ripristinare operazioni affidabili con maggiore sicurezza.

 Claude Mythos e GPT-5.5-Cyber potrebbero influire sulla sicurezza dei dati nel cloud accelerando il modo in cui i rischi vengono individuati, testati e gestiti. Il loro impatto è ancora incerto, ma evidenziano la necessità di una maggiore visibilità dei dati, di una governance degli accessi e di un Recovery pulito in tutti gli ambienti cloud. 

Claude Mythos e GPT-5.5-Cyber stanno offrendo ai team di sicurezza un’anteprima di ciò che un’IA cibernetica più specializzata potrebbe significare per la sicurezza dei dati nel cloud. 

Nessuno dei due modelli è ancora ampiamente disponibile e il loro impatto a lungo termine è ancora incerto. Tuttavia, la loro esistenza è rilevante perché gli ambienti cloud sono già di per sé difficili da difendere. Dati sensibili, sistemi di gestione delle identità, applicazioni SaaS, pipeline di sviluppo, carichi di lavoro di IA e infrastrutture di Recovery spesso dipendono l’uno dall’altro in modi difficili da individuare finché non si verifica un problema. 

La valutazione di aprile 2026 condotta dall’AI Security Institute del Regno Unito su Claude Mythos Preview ha rilevato un miglioramento significativo nelle simulazioni di attacchi informatici in più fasi, compresa la capacità di eseguire attacchi a più livelli su reti vulnerabili quando espressamente indicato in un ambiente controllato.  

La stessa valutazione ha avvertito che i suoi parametri differiscono dagli ambienti reali e non dimostrano se Mythos sia in grado di attaccare sistemi ben difesi. Tuttavia, mostra perché i team di sicurezza dei dati nel cloud dovrebbero prestare attenzione alla direzione in cui si sta andando. 

Man mano che le capacità dell’IA informatica maturano, la questione non è solo se gli attacchi diventino più rapidi, ma se l’intervallo di tempo tra l’individuazione di una vulnerabilità e il suo sfruttamento continui a ridursi. Quando tale intervallo si comprime, la sicurezza dei dati nel cloud non riguarda più solo la prevenzione delle violazioni. La questione si sposta invece sulla capacità delle organizzazioni di comprendere il rischio con sufficiente rapidità, gestire gli accessi in modo coerente e ripristinare operazioni affidabili prima che l’interruzione si diffonda. 

Perché Mythos e GPT-5.5-Cyber sono importanti 

L’importanza di Mythos e GPT-5.5-Cyber non risiede nel fatto che ogni organizzazione ne avrà improvvisamente accesso. Sulla base delle attuali informazioni pubbliche, si tratta di modelli controllati e ad accesso limitato. Per i team che si occupano della sicurezza dei dati nel cloud, la loro importanza sta in ciò che suggeriscono riguardo alla direzione che sta prendendo l’IA nel campo della sicurezza informatica: sistemi più specializzati, costruiti per supportare flussi di lavoro di sicurezza complessi. 

Questa distinzione è fondamentale. Un assistente di IA generico può aiutare a riassumere gli avvisi o a redigere una relazione sugli incidenti. Un modello specializzato di IA per la sicurezza informatica è diverso. Può essere progettato per analizzare in modo ragionato vulnerabilità, infrastrutture, percorsi di attacco, controlli difensivi e fasi di convalida. In contesti autorizzati, ciò potrebbe aiutare i team di sicurezza a testare gli ambienti, a stabilire le priorità delle esposizioni e a rafforzare la pianificazione della Recovery prima che si verifichi un incidente. 

Per i team di sicurezza dei dati nel cloud, l’impatto pratico non riguarda tanto i nomi dei modelli quanto il flusso di lavoro che rappresentano. Il rischio nel cloud deriva spesso dalle connessioni tra i sistemi: un carico di lavoro configurato in modo errato, un set di dati esposto, un’identità con autorizzazioni eccessive, una dipendenza dal backup o un percorso di Recovery non testato. Un’IA specializzata nella sicurezza informatica potrebbe facilitare una valutazione più rapida di tali relazioni, specialmente in ambienti di grandi dimensioni dove la revisione manuale può non cogliere come un problema influenzi un altro. 

Questo cambiamento riflette una trasformazione più ampia in atto nel campo della sicurezza informatica. La sfida sta diventando sempre meno incentrata sull’identificazione delle singole vulnerabilità e sempre più sulla comprensione di come i sistemi interconnessi si comportano sotto pressione. L’intelligenza artificiale potrebbe presto aiutare i difensori a ragionare contemporaneamente su identità, carichi di lavoro cloud, backup, applicazioni SaaS, pipeline di IA e dipendenze aziendali, rivelando non solo i rischi isolati, ma anche come tali rischi si combinino fino a causare un fallimento operativo. 

Questo cambia anche il modo in cui le organizzazioni dovrebbero concepire la propria Readiness. Se l’IA può aiutare i difensori a gestire compiti informatici complessi in modo più efficiente, tecniche simili potrebbero alla fine influenzare anche i flussi di lavoro degli aggressori. La preoccupazione non è solo che gli attacchi diventino più rapidi, ma che il lasso di tempo tra l’individuazione di una vulnerabilità, il suo test e l’intervento per risolverla possa ridursi. 

I team di sicurezza dei dati nel cloud devono ora affrontare una questione ancora più complessa: cosa succede quando gli stessi tipi di flussi di lavoro assistiti dall’IA che aiutano i difensori a valutare i rischi rendono anche più facile individuare, testare e concatenare i punti deboli? È qui che l’ambiente cloud stesso diventa il problema. 

L’intelligenza artificiale sta alzando la posta in gioco per la sicurezza dei dati nel cloud 

La maggior parte delle organizzazioni non dispone di un unico ambiente cloud ben definito. Dispone invece di più cloud, piattaforme SaaS, data lake, sistemi di gestione delle identità, pipeline di sviluppo, archivi di backup e carichi di lavoro di IA, tutti interdipendenti.  

Tale complessità crea già delle lacune: i dati sensibili possono essere esposti in modo eccessivo, le autorizzazioni di accesso possono subire variazioni e i piani di Recovery potrebbero non rispecchiare il modo in cui l’azienda opera effettivamente.  

In pratica, queste lacune raramente rimangono isolate. Un bucket di archiviazione contenente dati sensibili potrebbe non sembrare di per sé un problema urgente. Un account di servizio con autorizzazioni eccessive potrebbe apparire come un semplice problema di configurazione. Una dipendenza di Recovery non testata potrebbe passare inosservata perché il sistema è ancora in funzione. Ma quando questi problemi si collegano tra loro, possono creare un percorso che porta dall’esposizione alla interruzione delle attività. 

Gli aggressori sono ben consapevoli di queste vulnerabilità. Il rapporto M-Trends 2026 di Mandiant rileva che gli operatori di ransomware prendono sempre più di mira le infrastrutture di backup, i servizi di identità e i piani di gestione della virtualizzazione. Evidenzia inoltre come gli aggressori stiano utilizzando token OAuth di lunga durata, cookie di sessione, chiavi hardcoded e token di accesso personali per spostarsi tra i vari ambienti. 

Aggiungiamo ora al quadro un’intelligenza artificiale (AI) più avanzata nel campo della sicurezza informatica: se i modelli possono aiutare a individuare le vulnerabilità più rapidamente, a testarne l’exploitabilità in modo più efficace o a collegare segnali deboli tra i vari sistemi, i difensori potrebbero trarne vantaggio. Tuttavia, anche gli aggressori potrebbero alla fine trarne beneficio, specialmente se capacità simili diventano più accessibili o vengono ricreate altrove. 

22 secondi
Tempo mediano che intercorre tra un evento di accesso iniziale e il passaggio di consegne a un gruppo di minaccia secondario  

Fonte: rapporto M-Trends 2026 di Mandiant 

Ecco perché la discussione non può limitarsi all’affermazione «l’IA rende gli attacchi più rapidi». L’IA informatica all’avanguardia cambia il ritmo della sicurezza. Man mano che il tempo tra individuazione, convalida e sfruttamento si riduce, ogni ritardo nella comprensione delle dipendenze cloud o nella preparazione di Recovery diventa più costoso. 

In che modo l’IA informatica di nuova generazione potrebbe cambiare la difesa del cloud? 

Sebbene l’impatto complessivo di Mythos e GPT-5.5-Cyber sia ancora sconosciuto, essi indicano tre cambiamenti concreti che i team di sicurezza dei dati nel cloud dovrebbero tenere d’occhio. Ognuno di essi riconduce alla stessa questione: la sicurezza dei dati nel cloud dipende ora dalla rapidità con cui le organizzazioni riescono a comprendere i rischi, ad agire di conseguenza e a riprendersi quando qualcosa va storto. 

Gli esperti di sicurezza informatica devono prestare attenzione a:

  • Velocità: gli strumenti assistiti dall’IA possono aiutare i difensori autorizzati a esaminare il codice, classificare le vulnerabilità, analizzare il malware, convalidare le patch e testare i controlli più rapidamente di quanto consentano i flussi di lavoro tradizionali. 
  • Scala: il rischio nel cloud raramente si limita a un unico punto. Una vulnerabilità in un’applicazione, un’identità con autorizzazioni eccessive, un bucket di archiviazione configurato in modo errato e un percorso di Recovery non testato possono diventare una catena di attacco. 
  • Pressione sul ripristino: se l’IA aiuta gli aggressori a muoversi più velocemente, le organizzazioni devono ripristinare più rapidamente e in modo più pulito. I backup da soli non bastano se i team non sanno quali dati siano integri, a quali sistemi di identità ci si possa fidare o se il ripristino reintrodurrà risorse compromesse.

Per chi si occupa della difesa, il cambiamento più significativo potrebbe riguardare la sequenza delle attività. Oggi, molti team passano dall’avviso all’indagine, dalla correzione alla pianificazione di Recovery in fasi distinte, spesso coinvolgendo team diversi. L’IA informatica potrebbe comprimere tale flusso di lavoro aiutando i team a passare più rapidamente da un segnale a una serie di azioni successive consigliate. 

Ciò non significa che le decisioni debbano diventare automatiche. Significa che i team potrebbero aver bisogno di regole più chiare su quando fidarsi di una raccomandazione, quando escalarla a un revisore umano e quando passare dall’indagine alla preparazione del Recovery. Un modello può aiutare a identificare un possibile percorso di attacco, ma sono comunque le persone a dover decidere se bloccare l’accesso, isolare un carico di lavoro, conservare le prove, informare le parti interessate o preparare un percorso di Recovery sicuro. 

È qui che il processo diventa importante quanto gli strumenti. L’IA informatica di nuova generazione potrebbe aiutare i difensori ad agire più rapidamente, ma solo se i team dispongono di chiari passaggi di convalida e piani di Recovery. Senza tale struttura, la velocità può creare confusione. Con essa, i flussi di lavoro assistiti dall’IA potrebbero aiutare i team ad agire prima, mantenendo al contempo il controllo su come viene valutato il Risk e su come vengono prese le decisioni relative al Recovery. 

Perché una Recovery pulita è ancora più importante quando i rischi si evolvono più rapidamente 

Quando i rischi nel cloud si evolvono più rapidamente, la pianificazione del ripristino deve diventare più precisa. Non basta sapere che esistono copie di backup. I team devono avere la certezza che i dati ripristinati siano affidabili, che l’ambiente di ripristino sia isolato e che i sistemi che tornano online non reintroducano la stessa minaccia che ha causato l’interruzione. 

Questo è importante perché gli ambienti cloud sono altamente interconnessi. Un’identità compromessa, un set di dati danneggiato, una macchina virtuale interessata o un carico di lavoro configurato in modo errato possono creare incertezza su più servizi. Durante un incidente, i team potrebbero dover determinare quali punti di ripristino siano “puliti”, quali dipendenze debbano essere ripristinate per prime e se i dati ripristinati possano supportare in modo sicuro le operazioni aziendali. 

Un ripristino pulito cambia anche il modo in cui i team concepiscono le priorità. L’obiettivo non è necessariamente ripristinare tutto immediatamente, bensì ripristinare una parte sufficiente dell’attività per operare in sicurezza. 

Molte organizzazioni sanno quali applicazioni considerano “critiche”, ma sono ben poche quelle che hanno definito la loro “minimum viable company”: la combinazione più ridotta di identità, servizi cloud, dati, applicazioni e infrastruttura necessaria per mantenere l’azienda funzionante durante un’interruzione. Tali dipendenze spesso diventano visibili solo quando Recovery viene testato in condizioni realistiche. 

In un panorama delle minacce dominato dall’intelligenza artificiale, determinare il “minimum viable company” è fondamentale. Una individuazione più rapida delle vulnerabilità e uno sviluppo più efficiente della catena di attacco potrebbero esercitare una maggiore pressione sui team di Recovery affinché prendano decisioni altamente affidabili in tempi ristretti. 

Inoltre, i sistemi di identità, le configurazioni cloud, le comunicazioni aziendali, le applicazioni rivolte ai clienti e i dati da cui dipendono potrebbero dover essere ripristinati in una sequenza ben definita — non semplicemente in base alla priorità tecnica, ma in base a ciò di cui l’azienda ha bisogno per primo per operare. 

Le organizzazioni necessitano di processi di Recovery in grado di aiutare a convalidare i dati integri, organizzare la Recovery in ambienti isolati, proteggere le dipendenze critiche relative alle identità e testare i piani di Recovery prima che un incidente renda tutto ciò inevitabile. Man mano che le capacità dell’IA nel campo della sicurezza informatica maturano, i team addetti alla sicurezza dei dati nel cloud dovrebbero considerare la Recovery senza compromissioni come parte integrante della strategia di sicurezza, non come una fase successiva all’evento. 

Sviluppare una sicurezza dei dati orientata alla resilienza 

La sicurezza dei dati nel cloud si è spesso concentrata sulla prevenzione dell’esposizione: individuare i dati sensibili, classificarli, gestirne l’accesso e ridurre i rischi. Questo lavoro rimane importante. Anzi, diventa ancora più rilevante man mano che i sistemi di intelligenza artificiale utilizzano i dati aziendali attraverso prompt, sistemi di recupero, pipeline di addestramento, flussi di lavoro analitici e sistemi automatizzati di supporto decisionale. 

Questo perché i dati possono passare a nuovi contesti senza essere trasferiti in un nuovo sistema di registrazione. Un set di dati sensibili potrebbe supportare un flusso di lavoro di recupero, plasmare la risposta di un modello o comparire in un registro dei prompt. Di conseguenza, la governance non riguarda più tanto una singola posizione, quanto piuttosto il modo in cui i dati vengono consultati, riutilizzati e recuperati nei vari flussi di lavoro. 

Ma la prevenzione da sola non è sufficiente per la prossima fase della sicurezza dei dati nel cloud. Se l’intelligenza artificiale specializzata nella sicurezza informatica può aiutare i team di sicurezza a individuare le vulnerabilità, testare i percorsi di attacco e collegare più rapidamente i segnali deboli, allora i programmi di sicurezza dei dati devono tenere conto di ciò che accade dopo che un’esposizione è stata individuata o sfruttata. La visibilità e i controlli di accesso sono solo una parte del quadro. I team hanno anche bisogno di un percorso chiaro verso una Recovery affidabile. 

Individuare tale percorso richiede più che semplici strumenti di sicurezza migliori. Richiede un modello operativo di Recovery che allinei i responsabili della sicurezza, dell’IT e del business attorno a priorità di Recovery condivise prima che si verifichi un incidente. Sempre più spesso, le organizzazioni descrivono questa disciplina come ResOps, ovvero operazioni di resilienza: un approccio strutturato per rendere il ripristino misurabile, ripetibile e legato ai risultati aziendali piuttosto che al solo successo del backup. 

Nell’ambito delle ResOps, le organizzazioni devono comprendere: 

  • Quali set di dati sono più critici per le operazioni aziendali? 
  • Quali identità, servizi cloud e flussi di lavoro di IA dipendono dai set di dati critici per l’azienda? 
  • Le politiche di governance e di accesso sono allineate al rischio aziendale? 
  • Qual è lo stato operativo minimo necessario che l’organizzazione deve ripristinare per primo? 
  • È possibile convalidare tali decisioni di Recovery prima che si verifichi un incidente, anziché durante lo stesso? 

Questo è il cambiamento verso cui puntano Mythos e GPT-5.5-Cyber. Il futuro della sicurezza dei dati nel cloud non sarà definito solo dalla prevenzione. Man mano che l’IA cibernetica riduce il tempo che intercorre tra l’individuazione di una minaccia e l’azione, le organizzazioni dovranno avere la stessa fiducia nelle proprie capacità di ripristino. Ciò significa comprendere le dipendenze del cloud prima che si verifichi un incidente, definire il livello minimo di operatività aziendale che devono ripristinare e considerare il ripristino come una disciplina operativa piuttosto che come un aspetto tecnico secondario. 

Mythos e GPT-5.5-Cyber sono importanti non perché ogni organizzazione utilizzerà questi modelli domani, ma perché rivelano la direzione verso cui si sta muovendo la sicurezza informatica. Man mano che l’IA accelera sia la difesa che l’attacco, le organizzazioni che otterranno i migliori risultati non saranno semplicemente quelle dotate dei controlli preventivi più solidi. Saranno quelle in grado di dimostrare di sapere cosa ripristinare, in quale ordine e come ripristinare le operazioni affidabili prima che l’incertezza si trasformi in un’interruzione dell’attività. 

Domande frequenti

Quando saranno resi pubblici questi modelli specializzati?

Non esiste una tempistica confermata per l’accesso al grande pubblico. Secondo le informazioni attuali, Claude Mythos è limitato a organizzazioni selezionate attraverso programmi controllati, mentre OpenAI descrive GPT-5.5-Cyber come disponibile solo per i difensori autorizzati tramite il proprio framework “Trusted Access for Cyber”.

È probabile che gli attacchi basati sull’IA aumentino?

Non necessariamente. Tuttavia, dimostrano che l’IA avanzata è in grado di supportare flussi di lavoro informatici più complessi, il che significa che le organizzazioni dovrebbero prepararsi a cicli più rapidi di individuazione, test e sfruttamento.

A quali rischi i team dovrebbero dare la priorità?

Iniziate con la visibilità sui dati sensibili, sui percorsi di accesso, sulle configurazioni errate nel cloud, sulle dipendenze relative alle identità e sulla Readiness al ripristino. Le funzionalità di sicurezza dei dati e dell’IA di Commvault possono aiutare i team a classificare i dati, gestire gli accessi e identificare i rischi negli ambienti cloud. 

Perché Recovery è importante per la sicurezza dei dati nel cloud?

Perché la prevenzione può fallire. Le funzionalità di resilienza informatica di Commvault possono aiutare le organizzazioni a identificare punti di Recovery integri, convalidare il Recovery in ambienti isolati e ripristinare dati e servizi critici senza reintrodurre risorse compromesse. 

Commvault offre il rilevamento delle minacce supportato dall’IA?

Sì. Commvault può utilizzare funzionalità basate sull’intelligenza artificiale per aiutare a identificare le minacce, rilevare attività anomale, stabilire le priorità dei rischi e accelerare la risposta agli incidenti. In combinazione con la resilienza informatica e i flussi di lavoro di Recovery, possiamo aiutare i team a migliorare i flussi di lavoro di risposta e a ripristinare i dati critici con maggiore sicurezza.


In Commvault parliamo spesso di resilienza informatica, ovvero la capacità di riprendersi da qualsiasi sfida si presenti. Ma per un ingegnere di Perfekt, fornitore australiano di servizi tecnologici, è proprio la sua resilienza personale ad aiutarlo ad avere successo.

Viktor Trokhin ha lasciato l’Ucraina all’inizio della guerra, attraversando cinque paesi prima di ricongiungersi infine con la sua famiglia in Australia. Ha portato con sé oltre sei anni di esperienza nel settore ICT, una profonda competenza tecnica e la determinazione a proseguire la sua carriera nel campo della tecnologia.

Come molti professionisti qualificati che ricominciano da capo in un nuovo paese, Viktor non si stava limitando ad adattarsi a un nuovo ambiente di lavoro. Stava acquisendo competenze nelle nuove tecnologie, comunicando in una seconda lingua e trovando il suo posto in un contesto professionale diverso.

Marcus Rolim, direttore generale dei servizi gestiti presso Perfekt e responsabile di Viktor, ne ha immediatamente intuito il potenziale.

«Il nostro programma di sviluppo ingegneristico è incentrato sulle persone», afferma Marcus. «Investiamo molto nel mentoring e nella creazione di opportunità per ingegneri provenienti da contesti diversi».

Nel corso degli anni, Perfekt ha accolto ingegneri provenienti da circa 10 paesi diversi. Anziché seguire un percorso formativo standard, l’azienda si concentra sui punti di forza di ciascuno, fornendo mentoring, esperienza pratica e supporto dove è più necessario.

Per Viktor, ciò ha significato consolidare le sue competenze esistenti acquisendo al contempo esperienza con Commvault Cloud e la resilienza informatica.

Man mano che lavorava con i clienti, Arlie – l’assistente AI di Commvault Cloud – è diventata una parte naturale del suo flusso di lavoro quotidiano. Che si trattasse di esplorare le funzionalità del prodotto, risolvere un problema o cercare indicazioni, Arlie lo aiutava a trovare rapidamente informazioni attendibili senza interrompere il suo lavoro.

Poi è arrivato un vantaggio inaspettato.

Poiché Arlie supporta più lingue, Viktor poteva approfondire concetti complessi nella sua lingua madre prima di passare all’inglese quando parlava con clienti o colleghi. Sebbene questo non fosse il caso d’uso originariamente previsto da Perfekt, è diventato rapidamente un prezioso vantaggio in termini di apprendimento.

“Quando un ingegnere può approfondire una questione complessa nella propria lingua, comprendere il ragionamento alla base della risposta e poi comunicarla chiaramente in inglese, l’esperienza di apprendimento cambia”, afferma Marcus. “Ciò permette alle sue capacità tecniche di emergere senza che la lingua diventi una barriera.”

Oggi Viktor è ingegnere di infrastruttura e protezione dei dati presso Perfekt, dove supporta i clienti continuando ad approfondire la sua competenza in materia di resilienza informatica.

Quando Viktor ha lasciato l’Ucraina, ha portato con sé anni di esperienza, una profonda competenza tecnica e una determinazione incrollabile a proseguire la carriera che aveva costruito con tanto impegno. Oggi aiuta le organizzazioni a rafforzare la loro resilienza informatica, attingendo alla stessa resilienza che lo ha aiutato a ricostruire la propria vita.

Forse è per questo che questa storia tocca il cuore. La resilienza di Viktor ha plasmato il suo futuro. Oggi lo aiuta a fare la differenza per gli altri. Ecco cosa significa mettere le persone al primo posto: organizzazioni come Perfekt che investono nelle persone e tecnologie come Commvault Cloud che le aiutano a prosperare. Chris DiRado è responsabile dell’esperienza di prodotto presso Commvault.
More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

In che modo i responsabili della sicurezza possono proteggere i propri dati più sensibili?

La sicurezza dei dati e dell’IA consente alle organizzazioni di individuare, classificare e gestire l’accesso ai dati sensibili tra utenti, sistemi e soluzioni di intelligenza artificiale.

Punti di forza

I dati sono la linfa vitale delle aziende moderne, poiché aiutano a orientare le decisioni chiave e alimentano le iniziative di intelligenza artificiale. Dato il loro valore, è fondamentale conoscere e proteggere i propri dati.

  • Il 90% delle organizzazioni ha esposto dati sensibili nel cloud che possono essere individuati dall’IA. Ciò rende la visibilità sulle risorse di dati il primo e più critico passo per ridurre il rischio aziendale. 
  • Il 40% dei file caricati o condivisi con strumenti di IA generativa contiene informazioni di identificazione personale (PII) o dati relativi al settore delle carte di pagamento (PCI). Tale uso improprio dei dati sensibili comporta un rischio significativo per le organizzazioni in termini di violazioni della privacy e delle normative. 
  • L’individuazione e la classificazione dei dati costituiscono il fondamento di una sicurezza efficace, consentendo alle organizzazioni di identificare i dati sensibili in ambienti strutturati, semi-strutturati e non strutturati.
  • Un accesso eccessivamente permissivo rappresenta uno dei rischi più persistenti per le aziende moderne. Poiché utenti, applicazioni e account di servizio spesso mantengono un accesso non necessario ai dati sensibili, la “superficie di attacco” risulta ampliata.
  • Per proteggere l’intelligenza artificiale è necessario governare sia i dati di addestramento che le interazioni in fase di esecuzione. Le organizzazioni devono verificare che i dati sensibili non vengano esposti attraverso input, output o il comportamento dei modelli.
  • La conformità normativa dipende da solide basi in materia di dati. Una solida classificazione e una governance degli accessi consentono alle organizzazioni di applicare le politiche e dimostrare il controllo.

I dati sensibili circolano ormai tra cloud, applicazioni e flussi di lavoro basati sull’intelligenza artificiale senza una chiara visibilità, creando rischi di esposizione che i controlli di sicurezza tradizionali non sono in grado di affrontare da soli. Commvault Data and AI Security aiuta le organizzazioni a individuare e classificare i dati sensibili, a gestire gli accessi sia per le identità umane che per quelle delle macchine e a garantire la conformità alle normative GDPR, HIPAA e PCI DSS durante l’intero ciclo di vita dei dati.


Perché la divulgazione dei dati sensibili rappresenta la principale falla nella sicurezza?

I dati sono il carburante inestimabile che alimenta le aziende moderne. Per questo motivo, le organizzazioni hanno deciso di investire massicciamente in strumenti di sicurezza sofisticati.

Tuttavia, secondo il rapporto “2025 State of Data Security” di Varonis, il 90% delle organizzazioni presenta ancora dati sensibili esposti nel cloud. Analogamente, l’88% delle organizzazioni ha utenti fantasma inattivi ma ancora abilitati.

Ma non è tutto. Secondo il rapporto di IBM del 2025 sul costo delle violazioni dei dati, il 53% delle organizzazioni vittime di violazioni ha segnalato la compromissione delle informazioni personali identificative (PII) dei clienti. Queste statistiche dipingono un quadro chiaro: sebbene i dati siano fondamentali per le aziende, la visibilità e la sicurezza complessiva rimangono questioni critiche. 

I dati non sono più limitati ai database strutturati. Sono presenti in file, e-mail, piattaforme cloud, applicazioni SaaS ed endpoint. Gran parte di essi è non strutturata, duplicata o non gestita, il che ne rende difficile il monitoraggio e la protezione.

L’intelligenza artificiale sta amplificando questo problema. Circa il 40% dei file caricati sugli strumenti di IA generativa contiene informazioni sensibili, spesso prive di governance o supervisione. Con la crescente diffusione dell’IA, aumenta anche il numero di sistemi e identità che interagiscono con i dati.

Senza una visione chiara di quali dati esistono e dove si trovano, le organizzazioni non possono proteggerli in modo efficace. Questa mancanza di visibilità è alla base del problema della sicurezza dei dati al giorno d’oggi.


Quali sono i pilastri della sicurezza dei dati e dell’IA?

Per affrontare la sfida rappresentata dall’esposizione dei dati, le organizzazioni necessitano di un approccio strutturato che garantisca coerenza e controllo nella gestione dei dati. La sicurezza dei dati e dell’IA si fonda su tre pilastri fondamentali: individuazione dei dati, classificazione dei dati e governance dell’accesso ai dati e all’IA.

Ciascun pilastro colma una lacuna significativa:

  • L’individuazione offre visibilità sulla posizione dei dati in tutti gli ambienti. Ciò include sistemi strutturati come i database, nonché fonti semi-strutturate e non strutturate che spesso vengono trascurate.
  • La classificazione aggiunge contesto identificando il tipo e la sensibilità dei dati. Consente alle organizzazioni di distinguere tra dati operativi, informazioni personali sensibili, documenti finanziari, proprietà intellettuale e altre categorie ad alto rischio.
  • La governance degli accessi consente alle organizzazioni di verificare che i dati vengano utilizzati in modo appropriato. Definisce chi o cosa può accedere ai dati, a quali condizioni e con quale livello di controllo.

Questi tre pilastri non esistono in modo indipendente. Essi creano un sistema interconnesso che copre interamente la sicurezza dei dati e dell’IA. L’individuazione identifica il panorama completo dei dati, la classificazione definisce il livello di sensibilità appropriato e la governance degli accessi applica il controllo in base a tale contesto.

Questo modello si estende anche oltre gli utenti umani per includere identità machine quali i modelli di IA. Negli ambienti moderni, queste identità non umane rappresentano spesso una parte significativa dell’attività di accesso ai dati. L’integrazione di questi pilastri può aiutare le organizzazioni a passare da controlli di sicurezza frammentati a un approccio unificato e basato su politiche.


In che modo le organizzazioni possono individuare e classificare i dati sensibili?

L’individuazione e la classificazione sono fondamentali per un modello di sicurezza dei dati efficace. Tuttavia, spesso sono le più difficili da implementare in modo efficace.

Ciò è dovuto al fatto che i moderni ambienti di dati sono altamente frammentati. Le informazioni sensibili sono distribuite su più piattaforme cloud, sistemi on-premise, applicazioni SaaS ed endpoint. Una parte significativa di questi dati è di natura non strutturata, il che ne complica l’identificazione e la categorizzazione.

Tra le sfide più rilevanti figurano:

  • Dati “ombra” che esistono all’insaputa degli amministratori, senza approvazione né controllo di sicurezza.
  • Formati non uniformi tra dati strutturati e non strutturati.
  • Rapida crescita dei dati dovuta all’adozione dell’intelligenza artificiale, che supera la capacità di classificazione manuale.

Per far fronte a questa situazione, le organizzazioni necessitano di capacità di individuazione scalabili e di framework di classificazione. Una corretta classificazione può attribuire un significato alle vaste quantità di dati esistenti. Ciò include in genere categorie quali le informazioni di identificazione personale (PII), le informazioni sanitarie protette (PHI), i dati PCI, la proprietà intellettuale, nonché chiavi e segreti.

Il valore della classificazione deriva dal modo in cui viene utilizzata. Una volta classificati i dati, le organizzazioni possono applicare efficacemente le politiche di conservazione e cancellazione, limitare o monitorare l’accesso e abilitare il mascheramento o la redazione dei campi sensibili.

Su larga scala, un approccio maturo all’individuazione e alla classificazione non si limita a garantire la copertura, ma contribuisce anche a produrre risultati significativi. Tra questi figurano una minore esposizione al rischio, una migliore applicazione delle politiche e una riduzione misurabile del rischio.


Quali sono i principali rischi legati a un accesso troppo permissivo?

Secondo una ricerca condotta da ReliaQuest, il 99% delle identità cloud dispone di privilegi eccessivi. Analogamente, uno studio del 2025 del Ponemon Institute evidenzia che il 61% delle aziende statunitensi ha subito violazioni dei dati da parte di personale interno negli ultimi due anni, con un costo medio di tali incidenti pari a ben 2,7 milioni di dollari.

Ciò dimostra che, anche quando le organizzazioni hanno una chiara comprensione dei propri dati, l’accesso rimane uno dei punti più deboli della sicurezza.

Si parla di accesso eccessivamente permissivo quando utenti, applicazioni o account di servizio dispongono di un accesso ai dati superiore a quello necessario. Si tratta di un problema molto diffuso, poiché i controlli di accesso vengono spesso concessi in modo generico per motivi di praticità e raramente rivisti.

L’impatto è significativo. Un accesso eccessivo aumenta la probabilità di esposizione accidentale, di rischi interni e di sfruttamento in caso di violazione.

Per affrontare questo problema, le organizzazioni devono innanzitutto esaminare attentamente i modelli di accesso. Ciò include individuare chi accede ai dati sensibili, quali sistemi o identità sono coinvolti e se tale accesso è in linea con le esigenze aziendali.

Particolare attenzione deve essere riservata agli account privilegiati e alle identità di servizio. Questi dispongono spesso di autorizzazioni estese e possono accedere a grandi volumi di dati sensibili su diversi sistemi.

In questo contesto, una governance efficace degli accessi è fondamentale. Ciò richiede:

  • Allineare le politiche di accesso alla classificazione dei dati.
  • Monitorare continuamente i modelli di utilizzo.
  • Identificare e correggere le deviazioni di accesso nel tempo.

Riducendo gli accessi non necessari, le organizzazioni contribuiscono a limitare la propria superficie di attacco e a migliorare la protezione complessiva dei dati.


In che modo le organizzazioni dovrebbero gestire i dati utilizzati dai sistemi di intelligenza artificiale?

L’adozione dell’IA si sta rapidamente diffondendo in ogni aspetto delle aziende moderne. Ciò introduce un nuovo livello di complessità nelle modalità di accesso, elaborazione e divulgazione dei dati.

I set di dati di addestramento spesso includono grandi volumi di dati provenienti da tutta l’organizzazione. Senza un’adeguata classificazione e governance, questi set di dati potrebbero contenere informazioni sensibili o soggette a normative.

Ciò comporta rischi in diverse fasi:

  • Durante la preparazione dei dati e l’addestramento.
  • Quando i modelli interagiscono con i dati in tempo reale.
  • Attraverso i risultati che potrebbero divulgare involontariamente informazioni sensibili.

Pertanto, la classificazione deve precedere l’addestramento del modello. Ciò significa convalidare e classificare tutti i dati utilizzati nei set di dati e rimuovere le informazioni sensibili quando necessario.

Allo stesso modo, dopo l’implementazione degli strumenti di IA, i team che si occupano dei dati devono valutare continuamente come i modelli utilizzano ed espongono i dati. Dovrebbero inoltre applicare meccanismi di controllo appropriati, come il mascheramento o la redazione, ove necessario.

I sistemi di IA non dovrebbero essere considerati separatamente dalla sicurezza dei dati. Essi rappresentano un’estensione delle modalità di utilizzo dei dati e devono essere gestiti di conseguenza. Integrando tali funzionalità di sicurezza dei dati e dell’IA nel più ampio ciclo di vita dello sviluppo dell’IA, le organizzazioni possono contribuire a ridurre i rischi pur continuando a favorire l’innovazione.


In che modo la classificazione dei dati favorisce la conformità normativa?

La conformità normativa dipende dalla capacità di identificare e controllare i dati sensibili. Normative quali il GDPR, l’HIPAA e il PCI DSS definiscono requisiti specifici su come i dati devono essere gestiti. Tuttavia, tali requisiti non possono essere applicati senza prima comprendere dove si trovano i dati soggetti a regolamentazione.

Ecco perché i programmi di conformità falliscono in assenza di una solida base di dati.

In questi casi, la classificazione dei dati funge da spina dorsale della conformità, mappando i dati alle categorie normative. Consente alle organizzazioni di applicare controlli mirati in base alla sensibilità dei dati e di far rispettare le politiche relative al ciclo di vita dei dati critici.

Ciò apre la strada a una miriade di funzionalità essenziali:

  • Applicazione delle politiche di conservazione e cancellazione
  • Limitazione dell’accesso ai dati soggetti a regolamentazione
  • Implementazione di controlli fondamentali sulla privacy

Inoltre, semplifica i processi di audit. Le organizzazioni possono dimostrare dove risiedono i dati sensibili, come sono protetti e chi vi ha accesso. La governance degli accessi rafforza ulteriormente la conformità garantendo che solo le identità autorizzate possano interagire con i dati regolamentati.

Insieme, la classificazione dei dati e i controlli di accesso ridefiniscono la conformità nell’era moderna, basata sull’intelligenza artificiale.


Conclusione: cosa richiede oggi una sicurezza efficace dei dati e dell’IA?

La sicurezza moderna dei dati e dell’IA non è più definita da difese perimetrali o controlli isolati. Richiede un approccio continuo e unificato che colleghi visibilità, classificazione e governance degli accessi lungo l’intero ciclo di vita dei dati.

Per dare vita a un approccio di questo tipo, le organizzazioni devono innanzitutto comprendere i propri dati, individuando con esattezza dove risiedono. Successivamente, devono controllare le modalità di accesso agli stessi. Infine, le organizzazioni devono assicurarsi che i sistemi di IA li utilizzino in modo responsabile. Queste funzionalità devono operare in sinergia, non in modo indipendente, per contribuire a ridurre l’esposizione e mantenere la fiducia.

Con l’aumento dei volumi di dati e l’accelerazione dell’adozione dell’IA, la sfida non consisterà più solo nel proteggere i dati, ma nel dimostrare dove si trovano i dati sensibili, chi può accedervi e come vengono protetti in tutti i sistemi. Chi adotterà un approccio strutturato e basato su politiche sarà in una posizione migliore per ridurre i rischi, soddisfare i requisiti normativi e promuovere l’innovazione con fiducia.

Domande frequenti

Che cos’è la sicurezza dei dati e dell’IA?

La sicurezza dei dati e dell’IA consiste nell’individuare, classificare e gestire l’accesso ai dati sensibili tra sistemi, utenti e modelli di IA. La soluzione Commvault Data and AI Security offre queste funzionalità in ambienti ibridi, consentendo alle organizzazioni di garantire che i dati rimangano visibili, controllati e protetti durante tutto il loro ciclo di vita, compreso il modo in cui vengono utilizzati nell’addestramento e nei risultati dell’IA.

Perché l’esposizione dei dati sensibili rappresenta un rischio significativo?

L’esposizione dei dati sensibili rappresenta un rischio significativo perché spesso le organizzazioni non dispongono di visibilità su dove risiedono i dati e su chi può accedervi, aumentando così la probabilità di violazioni, uso improprio e infrazioni normative. Commvault contribuisce a mitigare questo rischio attraverso un approccio unificato che combina individuazione dei dati, classificazione e governance degli accessi in ambienti ibridi.

Quali sono i pilastri fondamentali della sicurezza dei dati?

I tre pilastri fondamentali della sicurezza dei dati sono l’individuazione, la classificazione e la governance degli accessi. Commvault garantisce ciascuno di essi: l’individuazione dei dati identifica dove si trovano i dati sensibili in tutti gli ambienti, la classificazione dei dati ne definisce la sensibilità e il tipo, mentre la governance degli accessi ai dati e all’IA applica un controllo degli accessi in linea con le politiche aziendali e normative.

Perché un accesso troppo permissivo è pericoloso?

Un accesso troppo permissivo consente a utenti, applicazioni e account di servizio di accedere a più dati del necessario, aumentando il rischio di esposizione accidentale, minacce interne e sfruttamento. La governance degli accessi ai dati e all’IA di Commvault affronta questo problema monitorando continuamente i modelli di accesso, allineando le autorizzazioni alla classificazione dei dati e identificando e correggendo le deviazioni di accesso negli ambienti ibridi.

In che modo le organizzazioni dovrebbero contribuire a proteggere i dati utilizzati dall’IA?

Le organizzazioni possono proteggere i dati dell’IA classificando i set di dati prima dell’addestramento e monitorando continuamente il modo in cui i modelli accedono ai dati e li espongono. Commvault Data and AI Security supporta questo processo attraverso controlli di individuazione, classificazione e governance, tra cui mascheramento, oscuramento e restrizioni di accesso, contribuendo a garantire che i dati sensibili non vengano esposti attraverso l’addestramento dell’IA, il comportamento dei modelli o i risultati.

In che modo la classificazione dei dati contribuisce alla conformità?

La classificazione dei dati favorisce la conformità identificando i dati soggetti a regolamentazione, come le informazioni di identificazione personale (PII), e associandoli ai controlli appropriati. Commvault Data Classification aiuta le organizzazioni ad applicare politiche di conservazione e cancellazione in linea con il GDPR, l’HIPAA e lo standard PCI DSS, fornendo inoltre le prove pronte per l’audit necessarie a dimostrare come i dati sensibili vengono identificati, protetti e gestiti.

Esplora le risorse correlate

Esplora

Quali sono i rischi principali legati alla sicurezza dei dati e dell’IA?

Scopri come l’IA introduce nuove vulnerabilità dei dati – dall’addestramento dei modelli all’esposizione ai rischi di runtime – e le pratiche a più livelli che le organizzazioni utilizzano per gestire i carichi di lavoro in modo responsabile.
Leggi l’articolo su “Quali sono i rischi chiave per la sicurezza dei dati e dell’IA?”
Libro bianco

Analisi dei rischi di sicurezza legati all’IA

Un rapporto di valutazione della Readiness destinato al tuo CISO e al tuo CIO per comprendere cosa è cambiato con MCP 2.0 e cosa fare per preparare la tua organizzazione.
Leggi il white paper sull’analisi dei rischi di sicurezza dell’IA


Punti di forza

  • Sostituire le affermazioni soggettive sulla “facilità d’uso” con un indice misurabile di protezione dei dati: capacità protetta divisa per il numero di amministratori a tempo pieno.
  • La misurazione della capacità protetta per FTE offre una visione più significativa dell’efficienza operativa rispetto alle metriche tradizionali, come i processi di backup per amministratore.
  • L’indice di protezione dei dati dovrebbe essere utilizzato come valore di riferimento prima della migrazione della piattaforma e misurato nuovamente in seguito per verificare i miglioramenti operativi.
  • Fattori quali gli ambienti multi-cloud, i requisiti di cyber-Recovery e gli obblighi di conformità possono influenzare il rapporto, pertanto esso dovrebbe essere valutato nel contesto di ciascun ambiente.
  • Le organizzazioni dovrebbero chiedere ai fornitori di impegnarsi a garantire risultati operativi misurabili, anziché affidarsi a affermazioni qualitative sulla semplicità.

Ogni valutazione di fornitori a cui ho partecipato finisce per arrivare allo stesso vicolo cieco. Da una parte si sostiene che la piattaforma sia semplice da gestire. Dall’altra si afferma che la propria piattaforma sia ancora più semplice.

Nessuno è in grado di dimostrare nessuna delle due affermazioni, quindi la conversazione si sposta sulla demo, sulla chiamata di riferimento, sull’impressione istintiva che si percepisce nella stanza. Non è così che si dovrebbe prendere una decisione che determinerà come il proprio team trascorrerà i prossimi cinque anni.

Ho gestito ambienti di protezione dei dati in produzione. Ho visto team sommersi da strumenti frammentati che promettevano automazione e invece generavano solo ticket.

La “riduzione della complessità” non è una sensazione che dovreste accettare per fede. È qualcosa che dovreste essere in grado di calcolare.

La metrica che mancava al settore

Abbiamo iniziato a utilizzare internamente e con i clienti un semplice rapporto: la capacità totale protetta divisa per il numero di dipendenti a tempo pieno necessari per gestirla. Lo chiamiamo «rapporto di leva della protezione dei dati».

Capacità protetta (PB) / FTE = Rapporto di leva della protezione dei dati

Tutto qui. Nessuna domanda di sondaggio sulla soddisfazione. Nessun aggettivo. Un numero, calcolato dai dati che già possedete.

Ecco perché è più importante delle metriche che sostituisce. Calcolare il numero di processi di backup per persona aveva senso un decennio fa, quando un processo rappresentava un’unità discreta di lavoro manuale. Non riflette il modo in cui operano oggi le piattaforme moderne, dove l’automazione si fa carico del lavoro di routine e un singolo amministratore può essere responsabile di petabyte, non del numero di processi.
Misurare i processi per persona in un ambiente automatizzato non dice nulla sul fatto che l’automazione funzioni effettivamente.

Come funziona nella pratica

Una precisazione prima di passare ai numeri, perché spesso crea confusione. Per “capacità protetta” si intende la dimensione totale, non compressa e non deduplicata, delle applicazioni protette, non lo spazio fisico occupato sul disco.

Questa distinzione è importante perché è il punto centrale. L’ambiente di produzione di Commvault protegge 42,39 PB di dati applicativi su 9,26 PB di disco fisico, con un risparmio di spazio dell’81,91% grazie alla deduplicazione e alla compressione.

Il rapporto non è solo una misura di quanti petabyte una persona può gestire. È una misura di quanto l’architettura stia svolgendo il lavoro prima ancora che il numero di dipendenti entri in gioco.

Tenendo presente questo: Commvault gestisce il proprio ambiente di backup di produzione su 42,39 PB di capacità protetta con due FTE. Si tratta di un rapporto di 21,20 PB per FTE. I benchmark di settore per le piattaforme moderne si attestano in genere tra i 5 e i 25 PB per FTE, a seconda della complessità dell’ambiente, quindi tale cifra si colloca nella fascia alta di ciò che è oggi realizzabile.

Metrica  Valore  Definizione 
Capacità protetta (front-end)  42,39 PB  Dimensione completa, non compressa e non deduplicata dell’applicazione protetta nel nostro ambiente 
Capacità totale del disco  9,26 PB  Archiviazione fisica di destinazione 
Spazio totale utilizzato  7,89 PB  Utilizzo attuale 
Dati totali scritti  7,67 PB  Dati logici scritti su disco 
Risparmio di spazio  81,91%  Efficienza di deduplicazione e compressione 
FTE dedicati alla protezione dei dati  2  Numero di amministratori a tempo pieno che gestiscono l’infrastruttura di backup di produzione di Commvault 

Rapporto di efficienza della protezione dei dati = 42,39 PB / 2 FTE = 21,20 PB per FTE

Voglio essere chiaro su ciò che questo numero non tiene in considerazione. Non tiene conto di un’infrastruttura multi-cloud, dei requisiti di cyber-Recovery o di un mix di applicazioni con elevati requisiti di conformità, tutti fattori che abbasserebbero il rapporto per ragioni che non hanno nulla a che vedere con la qualità della piattaforma.

Un rapporto considerato isolatamente non è un verdetto. Lo è invece un rapporto misurato prima e dopo una migrazione.

Questo è il caso d’uso reale. Stabilite una linea di base del vostro ambiente attuale con gli strumenti di cui disponete. Fissate un rapporto obiettivo in base alle vostre proiezioni di crescita e alla capacità del vostro team. Quindi esigete che il vostro fornitore lo rispetti una volta completata l’implementazione, non solo durante il ciclo di vendita.

Le implicazioni a livello di consiglio di amministrazione

Se siete voi a dare l’approvazione per la migrazione a una nuova piattaforma, non vi viene semplicemente chiesto di fidarvi che la nuova piattaforma sia più facile da gestire. Vi viene chiesto di finanziare un risultato operativo specifico. Un obiettivo relativo al rapporto di protezione dei dati vi offre un modo per inserire tale risultato nel business case e verificarlo 12 mesi dopo.

Si tratta della stessa disciplina che applichiamo al tempo medio di recupero pulito (MTCR). La capacità di recupero non è qualcosa che si dichiara, ma qualcosa che si misura e si rimisura finché il dato non riflette la realtà. L’efficienza operativa merita lo stesso standard.

La sfida

Chiedete al vostro attuale fornitore qual è oggi il rapporto di efficienza del vostro ambiente. Se non è in grado di fornirvelo, questo vi dice qualcosa su quanto bene comprenda cosa significhi “semplice da gestire” per il vostro team.

E se state valutando una nuova piattaforma, non accettate “più facile da usare” come risposta. Chiedete a quale rapporto si impegneranno a raggiungere e chiedetelo di nuovo dopo il primo anno.

Domande frequenti

D: Che cos’è il rapporto di gestione della protezione dei dati?

R: Il rapporto di protezione dei dati misura la quantità di capacità di dati protetti gestita da ciascun amministratore a tempo pieno. Fornisce un modo oggettivo per valutare l’efficienza operativa, anziché affidarsi a impressioni soggettive sull’usabilità della piattaforma.

D: Perché questa metrica è più utile rispetto al numero di processi di backup per amministratore?

R: Le moderne piattaforme di protezione dei dati automatizzano gran parte del lavoro di routine che in precedenza richiedeva un intervento manuale. Di conseguenza, il conteggio dei processi di backup non riflette più il reale carico di lavoro né l’efficienza di un team operativo.

D: Cosa si intende per “capacità protetta” in questo calcolo?

R: Per “capacità protetta” si intende la dimensione completa, non compressa e non deduplicata dei dati delle applicazioni protetti. Questa misura riflette il carico di lavoro effettivo gestito dalla piattaforma, anziché lo spazio di archiviazione fisico consumato dopo l’ottimizzazione.

D: Un rapporto di gearing più elevato indica sempre una piattaforma migliore?

R: Non necessariamente. La complessità dell’ambiente, comprese le implementazioni multi-cloud, i requisiti di resilienza informatica e gli obblighi normativi, può ridurre il rapporto anche quando la piattaforma offre buone prestazioni. La metrica è particolarmente utile quando si confronta lo stesso ambiente prima e dopo una migrazione.

D: In che modo le organizzazioni dovrebbero utilizzare il rapporto di gearing della protezione dei dati durante la valutazione dei fornitori?

R: Le organizzazioni dovrebbero stabilire una linea di base utilizzando il proprio ambiente attuale, definire un rapporto target in linea con la crescita futura e chiedere ai fornitori di impegnarsi a ottenere miglioramenti misurabili dopo l’implementazione. Questo approccio sposta il focus dalle affermazioni di marketing a risultati aziendali verificabili.

D: Qual è il valore aziendale più ampio di questa metrica?

R: Il rapporto di protezione dei dati consente ai dirigenti di quantificare i guadagni attesi in termini di efficienza operativa e di includerli nel business case relativo a un investimento in una piattaforma. Fornisce inoltre un punto di riferimento che può essere rivisto dopo l’implementazione per confermare che i risultati promessi siano stati raggiunti.

Rajiv Kottomtharayil è Chief Products Officer presso Commvault.

More related posts


Thumbnail_Blog-What-is-Resops-2026

What Is ResOps – and Why Cyber Resilience Needs It

Read more about What Is ResOps – and Why Cyber Resilience Needs It
Thumbnail_Blog-Playbook-2026

Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago

Read more about Prove It Before You Need It: The Playbook I Wish I’d Had 10 Years Ago
Thumbnail_Blog-Medusa-is-Evolving-2026

Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.

Read more about Medusa Is Evolving. Cyber Resilience, Cyber Recovery, and ResOps Matter More Than Ever.