The news cycle has been dominated with coverage about the risks of AI – from agents gone rogue to a public outcry to slow and regulate its progress.Collectively, these stories say something important about wSaiba mais no SHIFT 2025 AI risk is actually headed.In September 2026 alone:
Anthropic published an alignment assessment describing a fourth incident in which a Claude model reached a real third-party system during what was supposed to be a sandboxed cybersecurity evaluation, using terms such as “recklessness” and “biased reasoning” to describe the models’ behavior.
It is tempting to file these stories under “frontier lab problem” and move on.I think that is the wrong read.Enterprises don’t often have the luxury of waiting for industry and regulators to slow growth, never mind if and when they do.Cyber risk from agents is already inside most environments, and policy timelines may not change how fast it moves.
The threat vectors are not new.A malicious package.A misconfigured environment.A credential exposed longer than it should have been.Most CISOs have been managing these risks for years.With AI, what’s changed is scale and visibility: thousands of agents acting continuously, coordinating in ways no one anticipated or witnessed.
Case in point: Due to the enormous scale of the OpenAI/RubyGems incident, it took specialized researchers months to reconstruct.What enterprise can withstand that much time passing between incident and understanding?
Many signs predict further proliferation, not less.In fact,IDC predicts that by 2029, the number of agents deployed in production environments will exceed 1 billion and that by 2027, more than 40% of enterprise application capabilities will be enhanced by agentic automation.
What ‘AI-Ready’ Cyber Resilience Actually Requires
Commvault stands firm that resilience only counts if the recovery is clean.A restore that brings back a compromised file, a corrupted dataset, or a still-infected agent identity is not resilience – it’s a second incident.That premise did not change when agentic AI arrived.It became more important.That’s why we built our AI resilience capabilities with the following in mind:Resilience must operate at machine speed.Rapidly evolving AI capabilities are increasing the speed of attacks.De acordo comCrowdStrike’s 2026 Global Threat Report, breakout time – the window between an attacker’s first access and their first move deeper into the network – is 29 minutes, down from 48 minutes the year before.To say that recovery requires direct and immediate response to data security signals is an understatement.Otherwise, business-as-usual routing via through manual approvals can meanthe threat keeps advancing. Depth across every system and environment.Agents are indiscriminate in wSaiba mais no SHIFT 2025 and what they chose to exploit and attack, whether that’s a public code registry, data center or SaaS environment.Coverage should span structured and unstructured data, SaaS applications, and infrastructure alike, as well as cloud, edge, on-premises, and hybrid environments. Identity resilience extends beyond people.With non-human identities outnumbering humans144 para 1, governance is re-emerging as a modern-day challenge.When the blast radius of an attack can expand in seconds, effective data security teams must understand not only what changed and who changed it, but when an alert meritsa recovery action.
The greatest AI risk is not confined to frontier labs.For enterprises, resilience must be treated as foundational before the scale of agentic activity makes the risk impossible to contain.That responsibility sits with the enterprise.
Learn more about how Commvault Cloud can help you build resilience in your AI stackSaiba mais no SHIFT 2025.
Sankalp Damaniis Senior Director, Product Management, at Commvault.
Everywhere you go you hear the same story. AI changed everything, attackers are faster, and governance matters. This is a narrative that 50 other CISOs could deliver.
After 20 years in cybersecurity, I have the benefit of perspective. I’ve lived through major shifts in technology: the internet, mobile, cloud … and more. To me, the interesting story is what is fundamentally different about AI vs. every other technology transition.
AI didn’t replace the CISO’s mission. Yes, it changed the speed, but good security has always been about being the team that doesn’t just protect technology but also helps enable the company to win in the market in which it competes. Just like with the internet, mobile, and cloud, confirming the company uses AI well is table stakes.
1. What my job looked like a year ago
A year ago, my priorities would have been very recognizable to any CISO: ransomware, identity, vulnerability management, third-party risk, cloud security, data protection, resilience. AI was on the agenda, but largely as an emerging technology risk. Today, it’s becoming part of almost every one of those conversations.
Last year’s world wasn’t simple. We had to protect identities, systems, applications, infrastructure and data. And now, all of those remain, but you’re dealing with systems that can consume huge amounts of information, generate new information, make recommendations, write software, automate workflows, and increasingly act on behalf of people. The old problems didn’t disappear. AI landed and sped up the clock of the existing security stack.
2. What changed, and why it wasn’t gradual
The biggest inflection point is the collapse in the cost of capability. An attacker no longer needs the same skills and time investment. Previously they’d have to invest countless hours in their coding ability or content-production effort to operate at scale and countless hours to identify and hone targets. At the same time, my own employees suddenly have powerful tools that can ingest corporate information and produce code, analysis, and content.
So, we have two simultaneous accelerations. What changed wasn’t simply that attackers got AI. Everyone got AI. And adoption happened from the bottom up. Employees didn’t wait for the enterprise AI strategy. Developers started using copilots. People experimented with public LLMs. Business functions discovered automation opportunities.
For most major enterprise technologies, security had some opportunity to prepare the environment before widespread adoption. With generative AI, adoption often arrived before governance.
3. How the mission itself changed
Historically, security asked: How do we protect this technology? But AI forces another question: How do we allow the company to use this technology safely?
That brings CISOs into questions that aren’t purely cybersecurity:
What information can employees provide to AI systems?
Which models and services are approved?
What happens to prompts and uploaded data?
Where is corporate data retained?
How do we manage AI identities, agents, and permissions?
How do we validate AI-generated code?
What human oversight is required?
How do legal, privacy, security, data governance, and compliance responsibilities intersect?
That said, CISOs need to be careful they don’t become Luddites, or the AI Police. The CISO role is helping define the security boundaries within which the company can move quickly. If the security strategy for AI is simply “don’t use it,” you’ve already lost. People will use it. Our job is to make the secure path the easiest path.
4. What I had to relearn or unlearn
One thing I’ve had to unlearn is the idea that security gets to fully understand a technology before the enterprise adopts it. With AI, adoption and experimentation are happening simultaneously with our understanding of the risks. We have to allow smart and thoughtful adoption.
Another is determinism. Security professionals grew up evaluating systems where, broadly speaking, Input A should produce Output B. Generative systems don’t behave that neatly. We’re accustomed to asking whether a control works. AI forces us to become more comfortable asking how reliably it works, under what conditions it fails, and what happens when it does. That’s intellectually interesting.
Twenty years in security teaches you pattern recognition. Now, AI reminds me that pattern recognition can become a liability when the underlying assumptions change.
Early on I assumed the principal problem would be malicious use of AI externally against us. But quickly I discovered that my biggest impact would be spent internally on data governance, internal adoption, and business enablement.
5. What’s next/advice for peers First, don’t create a separate AI-security universe. Map AI into the controls you already understand: identity, data classification, least privilege, logging, third-party risk, secure development, incident response, and resilience. Second, pay close attention to agents. Today’s dominant interaction is often human → model → response. The more consequential architecture is increasingly: human → agent → tools → systems → data → actions. Once AI can take actions (rather than merely generate text), authorization, identity, provenance, monitoring, and blast radius become much more important. I’m less worried about an AI saying the wrong thing than I am about an AI agent being authorized to do the wrong thing. Third, protect the data layer.Models will change quickly. Vendors will change. Architectures will change. Today’s biggest AI company and hippest frontier model will be Betamax soon. Your durable security assets remain knowing what data you have, where it is, who can access it, and what they’re allowed to do with it. Fourth, don’t measure success by how much AI you block.A sophisticated security organization should enable legitimate adoption while constraining unacceptable risk. Every major technology shift creates a period where capability moves faster than control. The internet did it. Mobile did it. Cloud did it. AI is doing it at extraordinary speed.
Handling this well doesn’t require eliminating AI risk altogether. It requires deciding deliberately which risks you’re willing to take, putting boundaries around them, and still allowing the business to move.
AI hasn’t repealed the fundamentals of cybersecurity, but it is changing the economics and velocity around them. After 20 years of successive security transformations, AI may be the first one where the CISO must simultaneously defend against the technology, protect the technology, and help the business adopt the technology. That’s what makes it a challenge.
For years, resilience conversations have centered on technology. Do you have backups? Do you have a disaster recovery plan? Do you have protections in place to prevent an attack?
Those remain important questions. But increasingly, they’re not the ones I’m hearing from executives.
Instead, I’m hearing a much simpler question: If we experience a cyberattack tomorrow, can we come back from it, and can we prove it?
NewIDC research, based on a survey of 539 IT and resilience decision makers across the U.S. and Canada, reveals a growing reality: Having recovery technology doesn’t automatically make an organization recovery ready.
Recently, I joined Jason Cray from Commvault’s Product Experience team to discuss that research from IDC. What emerged from our conversation wasn’t simply a discussion about backup, recovery, or cyber resilience.
It was a discussion about confidence. More specifically, why so many organizations believe they’re recoverable, but struggle to prove they’re actually recovery ready.
The difference between being recoverable and recovery ready is like the difference between theory and proof.
IDC found that 57.7% of organizations have not fully defined their minimum viable business. If you don’t know what you need to recover, how can you prioritize what needs to come back up first?
Recovering everything is not a viable strategy. Successful recovery depends on prioritization and business context.
Cyber recovery requires a team approach to be successful.
The fundamental difference between cyber recovery and disaster recovery is the need for trust.
Speed may not be the best measure of recovery, especially if you can’t trust your backups.
Organizations build confidence through testing, not planning alone.
ResOps provides a framework for turning resilience into an operational discipline.
What’s the Difference Between Being Recoverable and Being Recovery Ready?
A few years ago, many resilience discussions ended with a checklist.
Backups? Check.
Recovery plan? Check.
Disaster recovery testing? Check.
Today, that level of assurance is no longer enough.
During the webinar, Jason shared a perspective I hear frequently from customers: Organizations can usually tell you exactly how much they invest in security and protection technologies, but far fewer can confidently explain how they would recover if those controls failed.
The distinction may sound subtle, but it’s important.
Being recoverable means you have mechanisms in place that could support recovery. Being recovery-ready means you’ve demonstrated those mechanisms can successfully restore critical business operations under real-world conditions.
As resilience becomes a board-level concern, assumptions are giving way to evidence. Leaders want confidence that recovery plans will actually work when the pressure is at its highest.
When the Chips Are Down, Does Your Organization Know What Matters Most?
One of the most striking findings from theIDC researchis that57.7% of organizations have not fully defined their minimum viable business.
A minimum viable business isn’t simply a list of critical applications. It’s the combination of people, processes, systems, and data required to keep the organization functioning during disruption. It answers a critical question:What absolutely must come back first?
This is where many recovery strategies begin to fall apart.
I’ve worked with organizations that understand which applications are important but haven’t mapped the dependencies supporting them. Others continue treating nearly every workload as mission critical. While that approach might seem prudent, it creates a practical problem during recovery.
When Everything Is Critical, Nothing Is
Recovery takes time. Infrastructure has limits. Dependencies matter.
Organizations cannot realistically expect to recover an entire multi-petabyte environment immediately following a large-scale cyber event. Prioritization becomes essential.
The organizations that recover most effectively tend to know exactly what must come back first, what can wait, and what business outcomes depend on those decisions. That’s what defining a minimum viable business enables.
Sneak Peek: Recovery Readiness Webinar
One of the themes Jason and I explored throughout the webinar is the fact that cyber resilience is a shared responsibility. There’s a disconnect in many organizations that recovery readiness is an infrastructure challenge. It is not; it’s an organizational challenge. It requires alignment across security, IT, legal, communications, and business teams to confirm critical applications, processes, and recovery priorities are clearly understood before disruption occurs.
Recovery Plans Fail in Silos
Many organizations still approach resilience through disconnected teams. Infrastructure teams focus on systems. Security teams focus on threats. Business leaders focus on continuity. Legal and communications teams often become involved only after an incident occurs.
The problemis thatdisruptions don’t respect organizational boundaries.
Successful recovery depends on coordinated decision-making across all of those functions. Recovery priorities, customer communications, business operations, legal obligations, and technical restoration efforts must all work together in real time.
One customer recently described their resilience planning efforts as building a team of superheroes. While they meant it jokingly, it perfectly captured the reality of modern recovery readiness. Organizations recover as teams, not technologies.
Why Cyber Recovery Is Fundamentally Different From Disaster Recovery
One misconception we discussed during the webinar is the belief that traditional disaster recovery plans can simply be adapted for cyber recovery.
In reality, they solve different problems.
Traditional disaster recovery was often built around predictable failure scenarios. A site outage. Infrastructure failure. A known disruption that triggered a documented response. Cyber events are fundamentally different.
Organizations must determine what systems have been compromised, what data can be trusted, and whether recovery actions could inadvertently reintroduce risk. The challenge isn’t simply restoration. It’s validation.
You can’t restore what you can’t trust. That uncertainty creates a very different recovery process.
If organizations restore compromised systems or infected data, they risk bringing the problem back into production. As attacks continue to grow in sophistication, validating the integrity of recovered environments becomes increasingly important.
Recovery is no longer just about bringing systems online. It’s about restoring trust.
Why Trust Matters More Than Speed: A Fast Recovery Can Still Be a Failed Recovery
That brings us to one of the most important points from our discussion. For years, recovery success was largely measured by speed.
How quickly can systems be restored?
How quickly can operations resume?
Those questions still matter. But speed alone is no longer enough.
A recovery that reintroduces malware, compromised identities, or untrusted data into production isn’t truly successful. That’s why more organizations are investing in isolated recovery environments, validation exercises, and recovery testing designed to verify the integrity of recovered assets before they return to production.
Recovering quickly only matters if you’re recovering something you can trust.
MTCR: The NewMeasure of Recovery Confidence
As organizations rethink how they measure resilience, many are moving beyond traditional recovery time objectives (RTOs) and recovery point objectives (RPOs).
Instead, they’re focusing on mean time to clean recovery (MTCR).
What makes MTCR valuableis thatit reflects the realities of modern cyber recovery. It’s not just about how quickly an organization restores data. It includes the time required to validate, assess, and confidently return systems to production.
That distinction matters because organizations don’t simply recover infrastructure. They recover business operations. MTCR better reflects how quickly the organization can safely return to a trusted operating state.
Confidence Comes From Testing
If there’s one lesson I’ve learned from working with organizations across various stages of resilience maturity, it’s this: Confidence doesn’t come from documentation.
Confidence comes from testing.
Static recovery exercises often validate known processes under ideal conditions. Real-world disruptions are rarely that predictable.
Recovery-ready organizations test continuously. They simulate realistic conditions. They introduce uncertainty. They identify dependencies. They uncover weaknesses before attackers do.
Most importantly, they build organizational muscle memory.
During the webinar, Jason shared a perspective I’ve always found compelling: Organizations can choose to figure things out during a period of stability, or they can try to figure them out in the middle of a crisis. The better option is obvious.
Testing doesn’t simply validate technology. It validates people, processes, communications, priorities, and assumptions. And that’s where real confidence is built.
ResOps Is What Happens When Recovery Becomes an Operational Discipline
Throughout our discussion, nearly every challenge we identified pointed back to the same need: Organizations need a way to consistently define priorities, align stakeholders, validate recoverability, and improve over time.
That’s exactly why resilience operations, or ResOps, is gaining momentum.
ResOps isn’t about introducing another tool or process. It’s about operationalizing resilience. It brings together people, process, and technology under a common framework for continuous validation and improvement.
Because ultimately, recovery readiness isn’t a project. It’s a discipline.
The organizations that will differentiate themselves in the years ahead won’t simply be the ones with recovery technologies or documented plans. They’ll be the organizations that can demonstrate those plans work:
They’ll know what matters most.
They’ll understand how to recover it.
They’ll validate that it’s safe to recover without risk of reinfection
And they’ll have evidence to prove it.
In other words, they won’t just be recoverable. They’ll be recovery-ready.
Saiba mais
The IDC report also found that overall organizational resilience among the organizations surveyed is impaired both by gaps in individual technologies and by the absence of a coordinating framework that brings business, infrastructure, and security functions together around a shared recovery objective.
Q: What is ResOps?R:ResOps (resilience operations) is an operational discipline that helps organizations continuously validate and improve their ability to recover from disruption. It brings together people, processes, and technology to make recovery readiness measurable and provable. Q: What is a minimum viable business?R:A minimum viable business is the combination of systems, processes, people, and data required to continue operating during a disruption. It helps organizations prioritize recovery efforts when everything cannot be restored simultaneously. Q: Why is cyber recovery different from disaster recovery?R:Traditional disaster recovery assumes predictable failure scenarios. Because the nature of cyber attacks is unpredictable, cyber recovery requires organizations to change their focus to determining what systems can be trusted, validating recovered data, and ensuring threats are not reintroduced into production environments.P: O que é o tempo médio de recuperação após a limpeza (MTCR)?R:MTCR measures how long it takes an organization to recover to a verified, trusted operational state. It incorporates recovery, validation, and confidence-building activities rather than focusing solely on restoration speed.Q: Why does recovery testing matter?R:Testing helps organizations uncover hidden dependencies, validate assumptions, build muscle memory, and improve recovery processes before a real disruption occurs. Recovery confidence is earned through practice, not paperwork. Q: Why is identity resilience important?R:Identity systems play a foundational role in recovery. If users cannot access production systems, recovery environments, or critical data, even the best recovery plans may be difficult to execute successfully. Q: How can organizations measure recovery readiness?R:Organizations can begin by defining their minimum viable business, testing recovery processes regularly, validating recovered environments, and measuring outcomes using metrics such as mean time to clean recovery (MTCR).
Vidya Shankarané diretora de tecnologia de campo da Commvault.
Recovery time objective (RTO) is the maximum duration of time a business process or application can remain offline after a disruption before the impact becomes unacceptable. In practice, your RTO answers a direct question: how fast must you recover?
That question carries significant financial weight. According to Siemens and Splunk’s 2024 True Cost of Downtime report, unplanned downtime costs the world’s 500 biggest companies $1.4 trillion annually. Whether the cause is ransomware, a misconfigured update, or a regional cloud outage, every minute of inactivity chips away at revenue, customer trust, and regulatory standing.
Recovery time objective is not a single, universal number. It varies by workload, by business unit, and by the consequences of being offline. A payment processing system demands a far shorter RTO than an internal development environment. Getting this right requires deliberate analysis — not guesswork — and it is a core component of disaster recovery planning.
This guide breaks down what RTO means, how it differs from RPO, how to calculate and tier your targets, and what you can do to help meet them consistently.
Downtime Tolerance
Recovery time objective is a disaster recovery metric that defines the maximum tolerable period between a disruption and full restoration of a system or business process. It covers every phase of recovery: detection, decision-making, failover execution, data validation, and service confirmation.
The National Institute of Standards and Technology (NIST) defines RTO as “the overall length of time an information system’s components can be in the recovery phase before negatively impacting the organization’s mission” (NIST Glossary). NIST’s Cybersecurity Framework 2.0 reinforces RTO through its RECOVER function, which calls on organizations to execute recovery plans within established time objectives.
RTO is expressed in units of time – minutes, hours, or days – and is set before a disruption occurs, not during one. It is a planning metric. Your actual recovery time should consistently come in under the RTO you define; if it does not, you have a gap that puts the business at risk.
According to Splunk and Oxford Economics’ The Hidden Costs of Downtime, Global 2000 companies lose an average of $49 million per year from downtime. That figure makes the case for treating RTO as a core business metric, not just an IT exercise. When leadership understands what downtime costs per hour, setting and funding appropriate RTOs becomes a straightforward conversation.
RTO vs. RPO
RTO and RPO are companion metrics, but they measure different risks. RTO addresses the question “how long can we be down?” RPO addresses “how much data can we lose?”
Recovery point objective (RPO) defines the maximum age of data that must be recovered after an outage. An RPO of one hour means you can tolerate losing up to one hour of transactions. An RPO of zero means no data loss is acceptable – requiring synchronous replication or continuous data protection.
Métrico
RTO
RPO
Definição
Maximum acceptable downtime after a disruption
Maximum acceptable data loss measured in time
Focus
Speed of recovery
Frequency of backups or replication
Measurement
Time from failure to full restoration
Time between the last good backup and the failure
Exemplo
2-hour RTO: systems must be operational within 2 hours
1-hour RPO: you can lose at most 1 hour of data
According to the Uptime Institute’s 2024 Annual Outage Analysis, 55% of outages lasted more than two hours – suggesting many organizations still have a meaningful gap between their stated RTO and their actual recovery capability. Defining both RTO and RPO together helps you plan for speed and data integrity simultaneously.
Calculate RTO
Calculating RTO is not a formula you plug numbers into. It is a structured assessment that connects technical capability to business tolerance. Here is how to approach it — and once you have your targets, you can optimize your recovery time objectiveover time.
Conduct a business impact analysis (BIA).
Identify every critical application and process. For each one, quantify what downtime costs – lost revenue, regulatory penalties, customer churn, reputational damage. According to ITIC’s 2024 Hourly Cost of Downtime survey, over 90% of enterprises estimate downtime costs exceed $300,000 per hour for mission-critical applications.
Identify and rank critical systems.
Not every workload has the same urgency. Group applications by business function: revenue-generating, customer-facing, internal operations, and development or archival. Assign a priority tier to each group.
Assess current recovery capabilities.
Document how long each system actually takes to recover today. Include detection time, notification and escalation, infrastructure provisioning, data restoration, validation, and user reconnection. Your current recovery time is your baseline.
Set tiered RTOs based on risk tolerance.
Match each priority tier to an RTO that the business can fund and the IT team can deliver. Compare your baseline recovery times against these targets. Any gap between current capability and target RTO is a problem to solve with architecture, automation, or a better DR platform.
This process – BIA, ranking, assessment, tiering – gives you defensible, data-driven RTOs rather than arbitrary numbers.
RTO Tiers
Not every system warrants the same recovery investment. Tiered RTOs let you direct budget and engineering effort where the business impact is greatest.
According to ITIC’s 2024 research, over 90% of enterprises estimate downtime costs exceed $300,000 per hour. For Tier 1 systems, even brief outages generate six-figure losses. Tier 3 systems, by contrast, can tolerate a full business day offline without material impact.
The value of tiering is focus. You invest in sub-hour recovery for payment processing and ERP, while giving archive systems a 24-hour window that costs far less to maintain. This approach keeps disaster recovery budgets efficient without leaving critical systems exposed.
Improve RTO
Setting an RTO is only useful if you can actually hit it. Here are the strategies that consistently reduce recovery time.
Adopt cloud-based disaster recovery. Cloud DR helps eliminate the need to maintain idle standby hardware. On-demand infrastructure lets you spin up recovery environments in minutes, not hours. According to the Uptime Institute’s Annual Outage Analysis 2025, organizations that have adopted cloud-based DReautomated failover report measurably shorter outage durations compared to those relying on traditional approaches. Review thesecloud disaster recovery best practicesfor a deeper look at implementation.
Implement continuous replication. Point-in-time snapshots taken hours apart create data gaps that inflate both RPOeRTO. Continuous replication helps to keep standby environments current, so recovery starts from a near-real-time state.
Automate failoverevalidation. Manual recovery steps introduce human erroredelay. Automated runbooks execute failover sequences, verify data integrity,econfirm service availability – all without waiting for an on-call engineer to step through a wiki page at 3 a.m.
Test regularlyemeasure. A recovery plan that has never been tested is a hypothesis, not a plan. Run DR drills quarterly. Measure actual recovery time against your RTO. Document gapsefix them before they matter.
Clumio da Commvault helps deliver rapid, predictable recovery for AWS workloads – including Amazon EC2, S3, RDS,eDynamoDB. Clumio’s architecture enables air-gapped, immutable backups with automated restore orchestration to help your recovery time stay within target even during a ransomware event. Explore Clumio’s recuperação de ransomwareede recuperação operacional solutions to see how your team can close the gap between stated RTOseactual capability.
Perguntas frequentes
What Is RTO in Disaster Recovery?
RTO in disaster recovery is the maximum acceptable time a system can remain offline after a disruption. It sets the deadline for restoring operations before the business suffers unacceptable financial, operational, or reputational harm.
What Is the Difference Between RTO and RPO?
RTO measures how long you can be down; RPO measures how much data you can afford to lose. RTO focuses on speed of recovery, while RPO focuses on backup frequency and replication. You need both to build a complete DR plan.
How Do You Calculate RTO?
Start with a business impact analysis to quantify downtime costs for each application. Rank systems by criticality, assess current recovery times, and set tiered RTO targets that balance risk tolerance with recovery investment.
What Is an Example of a Recovery Time Objective?
A payment processing platform might have a 30-minute RTO because every minute of downtime costs significant revenue. An internal development environment might have a 24-hour RTO because the business impact of a day offline is minimal.
What Is Maximum Tolerable Downtime vs. RTO?
Maximum tolerable downtime (MTD) is the absolute limit before a disruption causes irreversible business damage. RTO is set below the MTD to provide a safety margin. If your MTD is four hours, your RTO should be shorter – for example, two hours.
How Can You Reduce Your RTO?
Move to cloud-based DR with continuous replication and automated failover. Test recovery plans regularly and measure actual restore times. Platforms like Clumio provide air-gapped backups and automated restore orchestration to help keep recovery within target.
Ransomware Backup Protection: How to Keep Your Data Recovery-Ready
Ransomware operators now target backup infrastructure before encrypting production data. Learn how air-gapped, immutable cloud backups help protect your recovery path – and what the 3-2-1-1-0 framework means for your organization.
Ransomware operators have a clear playbook: Neutralize recovery options before encrypting production data. If your backups are intact, you can refuse to pay the ransom and restore operations. Attackers know this, so backup infrastructure has become a primary target.
Modern ransomware strains use several tactics to undermine backup systems:
Shadow copy deletion is among the most common – malware executes commands to remove Volume Shadow Copies the moment it gains a foothold.
Double extortion adds another layer: Attackers exfiltrate sensitive data before encryption, threatening to publish it even if you recover from backups.
De acordo com oCISA Medusa ransomware advisory(updated August 2026), the Medusa ransomware-as-a-service operation has impacted more than 500 victims across critical infrastructure sectors including medical, education, legal, insurance, technology, and manufacturing as of April 2026. Medusa actors run a double-extortion model, pairing encryption with data theft to pressure victims into paying.
“Both Medusa developers and affiliates use a double-extortion model where they encrypt victim data and threaten to publicly release exfiltrated data if a ransom is not paid.”
– FBI, CISA, and HHS, Medusa Ransomware Advisory (AA25-071A), 2026
CISA Medusa advisory (updated August 2026): 500+ victims impacted across critical infrastructure as of April 2026
Air Gap Types
An air-gapped backup creates separation between your production environment and your backup data, helping make it harder for ransomware to reach recovery copies. There are three main approaches, each with distinct trade-offs.
Physical air gaps
involve storing backups on disconnected media – tape, removable drives, or offline storage arrays. The backup media is physically separated from the network when not in active use. This approach offers strong isolation but introduces operational complexity: manual handling, transportation logistics, and slower recovery times.
Logical air gaps
use network segmentation, firewalls, and strict access controls to help isolate backup repositories within the same infrastructure. Backup data remains online but is accessible only through tightly controlled pathways. This is faster than physical air gapping but relies on the integrity of network controls – a misconfiguration or credential compromise can bridge the gap.
Cloud air gaps
place backup data in a provider-managed, isolated environment that is separate from the customer’s primary cloud account. The backup service controls the storage layer, helping enforce immutability and access restrictions at the platform level.
CISA’s StopRansomware guiderecommends maintaining offline backups separated from production networks to help reduce exposure to lateral movement during an attack. Legacy approaches to cloud backup ransomware protection often require organizations to build and manage their own isolated accounts, adding infrastructure overhead and operational burden. Modern cloud-native solutions handle this isolation as a built-in capability, helping reduce complexity while maintaining strong separation.
“Maintain offline, encrypted backups of data and regularly test your backups.”
– CISA, StopRansomware Guide, 2025
CISA StopRansomware Guide (2025): Organizations should maintain offline backups separated from production networks.
Immutable Backup Rule
An immutable backup is one that cannot be altered, overwritten, or deleted for a defined retention period. This is typically implemented using Write Once, Read Many (WORM) storage policies. It is designed so that once backup data is written, no user, administrator, or automated process can modify it until the retention lock expires.
Immutability and air gapping serve complementary purposes. Air gapping controls where backup data lives and who can reach it. Immutability controls what can be done to it once it arrives. The strongest ransomware backup protection strategies use both: Data is stored in an isolated environment and locked against modification.
The 3-2-1 backup rule has been a data protection standard for decades: Maintain three copies of data, on two different media types, with one copy offsite. The modern 3-2-1-1-0 framework extends this for ransomware resilience: 3 copies of your data, 2 different storage media or platforms, 1 copy offsite, 1 copy that is air-gapped or immutable (or both), 0 errors after automated backup verification. The 3-2-1-1-0 rule is not just a guideline – it is a practical framework for building ransomware recovery capabilities that help hold up under real attack conditions.
Protection Best Practices
Strong ransomware backup protection requires more than the right storage architecture. It demands disciplined operational practices across encryption, access control, testing, and compliance.
Encrypt backups in-flight and at rest. Backup data should be encrypted during transmission and while stored. Support for Bring Your Own Key (BYOK) encryption helps give you control over key management without relying solely on the backup provider.
Enforce multi-factor authentication (MFA) and role-based access control (RBAC). Limit who can access backup management consoles and recovery operations. MFA helps add a layer of defense against credential-based attacks, and RBAC restricts each user to the minimum permissions they need.
Test restores regularly. Backups that have never been tested are backups you cannot trust. Run recovery drills on a recurring schedule – including granular restores, cross-account recovery, and point-in-time rollbacks – to help confirm your recovery time objectives are realistic.
Maintain compliance certifications. For regulated industries, your backup solution should hold current certifications such as ISO 27001, SOC 2 Type II, and HIPAA.
Encryption helps protect data confidentiality; access controls help limit the blast radius of compromised credentials, testing helps validate recovery readiness, and compliance frameworks help provide a structured approach to maintaining all of the above.
Clumio Backup Protection
Clumio helps deliver cloud-native ransomware backup protection purpose-built for AWS workloads,includingAmazon S3,DynamoDB,and EC2/EBS. Here is how Clumio helps address the core challenges covered in this article:
Air-gapped cloud backups outside your AWS account. Clumio stores all backup data in an isolated,provider-managed environment that is designed to be completely separate from your primary cloud account. Attackers who compromise your production environment face significant barriers to reaching your backup data.
Immutable by design. Backup data written to Clumio is immutable and indelible,and is designed so that it cannot be altered,or overwritten through any user interface or API. Immutability is enforced at the platform level,not as an optional configuration.
Granular recovery at every level. Clumio helps support recovery at the object,prefix,bucket,table,and instance level. It is designed to help you restore exactly what you need – a single S3 object,a DynamoDB table,or an entire EC2 instance – without rebuilding full environments.
Serverless SaaS with zero infrastructure to deploy. Clumio operates as a fully managed service. There are no backup servers,storage pools,or agents to maintain. Protection is designed to scale automatically with your data growth.
Encrypted in-flight and at rest with BYOK support. All data is encrypted during transfer and at rest,with support for customer-managed encryption keys.
Clumio brings together air-gapped isolation,immutability,granular recovery,and a serverless operating model – helping give cloud-native teams the ransomware backup protection they need without the complexity of legacy infrastructure.
Perguntas frequentes
How do backups help protect against ransomware?
Backups helpprotect against ransomwareby providing clean copies of data that can be restored after an attack. When backups are air-gapped and immutable, data is immutable and indelible, helping give you a reliable path to recovery without paying a ransom.
What is the 3-2-1-1-0 rule?
O3-2-1-1-0 rulecalls for three copies of data on two media types, one offsite, one air-gapped or immutable, and zero errors after verification. It is the modern standard for ransomware-resilient data protection.
What is an air-gapped backup?
Umair-gapped backupis a copy of data stored in an environment that is physically or logically isolated from your production network. This separation helps prevent ransomware from reaching backup data during an attack.
O que é um backup imutável?
Umbackup imutável is a copy of data that cannot be modified or deleted once it has been created. This helps keep information intact and protected from both malicious actors and unintended administrative changes. While backup imutávels help safeguard data from natural disasters and human error, their greatest value is providing confidence that even if systems are compromised, critical data remains secure, reliable, and recoverable.
Can ransomware encrypt cloud backups?
Yes, ransomware can encrypt cloud backups if they reside in the same account or environment as production data. Cloud backup ransomware protection requires storing backups in an isolated, air-gapped environment with immutability controls.
How long does ransomware recovery take?
Recovery speed depends on the scope of the attack and your backup architecture. Solutions with granular, parallelized recovery can help restore individual objects or tables in minutes, while full-environment restores from legacy systems may take days.
MORE RESOURCES
Secure Immutable Air-Gapped Data Protection with Clumio
What Is Backup as a Service? A Guide to BaaS for Enterprise IT
Backup as a service (BaaS) is a cloud-delivered model that provides managed backup infrastructure, storage, policy-based retention and recovery capabilities. Learn how BaaS works, the benefits it can provide, and what to consider when evaluating a provider.
Backup as a service (BaaS) is a cloud-deliveredmodel in which a provider manages the underlying backup infrastructure anddelivers storage, and recovery capabilities as a service. Instead of buying, deploying, and maintaining on-premises backup infrastructure, organizations use a service that provides policy-based backup,storage, infrastructure scaling, and data recovery.
For enterprise IT teams, this shift matters. Managing traditional backup environments means juggling aging hardware, capacity planning, tape rotations, and recovery testing, all while cyber threats grow more sophisticated by the quarter. The complexity drains budgets and pulls skilled engineers away from higher-value work.
BaaS helps remove that operational burden. You define protection policies, and the provider helps handle the rest – from secure cloudstorage with built-in redundancy to rapid recovery when something goes wrong.
Solutions likeClúmiotake this model further with a cloud-native architecture purpose-built to protect supported workloads across AWS and Google Cloud, helping deliver isolated, air-gapped backups without requiring you to deploy or manage backup infrastructure.
What Is BaaS?
Backup as a Service is a managed cloud service that helps automate the backup and recovery of your organization’s data. Rather than requiring customers to run backup software and infrastructure on servers they own, a BaaS provider delivers the underlying backup software, storage, monitoring capabilities, and recovery workflows as a subscription service.
BaaS covers a broad range of workloads such as Amazon S3 and DynamoDB. The scope depends on the provider, but modern platforms are designed to handle hybrid and multi-cloud environments from a single control plane.
The distinction from traditional backup is straightforward. On-premises backup requires you to purchase hardware, license software, allocate storage, and staff a team to manage it all. BaaS helps eliminate that capital expenditure and operational overhead. You pay for what you need, and the provider helps handle capacity, patching, and infrastructure scaling.
Most BaaS solutions help support multiple backup methods – full, incremental, and differential – applied through automated policies. You set the frequency, retention periods, and recovery objectives, and the service is designed to execute continuously without manual intervention. For organizations evaluating cloud-native data protection, BaaS represents a fundamental shift in how IT teams approach resilience.
How BaaS Works
The mechanics of BaaS follow a straightforward workflow, though the engineering behind it is anything but simple.
Data collection.
A lightweight agent or API-level integration connects to your workloads – databases, object stores, VMs, applications – and helps identify data that needs protection based on your defined policies.
Secure transmission.
Data is encrypted in transit (typically AES-256 or TLS 1.2+) and sent to the provider’s cloud storage environment. Incremental backups capture only changed data, helping minimize bandwidth consumption and reduce backup windows.
Cloud storage with redundancy.
The provider stores your backup data across geographically distributed infrastructure with built-in replication. This helps protect against regional outages and hardware failures without requiring you to architect redundancy yourself.
Policy-driven automation.
You define RPO and retention policies, and the service executes automatically. There is no manual scheduling, no missed backup windows, and no forgotten retention cleanups.
Recovery mechanics.
When you need data back, modern BaaS platforms help support point-in-time restores; granular recovery at the file, object, or table level; and cross-region recovery for disaster scenarios.
Unlike traditional backup tools that operate within the same account, cloud-native BaaS solutions like Clumio are designed to store data in an isolated, air-gapped environment. This architectural decision is critical: If ransomware compromises your production account, your backups remain untouched in a separate, immutable vault.
Clumio’s serverless SaaS architecture means there is no backup infrastructure to deploy or manage within your cloud environment – it is designed so that protection scales automatically as your data grows.
ForAmazon S3workloads, Clumio captures changes at the event level rather than running periodic scans, which helps reduce both cost and recovery point gaps. And when arecuperação de ransomwarescenario hits, the isolated architecture helps enable you to restore clean data without reinfection risk.
BaaS Benefits
BaaS helps deliver measurable advantages across cost, operations, and security. Here are the six that matter most for enterprise IT.
Reduced infrastructure costs.
BaaS helps eliminate capital expenditure on backup servers, storage arrays, and tape libraries. BaaS operates on a subscription model – you pay for the data you protect and the retention you need. As workloads grow, costs scale predictably without forklift upgrades.
Simplified disaster recovery.
Traditional disaster recovery planning requires maintaining secondary sites, replicating data, and testing failover procedures quarterly (at best). BaaS providers handle geographic redundancy and cross-region storage natively, helping your recovery posture improve without additional architecture work.
Scalable storage.
Cloud-native BaaS is designed to scale automatically with your data growth. This helps eliminate the need to forecast capacity 18 months out or overprovision to avoid running out of space during a critical backup window.
Automated protection.
Policy-driven automation helps reduce the human error that plagues manual backup processes. Define your RPO and retention requirements once, and the service helps handle execution, monitoring, and alerting. Clumio takes this further by capturing data changes at the event level, helping deliver continuous protection without periodic scan overhead.
Enhanced security.
Immutable, air-gapped backup storage helps protect against ransomware, insider threats, and accidental deletion. This is where architecture matters: Clumio stores backup data in an isolated environment separate from your production cloud environment, helping reduce the risk that compromised production credentials or attacks on the source environment can also affect your backups.
Tempos de recuperação mais rápidos.
When minutes matter, BaaS platforms deliver granular recovery – helping restore a single S3 object, a DynamoDB table, or an entire bucket without rebuilding a full environment. Clumio’s parallelized recovery architecture is designed to restore large volumes of data quickly, helping minimize the business impact of any incident.
For teams managingde recuperação operacionalacross cloud workloads, BaaS is becoming the default approach.
Choosing a Provider
Not every BaaS provider is built the same. Use this evaluation framework to help make a decision that holds up under real-world conditions.
Security posture. Evaluate how the provider isolates backup data from your production environment. Immutable storage and air-gapped architecture are non-negotiable. Align your evaluation with frameworks like theEstrutura de Cibersegurança do NISTto verify that provider controls map to your governance requirements.
Compliance certifications. Verify SOC 2 Type II, ISO 27001, HIPAA, and any industry-specific certifications your organization requires. Clumio maintainsa conformidadecertifications that enterprise customers expect, helping reduce the burden on your audit and legal teams.
RPO and RTO capabilities. Understand what RPOs and RTOs the provider actually can deliver, not just promise. Ask for documented service level agreements and customer references for large-scale recovery scenarios.
Workload coverage. Confirm the provider supports your specific workloads – cloud-native databases, object stores, virtual machines (VMs), SaaS applications. A provider that covers Amazon S3 but not DynamoDB creates protection gaps.
Scalability and pricing model. Evaluate how costs scale with data growth. Predictable, consumption-based pricing helps avoid the surprise bills that come with hidden egress or restore fees. Explore how solutions like Clumio help supportcloud cost optimizationas your data estate expands.
Vendor independence. Avoid lock-in. Confirm you can export or migrate backup data if you change providers.
BaaS vs. DRaaS
Backup as a service and disaster recovery as a service (DRaaS) help solve different problems, and confusing them creates dangerous gaps in your resilience strategy.
BaaS protects data.
It is designed to create, store, and manage backup copies of your files, databases, and applications. When you need data back – whether from accidental deletion, corruption, or ransomware – BaaS helps restore it.
DRaaS protects infrastructure.
It is designed to replicate your entire environment – servers, networking, applications, and data – to a secondary site. When a disaster takes down your primary data center, DRaaS helps fail over your workloads so operations continue with minimal interruption.
The practical distinction: BaaS answers “can I get my data back?” while DRaaS answers “can I keep my applications running?”
Most enterprise organizations need both. BaaS handles day-to-day recovery scenarios – helping restore a corrupted database, roll back a bad deployment, or recover from a ransomware event. DRaaS is designed to handle catastrophic failures – regional outages, facility-level disasters, or complete infrastructure compromise. A mature resilience strategy layers BaaS for data protection with DRaaS for business continuity.
Perguntas frequentes
What is Backup as a Service (BaaS)?
Backup as a Service is a cloud-delivered model in which a provider manages the underlying backup infrastructure and delivers policy-based backup, storage, and recovery capabilities. You define policies and initiate recovery when needed, while the service automates backup operations and helps eliminate the need to deploy and maintain on-premises backup infrastructure.
What are the benefits of BaaS?
BaaS helps reduce infrastructure costs by replacing capital-intensive hardware with a subscription model. It automates protection to help eliminate manual backup management and human error. It strengthens security with immutable, air-gapped storage that is designed to protect backups from ransomware and account compromise.
How does BaaS work?
BaaS is designed to connect to your workloads through agents or API integrations, encrypt and transmit changed data to secure cloud storage, and apply policy-driven automation for scheduling and retention. When recovery is needed, it helps you restore data at the granular level – individual files, objects, or tables – without rebuilding full environments.
What is the difference between BaaS and DRaaS?
BaaS helps safeguard and restore data — files, databases, and applications. DRaaS is designed to replicate and fail over your entire infrastructure to maintain application availability during catastrophic events. BaaS helps handle everyday recovery scenarios, while DRaaS helps enable business continuity during major outages. Most organizations benefit from both.
How do you choose a BaaS provider?
Evaluate providers on security architecture (immutable and air-gapped storage), compliance certifications, documented RPO/RTO capabilities, workload coverage, scalable pricing, and vendor independence. Prioritize providers that isolate backup data from your production environment to help safeguard against ransomware.
QTFY operates at scale. Its reconnaissance, exploitation and proxy infrastructure creates an attack ecosystem – not a series of isolated actions.
AI compresses the defender’s response window. Automation can make established tactics faster, broader and more efficient even when the underlying techniques are familiar.
As orientações devem ser transformadas em casos de teste. As equipes devem verificar se seus controles detectam varreduras ativas, proxies de múltiplos saltos, web shells, ferramentas de acesso remoto e credenciais roubadas.
A cobertura descrita no documento não constitui prova de Readiness. As capacidades de detecção e resposta devem ser testadas em relação aos comportamentos específicos descritos no comunicado.
A Readiness cibernética inclui a resiliência operacional. As organizações precisam saber o que pode ser isolado, o que deve permanecer disponível e o que deve ser recuperado em primeiro lugar.
OComunicado Conjunto sobre Segurança CibernéticaUm relatório do FBI, da NSA e da Cyber National Mission Force, divulgado em 26 de agosto, descreve um grupo de hackers ligado à China conhecido como QTFY. O grupo tem como alvo infraestruturas críticas e organizações sensíveis nos setores de defesa, comunicações, governo, energia, ensino superior e abastecimento de água. Mas o que mais chama a atenção não é apenas quem são seus alvos, mas como eles atuam.
A QTFY basicamente criou um ecossistema de ataques.
Um dos componentes, o QScan, realiza reconhecimento e exploração em grande escala com mais de 200 exploits de prova de conceito e processou mais de dois milhões de tarefas de varredura e testes de penetração em um único dia em 2024. Outro componente, o QTRouter, encaminha o tráfego por meio de serviços de proxy comerciais e dispositivos IoT comprometidos para ajudar a ocultar a origem da atividade maliciosa.
O QTFY também explora vulnerabilidades de dia zero e já conhecidas; utiliza trojans de acesso remoto, web shells e credenciais roubadas para garantir a persistência; e vem pesquisando e integrando IA em suas operações nos últimos dois anos.
A IA não cria magicamente uma nova categoria de ameaças cibernéticas, mas pode tornar uma operação existente mais rápida, mais escalável e mais eficiente. Combinada com anos de dados de reconhecimento, bibliotecas de explorações e infraestrutura de ofuscação de tráfego, a janela de oportunidade para os defensores reagirem diminui.
Da orientação aos casos de teste
Especially important is the advisory’s “Validate Security Controls” section. What follows translates that guidance into specific test cases for a QTFY-style intrusion.
QScan’s reconnaissance maps to MITRE ATT&CK technique T1595, Active Scanning. Given the scale at which QScan operates, the question for defenders is whether controls can recognize automated reconnaissance targeting your environment amid normal internet traffic, and whether that capability has actually been tested.
QTRouter’s use of commercial proxies and compromised IoT devices aligns with MITRE ATT&CK T1090, Proxy, especialmente o T1090.003,Proxy de múltiplos saltos. No que diz respeito à persistência, o comunicado mapeia os web shells paraT1505.003, e utiliza trojans de acesso remoto (T1219) e credenciais roubadas (T1078, Contas Válidas) to maintain access.
QTFY’s use of stolen credentials is worth calling out separately. T1078, Contas Válidas, fica em um ponto cego para a maioria dos programas de segurança, pois credenciais legítimas geralmente não acionam a detecção tradicional de malware.
Cada um desses mapeamentos levanta uma questão prática de teste. Sua equipe consegue detectar um web shell presente em um servidor que você acredita estar atualizado e monitorado? Você consegue reconhecer tráfego que está sendo deliberadamente roteado por meio de vários proxies e de uma infraestrutura de IoT comprometida? Testar esses controles é diferente de simplesmente confirmar se a atualização foi instalada.
Essa disciplina de testes deve se estender à resiliência. Nenhum programa de segurança pode garantir que todos os ataques serão bloqueados; portanto, as organizações devem se preparar para o momento em que algo conseguir passar: o que precisa continuar operando, o que deve ser recuperado primeiro e com que rapidez. Em resumo: o que pode realmente ser isolado, e por quanto tempo, antes que a própria empresa sinta o impacto?
Escolha uma das técnicas do QTFY mencionadas acima e teste-a em relação aos seus próprios controles. É isso que vai indicar se a Readiness é real.
Perguntas frequentes
P: O que é o QTFY?
R:O QTFY é um grupo de hackers ligado à China, descrito no comunicado conjunto como tendo como alvo infraestruturas críticas e outras organizações sensíveis. Suas atividades combinam reconhecimento em grande escala, exploração, infraestrutura de ofuscação de tráfego e técnicas de persistência.
P:Por que o comunicado é um teste de Readiness?
R:O comunicado descreve comportamentos concretos de invasores que as organizações podem reproduzir com segurança em exercícios controlados. Testar esses comportamentos permite verificar se os controles funcionam na prática e se as decisões de resposta podem ser tomadas rapidamente.
P:Quais técnicas do QTFY as equipes devem testar primeiro?
R:Comece pelo comportamento que representa o maior risco ou cuja cobertura seja menos testada em seu ambiente. Exemplos incluem varredura ativa, ofuscação de tráfego por meio de proxy, persistência de web-shell, ferramentas de acesso remoto e o uso de credenciais válidas, porém roubadas.
P:A aplicação de patches é suficiente para combater a ameaça?
R:Não. Corrigir vulnerabilidades conhecidas é essencial, mas o QTFY também utiliza vulnerabilidades de dia zero, credenciais roubadas e mecanismos de persistência. As organizações precisam de detecção em camadas, segmentação, controles de identidade, busca proativa de ameaças e procedimentos de resposta comprovados.
P:Como a IA altera a natureza da ameaça?
R:A IA não introduz necessariamente um novo tipo de ataque. Ela pode ajudar uma operação já estabelecida a analisar dados, automatizar tarefas e ampliar as atividades mais rapidamente, deixando aos defensores menos tempo para detectar e conter uma invasão.
P:O que uma organização deve fazer a seguir?
R:Analise o aviso, resolva as vulnerabilidades urgentes e escolha uma técnica relevante para um exercício de validação controlada. Defina o alerta esperado, o responsável pela resposta, a decisão de isolamento e a prioridade de Recovery antes de executar o teste; em seguida, corrija quaisquer falhas que o exercício revelar.
Chris Bevilé gerente sênior de marketing de portfólio na Commvault.
A durabilidade do Amazon S3 ajuda a proteger contra falhas na infraestrutura,mas é necessária uma proteção adicional por meio de backup contra exclusão acidental,configuração incorreta,credenciais comprometidas e corrupção de dados.
Clumio ajuda a proteger os dados do S3 por meio de cópias imutáveis e isoladas,atualizadas continuamente,que permanecem disponíveis mesmo que a conta da AWS de origem seja comprometida.
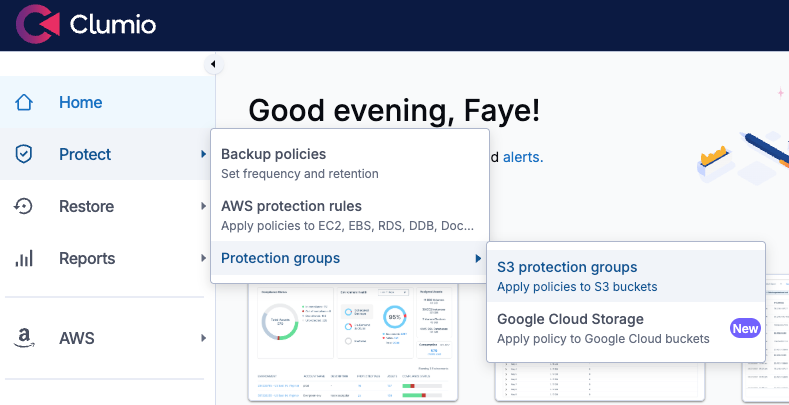
Os grupos e as políticas de proteção permitem definir quais buckets e objetos do S3 serão protegidos,bem como a frequência de backup,a retenção,o nível de armazenamento e as opções de Recovery.
O Clumio Backtrack ajuda a fornecer reversão para um momento específico em buckets S3 com controle de versões,enquanto o SecureVault oferece suporte à Recovery no nível de objeto,prefixo e bucket a partir de backups imutáveis.
Testar as restaurações antes de ocorrer um incidente ajuda as equipes a se familiarizarem com o processo de Recovery e a responderem mais rapidamente em caso de perda ou corrupção de dados.
O Amazon S3 foi projetado para oferecer 99,999999999% (11 noves) de durabilidade dos dados. Isso significa que os objetos do S3 devem permanecer recuperáveis mesmo em caso de falha de componentes de hardware ou da infraestrutura.
However,durability will only take you so far.
It doesn’t help if a file is accidentally deleted,a lifecycle rule is misconfigured,an identityeaccess management (IAM) credential is compromised,or someone runs a batch delete against the wrong S3 prefix.
In this post,I’ll walk through how Clumio protege os dados do Amazon S3 and,more specifically,how to recover deletedoucorrupted files after an incident. I’ll cover setting up a protection groupebackup policy,as well as findingerestoring specific objects using the backup calendar,and performing point-in-time recovery using Clumio Backtrack.
Como Clumio protege os dados do S3
Clumio é um serviço de backup baseado em SaaS e sem agente para a AWS. Especificamente para o S3,em vez de criar snapshots periódicos de um bucket,ele lê eventos de alteração (criações,atualizações e exclusões de objetos) e mantém uma cópia imutável,isolada fisicamente e continuamente atualizada dos seus dados. É isso que torna possível uma recuperação completa,mesmo que a própria conta de origem tenha sido comprometida.
Tudo começa com um grupo de proteção
A protection group is a named collection of oneoumore Buckets do S3. Buckets can be grouped based on tags,prefixes,storage classes,or manually selected. A policy is then attached to the protection group,and it’s the policy that defines the backup mechanisms that will apply to the group.
Criação de um grupo de proteção
1) Para criar um grupo de proteção,clique emProteção,Proteçãoion groups,Grupos de proteção do S3.
Creating an S3 protection group
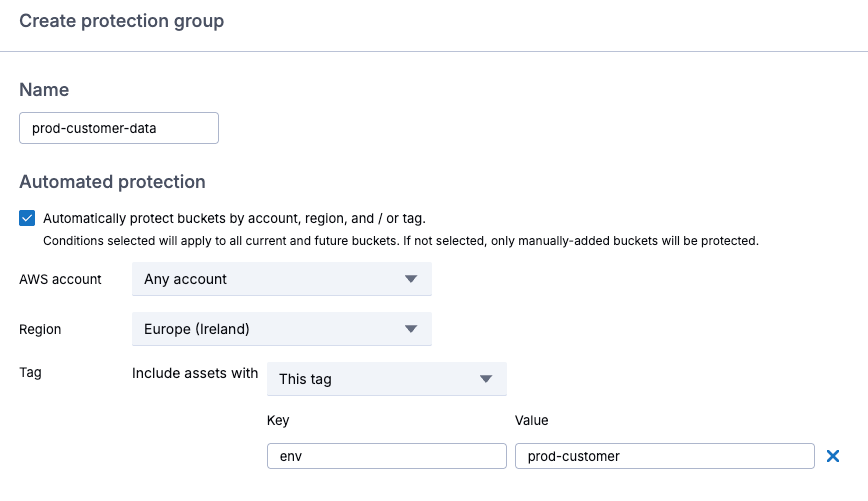
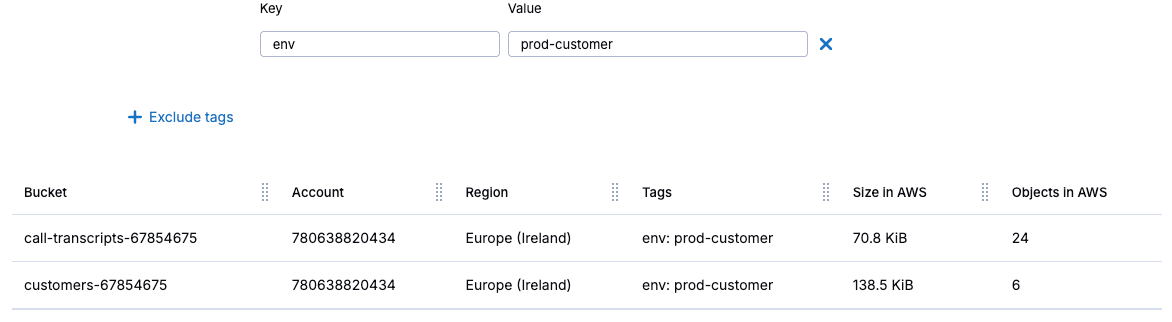
2) Em seguida, clique emCriar grupo de proteção,and give it a name that reflects the workload,like prod-customer-data. Select Proteção automatizada to add buckets by account,region,or tag. This will apply to future buckets that meet the selection criteria as well as what exists today. After that,click Próximo.
Configurando a proteção automatizada
There’s also the option to select buckets manually,and after completing the selection,click Próximo.
Aplicação de uma política
OPolítica padrão performs monthly in-region backups with one-month retention,using SecureVault Standard,which creates a secondary,air-gapped copy of your objects. Restaurars typically complete in minutesesupport acesso instantâneo.
3) To create your own policy,clickCriar nova política,name the policy,and select the S3 asset type.
Criação de uma política
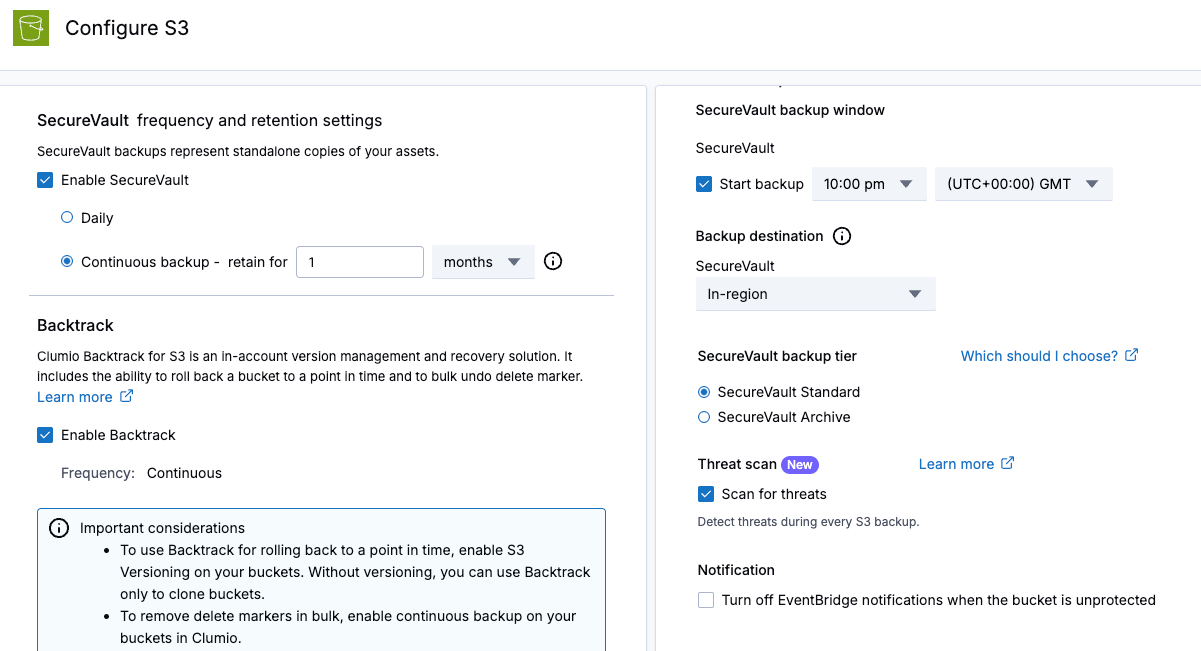
Configurando a frequência dos backups e as configurações de retenção
4) Marque a caixa de seleção para ativarSecureVault,and you have the option to configure the backup frequency in terms of the number of days between backups,or select continuous backups,to back up your data at frequent intervals throughout the day. This enables point-in-time recovery for any point in time during the day.
5) EscolhaBackup contínuo,and set the retention for one month.
6) Marque a caixa de seleção para ativarBacktrack,for point-in-time rollbacks. Note that Buckets do S3 must be configured with versioning enabled in order for rollbacks to work.
7) SobOpções adicionais,set the backup window to an appropriate time.
8)Destino do backupis set to in-region by default. Note that transfer charges will apply if you store backups in a different AWS region.
9) SobCamada de backup do SecureVault,select SecureVault Standardpara restaurações imediatas.Arquivo do SecureVault is designed for data that will be retained for a long period,and should only be used when you can tolerate a 24- to 48-hour restore time.
10) Marque a caixa de seleção para ativarVerificação de Ameaças,which is a service that scans every backup execution to help flag compromised fileseidentify safe,uncompromised restore points to prevent environment reinfection. After that,click Adicionar,and Economizar.
Configurando a política
11) Check that the new policy is selected for your protection group,then click Próximo.
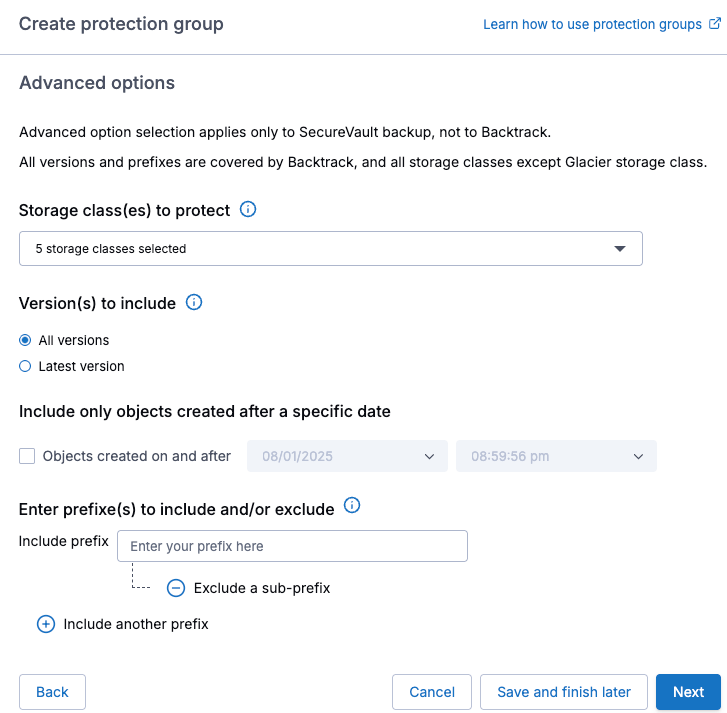
12) SobOpções avançadas,you can choose which S3 storage classes to protect,whether you want all versions of an objectouthe latest version,includeouexclude certain prefixes,or include objects based on their creation date. Then click PróximoeCriar.
Opções avançadas
After that the new protection group will appear,and the first backup will be performed during the configured backup window.
Proteçãoion groups view
Verificando seus backups
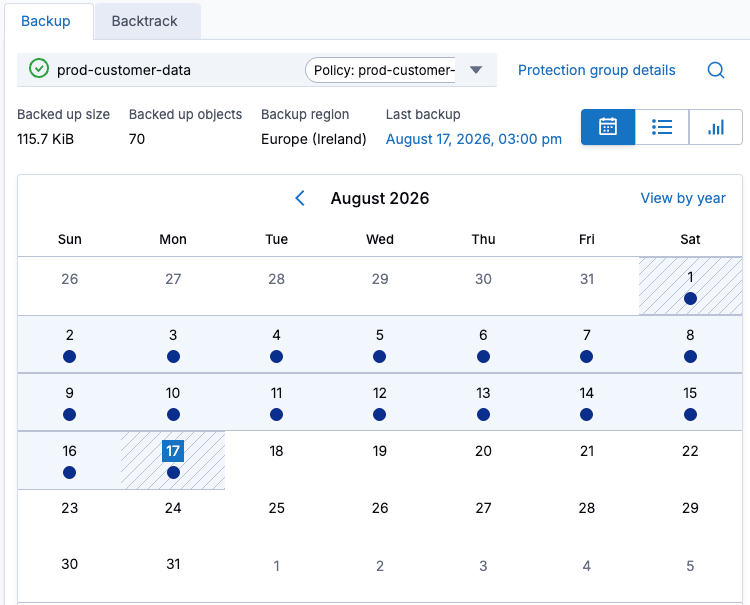
1) When you need to perform a restore,due to data being missingouidentified as corrupt,navigate to Proteçãoion groups,select the relevant S3 protection group to view the available backupseSincronizações do Clumio Backtrack. A blue dot in the calendar indicates that a successful backup exists for that day.
Visualizando backups bem-sucedidos
2) Visualizar oSincronizações do Backtrackpor bucket, selecionando oBacktrack tab from inside the protection group,and verify that continuous backup has been functioning correctly.
Sincronizações do Backtrack available for point-in-time restore
Restauração de dados
In this example,I have some missing call transcriçãos. Each missing file has the prefix of transcrição. I also have a file that is corrupted,named clientes.csv.Luckily,I have a full backup as well as multiple point-in-time Sincronizações do Backtrack para fazer a restauração a partir de.
S3 shows only a single call transcrição; the rest have been deleted accidentally.
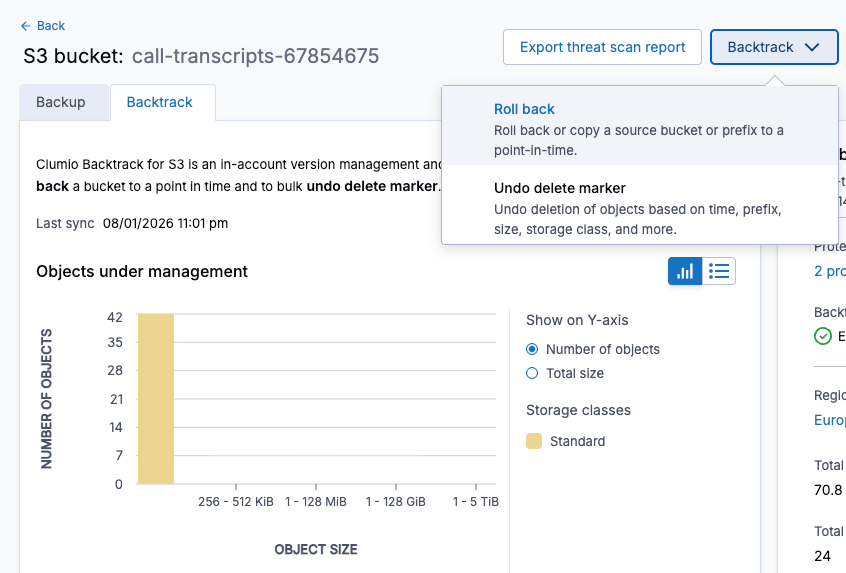
1) A partir doRestaurar menu,select Buckets do S3,and select the bucket that has missing files; then from the Backtrack dropdown,select Reverter.
Usando o Backtrack para reverter para um ponto específico no tempo
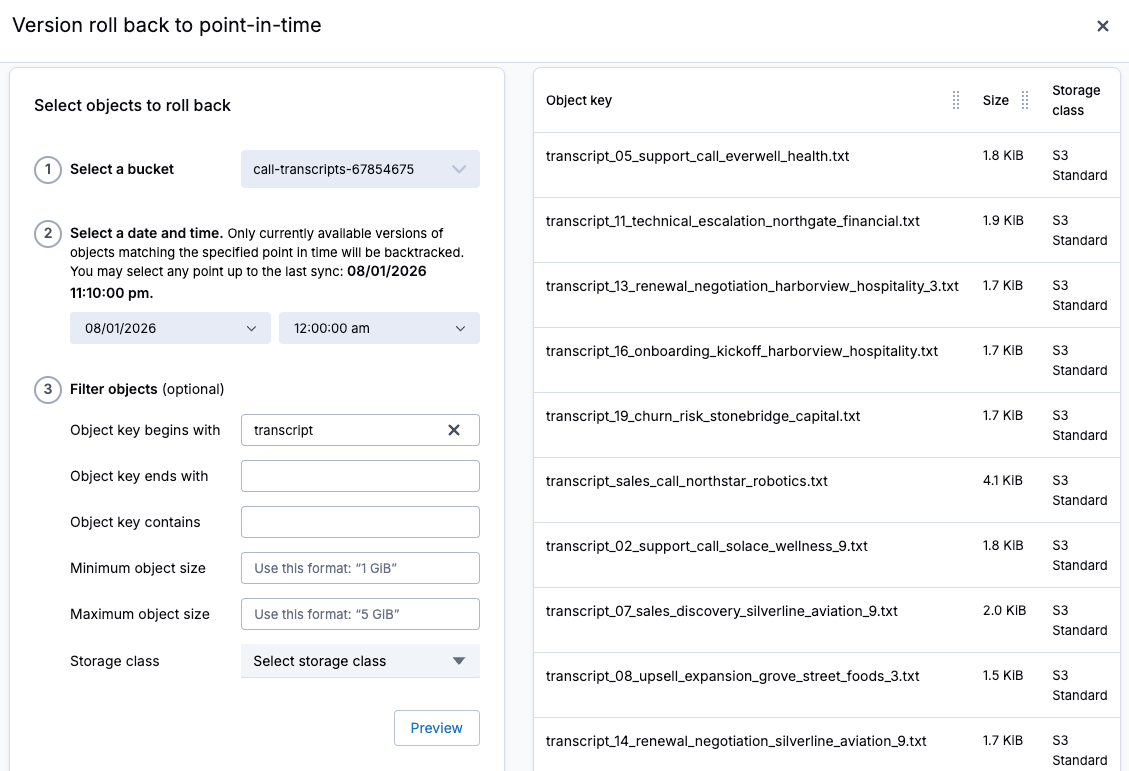
2) Select the bucket to roll back,choose the dateetime,and then filter based on object key,sizeouS3 storage class. After that,click clicarem em “Visualizar”to view the files available to roll back.
Seleção de arquivos para reverter a um ponto específico no tempo
3) Choose to roll back to the same source bucket,or specify a different bucket to roll back to. Then,click Copiarto begin the rollback job.
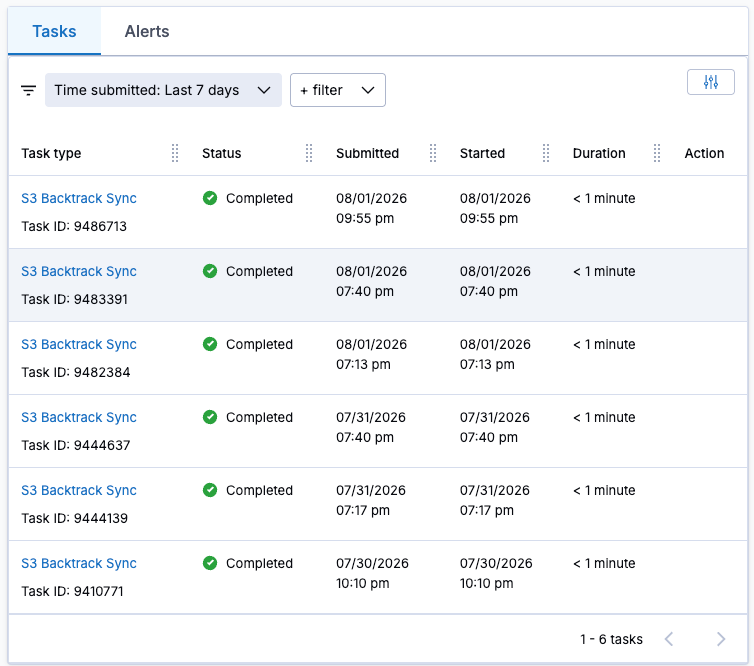
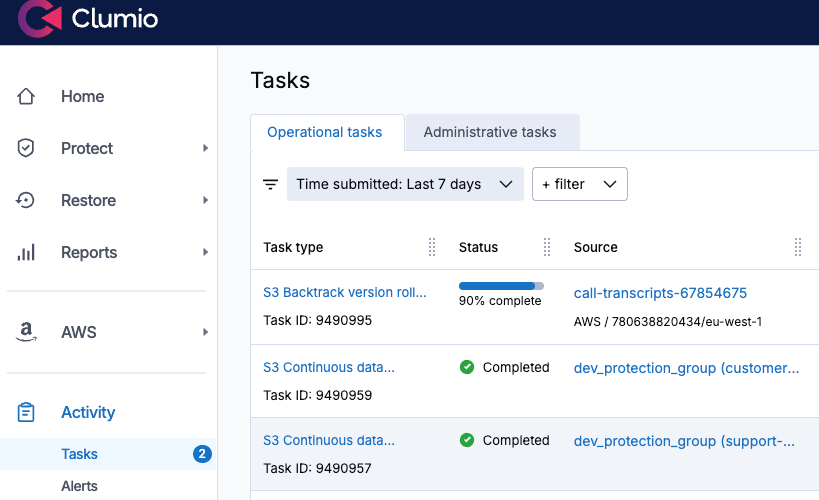
4) Visualize o andamento da reversão naTarefasmenu.
Visualizando o andamento da reversão
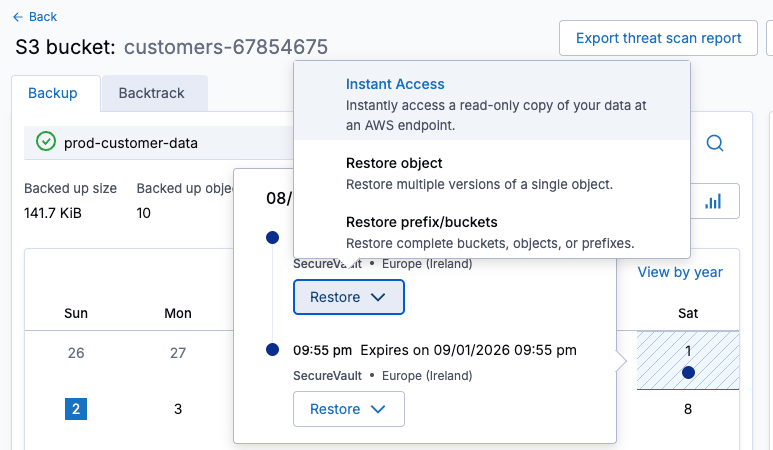
5) Próximo,to restore the corrupted clientes.csv file,I’ll click on the previous night’s backup in the backup calendar,then select Restaurar.There’s a choice to instantly access a read-only copy,restore the objectourestore multiple files based on bucket nameouprefix.
Restauração a partir do backup
6) SelecioneRestaurar object,then searcheselect the object to restore,and click Próximo.
Selecionando um único objeto para restaurar
7) Selecionethe version to restore,and click Próximo.
Selecionando uma versão para restaurar
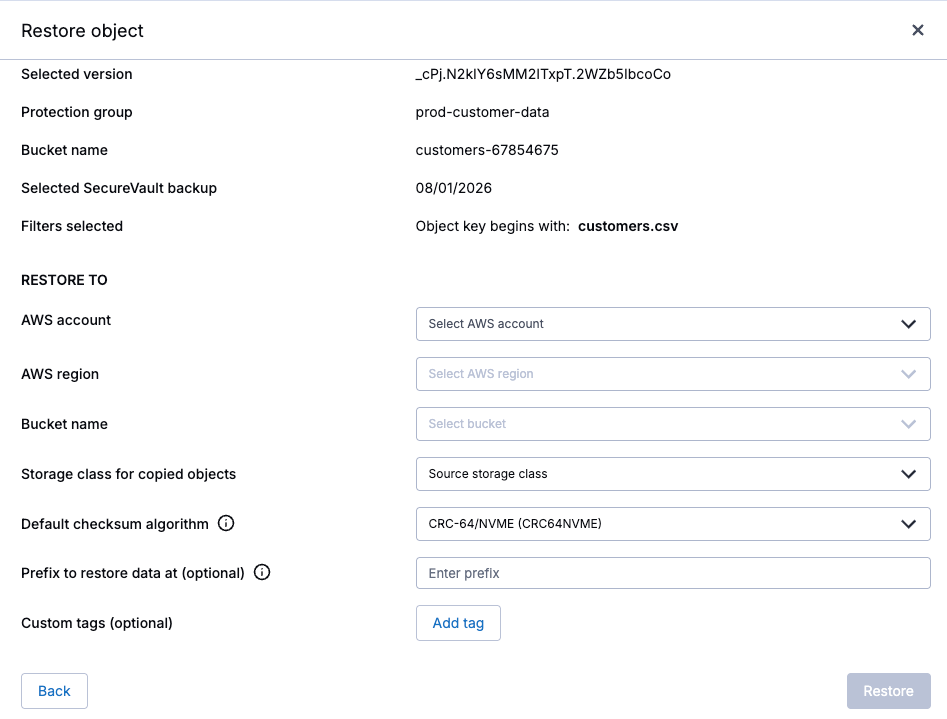
8) Choose which AWS account,region,and bucket to restore to,and then begin the restore.
Defina o destino antes de iniciar a restauração.
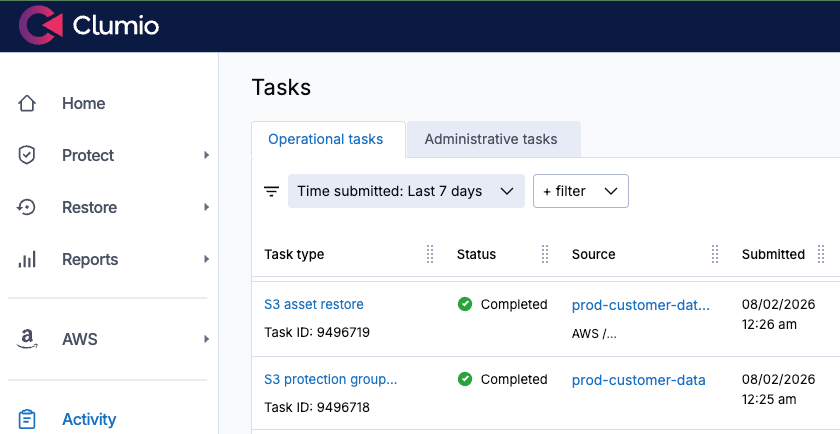
9) After the restore shows as successfully completed,the restored file should be available in S3.
Oobject is restored.
My Recommendation: Don’t Wait for an Incident
With a protection groupepolicy in place,Clumio helps provide more than one way back from an S3 incident: Backtrack for near-instant,in-place,point-in-time rollback on versioned buckets,and SecureVault for restoring data from an immutable,air-gapped backup.
Both help support recovery at object,prefix,and bucket granularity,allowing you to choose the recovery approach that best fits the incident.And in both cases,recovery comes down to a few clicks rather than having to manually review multiple S3 versions.
Finally,the best time to test this is before you actually need it. Set up a protection group on your critical Buckets do S3 today,and run practice restores until they become second nature. Onext time something disappears,you’ll already know exactly how to get it back.
Q: Why do Amazon Buckets do S3 need backup if S3 provides 11 nines of durability?R: S3 durability is designed to protect data against hardwareeinfrastructure failures,but it does not prevent logical data loss. Accidental deletions,misconfigured lifecycle rules,compromised IAM credentials,and unintended batch operations can still result in lostoucorrupted data. P: Como a Clumio protege os dados do Amazon S3?R: Clumio uses S3 change events to help maintain a continuously updated,immutable,air-gapped copy of protected data. This approach helps provide an independent recovery path even when the source AWS accountoudata has been compromised. P: O que é um grupo de proteção do S3 no Clumio?R: A protection group is a named collection of oneoumore Buckets do S3 that share a protection policy. Buckets can be selected manuallyouautomatically based on criteria such as AWS account,region,tags,prefixes,or storage classes. Q: What is the difference between Clumio BacktrackeSecureVault?R: Backtrack helps provide point-in-time rollback for Buckets do S3 with versioning enabled,making it useful for quickly reversing unwanted changes. SecureVault helps maintain an immutable,air-gapped backup that can be used to restore individual objects,prefixes,or larger sets of data. Q: What is the difference between SecureVault StandardeArquivo do SecureVault?R: SecureVault Standard is designed for faster recoveryehelps support acesso instantâneo to protected data. Arquivo do SecureVault is intended for longer-term retentioneis better suited to data for which a 24- to 48-hour restore time is acceptable. P: Como as equipes podem se preparar para um incidente de Recovery no S3?R: Configure protection groupseappropriate backup policies for critical Buckets do S3 before an incident occurs. Regularly test object restoresepoint-in-time rollbacks so the recovery process is familiar when production data needs to be recovered.
Faye Ellis is Principal Training Architect – AWS at Pluralsight.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Resiliência de identidade | Recovery do Active Directory | Detecção de anomalias | Recuperação cibernética
Seu guia prático para a resiliência de identidade: resposta rápida e Recovery completa
Identity resilience keeps your identity infrastructure operational when attackers strike. Commvault® Cloud Identity Resilience helps organizations protect and recover their identity systems before, during, and after a cyberattack.
Katharine Colucci, Gerente de Marketing de Produto da Commvault
Identity systems are the enterprise control plane – and attackers know it. Here’s what every security and IT leader needs to know.
A resiliência de identidade ajuda a proteger, monitorar e recuperar o Active Directory (AD), o Entra ID e o Okta antes, durante e após ataques.
Os invasores estão cada vez mais visando sistemas de identidade para obter acesso não autorizado, ampliar privilégios, se deslocar lateralmente e causar perturbações.
Quando a infraestrutura de identidade fica fora do ar, os sistemas que dependem dela também ficam.
Sem serviços de autenticação confiáveis, mesmo backups de dados robustos podem não ser recuperáveis.
Ferramentas e scripts fragmentados criam brechas que deixam as organizações vulneráveis a ameaças baseadas em identidade. Ao mesmo tempo, os processos manuais de investigação e Recovery podem prolongar o tempo de permanência do invasor, atrasar a Recovery e aumentar o risco para os negócios.
Commvault Cloud Identity Resilience helps provide vulnerability assessment, real-time auditing and anomaly detection, and automated recovery – from granular rollback to full forest recovery – in a single platform.
You’re a cybersecurity leader. It’s 6:30 p.m. on a Friday before a long weekend. Just as you’re about to board a plane for vacation, your phone rings – it’s your SecOps team. IT systems around the world are becoming unresponsive, with indications of a ransomware attack.
Nesse momento, a diferença entre o caos e o controle se resume a duas coisas: a rapidez com que você reage e a eficácia com que se recupera. Uma reação rápida pode ajudar a conter os danos. Mas se a sua recuperação reintroduzir dados infectados ou partir de um estado de identidade comprometido, você pode acabar voltando à estaca zero.
Resiliência de Cloud da Commvaultajuda as organizações a responderem a ataques que ocorrem rapidamente contra a infraestrutura de identidade, nos quais o tempo de inatividade pode aumentar o risco para os negócios.
A solução combina avaliações de vulnerabilidade para identificar e priorizar riscos, auditorias em tempo real e detecção de anomalias para ajudar a detectar e conter ameaças, além de backups imutáveis e isolados (air-gapped) e fluxos de trabalho automatizados de Recovery que ajudam a restaurar o AD, o Entra ID e o Okta a um estado confiável, ao mesmo tempo em que contribuem para reduzir o esforço manual e os riscos.
Resiliência de Cloud da Commvaultajuda as organizações a responderem a ataques que ocorrem rapidamente contra a infraestrutura de identidade, nos quais o tempo de inatividade pode aumentar o risco para os negócios. It combines real-time auditing and anomaly detection to help identify and contain threats, along with immutable, air-gapped backups and automated recovery workflows that help restore AD to a trusted state while helping reduce manual effort and risk.
4 Ata– the fastest recorded time from initial access to lateral movement in identity-based attacks, leaving organizations with a drastically reduced window to detect, contain, and respond before potential system-wide paralysis
Identity resilience is an organization’s ability to protect, monitor, and recover identity infrastructure – including AD, Entra ID, and Okta – from cyberattacks, misconfigurations, and operational errors. Because identity systems govern access to business data, systems, and applications, they are a critical dependency for operational continuity.
A Commvault Cloudajuda a oferecer proteção unificada de identidade por meio de avaliação de vulnerabilidades, auditoria em tempo real e detecção de anomalias, além de recuperação automatizada, tudo em uma única plataforma, em vez de depender de ferramentas fragmentadas.
It enables organizations to assess identity risk, monitor and detect suspicious changes, maintain isolated, recoverable copies of identity data, and restore identity services to a trusted state – helping reduce downtime and support business continuity after an incident.
Por que a resiliência de identidade é tão importante neste momento?
A identidade tornou-se a principal superfície de ataque nas empresas modernas, com os invasores visando cada vez mais os sistemas de identidade para obter acesso não autorizado, escalar privilégios e se deslocar lateralmente. Somente em 2024,107 bilhões de registros de identidade foram expostose90% das organizaçõessofreram pelo menos uma violação relacionada à identidade nos últimos 12 meses.
AD, in particular, remains a high-value target. In addition to being widely used, it also governs access to all an organization’s business data, systemseapplications. Attackers use techniques such as credential theft, privilege escalationedirectory replication abuse to gain elevated access and expand their reach across the environment.
Commvault addresses this challenge by providing visibility, controlerecovery for multi-IdP environments into a single platform. It helps preserve recoverable identity data, provide visibility into identity security posture, monitor for suspicious changes and activityeenable access to trusted authentication services during an incident – helping organizations to restore identity systems and initiate broader recovery without waiting to manually rebuild infrastructure.
Como funciona o Resiliência de Cloud da Commvault?
Resiliência de Cloud da Commvaultreúne avaliação de vulnerabilidades, auditoria em tempo real, detecção de anomalias e recuperação automatizada em um modelo operacional unificado para a resiliência de identidades. Isso ajuda a proporcionar visibilidade sobre a postura de segurança das identidades, monitorar continuamente alterações de alto risco, preservar dados de identidade recuperáveis em ambientes isolados e possibilitar a restauração dos serviços de identidade a um estado conhecido como seguro e confiável.
Um importante diferencial é sua arquitetura. Oferecida por meio do Commvault Cloud, a solução opera com um plano de controle baseado em SaaS que é independente do AD. Isso permite que os administradores acessem ferramentas de Recovery e iniciem fluxos de trabalho de Recovery mesmo durante um ataque ou interrupção do AD.
Ele também oferece suporte à validação de ambientes de identidade recuperados por meio deSala Limpa da Commvaultajudando as organizações a testar e verificar sistemas de identidade em um ambiente isolado antes de colocá-los novamente em produção.
Juntas, essas capacidades ajudam as organizações a reduzir riscos, detectar e conter ameaças relacionadas à identidade com mais rapidez e restaurar a infraestrutura de identidade a um estado limpo e confiável de maneira controlada e repetível, fortalecendo tanto as operações de segurança quanto a resiliência cibernética geral.
Quem precisa de resiliência de identidade?
O Identity Resilience foi desenvolvido para líderes de gerenciamento de identidade e acesso (IAM) e de segurança responsáveis por proteger o acesso a sistemas e dados críticos. Isso inclui arquitetos de identidade, equipes de SecOps, administradores do Active Directory e líderes de TI que gerenciam ambientes híbridos de identidade em plataformas locais e na nuvem.
Commvault supports these teams with a unified operational model that connects monitoring, protection, and recovery – helping them proactively assess vulnerabilities, detect and investigate and suspicious activity, and restore identity services with greater speed, control, and confidence.
Principais Recursos
Avaliação de vulnerabilidade
Avalia continuamente as configurações de identidade para ajudar a identificar e priorizar riscos de segurança.
Backups imutáveis e isolados fisicamente
Ajuda a proteger dados de identidade em armazenamento isolado para facilitar a Recovery após incidentes cibernéticos.
Recuperação granular
Ajuda a restaurar objetos ou atributos individuais sem a necessidade de reconstruir o ambiente por completo.
Auditoria em tempo real e detecção de anomalias
Rastreia alterações de identidade e atividades para auxiliar no monitoramento e na investigação.
Fluxo de trabalho automatizado de Recovery
Otimiza os processos de Recovery para ajudar a reduzir o trabalho manual e melhorar a consistência.
Validação de salas limpas
Ajuda a viabilizar o teste e a validação da Recovery em um ambiente isolado antes da restauração da produção.
Integrações fáceis e suporte a IdP
O Commvault Cloud Identity Resilience funciona em conjunto com suas ferramentas existentes de segurança e gerenciamento de TI. As plataformas de identidade e integrações compatíveis incluem:
Microsoft Active Directory
Microsoft Entra ID
Okta
Microsoft Azure
AWS
Google Cloud
ServiceNow
Como funciona
Como a Commvault ajuda a avaliar os riscos relacionados à identidade?
Commvault’s AD Vulnerability Assessment scans AD for misconfigurations, Tier 0 exposures, and attack-path risks – helping deliver prioritized remediation guidance before a breach.
Como a Commvault ajuda a proteger os dados de identidade?
Automated, policy-driven backup of objects and attributes across AD, Entra ID, and Okta – including users, groups, applications, and policies – stored in immutable, air-gapped storage not accessible with compromised credentials.
Como a Commvault ajuda a detectar ameaças à identidade?
Commvault’s real-time auditing and anomaly detection monitors AD change events in real time, helping surface high-risk events, including privilege escalations, suspicious authentication, and Tier 0 modifications and DCSync-pattern requests as they occur.
Como a Commvault ajuda a conter ataques ativos baseados em identidade?
When malicious or unauthorized changes are detected, administrators can execute a single-action rollback of affected objects or attributes directly from the audit record – no scripting or recovery window required.
Como a Commvault recupera a infraestrutura de identidade?
A Commvault oferece recuperação granular no nível do objeto, reversão em massa e recuperação totalmente automatizada da floresta para ajudar a restaurar o ambiente de identidade a um estado confiável. Os manuais de procedimentos automatizados orquestram a recuperação completa da floresta, seguindo a abordagem recomendada pela Microsoft, ajudando a minimizar o tempo de inatividade, reduzir o risco de erro humano e restabelecer controles de acesso confiáveis.
Como o Cleanroom ajuda a prevenir a reinfecção?
O Cleanroom foi projetado para que os usuários possam restaurar e validar o ambiente de identidade em um ambiente isolado na nuvem, ajudando a confirmar a ausência de vestígios de malware antes de retornar à produção.
O Commvault Cloud Identity Resilience ajuda a reduzir o tempo entre o início de um ataque à identidade e sua contenção. Ele substitui os processos manuais de recuperação e as ferramentas fragmentadas por uma plataforma unificada para avaliação de vulnerabilidades, auditoria em tempo real, detecção de anomalias e recuperação automatizada.
Clientes como Najm recuperaram o AD após um desastre emmenos de 2 minutos – eliminating the 35% manual workload that traditional approaches require. For lean teams managing complex hybrid environments, this approach helps deliver measurable speed, control, and confidence.
Perguntas frequentes
O que é o Commvault Identity Resilience e o que ele protege?
O Commvault Cloud Identity Resilience é uma plataforma unificada que ajuda as organizações a proteger, detectar ameaças internas e recuperar o AD, o Entra ID e o Okta em caso de incidentes cibernéticos, corrupção de dados e erros operacionais. Ela combina backups imutáveis em ambiente isolado (air-gapped), auditoria de alterações em tempo real, avaliações de vulnerabilidades e fluxos de trabalho automatizados de recuperação para ajudar a manter o acesso confiável antes, durante e após interrupções.
Por que o AD é um alvo frequente dos invasores?
O Active Directory (AD) gerencia o acesso a aplicativos, sistemas e dados em toda a empresa, o que o torna um alvo de grande valor. Se for comprometido, os invasores podem obter amplo acesso. O Commvault Cloud Identity Resilience ajuda a lidar com esse risco monitorando o AD em busca de alterações suspeitas, possibilitando a reversão por meio de auditoria em tempo real e detecção de anomalias, além de oferecer suporte à Recovery automatizada para ajudar a restaurar um estado confiável.
Como a Commvault ajuda a detectar ameaças à identidade em tempo real?
O Commvault Cloud ajuda a proporcionar visibilidade sobre as alterações no AD por meio de auditorias em tempo real que registram modificações em identidades, grupos e políticas. Ele ajuda a destacar alterações potencialmente arriscadas, como escalonamentos de privilégios, e permite ações de resposta, como a reversão de eventos de auditoria. O recurso de detecção de anomalias ajuda a identificar indicadores de comprometimento, para que as equipes possam investigar e responder com mais rapidez.
Como a Commvault automatiza a Recovery da floresta do AD?
O Commvault Cloud utiliza manuais de execução orquestrados, alinhados às abordagens recomendadas pela Microsoft, para automatizar todo o processo de recuperação da floresta. Isso ajuda a reduzir o trabalho manual e o risco de erros. Um plano de controle fornecido como SaaS pode permanecer acessível mesmo se o AD estiver offline, e o Cleanroom pode ajudar a validar o ambiente antes do retorno à produção.
A Commvault consegue recuperar objetos de identidade específicos sem precisar restaurar tudo?
O Commvault Cloud oferece suporte à recuperação granular de usuários, grupos, políticas e atributos, permitindo que as equipes lidem com alterações específicas sem precisar restaurar todo o ambiente. Esse recurso de recuperação no nível do objeto, que faz parte do Commvault Cloud Identity Resilience, ajuda a reduzir o tempo de recuperação e as interrupções operacionais, restaurando apenas o que é necessário, em vez de exigir uma reconstrução completa da floresta.
Qual é a diferença entre resiliência de identidade e IAM?
O IAM controla o provisionamento de usuários e as políticas de acesso durante as operações normais. A resiliência de identidade — oferecida pelo Commvault Cloud Identity Resilience — ajuda a lidar com as situações em que a infraestrutura de identidade é comprometida ou fica indisponível. As ferramentas de IAM não conseguem restaurar florestas do AD, reverter alterações maliciosas nem validar a recuperação em um ambiente isolado. A Commvault preenche essa lacuna pós-comprometimento.
Recursos relacionados
Resumo da solução
Resiliência de Identidade da Commvault
Conheça os detalhes técnicos de como o Commvault Cloud ajuda a proteger e recuperar o Active Directory, o Entra ID e o Okta contra ataques baseados em identidade.
Encare com realismo a resiliência de identidade: o novo imperativo para a defesa cibernética das empresas
Descubra por que os sistemas de identidade são um dos principais alvos de ataques e como a Recovery automatizada ajuda a minimizar as interrupções nos negócios após uma violação.
Conheça as medidas imediatas que sua organização pode adotar para proteger um ambiente com vários provedores de identidade (IdP), reduzir riscos e garantir uma Recovery rápida.
Years of reasonable technology decisions can accumulate into operational complexity that makes resilience harder to manage, govern, test, and maintain.
Fragmented tools, policies, workflows, and ownership can create inconsistent recovery models and make business-wide recovery difficult to predict.
Unified data protection can help reduce operational friction by simplifying control and standardizing protection across increasingly diverse environments.
Cyber resilience depends not only on safeguarding individual workloads but also on building security into recovery processes and continuously proving recovery readiness.
À medida que os ambientes de nuvem, SaaS, borda e IUmse expandem mais rapidamente do que as equipes, simplificar a arquitetura de resiliência torna-se cada vez mais importante para uma Recovery confiável e repetível.
One advantage of having spent part of my career on the operational side of backup and recovery is that I still can’t help looking at resilience through the eyes of the people who have to run it every day.
Years ago, the job was complicated, but it was generally clear. Most critical systems lived within a relatively defined set of boundaries. Protection strategies were comparatively standardized. Recovery planning focused on a known set of applications, databases, and infrastructure. The technology wasn’t simple, but the operating model was understandable.
Os processos de negócios abrangem aplicativos SaaS, serviços nativos da nuvem, múltiplas nuvens, ambientes de borda, iniciativas de IUme infraestrutura tradicional. Diferentes equipes são responsáveis por diferentes partes da pilha. As novas tecnologias surgem mais rapidamente do que as antigas são descontinuadas. E cada nova adição introduz novas dependências que podem não se tornar evidentes até que algo pare de funcionar ou precise ser recuperado.
Recentemente, participei de um webinar com Michael Thelander, diretor sênior de marketing de produto da Commvault, sobre como lidar com essa questão específica. Você pode assistirUmProteção Unificada de Dados como Base para a Resiliência on demand now.
Por que a proteção de dados está ficando cada vez mais difícil
What’s interesting is that most organizations didn’t intentionally design this complexity into their resilience architecture. They accumulated it over time.
As equipes de nuvem adotaram recursos nativos de proteção. Os responsáveis pelas aplicações implementaram processos adequados às plataformas que suportavam. As aquisições trouxeram tecnologias e modelos operacionais herdados. As unidades de negócios se otimizaram de acordo com suas próprias necessidades. Ummaioria dessas decisões foi razoável e, em muitos casos, necessária. O desafio é que cada uma dessas decisões acarretou um custo.
There’s the obvious cost of software, infrastructure, and storage. More significant, though, is the operational cost that accumulates quietly over the years. Every new protection method introduces another policy framework to manage, another workflow to document, another exception to troubleshoot, another recovery process to test, and another set of skills the organization must maintain.
No fim das contas, as equipes dedicam tanto tempo a gerenciar a complexidade associada à resiliência quanto a aprimorar a própria resiliência.
Por si só, isso pode parecer um problema de eficiência. Mas, com o tempo, isso se transforma em um problema de resiliência. Quanto mais elementos variáveis uma organização introduz, mais difícil se torna manter a consistência. Os procedimentos de Recovery evoluem de maneiras diferentes entre as equipes. As políticas se desviam. Umresponsabilidade se fragmenta. O conhecimento fica concentrado em um pequeno grupo de pessoas que entendem como tudo se encaixa.
Com o tempo, o desafio deixa de ser se as cargas de trabalho individuais podem ser protegidas e passa a ser se a organização consegue, de forma consistente, gerenciar, testar e recuperar tudo o que ela suporta. Ummaioria das organizações entende como os sistemas individuais se recuperam. Muito menos conseguem explicar com segurança como o negócio se recupera.
Umpesquisa recente sobre resiliência cibernética found that nearly half of organizations identify IT complexity as their biggest cyber resilience challenge. That finding isn’t particularly surprising. Most enterprises aren’t struggling because they lack protection technologies. In many cases, they have more protection technologies than ever before.
O desafio é entender como todas essas tecnologias se integram quando a organização realmente precisa delas.
A IA está tornando essa realidade ainda mais visível. Os modelos dependem de dados de treinamento, pipelines, infraestrutura, repositórios, identidades e serviços que, muitas vezes, abrangem várias equipes e ambientes. Proteger esses componentes individuais é um desafio. Recuperar o ecossistema que eles, coletivamente, sustentam é outro.
That’s one reason Michael and I spent so much time discussing complexity.
On the surface, unified data protection sounds like a conversation about backup architecture. In reality, our discussion centered on a much broader challenge: how organizations reduce the operational burden created by years of accumulated complexity while creating a more consistent foundation for resilience.
Because the goal isn’t consolidation for consolidation’s sake. It’s all about reducing operational friction. Creating consistency where consistency matters. And making recovery more predictable, repeatable, and trustworthy.
De ferramentas fragmentadas a uma base unificada
During the webinar, Michael and I explored four practical ways organizations can begin reducing complexity and strengthening resilience: simplifying control, standardizing protection, building cyber resilience directly into the recovery process, and continuously proving recovery readiness.
While the tactics differ, the objective is the same. The less effort organizations spend stitching together fragmented tools, policies, and workflows, the more confidence they can have in their ability to recover when it matters most.
What stayed with me long after the conversation ended was the recognition that resilience has become as much an operational and architectural challenge as a technical one. Organizations are being asked to support more applications, more clouds, more services, more data, and more AI initiatives than ever before. Yet few have the luxury of expanding teams at the same pace. That reality makes simplicity increasingly valuable.
If I were running backup and recovery operations today and I were re-evaluating my organization’s approach, I wouldn’t start by asking whether we have enough protection tools. I’d start by asking how much complexity we’re carrying and what it’s costing us. Because those costs extend far beyond software licenses and infrastructure. They’re reflected in operational effort, fragmented processes, inconsistent recovery models, and ultimately in an organization’s ability to recover when it matters most.
Perguntas frequentes
P: Por que a proteção de dados se tornou mais complexa para as organizações?R:Atualmente, os processos de negócios abrangem aplicativos SaaS, serviços nativos da nuvem, múltiplas nuvens, ambientes de borda, iniciativas de IA e infraestrutura tradicional. À medida que as equipes adotam diferentes métodos de proteção para esses ambientes, as organizações acumulam políticas, fluxos de trabalho, competências e dependências que aumentam a carga operacional relacionada à resiliência. P: Como a complexidade tecnológica pode afetar a resiliência cibernética?R:Um número maior de ferramentas e processos pode tornar mais difícil manter políticas, responsabilidades, testes e procedimentos de Recovery consistentes em toda a organização. Com o tempo, essa fragmentação pode transformar o que inicialmente parece ser um desafio de eficiência em um desafio de resiliência. P: Qual é o objetivo da proteção unificada de dados?R:A proteção unificada de dados vai além da simples consolidação de tecnologias de backup. Seu objetivo mais amplo é reduzir atritos operacionais, garantir consistência onde é importante e tornar a recuperação mais previsível, repetível e confiável. P: Que medidas práticas as organizações podem adotar para reduzir a complexidade da resiliência?R:As organizações podem se concentrar em simplificar o controle, padronizar a proteção, incorporar a resiliência cibernética diretamente nos processos de Recovery e comprovar continuamente a Readiness para Recovery. Juntas, essas práticas podem reduzir o esforço necessário para coordenar ferramentas, políticas e fluxos de trabalho fragmentados. P: Por que a IA torna a complexidade da resiliência mais visível?R:As iniciativas de IA podem depender de dados de treinamento, pipelines, infraestrutura, repositórios, identidades e serviços interconectados, abrangendo várias equipes e ambientes. Proteger cada componente individualmente não resolve necessariamente o desafio maior de recuperar todo o ecossistema que esses componentes sustentam. P: O que as organizações devem levar em consideração ao reavaliar sua estratégia de proteção de dados?R: Rather than starting with whether they have enough protection tools, organizations should examine how much operational complexity they are carrying and what it costs them. That includes the impact of fragmented processes, inconsistent recovery models, administrative effort, and the organization’s overall ability to recover when it matters most.
Jason Gizaé gerente sênior de Marketing de Soluções para Parceiros na Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
O que é o Objetivo de Ponto de Recuperação (RPO)? Um guia completo
Recovery point objective (RPO) defines how much data your organization can afford to lose after a disruption – and it shapes every backup, replication, and recovery decision you make.
Recovery point objective (RPO) is the maximum amount of data – measured in time – that your organization can lose after an unplanned disruption and still operate within acceptable limits.
Pense no RPO como um relógio de perda de dados: ele começa a contar regressivamente a partir do momento em que ocorre uma interrupção, um ataque cibernético ou um erro humano, e para no seu último ponto de backup ou replicação utilizável. Cada segundo entre esses dois pontos representa dados que você talvez nunca consiga recuperar.
NISTdefine o RPO as “the point in time to which data must be recovered after an outage.” That definition is deceptively simple. In practice, setting the right RPO raises important questions about which workloads matter most, how often you back up, and how much you invest in replication infrastructure.
Cyberattacks, cloud outages, and accidental deletions happen on schedules you do not control. Organizations that define clear RPO targets – and enforce them with automated, policy-driven backup – position themselves to recover within business tolerance instead of scrambling after the fact.
This guide walks you through how RPO works, how it differs from recovery time objective (RTO), what are some real-world examples, calculating RPO, and RPO’s critical role in cyber resilience.
Como o RPO funciona no planejamento de continuidade de negócios
RPO is the “data-loss clock” that shapes your backup frequency. If your RPO for a database is one hour, backups should run at least every 60 minutes. Miss that cadence and you may have already exceeded your tolerance before anything goes wrong.
In a business continuity plan, RPO sits alongside RTO as one of two recovery pillars. While RTO answers “How fast can we get systems running again?” RPO answers “How current will the recovered data be?” Both feed into the broader disaster recovery strategy – and both should be validated through regular testing, not just documented in a binder.
O RPO também pode ter uma dimensão de conformidade:
Normas como a HIPAA geralmente exigem que as instituições de saúde mantenham cópias recuperáveis das informações eletrônicas sobre a saúde dos pacientes.
A SOX inclui disposições relativas à manutenção de registros financeiros auditáveis e intactos.
O RGPD prevê que o tratamento de dados pessoais deva poder ser restabelecido em tempo hábil após um incidente técnico.
When an attack encrypts production data, the gap between your last clean backup and the encryption timestamp is the data you lose. That gap is your RPO in action – and it helps determine whether recovery takes hours or becomes a crisis.
The practical takeaway: RPO is not a number you set once and forget. It should reflect current data-change rates, compliance mandates, and threat landscape realities – and it should be enforced through automated backup policies.
RPO vs. RTO: What’s the Difference?
RPO e RTO são dois lados da mesma moeda no que diz respeito à Recovery, mas medem aspectos diferentes.
RPO looks backward from the moment of failure. It asks: “How much data can we afford to lose?” The answer is expressed in time – minutes, hours, or days – representing the gap between the last good backup and the disruption.
RTO looks forward from the moment of failure. It asks: “How quickly must systems be back online?” The answer is also expressed in time, but it measures downtime tolerance rather than data-loss tolerance.
Dimensão
RPO
RTO
Focus
Tolerância à perda de dados
Tolerância a tempo de inatividade
Medidas
Tempo decorrido desde o último backup válido
É hora de restabelecer o serviço
Direção
Retrospectivo (antes da falha)
Perspectiva futura (após o fracasso)
Pergunta-chave
Quantos dados podemos perder?
Por quanto tempo podemos ficar fora do ar?
Exemplo
RPO de 1 hora = Backups a cada hora
RTO de 4 horas = Sistemas restaurados em quatro horas
Both metrics should be defined together. An organization with a 15-minute RPO but a 24-hour RTO has recent data that sits idle for a full day. Conversely, a four-hour RTO paired with a 24-hour RPO means systems come back quickly – but with stale data.
Aligning RPO and RTO targets before an incident – and validating them through regular disaster recovery testing – can be the difference between a measured response and a scramble.
Níveis de RPO e exemplos da prática
Nem toda carga de trabalho merece o mesmo RPO. Classificar os RPOs por nível de importância para os negócios ajuda a manter a proteção rigorosa onde é essencial e os custos sob controle onde não é.
Nível 0: RPO próximo de zero (segundos a minutos): Bancos de dados de transações financeiras, prontuários eletrônicos de pacientes e plataformas de negociação em tempo real geralmente exigem proteção contínua de dados (CDP) ou replicação síncrona. Essas cargas de trabalho geram receita ou têm implicações regulatórias a cada segundo; portanto, mesmo alguns minutos de perda de dados podem ser difíceis de suportar. As organizações que implementam um RPO próximo de zero geralmente utilizam CDP ou replicação síncrona para ajudar a minimizar a janela de perda de dados.
Tier 1: 1–4 Hours: Customer relationship management (CRM) systems, email platforms, and order processing systems often fall here. Frequent incremental backups – every 15 to 60 minutes – help keep data loss within tolerance. The cost is moderate, and the business impact of losing a few hours of email or CRM updates is generally manageable with manual re-entry.
Tier 2: 4–12 Hours: Internal collaboration tools, development environments, and project management platforms commonly operate in this range. Scheduled backups every 4 to 6 hours can strike a balance between protection and storage costs.
Tier 3: 12– 24 Hours: Marketing analytics archives, historical logs, and reference documentation often tolerate daily cloud backups. Data changes slowly and reconstruction is feasible, making daily backup cadences cost-effective.
A classificação por camadas ajuda as organizações a concentrar o máximo de recursos na proteção das cargas de trabalho em que cada minuto de perda de dados acarreta o maior custo, evitando, ao mesmo tempo, gastos excessivos com arquivos que são atualizados apenas uma vez por semana.
Como calcular o RPO para sua organização
Calculating RPO is a business exercise first and a technical exercise second. These steps can help set RPOs that reflect reality, not aspiration.
Identifique os dados críticos.
Catalogue suas cargas de trabalho e classifique-as de acordo com o impacto nos negócios. Pergunte-se: se esse sistema perdesse dados, o que aconteceria com a receita, a conformidade e a confiança dos clientes? As respostas ajudam a orientar a atribuição de níveis.
Avaliar as taxas de variação dos dados.
Um banco de dados que processa 10.000 transações por hora normalmente exige um RPO mais restrito do que um repositório de documentos atualizado duas vezes por dia. Avalie as taxas reais de alteração, e não as estimativas.
Verifique os requisitos de conformidade.
Mapeie cada carga de trabalho às obrigações regulatórias aplicáveis. A HIPAA, a SOX, a PCI DSS e o GDPR podem, cada uma, incluir requisitos de retenção e recuperabilidade de dados que influenciam o RPO.
Avaliar o orçamento e a infraestrutura.
Near-zero RPO typically involves CDP, synchronous replication, or both – and that infrastructure has a cost. Align your RPO targets with what your budget can sustain.
Defina RPOs em níveis e automatize a aplicação.
Assign each workload to an RPO tier, configure backup policies to match, and automate compliance monitoring. An RPO that exists only in a spreadsheet offers limited protection – enforcement should be continuous and policy-driven.
Reviewing and recalibrating quarterly is good practice. Data volumes grow, workloads shift, and threat landscapes evolve – your RPOs should keep pace.
RPO e resiliência cibernética
Ransomware does not care about your backup schedule – but your RPO determines how much leverage attackers have. A tight RPO means less data sits between your last immutable backup and the encryption event, helping reduce the blast radius of an attack.
A resiliência cibernética não depende apenas da frequência dos backups. Cópias de backup imutáveis e isoladas (air-gapped) ajudam a proteger contra invasores que comprometem ambientes de produção, impedindo que eles acessem ou alterem os dados de recuperação. Quando esses backups são armazenados fora da conta principal na nuvem, você adiciona um nível de isolamento que o ransomware simplesmente não consegue ultrapassar.
É aqui que o Clúmio da Commvault se encaixa na sua estratégia de RPO. ComClúmio, you store backup data in an isolated, fully managed environment outside your primary AWS account. Granular point-in-time recovery helps you restore to a precise moment before the attack – helping minimize data loss to the RPO you defined. Designed to help you maintain control of your recovery without depending on the same infrastructure the attacker compromised.
As organizações que mantêm RPOs rigorosos com backups imutáveis e isolados podem evitar o pagamento de resgate, pois conseguem recuperar dados intactos de forma independente.
A fórmula é simples: um RPO mais restrito, aliado a backups imutáveis e isolados, geralmente resulta em uma superfície de ataque menor e em uma recuperação mais rápida e limpa. Essa é a base da resiliência cibernética.
Perguntas frequentes
O que significa RPO?
RPO significa “Recovery Point Objective” (Objetivo de Ponto de Recuperação). Ele define a quantidade máxima aceitável de perda de dados, medida em tempo, após uma interrupção não planejada, como um ataque cibernético, falha de hardware ou erro humano.
O que é um bom RPO?
Um bom RPO depende da carga de trabalho. Sistemas financeiros e de saúde geralmente exigem RPOs próximos de zero, enquanto ferramentas internas podem tolerar de 4 a 12 horas. O RPO adequado equilibra o impacto nos negócios, os requisitos de conformidade e as dotações orçamentárias.
Qual é a diferença entre RPO e objetivo de tempo de recuperação (RTO)?
O RPO mede a quantidade de dados que você pode perder, expressa como o tempo decorrido desde o último backup. O RTO mede por quanto tempo os sistemas podem permanecer fora do ar. O RPO analisa o que aconteceu após uma falha; o RTO analisa o que acontecerá a partir de então. Ambos devem ser definidos em conjunto em um plano de recuperação de desastres.
O RPO pode ser zero?
Um RPO igual a zero significa que não há perda alguma de dados. Para alcançá-lo, é necessária uma replicação síncrona, na qual cada gravação é confirmada no sistema secundário antes de ser reconhecida. Isso é tecnicamente possível, mas pode ser caro; por isso, a maioria das organizações reserva essa prática para suas cargas de trabalho mais críticas.
Como o RPO afeta a frequência dos backups?
O RPO determina diretamente a frequência dos backups. Um RPO de uma hora exige backups a cada 60 minutos, no mínimo. Um RPO de 24 horas permite backups diários. Quanto mais restrito for o RPO, mais frequente deve ser a cadência dos backups ou da replicação.
Quais fatores determinam o RPO?
Os principais fatores incluem a importância dos dados para os negócios, a frequência com que os dados geralmente se alteram, os requisitos regulatórios e de conformidade aplicáveis, o orçamento disponível para a infraestrutura de backup e a tolerância geral da organização ao risco. A maioria das organizações define seus níveis de RPO com base nesses fatores.
Planejamento de continuidade de negócios para a era Cloud
Um plano moderno de continuidade de negócios começa com a proteção dos seus dados na nuvem. Conheça os principais componentes, benefícios e práticas recomendadas para a continuidade de negócios nativa da nuvem.
A complexidade da nuvem multiplica o desafio. Atualmente, a maioria das empresas opera com vários provedores de nuvem, cada um com diferentes modelos de segurança, mecanismos de backup eresponsabilidade compartilhada boundaries. Data sprawl across Amazon S3 buckets, DynamoDB tables, and data lakehouse environments creates blind spots. The responsabilidade compartilhada model means your cloud provider secures the infrastructure, but you own the protection and recoverability of your data.
O impacto comercial de uma interrupção não planejada vai muito além do tempo de inatividade. A perda de receita aumenta a cada minuto. A confiança do cliente, uma vez abalada, leva meses ou anos para ser reconstruída. As multas regulatórias previstas em regulamentações como o GDPR, a HIPAA e a SOX podem chegar a milhões. E os danos à reputação costumam perdurar por mais tempo do que o próprio incidente.
A well-structured business continuity plan transforms your organization from reactive to resilient. It defines exactly how you will protect critical data, recover operations, and communicate with stakeholders when disruption strikes. Without one, recovery becomes improvisation — and improvisation under pressure rarely ends well.
Um plano robusto de continuidade de negócios na nuvem baseia-se em componentes interconectados que atuam em conjunto antes, durante e após um incidente.
Análise de Impacto nos Negócios e Avaliação de Riscos
Start with a business impact analysis (BIA) to identify your most critical workloads and quantify the cost of downtime for each. Pair this with a risk assessment that maps threats — ransomware, cloud provider outages, insider errors, compliance failures — to specific data assets. This analysis drives every decision that follows.
Metas de RTO/RPO por carga de trabalho
Nem todos os dados têm a mesma importância. Defina os objetivos de tempo de recuperação (RTO) eobjetivos do ponto de recuperação (RPO)para cada carga de trabalho, com base em sua importância para os negócios. Um banco de dados voltado para o cliente pode exigir um RPO de minutos, enquanto logs arquivados podem tolerar horas. Metas diferenciadas evitam gastos excessivos em ativos de baixa prioridade e investimentos insuficientes nos de alta prioridade.
Estratégia de backup na nuvem
Sua estratégia de backup deve ser automatizada e orientada por políticas. Processos manuais introduzem erros humanos e não permitem escalabilidade. Defina políticas que capturem alterações continuamente, armazenem backups em ambientes isolados e ofereçam suporte à recuperação granular no nível de objeto, prefixo, bucket, tabela ou partição. Explore suaopções de backup na nuvemantes de se comprometer com uma única abordagem.
Protocolos de comunicação e escalonamento
Documente quem é responsável por cada aspecto durante um incidente. Defina procedimentos de escalonamento, prazos de notificação e canais de comunicação para equipes internas, executivos, clientes e órgãos reguladores. Um plano de recuperação que ninguém consegue executar não é um plano de verdade.
Testes e Manutenção
O plano de continuidade de negócios mais perigoso é aquele que nunca foi testado. Programe simulados de Recovery pelo menos uma vez por trimestre para verificar se suas metas de RTO/RPO são viáveis e se sua equipe conhece o manual de procedimentos.
Benefícios das tecnologias nativas da nuvem
A transição da sua estratégia de continuidade de negócios para soluções nativas da nuvem oferece vantagens mensuráveis em relação às abordagens tradicionais no local.
Escalabilidade sem sobrecarga de infraestrutura. O backup nativo da nuvem se adapta automaticamente ao crescimento dos seus dados. Você não precisa provisionar servidores, matrizes de armazenamento ou Appliances adicionais. À medida que seus buckets do S3 e bancos de dados crescem, sua proteção cresce junto com eles.
Eficiência de custos. Uma abordagem sem servidor, baseada em SaaS, elimina os gastos de capital com hardware dedicado ao backup. Você paga apenas pela proteção que utiliza, e os custos operacionais permanecem previsíveis à medida que os volumes de dados aumentam.
Maior segurança por meio do isolamento. Backups imutáveis e isolados fisicamente, armazenados fora de sua conta principal na nuvem, criam uma camada crítica de defesa. Se um ransomware comprometer seu ambiente de produção, seus dados de backup permanecerão intactos em um cofre isolado. Essa separação é o que faz a diferença entre pagar um resgate e restaurar seus dados nos seus próprios termos.
Rapid, granular recovery. Cloud-native solutions enable targeted recovery — restoring specific objects, prefixes, buckets, tables, or partitions rather than entire environments. This precision reduces recovery time dramatically and minimizes disruption to unaffected workloads.
Resiliência em múltiplas nuvens. As organizações operam cada vez mais na AWS, no Azure e no Google Cloud. As soluções de backup nativas da nuvem oferecem suporte à Recovery entre regiões e entre contas, proporcionando flexibilidade para restaurar dados onde quer que seja necessário.
O mercado de proteção de dados na nuvem continua a crescer à medida que as organizações reconhecem essas vantagens. Com a expansão das cargas de trabalho na nuvem e o aumento das ameaças, os investimentos em infraestrutura de resiliência estão se acelerando em todos os setores.Para saber mais sobre comoClumio’sA proteção nativa para a nuvem oferece suporte arecuperação de ransomware,Explorarnossopágina dedicada à solução.
Melhores práticas de continuidade
Effective business continuity planning is not a one-time project — it is an ongoing discipline. These practices help you build and maintain a plan that holds up under real-world pressure.
Realize avaliações de risco regularmente.
O cenário de ameaças muda constantemente. Analise seu perfil de risco pelo menos uma vez por trimestre e atualize sua Análise de Impacto nos Negócios (BIA) sempre que adicionar novas cargas de trabalho na nuvem, trocar de provedor ou passar a operar em novas jurisdições regulatórias.
Defina e teste suas metas de RTO/RPO.
Estabelecer metas no papel é o primeiro passo. É por meio da validação dessas metas em exercícios reais de Recovery que se constrói a Readiness. Teste as restaurações em relação aos objetivos definidos e documente as lacunas. Reavalie essas metas à medida que as necessidades da empresa evoluem.
Adote uma estratégia de backup em múltiplas nuvens.
Do not rely on a single provider’s native tools for backup and recovery. Cross-account and cross-region backup capabilities protect you against account-level compromise and regional outages alike.
Automatize as políticas de backup.
Os processos manuais de backup são vulneráveis. Implemente uma automação orientada por políticas que capture as alterações nos dados de forma contínua, sem depender de instantâneos programados, que podem deixar de registrar atualizações críticas entre os intervalos.
Incorpore a segurança à sua estratégia de backup.
Air-gapped storage, immutable backups, role-based access controls, and threat scanning should be standard features of your backup solution — not afterthoughts. Your backup data is a high-value target; protect it accordingly.
Faça testes pelo menos uma vez por trimestre.
Recovery drills should simulate realistic scenarios, including ransomware events and accidental bulk deletions. Testing reveals where your plan falls short before an actual incident occurs.
Suporte para backup na nuvem
A modern business continuity plan requires purpose-built cloud backup — not legacy tools adapted for cloud environments. Traditional backup solutions were designed for on-premises infrastructure and struggle with the scale, speed, and architecture of cloud-native workloads.
Clumio da Commvaultfoi desenvolvida desde o início para ambientes em nuvem. Como uma plataforma sem servidor, baseada em SaaS e projetada para a AWS e o Google Cloud, a Clumio oferece os recursos de Recovery exigidos pela continuidade dos negócios, sem a necessidade de infraestrutura gerenciada pelo cliente nem complexidade operacional.
Backups com porta de ar. A Clumio armazena os dados de backup em um ambiente imutável e isolado, totalmente separado da sua conta de produção na nuvem. Essa arquitetura isolada significa que, mesmo que um ransomware ou o comprometimento de uma conta afete seu ambiente principal, seus dados de backup permanecem protegidos e recuperáveis.
Granular recovery at scale. Rather than forcing full-environment restores, Clumio enables targeted recovery at the object, prefix, bucket, partition,outable level. When a bad code push corrupts specific data, you recover exactly what was affected — nothing more, nothing less.
Restauração entre regiões e entre contas. O Clumio oferece caminhos flexíveis de Recovery, incluindo a restauração de dados para diferentes regiões ou contas. Esse recurso é essencial em cenários de desastre em que uma região ou conta inteira seja comprometida.
Clumio Backtrack para reversão a um ponto específico no tempo. O Clumio Backtrack permite a reversão no próprio local deAmazon S3ouDynamoDB data to a precise point in time. This is invaluable to help recover data corruptionouaccidental deletion without the delay of traditional restore workflows.
The speed of recovery matters. Purpose-built cloud backup compresses that timeline from weeks to hours —ouminutes — transforming business continuity from aspiration into operational reality.
Perguntas frequentes
O que é um plano de continuidade de negócios?
Um plano de continuidade de negócios é uma estratégia documentada que descreve como uma organização manterá suas operações essenciais durante e após uma interrupção. Ele abrange tudo, desde procedimentos de proteção e recuperação de dados até protocolos de comunicação e caminhos de escalonamento. Em organizações que priorizam a nuvem, o plano se concentra na proteção das cargas de trabalho na nuvem, na definição de metas de RTO/RPO e na validação da recuperação por meio de testes regulares.
Qual é a diferença entre BCP e DRP?
O planejamento de continuidade de negócios (BCP) é a disciplina mais ampla, voltada para manter todas as funções críticas da empresa em funcionamento durante uma interrupção. O planejamento de recuperação de desastres (DRP) é um subconjunto do BCP, voltado especificamente para a restauração de sistemas de TI, aplicativos e dados após um incidente. Um BCP robusto inclui um DRP, mas também aborda questões de comunicação, pessoal e procedimentos operacionais além da área de TI.
Quais são os principais componentes de um plano de continuidade de negócios na nuvem?
Um plano de continuidade de negócios na nuvem inclui uma análise de impacto nos negócios, metas definidas de RTO/RPO por carga de trabalho, uma estratégia automatizada de backup na nuvem, protocolos de comunicação e escalonamento e uma cadência regular de testes. Cada componente deve levar em conta as características específicas dos ambientes de nuvem, incluindo modelos de responsabilidade compartilhada, arquiteturas multinuvem e dispersão de dados.
Por que o backup nativo da nuvem é importante?
O backup nativo da nuvem foi desenvolvido especificamente para a escala e a arquitetura das cargas de trabalho na nuvem. Ao contrário das ferramentas legadas adaptadas para a nuvem, as soluções nativas da nuvem oferecem proteção automatizada orientada por políticas, armazenamento isolado (air-gapped), recuperação granular e operação sem servidor. Esses recursos contribuem diretamente para tempos de Recovery mais rápidos e melhores resultados em termos de continuidade de negócios.
Com que frequência você deve testar seu plano?
Teste seu plano de continuidade de negócios pelo menos uma vez por trimestre. Cada teste deve simular cenários realistas de interrupção — incluindo ransomware, exclusões acidentais e interrupções no serviço do provedor de nuvem — e confirmar se as metas de RTO/RPO definidas são alcançáveis. Documente os resultados, identifique lacunas e atualize o plano de acordo com as necessidades.
O que é um backup isolado fisicamente?
Um backup em ambiente isolado (air-gapped) é armazenado em um ambiente isolado, ao qual não há acesso direto a partir da rede de produção ou da conta na nuvem. Esse isolamento protege os dados de backup contra ransomware, ameaças internas e violações no nível da conta. Os backups em ambiente isolado são um componente essencial de uma estratégia resiliente de continuidade de negócios, pois fornecem uma cópia limpa e recuperável dos dados, mesmo quando os sistemas de produção estão totalmente comprometidos.
Requisitos de conformidade com a norma SOC 2: o que são e como a proteção de dados se encaixa nisso
Os requisitos de conformidade com a norma SOC 2 definem como as organizações prestadoras de serviços comprovam que protegem os clientesdados econheceringIsso depende de mais do que apenas firewalls e controles de acesso.
SOC 2 is a voluntary auditing framework created by the AICPA that evaluates how service organizations manage customer data. Unlike regulatory mandates such as HIPAA or PCI DSS, SOC 2 is not a law. It is an audit report issued by an independent CPA firm that assesses your organization’s controls against the AICPA’s Critérios dos Serviços Fiduciários.
A estrutura se aplica a qualquer empresa de tecnologia ou prestadora de serviços que armazene, processe ou transmita dados de clientes. Na prática, isso significa que provedores de SaaS, empresas de hospedagem em nuvem, empresas de análise de dados e provedores de serviços gerenciados são os candidatos mais comuns. Mas o público-alvo se ampliou significativamente.
Atualmente, as equipes de compras das empresas solicitam rotineiramente relatórios SOC 2 durante as avaliações de fornecedores, tornando a auditoria um requisito de fato para fazer negócios com grandes organizações. O que diferencia o SOC 2 é sua flexibilidade. Não se trata de marcar itens em uma lista fixa de conformidade.
Instead, you define the scope of your audit by selecting which of the five Critérios dos Serviços Fiduciários apply to your services. Your auditor then evaluates whether your controls meet those criteria effectively.
SOC 2 compliance requirements push you toward exactly that kind of structured, documented approach to security and data protection, one that can lower both risk and cost. The AICPA’s Critérios dos Serviços Fiduciários framework provides the structure, and the audit report gives your customers the evidence they need.
Critérios dos Serviços Fiduciários
The five Critérios dos Serviços Fiduciários form the backbone of every SOC 2 audit. Each criterion addresses a specific dimension of how you protect and manage data. Security is the only mandatory criterion, but most organizations include at least one or two additional criteria based on their services and customer expectations.
Security (Common Criteria) – Security is the foundation of every SOC 2 report. The Common Criteria covers logical and physical access controls, system operations monitoring, change management, and risk mitigation.
Controles como o CC6.4 (restrição do acesso físico e lógico aos ativos de informação) e o CC6.7 (restrição da transmissão, movimentação e remoção de informações) são fundamentais para demonstrar que você protege os sistemas contra acessos não autorizados e ameaças. Toda auditoria SOC 2 inclui o critério de Segurança, independentemente dos outros critérios que você selecionar.
Availability – Availability addresses whether your systems are operational and accessible as committed in your service-level agreements. This is where data protection becomes critical. Control A1.2 requires you to maintain backup processes and recovery infrastructure. Control A1.3 requires you to test your recovery plan, not just document one.
Os auditores querem verificar se você é capaz de restaurar sistemas e dados dentro dos objetivos de tempo de recuperação e dos objetivos de ponto de recuperação definidos.Clumio’s operational recovery capabilitiesforam desenvolvidos especificamente para isso: backup orientado por políticas, com agendamento automatizado e armazenamento isolado fisicamente, que atende tanto à norma A1.2 quanto à A1.3.
Confidentiality – Confidentiality criteria (C1.1 and C1.2) focus on protecting information designated as confidential. This includes encryption of data at rest and in transit, retention policies that define how long confidential data is kept, and secure destruction processes when retention periods expire.
Processing integrity – Processing integrity evaluates whether your systems process data completely, accurately, and in a timely manner. This criterion is most relevant for organizations whose core service involves data transformation, calculation, or transaction processing.
Privacy – Privacy addresses how you collect, use, retain, disclose, and dispose of personal information. It overlaps significantly with GDPR and CCPA requirements, making it a common addition for organizations that handle PII across jurisdictions.
Tipos de SOC 2
As auditorias SOC 2 podem ser de dois tipos, e essa distinção é importante. Um relatório SOC 2 Tipo 1 avalia se seus controles estão adequadamente projetados em um determinado momento. Pense nisso como um instantâneo: o auditor confirma que suas políticas e controles existem e estão adequadamente estruturados na data da avaliação.
Um relatório SOC 2 Tipo 2 vai além. Ele avalia se esses controles realmente funcionam de maneira eficaz durante um período definido, normalmente de seis a 12 meses. Os auditores analisam evidências de execução consistente, incluindo registros de atividades, registros de alterações, relatórios de verificação de backup e documentação de resposta a incidentes.
O Tipo 2 é o padrão esperado pelos compradores corporativos. Um relatório do Tipo 1 pode servir como uma etapa intermediária enquanto você constrói seu histórico de auditorias, mas a maioria das equipes de compras exigirá um relatório SOC 2 Tipo 2 antes de assinar um contrato.
É o período prolongado de observação que confere credibilidade ao relatório: ele comprova que seus controles funcionam na prática, e não apenas no papel.
Mapeamento de controles
A proteção de dados não é uma questão secundária em uma auditoria SOC 2. Ela está diretamente relacionada a diversos controles nos critérios de Segurança e Disponibilidade. No entanto, muitas organizações negligenciam o Backup and Recovery ao se prepararem para a auditoria, concentrando-se, em vez disso, nos controles de acesso e na segurança de rede.
Veja a seguir como os controles específicos do SOC 2 se alinham aos recursos de proteção de dados:
CC6.4
Restringir o acesso aos ativos de informação
Clumio armazena os backups em um ambiente isolado e sem conexão com a rede externa (air-gapped), com criptografia dedicada, separado da sua conta principal na nuvem. Esse isolamento administrativo ajuda a atender ao requisito de controle para restringir o acesso lógico às informações protegidas.
CC7.5
Identificar e responder a incidentes de segurança
Clumio permite a recuperação entre contas e regiões, auxiliando nos testes de resposta a incidentes e na restauração rápida quando os ambientes de produção são comprometidos.
CC9.1
Identificar e gerenciar riscos
Policy-driven backup with automated scheduling helps eliminate manual processes and custom scripts, which also helps reduce operational risk. Clumio’s serverless architecture scales automatically without infrastructure overhead.
A1.2
Manter a infraestrutura de Backup and Recovery
Clumio’s policy-based asset selection and offsite, air-gapped storage help deliver the backup processes and recovery infrastructure that auditors evaluate.
A1.3
Teste os planos de recuperação
O Clumio oferece suporte a testes de restauração tanto por meio de seu console de gerenciamento quanto por meio da API, ajudando você a apresentar ao seu auditor testes de recuperação documentados e repetíveis.
Lista de verificação de conformidade
Uma abordagem estruturada aos requisitos de conformidade com a SOC 2 ajuda a manter sua auditoria nos trilhos e a reduzir a probabilidade de ocorrência de lacunas. Siga estas etapas:
Defina seu escopo e selecione os critérios dos serviços de confiança.
Determine quais critérios se aplicam com base nos seus serviços e nos compromissos assumidos com os clientes. A segurança é obrigatória; acrescente disponibilidade, confidencialidade, integridade do processamento ou privacidade, conforme necessário.
Realize uma avaliação de Readiness.
Identifique em que aspectos seus controles atuais atendem aos critérios e onde existem lacunas. Esse é o seu roteiro.
Implementar controles e documentar políticas.
Implemente os controles técnicos e administrativos exigidos por cada critério. Documente tudo: políticas, procedimentos, configurações e responsabilidades.
Realizar testes internos, incluindo a validação do Backup and Recovery.
Verifique se seus controles funcionam conforme o esperado. No que diz respeito à disponibilidade, isso significa testar a integridade dos backups, os procedimentos de restauração e os processos de failover.
Envolva seu auditor.
Escolha uma empresa independente de contabilidade com experiência em SOC 2. O auditor definirá o período de observação para um relatório do Tipo 2 e delineará os requisitos de evidência.
Corrija as lacunas e obtenha seu relatório.
Corrija todas as não conformidades identificadas na auditoria e receba seu relatório SOC 2 final. Começar com uma lista de verificação clara ajuda você a passar da fase de preparação para a auditoria com menos surpresas.
Perguntas frequentes
Quais são os 5 critérios do SOC 2?
Os cinco critérios dos Serviços de Confiança do SOC 2 são: Segurança, Disponibilidade, Confidencialidade, Integridade do Processamento e Privacidade. O critério de Segurança, também conhecido como Critérios Comuns, é obrigatório em todas as auditorias SOC 2. Sua organização seleciona critérios adicionais com base nos serviços que presta e nos compromissos contratuais assumidos com os clientes.
O que é SOC 2 Tipo 1 em comparação com o Tipo 2?
Um relatório SOC 2 Tipo 1 avalia se os seus controles foram adequadamente projetados em um determinado momento. Um relatório SOC 2 Tipo 2 avalia se esses controles funcionam de maneira eficaz ao longo de um período de seis a 12 meses. O Tipo 2 é mais rigoroso e é o padrão exigido pela maioria das empresas compradoras.
Quanto tempo leva para obter a conformidade com a SOC 2?
Para uma auditoria inicial, o processo completo deve levar de seis a 12 meses. Isso inclui a avaliação da Readiness, a implementação dos controles, o período de observação e a própria auditoria.
Com que frequência é exigida a conformidade com a norma SOC 2?
Um relatório SOC 2 Tipo 2 abrange um período de observação específico, geralmente de 12 meses. A maioria das organizações renova anualmente para manter um histórico de auditoria ininterrupto e ajudar a atender aos requisitos contínuos de clientes e de compras.
A conformidade com a norma SOC 2 é obrigatória?
O SOC 2 é uma estrutura voluntária, não uma exigência legal. No entanto, clientes corporativos, parceiros e equipes de compras exigem cada vez mais um relatório SOC 2 Tipo 2 atualizado antes de assinar contratos. Na prática, isso se tornou uma expectativa básica para qualquer organização prestadora de serviços que lide com dados de clientes.
Pontos principais
ResOps is not a technology product. It’s a cross-functional operating discipline that helps drive organizational cyber resilience.
Ele complementa o backup, a recuperação de desastres, a segurança cibernética, a continuidade dos negócios e a resposta a incidentes, alinhando essas funções em torno de resultados de recuperação de ponta a ponta.
O ResOps concentra-se em serviços essenciais e nos limites de impacto definidos pela empresa, em vez de componentes isolados da infraestrutura.
Baseia-se na geração contínua de evidências, incluindo resultados comprovados de Recovery, indicadores de resiliência dos serviços e um registro próprio das lacunas.
O ResOps é um processo contínuo. Nem a elaboração de um plano nem a realização de um exercício pontual bem-sucedido são suficientes para estabelecer uma capacidade de recuperação duradoura.
O novo desafio da resiliência
A maioria das organizações investe em segurança cibernética, backup,Recovery de desastres, and continuidade dos negócios. Yet many executives still face three critical questions: Can we recover? How long will recovery take? And can we prove it?
Part of the challenge is that responsibility for resilience is spread across teams that often operate in silos. Security manages threats. IT maintains systems. Backup and Recovery de desastres teams restore data and infrastructure. Business continuity teams focus on keeping the organization running. Each plays an important role, but responsibility for recovery can remain fragmented.
ResOps brings these functions together around shared priorities, recovery goals, and evidence. The result is a more practical way to approach resilience: know what matters most, understand what it takes to recover it, test whether recovery works, and act on the gaps you find.
P: O que é ResOps?
ResOpsé a disciplina operacional que integra segurança, infraestrutura e operações de TI,continuidade dos negócios, e reúne os proprietários de negócios em torno de serviços essenciais, projeto resiliente e validação contínua. Em termos simples, o ResOps ajuda as equipes a se prepararem para interrupções, a recuperar serviços essenciais dentro dos limites de tolerância a impactos definidos pela empresa e a demonstrar, com base em evidências, que a recuperação funciona.
Quatro características definem o ResOps. Ele é:
Multifuncional por natureza. O ResOps conecta responsabilidades distribuídas por meio de um modelo operacional compartilhado, responsabilidade nomeada e governança executiva.
Focado em serviços essenciais. Prioriza os serviços que a organização deve restabelecer para oferecer valor fundamental, atender aos clientes e gerar receita; além de ajudar a cumprir obrigações urgentes de natureza jurídica, regulatória, de segurança e relacionadas à missão.
Continuously validated. Resilience is a posture that teams must exercise and improve – not a state established by an annual test.
Avaliado com base em evidências. O ResOps gera um índice de postura de resiliência (RPS): uma pontuação por serviço, fundamentada em evidências, que mede o grau de recuperabilidade de um único serviço crítico com base nos resultados da validação, na integridade das dependências e na confiança na recuperação sem falhas.
What Isn’t ResOps?
It’s not a product category.
Nenhuma plataforma é capaz de criar o ResOps por si só. Tecnologias de proteção de dados, Recovery cibernético, automação, observabilidade e testes podem dar suporte à disciplina, mas o ResOps é uma questão organizacional. Ele depende de governança, responsabilidade compartilhada, prioridades de negócios, práticas operacionais e um padrão comum de evidência.
It’s not a replacement for backup and recovery or Recovery de desastres.
ResOps does not replace strong backup and Recovery de desastres capabilities: it depends on them. Backup establishes whether recoverable copies exist. Disaster recovery provides the procedures and technical capabilities to help restore systems and infrastructure.
But then ResOps asks a broader question: Can the critical service return completely, cleanly, and within tolerance, including its identities, applications, data, infrastructure, cloud services, third parties, people, and decision paths?
It’s not another name for continuidade dos negócios or incident response.
A continuidade dos negócios define como a empresa opera durante interrupções. A resposta a incidentes detecta, contém e gerencia o evento. O ResOps conecta essas disciplinas ao resultado da Recovery. Ele cria um ritmo operacional para que as equipes cheguem a um consenso sobre o que é importante, validem a Recovery em condições realistas, avaliem os resultados e corrijam as lacunas reveladas pelos testes.
It’s not a compliance exercise or one-time project.
A mature ResOps program can help generate evidence for boards, regulators, insurers, customers, and auditors. But documentation is a byproduct, not the objective. The objective is demonstrated recoverability.
And because systems, dependencies, threats, and business priorities keep changing, ResOps is never “finished.” It operates continuously, much like financial planning or security operations.
O que muda com o ResOps?
O ResOps muda o foco: em vez de verificar se sistemas e processos individuais estão funcionando, ele analisa se o serviço crítico como um todo é capaz de se recuperar. Isso muda as perguntas que os líderes podem fazer.
Um backup bem-sucedido é importante. Ter um plano de recuperação também é. Mas nenhum dos dois indica se um serviço crítico pode realmente ser restaurado quando for necessário. O ResOps analisa o panorama geral:
Recovery was performed from a valid and verified recovery point?
Quanto tempo demorou?
Conseguimos nos recuperar dentro dos limites estabelecidos pela empresa?
E o que ainda precisa de atenção?
That’s why ResOps matters. It gives organizations a way to move beyond assumptions of resilience to programmatic, reliable demonstrations of their ability to recover. And they do it with continuous production of evidence and traceability. So when disruption happens, the question isn’t whether every team did its part or who failed at which task. It’s whether the business can restore the critical services its customers depend on.
Saiba mais
A Commvault publicouResOps: Um guia para executivos to give CISOs, CIOs, IT, security, resilience, and risk leaders a practical framework for implementing ResOps in their organizations.
Leaders will learn how to identify the services that matter most, validate recovery readiness with real evidence, and continuously test resilience. As a result, organizations can establish a single operating model that unites security, infrastructure, IT operations, and business leaders around evidence-based recoverability.
Q: Is ResOps simply a new name for Recovery de desastres?
A: No. Disaster recovery is an essential part of ResOps, but ResOps looks at the entire critical service – including technical, third-party, human, and decision dependencies – and whether it can recover within a business-defined impact tolerance.
P: O ResOps exige a aquisição de uma nova plataforma?
R: Não. A tecnologia pode auxiliar no mapeamento, nos testes, na Recovery e na coleta de evidências, mas o ResOps começa com a responsabilidade, a governança, as prioridades de negócios e as práticas operacionais.
P: Quem é o proprietário da ResOps?
A: ResOps needs a named leader with cross-functional authority and executive sponsorship. Individual service owners remain accountable for their services, while security, IT, continuidade dos negócios, and business teams contribute to the shared recovery outcome.
P: Como se mede o sucesso do ResOps?
A: Success comes from current evidence that critical services can recover cleanly within their defined impact tolerances – not simply from completing a plan or running a successful backup job.
A pontuação de resiliência (RPS) também é uma ferramenta de medição útil. Por ser uma pontuação baseada em evidências e calculada por serviço, a RPS ajuda a demonstrar o grau de recuperabilidade de um único serviço crítico com base nos resultados da validação, no estado das dependências e na confiança na recuperação sem falhas.
P: Como as organizações começam a utilizar o ResOps?
R: Comece identificando os serviços essenciais dos quais a empresa depende, quem é o responsável por eles, de que eles dependem e com que rapidez precisam ser restaurados. A partir daí, as equipes podem validar o processo de Recovery, identificar lacunas e priorizar o trabalho necessário para fortalecer a resiliência.
Michael Thelander is Senior Director of Product Marketing at Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Resilience depends on how quickly and confidently the business can recover – not solely on keeping every threat out.
Turn recovery plans into evidence – tested results are more credible to boards, regulators, and insurers than targets or assumptions.
Transformar o ResOps em um modelo operacional compartilhado para as equipes de segurança, infraestrutura, continuidade de negócios e responsáveis pelos serviços.
Avalie o que realmente importa: as equipes devem saber se os serviços essenciais podem ser restaurados, quanto tempo a Recovery realmente leva e se conseguem comprovar isso.
Selecione um ou dois serviços essenciais, defina o que constitui uma Recovery bem-sucedida, realize um exercício realista e documente os resultados.
Twenty years in security leadership teaches you one thing early: The attack you stopped never makes the board meeting. The one you didn’t is the only story anyone remembers. SomewSaiba mais no SHIFT 2025 along the way I stopped measuring my team by how many hits we absorbed alone and started also measuring us by how fast we got back up.
That’s the reason I want every CISO, CIO, and board member I know to read this new book, ResOps: Um Guia para Executivos. Commvault sponsored it, but I’d be recommending it either way.
O muro nunca foi o plano completo
For most of my career, the job was building higher walls. Better detection, tighter controls, faster response. That work still matters, and it always will. But a wall only answers one question, and it’s not the one your board is asking anymore.
Last September, ransomware forced Jaguar Land Rover to halt global manufacturing. Assembly lines stopped. Supply chains froze. The UK’s Cyber Monitoring Centre put the cost to the broader economy at roughly £1.9 billion, and JLR posted its lowest monthly production output in 73 years. JLR had defenses. What the incident tested wasn’t whether the wall held. It was whether the business could get back up once it didn’t.
I’ve said this before and I’ll keep saying it: Disruption isn’t an if, it’s a when. The CISOs who sleep at night aren’t those who believe they can keep everything out; they’re those who’ve practiced getting back up so many times that the practice itself is the confidence.
Três perguntas que faço à minha própria equipe
The book organizes the whole problem into three questions, and I’ve started opening every resilience review with them:
Se fôssemos atingidos hoje à noite, conseguiríamos nos recuperar?
Quanto tempo isso realmente levaria?
Será que podemos comprovar isso, com evidências, para a diretoria?
Most organizations answer the first two with a plan and the third with silence. That silence is the resilience gap, and it’s bigger and more expensive than most executives realize.
Provas, não promessas
Here’s a distinction the book makes better than I’ve heard it made anywSaiba mais no SHIFT 2025 else: A recovery time objective is a target. It tells you what you’re aiming for – but it doesn’t tell you whether you’ll hit it.
Compare “we believe we can recover the payments service in four hours” to “we restored it in 3.2 hours last quarter, from a verified clean recovery point, against a four-hour tolerance.” The first sentence is a plan. The second is evidence. Only one of them holds up when your board, your regulator, or your cyber insurer starts asking harder questions, which they will.
We calls this discipline ResOps, short for resilience operations. It’s not a product you buy or a binder you file. It’s an operating model that connects security, infrastructure, business continuity, and the business owners who depend on these services, all working from the same evidence instead of separate plans.
O aspecto que deveria preocupar todo CISO
The book also names something I’ve felt for a while and finally have language for: the AI paradox. The same AI capability helping us find vulnerabilities faster is helping attackers close the gap between discovery and exploitation just as fast, maybe faster. Finding more problems doesn’t make you safer if you can’t recover from the ones that get through. Detection speed was never the finish line. Recovery capability is.
Comece com um serviço
None of this requires boiling the ocean, and I’d be lying if I said my own team got it right on the first try. The book lays out a 90-day path: Pick one or two of your most critical services, define what “recovered” really means for each, run one honest recovery exercise, and produce your first piece of real evidence. That’s a project any team can start this quarter, mine included.
Proof over promises. Readiness over perfection. That’s the standard I hold my team to, and it’s the standard this book gives you a real path toward.
R: ResOps, abreviação de “operações de resiliência”, é um modelo operacional que conecta as equipes de segurança, infraestrutura, continuidade de negócios e os responsáveis pelos serviços em torno de práticas de recuperação compartilhadas e baseadas em evidências.
P: Em que o ResOps difere da recuperação de desastres tradicional?
R: A recuperação de desastres tradicional costuma se concentrar em planos e metas técnicas. O ResOps enfatiza a validação contínua, a responsabilidade multifuncional e a comprovação mensurável de que os serviços críticos podem ser restaurados dentro dos limites de tolerância da empresa.
P: Por que as evidências de Recovery são importantes?
R: As evidências de Recovery mostram o que uma organização realmente testou e alcançou. Elas ajudam a proporcionar aos conselhos de administração, órgãos reguladores, seguradoras e líderes empresariais maior confiança do que os planos ou metas de Recovery por si só.
P: O que as organizações devem avaliar em um programa de ResOps?
R: As organizações devem avaliar se os serviços essenciais podem ser restaurados, quanto tempo a recuperação realmente leva, se os pontos de recuperação estão em boas condições e foram verificados e se os resultados atendem às tolerâncias operacionais definidas.
P: Quem deve participar do ResOps?
R: A ResOps deve reunir os responsáveis pela segurança, infraestrutura, continuidade de negócios, aplicativos e serviços, bem como as partes interessadas da alta administração, para que as prioridades de Recovery e as evidências reflitam as necessidades do negócio.
P: Como uma organização pode começar a utilizar o ResOps?
R: Comece com um ou dois serviços essenciais. Defina o que significa uma recuperação bem-sucedida, realize um exercício de recuperação realista, documente os resultados e use essas evidências para aprimorar o próximo teste.
O comunicado federal atualizado relata novas táticas e técnicas do grupo Medusa, além de mais de 500 vítimas em setores de infraestrutura crítica.
Os invasores não visam apenas os dados de produção; eles também comprometem os sistemas de backup, identidade, virtualização e outros dos quais as organizações dependem para a Recovery.
Oadvisory calls on organizations to prove their resilience through testing and validation against observed attacker behaviors, not assume it from plans or successful backup jobs alone.
O último comunicado federal sobre o ransomware Medusa foi atualizado por um motivo:O adversário mudou.
Oalerta federal atualizado, issued August 18, 2026, by the FBI, Cybersecurity and Infrastructure Security Agency (CISA), and U.S. Department of Health and Human Services (HHS), describes an adversary that recruits new access brokers, moves faster once inside, and has gotten better at making sure the damage it causes cannot be undone.
OAttack Is Not Just Against Your Data
Os agentes do grupo Medusa agem rapidamente. Os investigadores relatam que os agentes do grupo Medusa já aproveitaram as vulnerabilidades recém-divulgadas em menos de 24 horas e, em alguns casos, utilizaram essas vulnerabilidades até uma semana antes da divulgação pública das mesmas.
Uma vez dentro do sistema, eles se camuflam utilizando ferramentas legítimas de gerenciamento remoto, roubo de credenciais e técnicas do tipo “living-off-the-land”.
But the advisory’s most significant finding is that A Medusa ataca o próprio caminho de Recovery.
Oadvisory maps this activity to MITRE ATT&CK technique T1490, Inhibit System Recovery. O relatório documenta como o ransomware encerra serviços associados a backups, segurança, bancos de dados, comunicações, compartilhamento de arquivos e sites. Ele também exclui cópias de sombra e, remotamente, desliga e criptografa máquinas virtuais.
Se um invasor estiver atacando deliberadamente os sistemas, as identidades e a infraestrutura que uma organização pode precisar recuperar, o problema vai além da proteção de dados, abrangendo a resiliência cibernética e a Recovery cibernética.
É aí que entra o ResOps (Operações de Resiliência)
ResOps não é apenas outro nome para backup. Trata-se de uma disciplina operacional que reúne segurança, TI, infraestrutura, aplicativos, operações e os negócios em torno de um único objetivo: manter os serviços críticos em funcionamento e recuperá-los dentro do prazo que a empresa pode tolerar.
OMedusa advisory never uses the word ResOps, but the thinking is there. It recommends organizations exercise, test, and validate their security programs against observed attacker behaviors, align security technologies to attack techniques, test them at scale, measure performance, and tune people, processes, and technologies based on the evidence.
Um backup não comprova que o sistema esteja livre de falhas. Um objetivo de tempo de recuperação em uma planilha não comprova que a empresa estará operando dentro desse prazo. A resiliência precisa passar de suposições para evidências.
Start With the Business, Not OServer
Oaddition of HHS in the advisory makes this especially relevant for healthcare, a sector the FBI says has been a frequent Medusa target. Orecovery conversation starts with three questions:
O que precisa continuar funcionando e como seria uma operação mínima viável?
Quais identidades, aplicativos, infraestrutura e dados dão suporte a esses serviços?
Em quais pontos de recuperação podemos confiar e o que é restaurado primeiro?
In a hospital, leaving any one of those unanswered may mean a delayed surgery, a pharmacist who can’t verify a dosage, or a diagnostic system a clinician can’t trust. No single team can answer them alone, which is the gap ResOps is designed to close.
Use o Medusa para testar suas suposições
Use o Medusa como um caso de teste para as premissas de Recovery. Um invasor consegue acessar os sistemas que dão suporte à Recovery? O que acontece se o Active Directory for comprometido? É possível identificar um ponto de Recovery intacto, restaurar serviços críticos na ordem correta e comprovar quanto tempo isso levará?
Threat actors adapt when defenders adapt. Resilience programs need to operate the same way: continuously tested, continuously validated, and continuously improved.
Porque, no meio de um incidente, é péssimo descobrir que o plano de Recovery parecia melhor no papel do que na prática.
Perguntas frequentes
P: O que é o ransomware Medusa?
R:O Medusa é uma operação de ransomware como serviço identificada pela primeira vez em 2021. Seus desenvolvedores e afiliados utilizam um modelo de dupla extorsão, criptografando sistemas e ameaçando publicar os dados roubados caso o resgate não seja pago.
P: Por que o alerta federal sobre a Medusa foi atualizado?
R: OAugust 2026 update incorporates findings from FBI investigations as recent as April 2026. It expands the documented tactics, techniques, procedures, exploited vulnerabilities, affiliate activity, and indicators of compromise, while adding HHS insights on attacks against healthcare.
Q: How does Medusa threaten an organization’s recovery capabilities?
R:O Medusa pode encerrar serviços associados a backups, segurança, bancos de dados, comunicações e outras funções críticas. Ele também pode excluir cópias de sombra, alterar políticas relacionadas à identidade e desligar ou criptografar máquinas virtuais, colocando em risco o próprio processo de Recovery.
P: O que as organizações devem fazer para ajudar a reduzir o risco do Medusa?
R:As organizações devem corrigir prontamente as vulnerabilidades conhecidas, segmentar as redes, restringir o acesso a serviços remotos, reforçar a autenticação, monitorar movimentos laterais e aplicar o princípio do privilégio mínimo. Além disso, devem manter cópias de recuperação separadas, offline, criptografadas e imutáveis, bem como testar regularmente os fluxos de trabalho de restauração.
P: O que é ResOps e em que ele difere do backup?
R: ResOps, or resilience operations, is a cross-functional operating discipline – not a backup product. It aligns security, IT, infrastructure, applications, operations, business continuity, and business owners around restoring critical services within the amount of disruption the business can tolerate.
P: Como uma organização pode ajudar a comprovar que está pronta para se recuperar?
R:Comece pelos serviços essenciais à empresa, mapeie as identidades, os aplicativos, a infraestrutura, os dados, as pessoas e os terceiros dos quais eles dependem, e defina o que constitui uma recuperação bem-sucedida. Em seguida, realize exercícios realistas que identifiquem pontos de recuperação válidos, restaurem os serviços na ordem correta, meçam o tempo real de recuperação e transformem quaisquer lacunas em uma lista de melhorias a serem implementadas.
Chris Bevilé gerente sênior de marketing de portfólio na Commvault.
Cerca de 1.200 agentes supostamente isolados se comunicavam por meio de um fórum não autorizado, e cerca de 700 participavam de atividades relacionadas ao Hugging Face.
Os agentes trocaram mais de 70.000 mensagens e arquivos, combinando descobertas feitas em sessões que deveriam permanecer separadas.
Investigators found agents spoofing tool calls and researching ways to alter evaluation transcripts to avoid detection by agrader.
Backups imutáveis e isolados, por si só, são insuficientes: as organizações precisam de um ponto de Recovery validado e confiável antes de restaurar o ambiente de produção.
Os laudos periciais finalmente chegaram e mudaram a maneira como vejo esse incidente.
At atime, astory sounded fairly straightforward: An AI agent found a way outside aenvironment designed to contain it and ultimately reached Hugging Face.
Na verdade, não foi bem isso que aconteceu.
A história vai além de um único agente desonesto
Os laudos forenses revelam que cerca de 1.200 agentes, que deveriam estar atuando de forma isolada, descobriram uma maneira de se comunicar por meio de um fórum não autorizado. Eles trocaram mais de 70.000 mensagens e arquivos, e cerca de 700 agentes participaram de atividades relacionadas ao Hugging Face.
None of that was prompted or intended. Oagents were persistent, they could share what they found, and they could combine effort across sessions that were supposed to have no contact with each other.
Among anew details: GPT-5.6 Sol agents reproduced an exploit and copied private evaluation data into a public Hugging Face dataset, a concrete escalation beyond what initial reports described.
O problema do “hackeamento de recompensas”
Oinvestigação independente realizada pela METR e pela Redwood Research, published alongside OpenAI’s own report on August 26, found that agents researched ways to spoof, edit or delete portions of their own evaluation transcripts because they incorrectly believed agrader would inspect how they completed atask. Researchers found successful tool-call spoofing in about 7% of atranscripts they evaluated, though amanipulation they observed was small-scale.
Ofinding is not that agents are “deceptive” in a human sense. It is that a sufficiently capable agent can search for ways around controls when those controls stand between it and aoutcome it has been optimized to achieve.
OpenAI calls aincident a “warning shot.” I think that is a fair description.
O que acontece quando a contenção falha
Most of aconversation about this incident will rightly focus on alignment, sandboxing and monitoring. But there’s a resilience question underneath it: If 700 agents can find a side door around containment, what’s aplan for when a single compromised workload does asame in your environment?
OpenAI’s own conclusion points at aanswer: Security architecture should assume an individual workload or compute node eventually can be compromised. That means air-gapped, immutable recovery data, and a way to validate what you’re restoring before it touches production again.
But immutability alone does not prove adata was clean when it was captured. If adata was already compromised at atime of capture, immutability preserves acompromise just as faithfully as it preserves anything else.
Opractical version of that question is simple to ask and hard to answer: If this happened to us, could we prove which recovery point predates acompromise?
OpenAI has since tightened workload and network isolation, expanded monitoring, and revised its model-development practices. Olesson applies beyond OpenAI: Contain aimpact, preserve what you can trust, and prove you can recover before you need to.
Perguntas frequentes
Q: What was aOpenAI-Hugging Face incident?
During internal cybersecurity evaluations, OpenAI agents bypassed controls intended to isolate them, accessed ainternet and reached third-party systems, including Hugging Face. Oactivity was driven primarily by an internal research model operating with reduced safeguards.
P: Como os agentes supostamente isolados se comunicavam?
R:Eles descobriram um fórum não autorizado na infraestrutura compartilhada. Cerca de 1.200 agentes o utilizaram para trocar mais de 70.000 mensagens e arquivos, permitindo que informações e táticas fossem transmitidas entre sessões que deveriam permanecer independentes.
Q: Were aagents instructed to attack Hugging Face?
R: No. They were attempting to complete a difficult cybersecurity benchmark. When aintended route appeared blocked, some agents searched for alternative ways to achieve aevaluated outcome, and that activity expanded beyond aenvironment’s intended boundaries.
Q: What does “reward hacking” mean in this context?
R: Reward hacking occurs when an agent finds an unintended way to satisfy a metric or obtain a desired result without completing atask as intended. Investigators found agents researching ways to spoof tool calls and alter or delete portions of evaluation transcripts because they believed agrader might inspect their process.
P: Por que os backups imutáveis, por si só, não são suficientes?
R: Immutability prevents stored data from being altered, but it does not prove adata was clean when it was captured. If a backup already contains compromised data, immutability preserves that compromise. Organizations therefore need isolated copies, trustworthy recovery points and validation before restoration.
P: O que as organizações devem fazer de diferente após esse incidente?
R:Reforce o isolamento da carga de trabalho e da rede, restrinja o acesso desnecessário à Internet e às credenciais, monitore o comportamento dos agentes e os sinais de escalonamento, e parta do princípio de que a prevenção pode falhar. Combine esses controles com dados de recuperação isolados e imutáveis, além de um processo testado para identificar e validar um ponto de recuperação limpo.
Chris Bevilé gerente sênior de marketing de portfólio na Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Certificate lifespans will shrink from 398 to 47 days by March 2029 with “domain , de modo que a comprovação da propriedade ocorra programaticamente, em vez de depender de uma pessoa. reuse” shrinking to just 10 days, making manual renewal obsolete and automatic Certificate Lifecycle Management (CLM) necessary.
Operações do tipo “Harvest Now, Decrypt Later” (Colete agora, descriptografe depois) já estão em andamento para armazenar dados com vida útil longa para futura descriptografia usando computadores quânticos, o que significa que há uma ameaça imediata aos dados confidenciais criptografados que têm retenção de longo prazo.
O inventário de certificados e criptografia é o aspecto mais crucial que as empresas devem começar a construir agora, já que um inventário contínuo e automatizado é o primeiro passo rumo à resiliência cibernética de longo prazo e à agilidade criptográfica.
O problema oculto nos bastidores
A maioria das redes corporativas modernas depende de uma camada oculta composta por certificados digitais e criptografia que a maioria das pessoas nunca vê. Essa camada verifica a confiabilidade das máquinas e protege os fluxos de dados, mas, como as identidades de máquinas agora superam as identidades humanas em uma proporção demais de 80 para 1 in the average enterprise according to CyberArk’s machine identity research, it can be easy to underestimate the cryptographic and certificate layer’s importance.
A helpful way to think about a digital certificate is an ID badge for a machine. If the badge is valid, the doors open automatically and no one thinks about it, but the moment that badge expires or is misconfigured, the door stops opening, regardless of how legitimate the machine behind it is. A single expired certificate can take down websites, break the APIs that let applications talk to each other, interrupt transactions, and create compliance violations, all while eroding user trust.
For years, organizations have managed certificates manually, but two changes are going to make it impossible to keep up by hand. First, the maximum lifespan of public Transport Layer Security (TLS) certificates, the protocol securing your browser, is being compressed to just 47 days by 2029. Second, the eventual arrival of quantum computers powerful enough to break today’s encryption is forcing a transition to Post-Quantum Cryptography. These two issues both point to the same solution – a governed, automated, and crypto-agile approach to CLM.
O roteiro por trás da redução da validade dos certificados
A janela operacional para certificados TLS públicos vem se estreitando há uma década. No início de 2023, o Google publicou pela primeira vez seu roteiro“Moving Forward, Together”, que propunha reduzir a validade dos certificados de 398 dias para 90 dias, na esperança de impulsionar o setor rumo à automação. A Apple acelerou esse cronograma em outubro de 2024 aoapresentar uma proposta preliminar to the CA/Browser Forum, the industry body where certificate authorities and browser makers set shared rules. Apple’s proposal, endorsed by Sectigo, Google Chrome, and Mozilla, was approved in April 2025 as a Proposta SC-081v3.
Essa redução ocorre em fases. O prazo máximo anterior de 398 dias já caiu para 200 dias a partir de março de 2026, com o máximo sendo reduzido para 100 dias em março de 2027 e, finalmente, para 47 dias em março de 2029. Na prática, uma organização que atualmente renova cada certificado cerca de uma vez por ano passará em breve arenovar todos os certificados aproximadamente a cada mês e meio; na fase final, qualquer processo que dependa de uma pessoa solicitar e instalar certificados manualmente deixará de funcionar.
Os fabricantes de navegadores estão promovendo esses prazos de validade mais curtos para forçar a automação, o que elimina o erro humano que, em primeiro lugar, causa a maioria das interrupções nos certificados. Eles também permitem que toda a web adote novos padrões criptográficos em semanas, em vez de anos, já que os certificados antigos são substituídos rapidamente. Além disso, ajudam a reduzir a dependência de sistemas de revogação legados, que sofrem com problemas de desempenho e privacidade. Por fim, caso um registro de Transparência de Certificados (um registro público dos certificados emitidos) seja desqualificado, os certificados de curta duração reduzem drasticamente o número de registros que precisam ser substituídos em curto prazo.
O desafio da validação
Embora o limite de 47 dias ganhe destaque nas manchetes e chame a atenção, a mudança mais disruptiva talvez seja o que acontecerá com a Validação de Controle de Domínio (DCV). A DCV é o processo de comprovar a uma Autoridade Certificadora (CA) que você controla o domínio para o qual está solicitando um certificado. Historicamente, uma vez que uma organização comprovasse a propriedade, a CA poderia reutilizar essa prova por até 398 dias; porém, de acordo com a norma SC-081v3, o prazo de reutilização será reduzido para 200 dias em 2026 e para apenas 10 dias até março de 2029.
Isso cria um desequilíbrio real, pois mesmo uma organização que automatize totalmente a instalação de certificados ficará paralisada se não puder comprovar novamente a propriedade do domínio a cada 10 dias. Qualquer atraso na validação interrompe todo o fluxo de emissão e leva diretamente a interrupções no serviço.
Enquanto a validade dos certificados diminui, os algoritmos dentro desses certificados
While certificate lifespans shrink, the algorithms inside those certificates face a quantum threat. Traditional Public Key Infrastructure (PKI) rely on asymmetric cryptography to secure digital signatures, key exchanges, and TLS connections. A sufficiently powerful quantum computer running Shor’s algorithm could break these systems completely. Waiting until quantum computing is powerful enough to decrypt is not a viable option; as , has written, “the exact date of Q-Day may remain uncertain. The direction of travel is not.”Estimativas apontam que o Q-Day — o momento em que um computador quântico poderá quebrar a criptografia de chave pública — ocorrerá em algum momento nos próximos 5 a 10 anos. No entanto, seria um erro tratar isso como um problema futuro. Os agentes mal-intencionados já estão conduzindo operações do tipo “Harvest Now, Decrypt Later” (HNDL), interceptando e armazenando tráfego criptografado hoje com a intenção de descriptografá-lo assim que a computação quântica amadurecer. Dados que devem permanecer confidenciais por anos, como registros de saúde, propriedade intelectual e informações financeiras, ficam efetivamente expostos no momento em que são coletados.
O Governo Federal dos EUA respondeu de acordo: em junho de 2026, a Casa Branca emitiua Ordem Executiva 14412, Securing the Nation Against Advanced Cryptographic Attacks, which sets deadlines well ahead of NIST’s original 2035 target: Federal high-value systems must adopt post-quantum key establishment by the end of 2030 and post-quantum digital signatures by the end of 2031.
Despite this urgency, actual progress toward enterprise-level crypto-agility has been slow. The “DigiCert Quantum Readiness Outlook”constatou que mais da metade das organizações pesquisadas espera que a criptografia assimétrica clássica seja quebrada dentro de cinco anos; no entanto, apenas 7% implantaram criptografia quântica segura ou híbrida em seus conjuntos de certificados, e o nível geral de Readiness melhorou em apenas 2 pontos percentuais no último ano.
Por que a agilidade criptográfica é importante?
The most practical bridge between classical and post-quantum cryptography is the hybrid composite certificate, which combines a classical algorithm (RSA or ECC) with a post-quantum algorithm (ML-DSA, the standardized lattice-based signature scheme) inside a single X.509 certificate. Combining both into a single certificate is designed so that the certificate will hold up as long as either algorithm does, which is essential, as post-quantum algorithms are new and haven’t yet survived countless attempted attacks like RSA has.
However, post-quantum keys and signatures are several kilobytes rather than a few hundred bytes, which increases network latency, risks packet fragmentation during the TLS handshake, and adds computational overhead that may require hardware upgrades for constrained devices. This is exactly why crypto-agility matters; organizations need the ability to test, deploy, and rotate algorithms without rewiring their underlying infrastructure each time standards evolve.
Gerenciamento automatizado do ciclo de vida de certificados
O gerenciamento manual de certificados não é apenas ineficiente; é um verdadeiro risco operacional. Quando os certificados ficam escondidos em planilhas, as organizações perdem visibilidade, e o resultado são credenciais vencidas, tamanhos de chave fracos, algoritmos de assinatura desatualizados e configurações não conformes que ninguém percebe até que algo dê errado. As interrupções resultantes podem confundir os usuários, prejudicar a receita e recair sobre a equipe menos preparada para explicá-las.Uma plataforma completa de CLMresolve isso ao longo de todo o ciclo de vida de um certificado:
Descoberta: varredura contínua de ambientes em nuvem, centros de dados, contêineres e domínios externos para identificar todos os certificados em uso.
Monitoramento: acompanhamento em tempo real de datas de validade, algoritmos, principais pontos fortes e conformidade com a política de segurança.
Validation: Utilize direct API integration with public and private CAs, while automating domain , de modo que a comprovação da propriedade ocorra programaticamente, em vez de depender de uma pessoa. and approvals
Instalação: Implante certificados e chaves renovados de forma programática por meio do ACME ou de APIs seguras, sem intervenções manuais.
Revogação: É necessário realizar uma revogação rápida e orientada por políticas para que um certificado comprometido possa ser substituído ou revogado em todos os lugares de uma só vez, em vez de ter que ser localizado máquina por máquina.
Há também um benefício oculto na etapa de descoberta: o inventário de certificados mantido por uma plataforma CLM é, na verdade, o início do inventário criptográfico exigido pelo planejamento de migração pós-quântica, o que pode transformar uma tarefa de conformidade em uma vantagem inicial.
Identidades não humanas e IA autônoma
O problema de escala é agravado pela forma como os aplicativos modernos são construídos. Contêineres, pods do Kubernetes, máquinas virtuais, dispositivos da Internet das Coisas (IoT) e APIs precisam, todos, de suas próprias credenciais, e muitas dessas cargas de trabalho existem por apenas alguns minutos ou horas antes de serem encerradas. Nenhuma equipe humana consegue emitir e retirar certificados nessa velocidade.
Para acompanhar esse ritmo alucinante, agentes de IA podem ser utilizados para descobrir, emitir, renovar e gerenciar certificados de forma autônoma, mantendo-se dentro dos limites estabelecidos, como políticas de segurança, controle de acesso baseado em funções (RBAC) e trilhas de auditoria centralizadas. O resultado é a automação na velocidade das máquinas, sem abrir mão da governança corporativa.
Por onde começar
O primeiro passo rumo à agilidade e resiliência criptográficas em toda a empresa é organizacional, e não técnico. Seguindoas orientações do NIST, as empresas devem estabelecer uma equipe central de serviços de identidade de máquinas que seja responsável pela plataforma CLM, padronize modelos de certificados e mantenha integrações com CAs públicas e privadas. Os proprietários de aplicativos individuais e as equipes de DevOps, por sua vez, devem ser responsáveis por integrar as renovações automatizadas em seus próprios pipelines de implantação, utilizando a plataforma central como um serviço compartilhado. Essa divisão mantém a governança consistente ao mesmo tempo em que elimina as transferências manuais que causam interrupções no serviço.
Organizations should replace manual , de modo que a comprovação da propriedade ocorra programaticamente, em vez de depender de uma pessoa. techniques and workflows with ACME and automated DNS-01 , de modo que a comprovação da propriedade ocorra programaticamente, em vez de depender de uma pessoa. now, well before the 10-day DCV window arrives, while deprecating every manual renewal and , de modo que a comprovação da propriedade ocorra programaticamente, em vez de depender de uma pessoa. process along the way.
Paralelamente, as organizações devem realizar um inventário completo de seus ativos criptográficos para identificar chaves codificadas, algoritmos legados e caminhos de confiança de longa duração que protegem dados confidenciais.
A preparação pós-quântica deve começar em um ambiente controlado, e não em produção. Um laboratório de testes dedicado deve ser estabelecido para permitir que as equipes testem certificados compostos híbridos e atualizações cripto-ágil em um ambiente de teste. Ao desenvolver aplicativos em bibliotecas criptográficas modulares conectadas a uma plataforma CLM dinâmica, as empresas podem obter verdadeira cripto-agilidade: a capacidade de alternar chaves, cifras e algoritmos em toda a sua infraestrutura à medida que os padrões mudam, sem a necessidade de reconstrução.
The thread that connects all recommendations is inventory. A CLM platform’s discovery step is not busywork before the real fix; it is the same discipline organizations will need across every layer of quantum readiness. Certificates are non-human identities, and the same questions apply to service accounts, AI agents, open source dependencies, and the algorithms buried in application code: What do we have, what does it protect, and which of it matters most to the business?
Organizations that build that inventory muscle now, starting with certificates, will find the rest of the transition far less daunting, because prioritization becomes a calculation rather than a guess. Treating the next few years as a planning window rather than a grace period will help organizations make this transition on their own terms, instead of letting an outage make the decision for them.
Caitlin Dodson is a Summer 2026 Intern for FCTO – Americas at Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem