The news cycle has been dominated with coverage about the risks of AI – from agents gone rogue to a public outcry to slow and regulate its progress.Collectively, these stories say something important about whier AI risk is actually headed.In September 2026 alone:
Anthropic published an alignment assessment describing a fourth incident in which a Claude model reached a real third-party system during what was supposed to be a sandboxed cybersecurity evaluation, using terms such as “recklessness” and “biased reasoning” to describe the models’ behavior.
It is tempting to file these stories under “frontier lab problem” and move on.I think that is the wrong read.Enterprises don’t often have the luxury of waiting for industry and regulators to slow growth, never mind if and when they do.Cyber risk from agents is already inside most environments, and policy timelines may not change how fast it moves.
The threat vectors are not new.A malicious package.A misconfigured environment.A credential exposed longer than it should have been.Most CISOs have been managing these risks for years.With AI, what’s changed is scale and visibility: thousands of agents acting continuously, coordinating in ways no one anticipated or witnessed.
Case in point: Due to the enormous scale of the OpenAI/RubyGems incident, it took specialized researchers months to reconstruct.What enterprise can withstand that much time passing between incident and understanding?
Many signs predict further proliferation, not less.In fact,IDC predicts that by 2029, the number of agents deployed in production environments will exceed 1 billion and that by 2027, more than 40% of enterprise application capabilities will be enhanced by agentic automation.
What ‘AI-Ready’ Cyber Resilience Actually Requires
Commvault stands firm that resilience only counts if the recovery is clean.A restore that brings back a compromised file, a corrupted dataset, or a still-infected agent identity is not resilience – it’s a second incident.That premise did not change when agentic AI arrived.It became more important.That’s why we built our AI resilience capabilities with the following in mind:gar nicht mehr gibt.Hier sind die wichtigsten Erkenntnisse.Resilience must operate at machine speed.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Rapidly evolving AI capabilities are increasing the speed of attacks.von Commvault und Tech Research Asia hat kritische Lücken bei den Maßnahmen zur Cyber-Recovery in Unternehmen im gesamten asiatisch-pazifischen Raum aufgezeigt.CrowdStrike’s 2026 Global Threat Report, breakout time – the window between an attacker’s first access and their first move deeper into the network – is 29 minutes, down from 48 minutes the year before.To say that recovery requires direct and immediate response to data security signals is an understatement.Otherwise, business-as-usual routing via through manual approvals can meanthe threat keeps advancing. gar nicht mehr gibt.Hier sind die wichtigsten Erkenntnisse.Depth across every system and environment.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Agents are indiscriminate in whier and what they chose to exploit and attack, whether that’s a public code registry, data center or SaaS environment.Coverage should span structured and unstructured data, SaaS applications, and infrastructure alike, as well as cloud, edge, on-premises, and hybrid environments. gar nicht mehr gibt.Hier sind die wichtigsten Erkenntnisse.Identity resilience extends beyond people.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.With non-human identities outnumbering humans144 zu 1, governance is re-emerging as a modern-day challenge.When the blast radius of an attack can expand in seconds, effective data security teams must understand not only what changed and who changed it, but when an alert meritsa recovery action.
The greatest AI risk is not confined to frontier labs.For enterprises, resilience must be treated as foundational before the scale of agentic activity makes the risk impossible to contain.That responsibility sits with the enterprise.
Learn more about how Commvault Cloud can help you build resilience in your AI stackhier.
Sankalp Damaniis Senior Director, Product Management, at Commvault.
Everywhere you go you hear the same story. AI changed everything, attackers are faster, and governance matters. This is a narrative that 50 other CISOs could deliver.
After 20 years in cybersecurity, I have the benefit of perspective. I’ve lived through major shifts in technology: the internet, mobile, cloud … and more. To me, the interesting story is what is fundamentally different about AI vs. every other technology transition.
AI didn’t replace the CISO’s mission. Yes, it changed the speed, but good security has always been about being the team that doesn’t just protect technology but also helps enable the company to win in the market in which it competes. Just like with the internet, mobile, and cloud, confirming the company uses AI well is table stakes.
1. What my job looked like a year ago
A year ago, my priorities would have been very recognizable to any CISO: ransomware, identity, vulnerability management, third-party risk, cloud security, data protection, resilience. AI was on the agenda, but largely as an emerging technology risk. Today, it’s becoming part of almost every one of those conversations.
Last year’s world wasn’t simple. We had to protect identities, systems, applications, infrastructure and data. And now, all of those remain, but you’re dealing with systems that can consume huge amounts of information, generate new information, make recommendations, write software, automate workflows, and increasingly act on behalf of people. The old problems didn’t disappear. AI landed and sped up the clock of the existing security stack.
2. What changed, and why it wasn’t gradual
The biggest inflection point is the collapse in the cost of capability. An attacker no longer needs the same skills and time investment. Previously they’d have to invest countless hours in their coding ability or content-production effort to operate at scale and countless hours to identify and hone targets. At the same time, my own employees suddenly have powerful tools that can ingest corporate information and produce code, analysis, and content.
So, we have two simultaneous accelerations. What changed wasn’t simply that attackers got AI. Everyone got AI. And adoption happened from the bottom up. Employees didn’t wait for the enterprise AI strategy. Developers started using copilots. People experimented with public LLMs. Business functions discovered automation opportunities.
For most major enterprise technologies, security had some opportunity to prepare the environment before widespread adoption. With generative AI, adoption often arrived before governance.
3. How the mission itself changed
Historically, security asked: How do we protect this technology? But AI forces another question: How do we allow the company to use this technology safely?
That brings CISOs into questions that aren’t purely cybersecurity:
What information can employees provide to AI systems?
Which models and services are approved?
What happens to prompts and uploaded data?
Where is corporate data retained?
How do we manage AI identities, agents, and permissions?
How do we validate AI-generated code?
What human oversight is required?
How do legal, privacy, security, data governance, and compliance responsibilities intersect?
That said, CISOs need to be careful they don’t become Luddites, or the AI Police. The CISO role is helping define the security boundaries within which the company can move quickly. If the security strategy for AI is simply “don’t use it,” you’ve already lost. People will use it. Our job is to make the secure path the easiest path.
4. What I had to relearn or unlearn
One thing I’ve had to unlearn is the idea that security gets to fully understand a technology before the enterprise adopts it. With AI, adoption and experimentation are happening simultaneously with our understanding of the risks. We have to allow smart and thoughtful adoption.
Another is determinism. Security professionals grew up evaluating systems where, broadly speaking, Input A should produce Output B. Generative systems don’t behave that neatly. We’re accustomed to asking whether a control works. AI forces us to become more comfortable asking how reliably it works, under what conditions it fails, and what happens when it does. That’s intellectually interesting.
Twenty years in security teaches you pattern recognition. Now, AI reminds me that pattern recognition can become a liability when the underlying assumptions change.
Early on I assumed the principal problem would be malicious use of AI externally against us. But quickly I discovered that my biggest impact would be spent internally on data governance, internal adoption, and business enablement.
5. What’s next/advice for peers gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.First, don’t create a separate AI-security universe.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Map AI into the controls you already understand: identity, data classification, least privilege, logging, third-party risk, secure development, incident response, and resilience. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Second, pay close attention to agents.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Today’s dominant interaction is often human → model → response. The more consequential architecture is increasingly: human → agent → tools → systems → data → actions. Once AI can take actions (rather than merely generate text), authorization, identity, provenance, monitoring, and blast radius become much more important. I’m less worried about an AI saying the wrong thing than I am about an AI agent being authorized to do the wrong thing. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Third, protect the data layer.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Models will change quickly. Vendors will change. Architectures will change. Today’s biggest AI company and hippest frontier model will be Betamax soon. Your durable security assets remain knowing what data you have, where it is, who can access it, and what they’re allowed to do with it. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Fourth, don’t measure success by how much AI you block.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.A sophisticated security organization should enable legitimate adoption while constraining unacceptable risk. Every major technology shift creates a period where capability moves faster than control. The internet did it. Mobile did it. Cloud did it. AI is doing it at extraordinary speed.
Handling this well doesn’t require eliminating AI risk altogether. It requires deciding deliberately which risks you’re willing to take, putting boundaries around them, and still allowing the business to move.
AI hasn’t repealed the fundamentals of cybersecurity, but it is changing the economics and velocity around them. After 20 years of successive security transformations, AI may be the first one where the CISO must simultaneously defend against the technology, protect the technology, and help the business adopt the technology. That’s what makes it a challenge.
For years, resilience conversations have centered on technology. Do you have backups? Do you have a disaster recovery plan? Do you have protections in place to prevent an attack?
Those remain important questions. But increasingly, they’re not the ones I’m hearing from executives.
Instead, I’m hearing a much simpler question: gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.If we experience a cyberattack tomorrow, can we come back from it, and can we prove it?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
NewIDC research, based on a survey of 539 IT and resilience decision makers across the U.S. and Canada, reveals a growing reality: Having recovery technology doesn’t automatically make an organization recovery ready.
Recently, I joined Jason Cray from Commvault’s Product Experience team to discuss that research from IDC. What emerged from our conversation wasn’t simply a discussion about backup, recovery, or cyber resilience.
It was a discussion about confidence. More specifically, why so many organizations believe they’re recoverable, but struggle to prove they’re actually recovery ready.
The difference between being recoverable and recovery ready is like the difference between theory and proof.
IDC found that 57.7% of organizations have not fully defined their minimum viable business. If you don’t know what you need to recover, how can you prioritize what needs to come back up first?
Recovering everything is not a viable strategy. Successful recovery depends on prioritization and business context.
Cyber recovery requires a team approach to be successful.
The fundamental difference between cyber recovery and disaster recovery is the need for trust.
Speed may not be the best measure of recovery, especially if you can’t trust your backups.
Organizations build confidence through testing, not planning alone.
ResOps provides a framework for turning resilience into an operational discipline.
What’s the Difference Between Being Recoverable and Being Recovery Ready?
A few years ago, many resilience discussions ended with a checklist.
Backups? Check.
Recovery plan? Check.
Disaster recovery testing? Check.
Today, that level of assurance is no longer enough.
During the webinar, Jason shared a perspective I hear frequently from customers: Organizations can usually tell you exactly how much they invest in security and protection technologies, but far fewer can confidently explain how they would recover if those controls failed.
The distinction may sound subtle, but it’s important.
Being recoverable means you have mechanisms in place that could support recovery. Being recovery-ready means you’ve demonstrated those mechanisms can successfully restore critical business operations under real-world conditions.
As resilience becomes a board-level concern, assumptions are giving way to evidence. Leaders want confidence that recovery plans will actually work when the pressure is at its highest.
When the Chips Are Down, Does Your Organization Know What Matters Most?
One of the most striking findings from theIDC researchis thatgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.57.7% of organizations have not fully defined their minimum viable business.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
A minimum viable business isn’t simply a list of critical applications. It’s the combination of people, processes, systems, and data required to keep the organization functioning during disruption. It answers a critical question:
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.What absolutely must come back first?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
This is where many recovery strategies begin to fall apart.
I’ve worked with organizations that understand which applications are important but haven’t mapped the dependencies supporting them. Others continue treating nearly every workload as mission critical. While that approach might seem prudent, it creates a practical problem during recovery.
When Everything Is Critical, Nothing Is
Recovery takes time. Infrastructure has limits. Dependencies matter.
Organizations cannot realistically expect to recover an entire multi-petabyte environment immediately following a large-scale cyber event. Prioritization becomes essential.
The organizations that recover most effectively tend to know exactly what must come back first, what can wait, and what business outcomes depend on those decisions. That’s what defining a minimum viable business enables.
Sneak Peek: Recovery Readiness Webinar
One of the themes Jason and I explored throughout the webinar is the fact that cyber resilience is a shared responsibility. There’s a disconnect in many organizations that recovery readiness is an infrastructure challenge. It is not; it’s an organizational challenge. It requires alignment across security, IT, legal, communications, and business teams to confirm critical applications, processes, and recovery priorities are clearly understood before disruption occurs.
Recovery Plans Fail in Silos
Many organizations still approach resilience through disconnected teams. Infrastructure teams focus on systems. Security teams focus on threats. Business leaders focus on continuity. Legal and communications teams often become involved only after an incident occurs.
The problemis thatdisruptions don’t respect organizational boundaries.
Successful recovery depends on coordinated decision-making across all of those functions. Recovery priorities, customer communications, business operations, legal obligations, and technical restoration efforts must all work together in real time.
One customer recently described their resilience planning efforts as building a team of superheroes. While they meant it jokingly, it perfectly captured the reality of modern recovery readiness. Organizations recover as teams, not technologies.
Why Cyber Recovery Is Fundamentally Different From Disaster Recovery
One misconception we discussed during the webinar is the belief that traditional disaster recovery plans can simply be adapted for cyber recovery.
In reality, they solve different problems.
Traditional disaster recovery was often built around predictable failure scenarios. A site outage. Infrastructure failure. A known disruption that triggered a documented response. Cyber events are fundamentally different.
Organizations must determine what systems have been compromised, what data can be trusted, and whether recovery actions could inadvertently reintroduce risk. The challenge isn’t simply restoration. It’s validation.
You can’t restore what you can’t trust. That uncertainty creates a very different recovery process.
If organizations restore compromised systems or infected data, they risk bringing the problem back into production. As attacks continue to grow in sophistication, validating the integrity of recovered environments becomes increasingly important.
Recovery is no longer just about bringing systems online. It’s about restoring trust.
Why Trust Matters More Than Speed: A Fast Recovery Can Still Be a Failed Recovery
That brings us to one of the most important points from our discussion. For years, recovery success was largely measured by speed.
How quickly can systems be restored?
How quickly can operations resume?
Those questions still matter. But speed alone is no longer enough.
A recovery that reintroduces malware, compromised identities, or untrusted data into production isn’t truly successful. That’s why more organizations are investing in isolated recovery environments, validation exercises, and recovery testing designed to verify the integrity of recovered assets before they return to production.
Recovering quickly only matters if you’re recovering something you can trust.
MTCR: The NewMeasure of Recovery Confidence
As organizations rethink how they measure resilience, many are moving beyond traditional recovery time objectives (RTOs) and recovery point objectives (RPOs).
Instead, they’re focusing on gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.mean time to clean recovery (MTCR).Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
What makes MTCR valuableis thatit reflects the realities of modern cyber recovery. It’s not just about how quickly an organization restores data. It includes the time required to validate, assess, and confidently return systems to production.
That distinction matters because organizations don’t simply recover infrastructure. They recover business operations. MTCR better reflects how quickly the organization can safely return to a trusted operating state.
Confidence Comes From Testing
If there’s one lesson I’ve learned from working with organizations across various stages of resilience maturity, it’s this: Confidence doesn’t come from documentation.
Confidence comes from testing.
Static recovery exercises often validate known processes under ideal conditions. Real-world disruptions are rarely that predictable.
Recovery-ready organizations test continuously. They simulate realistic conditions. They introduce uncertainty. They identify dependencies. They uncover weaknesses before attackers do.
Most importantly, they build organizational muscle memory.
During the webinar, Jason shared a perspective I’ve always found compelling: Organizations can choose to figure things out during a period of stability, or they can try to figure them out in the middle of a crisis. The better option is obvious.
Testing doesn’t simply validate technology. It validates people, processes, communications, priorities, and assumptions. And that’s where real confidence is built.
ResOps Is What Happens When Recovery Becomes an Operational Discipline
Throughout our discussion, nearly every challenge we identified pointed back to the same need: Organizations need a way to consistently define priorities, align stakeholders, validate recoverability, and improve over time.
That’s exactly why resilience operations, or ResOps, is gaining momentum.
ResOps isn’t about introducing another tool or process. It’s about operationalizing resilience. It brings together people, process, and technology under a common framework for continuous validation and improvement.
Because ultimately, recovery readiness isn’t a project. It’s a discipline.
The organizations that will differentiate themselves in the years ahead won’t simply be the ones with recovery technologies or documented plans. They’ll be the organizations that can demonstrate those plans work:
They’ll know what matters most.
They’ll understand how to recover it.
They’ll validate that it’s safe to recover without risk of reinfection
And they’ll have evidence to prove it.
In other words, they won’t just be recoverable. They’ll be recovery-ready.
Mehr erfahren
The IDC report also found that overall organizational resilience among the organizations surveyed is impaired both by gaps in individual technologies and by the absence of a coordinating framework that brings business, infrastructure, and security functions together around a shared recovery objective.
For a deeper look at the research:
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Sehen Sie sich daswebinar:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Recovery Readiness Webinar On Demand
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Download the report:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. IDC Resilience Operations Report
FAQs
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What is ResOps?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.ResOps (resilience operations) is an operational discipline that helps organizations continuously validate and improve their ability to recover from disruption. It brings together people, processes, and technology to make recovery readiness measurable and provable.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What is a minimum viable business?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.A minimum viable business is the combination of systems, processes, people, and data required to continue operating during a disruption. It helps organizations prioritize recovery efforts when everything cannot be restored simultaneously.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: Why is cyber recovery different from disaster recovery?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Traditional disaster recovery assumes predictable failure scenarios. Because the nature of cyber attacks is unpredictable, cyber recovery requires organizations to change their focus to determining what systems can be trusted, validating recovered data, and ensuring threats are not reintroduced into production environments.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What is mean time to clean recovery (MTCR)?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.MTCR measures how long it takes an organization to recover to a verified, trusted operational state. It incorporates recovery, validation, and confidence-building activities rather than focusing solely on restoration speed.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: Why does recovery testing matter?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Testing helps organizations uncover hidden dependencies, validate assumptions, build muscle memory, and improve recovery processes before a real disruption occurs. Recovery confidence is earned through practice, not paperwork.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: Why is identity resilience important?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Identity systems play a foundational role in recovery. If users cannot access production systems, recovery environments, or critical data, even the best recovery plans may be difficult to execute successfully.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: How can organizations measure recovery readiness?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Organizations can begin by defining their minimum viable business, testing recovery processes regularly, validating recovered environments, and measuring outcomes using metrics such as mean time to clean recovery (MTCR).
Recovery time objective (RTO) is the maximum duration of time a business process or application can remain offline after a disruption before the impact becomes unacceptable. In practice, your RTO answers a direct question: how fast must you recover?
That question carries significant financial weight. According to Siemens and Splunk’s 2024 True Cost of Downtime report, unplanned downtime costs the world’s 500 biggest companies $1.4 trillion annually. Whether the cause is ransomware, a misconfigured update, or a regional cloud outage, every minute of inactivity chips away at revenue, customer trust, and regulatory standing.
Recovery time objective is not a single, universal number. It varies by workload, by business unit, and by the consequences of being offline. A payment processing system demands a far shorter RTO than an internal development environment. Getting this right requires deliberate analysis — not guesswork — and it is a core component of disaster recovery planning.
This guide breaks down what RTO means, how it differs from RPO, how to calculate and tier your targets, and what you can do to help meet them consistently.
Downtime Tolerance
Recovery time objective is a disaster recovery metric that defines the maximum tolerable period between a disruption and full restoration of a system or business process. It covers every phase of recovery: detection, decision-making, failover execution, data validation, and service confirmation.
The National Institute of Standards and Technology (NIST) defines RTO as “the overall length of time an information system’s components can be in the recovery phase before negatively impacting the organization’s mission” (NIST Glossary). NIST’s Cybersecurity Framework 2.0 reinforces RTO through its RECOVER function, which calls on organizations to execute recovery plans within established time objectives.
RTO is expressed in units of time – minutes, hours, or days – and is set before a disruption occurs, not during one. It is a planning metric. Your actual recovery time should consistently come in under the RTO you define; if it does not, you have a gap that puts the business at risk.
According to Splunk and Oxford Economics’ The Hidden Costs of Downtime, Global 2000 companies lose an average of $49 million per year from downtime. That figure makes the case for treating RTO as a core business metric, not just an IT exercise. When leadership understands what downtime costs per hour, setting and funding appropriate RTOs becomes a straightforward conversation.
den RTO vs. RPO
den RTO and RPO are companion metrics, but they measure different risks. den RTO addresses the question “how long can we be down?” RPO addresses “how much data can we lose?”
Recovery point objective (RPO) defines the maximum age of data that must be recovered after an outage. An RPO of one hour means you can tolerate losing up to one hour of transactions. An RPO of zero means no data loss is acceptable – requiring synchronous replication or continuous data protection.
Metrisch
den RTO
RPO
Definition
Maximum acceptable downtime after a disruption
Maximum acceptable data loss measured in time
Fokus
Speed of recovery
Frequency of backups or replication
Measurement
Time from failure to full restoration
Time between the last good backup and the failure
Beispiel
2-hour den RTO: systems must be operational within 2 hours
1-hour RPO: you can lose at most 1 hour of data
According to the Uptime Institute’s 2024 Annual Outage Analysis, 55% of outages lasted more than two hours – suggesting many organizations still have a meaningful gap between their stated den RTO and their actual recovery capability. Defining both den RTO and RPO together helps you plan for speed and data integrity simultaneously.
Calculate RTO
Calculating RTO is not a formula you plug numbers into. It is a structured assessment that connects technical capability to business tolerance. Here is how to approach it — and once you have your targets, you can optimize your recovery time objectiveover time.
Conduct a business impact analysis (BIA).
Identify every critical application and process. For each one, quantify what downtime costs – lost revenue, regulatory penalties, customer churn, reputational damage. According to ITIC’s 2024 Hourly Cost of Downtime survey, over 90% of enterprises estimate downtime costs exceed $300,000 per hour for mission-critical applications.
Identify and rank critical systems.
Not every workload has the same urgency. Group applications by business function: revenue-generating, customer-facing, internal operations, and development or archival. Assign a priority tier to each group.
Assess current recovery capabilities.
Document how long each system actually takes to recover today. Include detection time, notification and escalation, infrastructure provisioning, data restoration, validation, and user reconnection. Your current recovery time is your baseline.
Set tiered RTOs based on risk tolerance.
Match each priority tier to an RTO that the business can fund and the IT team can deliver. Compare your baseline recovery times against these targets. Any gap between current capability and target RTO is a problem to solve with architecture, automation, or a better DR platform.
This process – BIA, ranking, assessment, tiering – gives you defensible, data-driven RTOs rather than arbitrary numbers.
RTO Tiers
Not every system warrants the same recovery investment. Tiered RTOs let you direct budget and engineering effort where the business impact is greatest.
According to ITIC’s 2024 research, over 90% of enterprises estimate downtime costs exceed $300,000 per hour. For Tier 1 systems, even brief outages generate six-figure losses. Tier 3 systems, by contrast, can tolerate a full business day offline without material impact.
The value of tiering is focus. You invest in sub-hour recovery for payment processing and ERP, while giving archive systems a 24-hour window that costs far less to maintain. This approach keeps disaster recovery budgets efficient without leaving critical systems exposed.
Improve RTO
Setting an RTO is only useful if you can actually hit it. Here are the strategies that consistently reduce recovery time.
Adopt cloud-based disaster recovery. Cloud DR helps eliminate the need to maintain idle standby hardware. On-demand infrastructure lets you spin up recovery environments in minutes, not hours. According to the Uptime Institute’s Annual Outage Analysis 2025, organizations that have adopted cloud-based DRundautomated failover report measurably shorter outage durations compared to those relying on traditional approaches. Review thesecloud disaster recovery best practicesfor a deeper look at implementation.
Implement continuous replication. Point-in-time snapshots taken hours apart create data gaps that inflate both RPOundRTO. Continuous replication helps to keep standby environments current, so recovery starts from a near-real-time state.
Automate failoverundvalidation. Manual recovery steps introduce human errorunddelay. Automated runbooks execute failover sequences, verify data integrity,undconfirm service availability – all without waiting for an on-call engineer to step through a wiki page at 3 a.m.
Test regularlyundmeasure. A recovery plan that has never been tested is a hypothesis, not a plan. Run DR drills quarterly. Measure actual recovery time against your RTO. Document gapsundfix them before they matter.
Clumio von Commvault helps deliver rapid, predictable recovery for AWS workloads – including Amazon EC2, S3, RDS,undDynamoDB. Clumio’s architecture enables air-gapped, immutable backups with automated restore orchestration to help your recovery time stay within target even during a ransomware event. Explore Clumio’s der Recovery-Wiederherstellung nach Ransomware-AngriffenundRecovery solutions to see how your team can close the gap between stated RTOsundactual capability.
Häufig gestellte Fragen
What Is RTO in Disaster Recovery?
RTO in disaster recovery is the maximum acceptable time a system can remain offline after a disruption. It sets the deadline for restoring operations before the business suffers unacceptable financial, operational, or reputational harm.
What Is the Difference Between RTO and RPO?
RTO measures how long you can be down; RPO measures how much data you can afford to lose. RTO focuses on speed of recovery, while RPO focuses on backup frequency and replication. You need both to build a complete DR plan.
How Do You Calculate RTO?
Start with a business impact analysis to quantify downtime costs for each application. Rank systems by criticality, assess current recovery times, and set tiered RTO targets that balance risk tolerance with recovery investment.
What Is an Example of a Recovery Time Objective?
A payment processing platform might have a 30-minute RTO because every minute of downtime costs significant revenue. An internal development environment might have a 24-hour RTO because the business impact of a day offline is minimal.
What Is Maximum Tolerable Downtime vs. RTO?
Maximum tolerable downtime (MTD) is the absolute limit before a disruption causes irreversible business damage. RTO is set below the MTD to provide a safety margin. If your MTD is four hours, your RTO should be shorter – for example, two hours.
How Can You Reduce Your RTO?
Move to cloud-based DR with continuous replication and automated failover. Test recovery plans regularly and measure actual restore times. Platforms like Clumio provide air-gapped backups and automated restore orchestration to help keep recovery within target.
Ransomware Backup Protection: How to Keep Your Data Recovery-Ready
Ransomware operators now target backup infrastructure before encrypting production data. Learn how air-gapped, immutable cloud backups help protect your recovery path – and what the 3-2-1-1-0 framework means for your organization.
Ransomware operators have a clear playbook: Neutralize recovery options before encrypting production data. If your backups are intact, you can refuse to pay the ransom and restore operations. Attackers know this, so backup infrastructure has become a primary target.
Modern ransomware strains use several tactics to undermine backup systems:
Shadow copy deletion is among the most common – malware executes commands to remove Volume Shadow Copies the moment it gains a foothold.
Double extortion adds another layer: Attackers exfiltrate sensitive data before encryption, threatening to publish it even if you recover from backups.
Laut demCISA Medusa ransomware advisory(updated August 2026), the Medusa ransomware-as-a-service operation has impacted more than 500 victims across critical infrastructure sectors including medical, education, legal, insurance, technology, and manufacturing as of April 2026. Medusa actors run a double-extortion model, pairing encryption with data theft to pressure victims into paying.
“Both Medusa developers and affiliates use a double-extortion model where they encrypt victim data and threaten to publicly release exfiltrated data if a ransom is not paid.”
– FBI, CISA, and HHS, Medusa Ransomware Advisory (AA25-071A), 2026
CISA Medusa advisory (updated August 2026): 500+ victims impacted across critical infrastructure as of April 2026
Air Gap Types
An air-gapped backup creates separation between your production environment and your backup data, helping make it harder for ransomware to reach recovery copies. There are three main approaches, each with distinct trade-offs.
Physical air gaps
involve storing backups on disconnected media – tape, removable drives, or offline storage arrays. The backup media is physically separated from the network when not in active use. This approach offers strong isolation but introduces operational complexity: manual handling, transportation logistics, and slower recovery times.
Logical air gaps
use network segmentation, firewalls, and strict access controls to help isolate backup repositories within the same infrastructure. Backup data remains online but is accessible only through tightly controlled pathways. This is faster than physical air gapping but relies on the integrity of network controls – a misconfiguration or credential compromise can bridge the gap.
Cloud air gaps
place backup data in a provider-managed, isolated environment that is separate from the customer’s primary cloud account. The backup service controls the storage layer, helping enforce immutability and access restrictions at the platform level.
CISA’s StopRansomware guiderecommends maintaining offline backups separated from production networks to help reduce exposure to lateral movement during an attack. Legacy approaches to cloud backup ransomware protection often require organizations to build and manage their own isolated accounts, adding infrastructure overhead and operational burden. Modern cloud-native solutions handle this isolation as a built-in capability, helping reduce complexity while maintaining strong separation.
“Maintain offline, encrypted backups of data and regularly test your backups.”
– CISA, StopRansomware Guide, 2025
CISA StopRansomware Guide (2025): Organizations should maintain offline backups separated from production networks.
Immutable Backup Rule
An immutable backup is one that cannot be altered, overwritten, or deleted for a defined retention period. This is typically implemented using Write Once, Read Many (WORM) storage policies. It is designed so that once backup data is written, no user, administrator, or automated process can modify it until the retention lock expires.
Immutability and air gapping serve complementary purposes. Air gapping controls where backup data lives and who can reach it. Immutability controls what can be done to it once it arrives. The strongest ransomware backup protection strategies use both: Data is stored in an isolated environment and locked against modification.
The 3-2-1 backup rule has been a data protection standard for decades: Maintain three copies of data, on two different media types, with one copy offsite. The modern 3-2-1-1-0 framework extends this for ransomware resilience: 3 copies of your data, 2 different storage media or platforms, 1 copy offsite, 1 copy that is air-gapped or immutable (or both), 0 errors after automated backup verification. The 3-2-1-1-0 rule is not just a guideline – it is a practical framework for building ransomware recovery capabilities that help hold up under real attack conditions.
Protection Best Practices
Strong ransomware backup protection requires more than the right storage architecture. It demands disciplined operational practices across encryption, access control, testing, and compliance.
Encrypt backups in-flight and at rest. Backup data should be encrypted during transmission and while stored. Support for Bring Your Own Key (BYOK) encryption helps give you control over key management without relying solely on the backup provider.
Enforce multi-factor authentication (MFA) and role-based access control (RBAC). Limit who can access backup management consoles and recovery operations. MFA helps add a layer of defense against credential-based attacks, and RBAC restricts each user to the minimum permissions they need.
Test restores regularly. Backups that have never been tested are backups you cannot trust. Run recovery drills on a recurring schedule – including granular restores, cross-account recovery, and point-in-time rollbacks – to help confirm your recovery time objectives are realistic.
Maintain compliance certifications. For regulated industries, your backup solution should hold current certifications such as ISO 27001, SOC 2 Type II, and HIPAA.
Encryption helps protect data confidentiality; access controls help limit the blast radius of compromised credentials, testing helps validate recovery readiness, and compliance frameworks help provide a structured approach to maintaining all of the above.
Clumio Backup Protection
Clumio helps deliver cloud-native ransomware backup protection purpose-built for AWS workloads,includingAmazon S3,DynamoDB,and EC2/EBS. Here is how Clumio helps address the core challenges covered in this article:
Air-gapped cloud backups outside your AWS account. Clumio stores all backup data in an isolated,provider-managed environment that is designed to be completely separate from your primary cloud account. Attackers who compromise your production environment face significant barriers to reaching your backup data.
Immutable by design. Backup data written to Clumio is immutable and indelible,and is designed so that it cannot be altered,or overwritten through any user interface or API. Immutability is enforced at the platform level,not as an optional configuration.
Granular recovery at every level. Clumio helps support recovery at the object,prefix,bucket,table,and instance level. It is designed to help you restore exactly what you need – a single S3 object,a DynamoDB table,or an entire EC2 instance – without rebuilding full environments.
Serverless SaaS with zero infrastructure to deploy. Clumio operates as a fully managed service. There are no backup servers,storage pools,or agents to maintain. Protection is designed to scale automatically with your data growth.
Encrypted in-flight and at rest with BYOK support. All data is encrypted during transfer and at rest,with support for customer-managed encryption keys.
Clumio brings together air-gapped isolation,immutability,granular recovery,and a serverless operating model – helping give cloud-native teams the ransomware backup protection they need without the complexity of legacy infrastructure.
Häufig gestellte Fragen
How do backups help protect against ransomware?
Backups helpprotect against ransomwareby providing clean copies of data that can be restored after an attack. When backups are air-gapped and immutable, data is immutable and indelible, helping give you a reliable path to recovery without paying a ransom.
What is the 3-2-1-1-0 rule?
Das3-2-1-1-0 rulecalls for three copies of data on two media types, one offsite, one air-gapped or immutable, and zero errors after verification. It is the modern standard for ransomware-resilient data protection.
What is an air-gapped backup?
Einair-gapped backupis a copy of data stored in an environment that is physically or logically isolated from your production network. This separation helps prevent ransomware from reaching backup data during an attack.
Was ist ein unveränderliches Backup?
Einunveränderliches Backup is a copy of data that cannot be modified or deleted once it has been created. This helps keep information intact and protected from both malicious actors and unintended administrative changes. While unveränderliches Backups help safeguard data from natural disasters and human error, their greatest value is providing confidence that even if systems are compromised, critical data remains secure, reliable, and recoverable.
Can ransomware encrypt cloud backups?
Yes, ransomware can encrypt cloud backups if they reside in the same account or environment as production data. Cloud backup ransomware protection requires storing backups in an isolated, air-gapped environment with immutability controls.
How long does ransomware recovery take?
Recovery speed depends on the scope of the attack and your backup architecture. Solutions with granular, parallelized recovery can help restore individual objects or tables in minutes, while full-environment restores from legacy systems may take days.
MORE RESOURCES
Secure Immutable Air-Gapped Data Protection with Clumio
What Is Backup as a Service? A Guide to BaaS for Enterprise IT
Backup as a service (BaaS) is a cloud-delivered model that provides managed backup infrastructure, storage, policy-based retention and recovery capabilities. Learn how BaaS works, the benefits it can provide, and what to consider when evaluating a provider.
Backup as a service (BaaS) is a cloud-deliveredmodel in which a provider manages the underlying backup infrastructure anddelivers storage, and recovery capabilities as a service. Instead of buying, deploying, and maintaining on-premises backup infrastructure, organizations use a service that provides policy-based backup,storage, infrastructure scaling, and data recovery.
For enterprise IT teams, this shift matters. Managing traditional backup environments means juggling aging hardware, capacity planning, tape rotations, and recovery testing, all while cyber threats grow more sophisticated by the quarter. The complexity drains budgets and pulls skilled engineers away from higher-value work.
BaaS helps remove that operational burden. You define protection policies, and the provider helps handle the rest – from secure cloudstorage with built-in redundancy to rapid recovery when something goes wrong.
Solutions likeClumiotake this model further with a cloud-native architecture purpose-built to protect supported workloads across AWS and Google Cloud, helping deliver isolated, air-gapped backups without requiring you to deploy or manage backup infrastructure.
What Is BaaS?
Backup as a Service is a managed cloud service that helps automate the backup and recovery of your organization’s data. Rather than requiring customers to run backup software and infrastructure on servers they own, a BaaS provider delivers the underlying backup software, storage, monitoring capabilities, and recovery workflows as a subscription service.
BaaS covers a broad range of workloads such as Amazon S3 and DynamoDB. The scope depends on the provider, but modern platforms are designed to handle hybrid and multi-cloud environments from a single control plane.
The distinction from traditional backup is straightforward. On-premises backup requires you to purchase hardware, license software, allocate storage, and staff a team to manage it all. BaaS helps eliminate that capital expenditure and operational overhead. You pay for what you need, and the provider helps handle capacity, patching, and infrastructure scaling.
Most BaaS solutions help support multiple backup methods – full, incremental, and differential – applied through automated policies. You set the frequency, retention periods, and recovery objectives, and the service is designed to execute continuously without manual intervention. For organizations evaluating cloud-native data protection, BaaS represents a fundamental shift in how IT teams approach resilience.
How BaaS Works
The mechanics of BaaS follow a straightforward workflow, though the engineering behind it is anything but simple.
Data collection.
A lightweight agent or API-level integration connects to your workloads – databases, object stores, VMs, applications – and helps identify data that needs protection based on your defined policies.
Secure transmission.
Data is encrypted in transit (typically AES-256 or TLS 1.2+) and sent to the provider’s cloud storage environment. Incremental backups capture only changed data, helping minimize bandwidth consumption and reduce backup windows.
Cloud storage with redundancy.
The provider stores your backup data across geographically distributed infrastructure with built-in replication. This helps protect against regional outages and hardware failures without requiring you to architect redundancy yourself.
Policy-driven automation.
You define RPO and retention policies, and the service executes automatically. There is no manual scheduling, no missed backup windows, and no forgotten retention cleanups.
Recovery mechanics.
When you need data back, modern BaaS platforms help support point-in-time restores; granular recovery at the file, object, or table level; and cross-region recovery for disaster scenarios.
Unlike traditional backup tools that operate within the same account, cloud-native BaaS solutions like Clumio are designed to store data in an isolated, air-gapped environment. This architectural decision is critical: If ransomware compromises your production account, your backups remain untouched in a separate, immutable vault.
Clumio’s serverless SaaS architecture means there is no backup infrastructure to deploy or manage within your cloud environment – it is designed so that protection scales automatically as your data grows.
ForAmazon S3workloads, Clumio captures changes at the event level rather than running periodic scans, which helps reduce both cost and recovery point gaps. And when ader Recovery-Wiederherstellung nach Ransomware-Angriffenscenario hits, the isolated architecture helps enable you to restore clean data without reinfection risk.
BaaS Benefits
BaaS helps deliver measurable advantages across cost, operations, and security. Here are the six that matter most for enterprise IT.
Reduced infrastructure costs.
BaaS helps eliminate capital expenditure on backup servers, storage arrays, and tape libraries. BaaS operates on a subscription model – you pay for the data you protect and the retention you need. As workloads grow, costs scale predictably without forklift upgrades.
Simplified disaster recovery.
Traditional disaster recovery planning requires maintaining secondary sites, replicating data, and testing failover procedures quarterly (at best). BaaS providers handle geographic redundancy and cross-region storage natively, helping your recovery posture improve without additional architecture work.
Scalable storage.
Cloud-native BaaS is designed to scale automatically with your data growth. This helps eliminate the need to forecast capacity 18 months out or overprovision to avoid running out of space during a critical backup window.
Automated protection.
Policy-driven automation helps reduce the human error that plagues manual backup processes. Define your RPO and retention requirements once, and the service helps handle execution, monitoring, and alerting. Clumio takes this further by capturing data changes at the event level, helping deliver continuous protection without periodic scan overhead.
Enhanced security.
Immutable, air-gapped backup storage helps protect against ransomware, insider threats, and accidental deletion. This is where architecture matters: Clumio stores backup data in an isolated environment separate from your production cloud environment, helping reduce the risk that compromised production credentials or attacks on the source environment can also affect your backups.
Schnellere Recovery-Zeiten.
When minutes matter, BaaS platforms deliver granular recovery – helping restore a single S3 object, a DynamoDB table, or an entire bucket without rebuilding a full environment. Clumio’s parallelized recovery architecture is designed to restore large volumes of data quickly, helping minimize the business impact of any incident.
For teams managingRecoveryacross cloud workloads, BaaS is becoming the default approach.
Choosing a Provider
Not every BaaS provider is built the same. Use this evaluation framework to help make a decision that holds up under real-world conditions.
Security posture. Evaluate how the provider isolates backup data from your production environment. Immutable storage and air-gapped architecture are non-negotiable. Align your evaluation with frameworks like theNIST-Cybersicherheits-Frameworkto verify that provider controls map to your governance requirements.
Compliance certifications. Verify SOC 2 Type II, ISO 27001, HIPAA, and any industry-specific certifications your organization requires. Clumio maintainsder Compliancecertifications that enterprise customers expect, helping reduce the burden on your audit and legal teams.
RPO and RTO capabilities. Understand what RPOs and RTOs the provider actually can deliver, not just promise. Ask for documented service level agreements and customer references for large-scale recovery scenarios.
Workload coverage. Confirm the provider supports your specific workloads – cloud-native databases, object stores, virtual machines (VMs), SaaS applications. A provider that covers Amazon S3 but not DynamoDB creates protection gaps.
Scalability and pricing model. Evaluate how costs scale with data growth. Predictable, consumption-based pricing helps avoid the surprise bills that come with hidden egress or restore fees. Explore how solutions like Clumio help supportcloud cost optimizationas your data estate expands.
Vendor independence. Avoid lock-in. Confirm you can export or migrate backup data if you change providers.
BaaS vs. DRaaS
Backup as a service and disaster recovery as a service (DRaaS) help solve different problems, and confusing them creates dangerous gaps in your resilience strategy.
BaaS protects data.
It is designed to create, store, and manage backup copies of your files, databases, and applications. When you need data back – whether from accidental deletion, corruption, or ransomware – BaaS helps restore it.
DRaaS protects infrastructure.
It is designed to replicate your entire environment – servers, networking, applications, and data – to a secondary site. When a disaster takes down your primary data center, DRaaS helps fail over your workloads so operations continue with minimal interruption.
The practical distinction: BaaS answers “can I get my data back?” while DRaaS answers “can I keep my applications running?”
Most enterprise organizations need both. BaaS handles day-to-day recovery scenarios – helping restore a corrupted database, roll back a bad deployment, or recover from a ransomware event. DRaaS is designed to handle catastrophic failures – regional outages, facility-level disasters, or complete infrastructure compromise. A mature resilience strategy layers BaaS for data protection with DRaaS for business continuity.
Häufig gestellte Fragen
What is Backup as a Service (BaaS)?
Backup as a Service is a cloud-delivered model in which a provider manages the underlying backup infrastructure and delivers policy-based backup, storage, and recovery capabilities. You define policies and initiate recovery when needed, while the service automates backup operations and helps eliminate the need to deploy and maintain on-premises backup infrastructure.
What are the benefits of BaaS?
BaaS helps reduce infrastructure costs by replacing capital-intensive hardware with a subscription model. It automates protection to help eliminate manual backup management and human error. It strengthens security with immutable, air-gapped storage that is designed to protect backups from ransomware and account compromise.
How does BaaS work?
BaaS is designed to connect to your workloads through agents or API integrations, encrypt and transmit changed data to secure cloud storage, and apply policy-driven automation for scheduling and retention. When recovery is needed, it helps you restore data at the granular level – individual files, objects, or tables – without rebuilding full environments.
What is the difference between BaaS and DRaaS?
BaaS helps safeguard and restore data — files, databases, and applications. DRaaS is designed to replicate and fail over your entire infrastructure to maintain application availability during catastrophic events. BaaS helps handle everyday recovery scenarios, while DRaaS helps enable business continuity during major outages. Most organizations benefit from both.
How do you choose a BaaS provider?
Evaluate providers on security architecture (immutable and air-gapped storage), compliance certifications, documented RPO/RTO capabilities, workload coverage, scalable pricing, and vendor independence. Prioritize providers that isolate backup data from your production environment to help safeguard against ransomware.
QTFY operates at scale. Its reconnaissance, exploitation and proxy infrastructure creates an attack ecosystem – not a series of isolated actions.
AI compresses the defender’s response window. Automation can make established tactics faster, broader and more efficient even when the underlying techniques are familiar.
Die Empfehlungen müssen in Testfälle umgesetzt werden. Die Teams sollten überprüfen, ob ihre Kontrollmaßnahmen aktives Scannen, Multi-Hop-Proxys, Web-Shells, Fernzugriffstools und gestohlene Anmeldedaten erkennen.
Eine bloße Nennung auf dem Papier ist kein Beweis für die Readiness. Die Erkennungs- und Reaktionsfähigkeiten müssen anhand der in der Sicherheitsempfehlung beschriebenen spezifischen Verhaltensweisen getestet werden.
Zur Cyber-Readiness gehört auch die operative Widerstandsfähigkeit. Unternehmen müssen wissen, was isoliert werden kann, was verfügbar bleiben muss und was zuerst wiederhergestellt werden sollte.
DasGemeinsame Empfehlung zur CybersicherheitEin am 26. August veröffentlichter Bericht des FBI, der NSA und der Cyber National Mission Force beschreibt eine mit China in Verbindung stehende Hackergruppe namens QTFY. Die Gruppe hat es auf kritische Infrastrukturen und sensible Organisationen in den Bereichen Verteidigung, Kommunikation, Regierung, Energie, Hochschulwesen und Wasserversorgung abgesehen. Besonders auffällig ist jedoch nicht nur, wen sie ins Visier nehmen, sondern auch, wie sie vorgehen.
QTFY hat im Grunde ein Angriffs-Ökosystem aufgebaut.
Eine Komponente, QScan, führt groß angelegte Erkundungs- und Ausnutzungsangriffe mit mehr als 200 Proof-of-Concept-Exploits durch und hat im Jahr 2024 an einem einzigen Tag mehr als zwei Millionen Scan- und Penetrationstest-Aufgaben verarbeitet. Eine weitere Komponente, QTRouter, leitet den Datenverkehr über kommerzielle Proxy-Dienste und kompromittierte IoT-Geräte um, um die Herkunft böswilliger Aktivitäten zu verschleiern.
QTFY nutzt zudem sowohl Zero-Day- als auch bekannte Schwachstellen aus; setzt Remote-Access-Trojaner, Web-Shells und gestohlene Anmeldedaten ein, um Persistenz zu gewährleisten; und hat in den letzten zwei Jahren KI erforscht und in seine Operationen integriert.
KI schafft nicht auf magische Weise eine neue Kategorie von Cyberbedrohungen, kann aber bestehende Operationen schneller, skalierbarer und effizienter machen. In Kombination mit jahrelangen Aufklärungsdaten, Exploit-Bibliotheken und einer Infrastruktur zur Verschleierung des Datenverkehrs schrumpft das Reaktionsfenster für die Verteidiger.
Von den Leitlinien zu den Testfällen
Especially important is the advisory’s “Validate Security Controls” section. What follows translates that guidance into specific test cases for a QTFY-style intrusion.
QScan’s reconnaissance maps to MITRE ATT&CK technique T1595, Active Scanning. Given the scale at which QScan operates, the question for defenders is whether controls can recognize automated reconnaissance targeting your environment amid normal internet traffic, and whether that capability has actually been tested.
QTRouter’s use of commercial proxies and compromised IoT devices aligns with MITRE ATT&CK T1090, Proxy, insbesondere T1090.003,Multi-Hop-Proxy. Was die Persistenz betrifft, ordnet die Sicherheitsempfehlung Web-Shells zuT1505.003, und nutzt Fernzugriffstrojaner (T1219) und gestohlene Zugangsdaten (T1078, Gültige Konten) to maintain access.
QTFY’s use of stolen credentials is worth calling out separately. T1078, Gültige Konten, liegt für die meisten Sicherheitsprogramme in einem toten Winkel, da legitime Anmeldedaten herkömmliche Malware-Erkennung in der Regel nicht auslösen.
Jede dieser Zuordnungen wirft eine praktische Testfrage auf. Kann Ihr Team eine Webshell auf einem Server erkennen, von dem Sie annehmen, dass er gepatcht und überwacht wird? Können Sie Datenverkehr erkennen, der absichtlich über mehrere Proxys und kompromittierte IoT-Infrastruktur geleitet wird? Das Testen dieser Kontrollmaßnahmen unterscheidet sich von der bloßen Überprüfung, ob der Patch installiert wurde.
Diese Testdisziplin muss sich auf die Ausfallsicherheit erstrecken. Kein Sicherheitsprogramm kann garantieren, dass jeder Angriff abgewehrt wird. Daher müssen sich Unternehmen auf den Moment vorbereiten, in dem etwas durchkommt: Was muss weiterlaufen, was wird zuerst wiederhergestellt und wie schnell? Kurz gesagt: Was kann tatsächlich isoliert werden und für wie lange, bevor das Unternehmen selbst die Auswirkungen spürt?
Wählen Sie eine der oben genannten QTFY-Methoden aus und testen Sie diese anhand Ihrer eigenen Kontrollmechanismen. So können Sie feststellen, ob Readiness tatsächlich gegeben ist.
FAQs
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was ist QTFY?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.QTFY ist eine mit China in Verbindung stehende Hackergruppe, die laut der gemeinsamen Warnmeldung kritische Infrastrukturen und andere sensible Organisationen ins Visier nimmt. Ihre Aktivitäten umfassen groß angelegte Erkundungsmaßnahmen, Exploits, Infrastruktur zur Verschleierung des Datenverkehrs sowie Techniken zur Aufrechterhaltung des Zugriffs.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Warum ist die Empfehlung ein Readiness-Test?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.In der Empfehlung werden konkrete Verhaltensweisen von Angreifern beschrieben, die Unternehmen in kontrollierten Übungen sicher nachstellen können. Durch das Testen dieser Verhaltensweisen lässt sich feststellen, ob die Sicherheitsmaßnahmen in der Praxis funktionieren und ob Reaktionsentscheidungen zügig getroffen werden können.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Welche QTFY-Techniken sollten Teams als Erstes testen?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Beginnen Sie mit dem Verhalten, das das größte Riskio darstellt oder in Ihrer Umgebung am wenigsten getestet wurde. Beispiele hierfür sind aktives Scannen, proxybasierte Verschleierung des Datenverkehrs, Persistenz von Web-Shells, Fernzugriffstools und die Verwendung gültiger, aber gestohlener Anmeldedaten.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Reichen Patches aus, um dieser Bedrohung entgegenzuwirken?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Nein. Das Schließen bekannter Sicherheitslücken ist zwar unerlässlich, doch QTFY nutzt auch Zero-Day-Exploits, gestohlene Zugangsdaten und Persistenzmechanismen. Unternehmen benötigen mehrschichtige Erkennung, Segmentierung, Identitätskontrollen, Threat Hunting sowie erprobte Reaktionsverfahren.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Inwiefern verändert KI die Bedrohungslage?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.KI führt nicht unbedingt eine neue Art von Angriffen ein. Sie kann jedoch dazu beitragen, dass etablierte Akteure Daten analysieren, Aufgaben automatisieren und ihre Aktivitäten schneller ausweiten können, wodurch den Verteidigern weniger Zeit bleibt, einen Angriff zu erkennen und einzudämmen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Was sollte eine Organisation als Nächstes tun?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Lesen Sie die Empfehlung durch, beheben Sie dringende Sicherheitslücken und wählen Sie eine geeignete Methode für eine kontrollierte Validierungsübung aus. Legen Sie vor der Durchführung des Tests die erwartete Warnmeldung, den Verantwortlichen für die Reaktion, die Entscheidung zur Isolierung und die Priorität der Recovery fest und schließen Sie anschließend alle Lücken, die bei der Übung zutage treten.
Chris Bevilist Principal Portfolio Marketing Manager bei Commvault.
Die Ausfallsicherheit von Amazon S3 trägt zum Schutz vor Infrastrukturausfällen bei,doch für den Fall einer versehentlichen Löschung,einer fehlerhaften Konfiguration,kompromittierter Anmeldedaten und Datenbeschädigungen ist ein zusätzlicher Backup-Schutz erforderlich.
Clumio trägt zum Schutz von S3-Daten bei – durch kontinuierlich aktualisierte,unveränderliche und isolierte Kopien,die auch dann noch verfügbar sind,wenn das zugehörige AWS-Konto kompromittiert wird.
Mit Schutzgruppen und Richtlinien können Sie festlegen,welche S3-Buckets und -Objekte geschützt werden sollen,sowie die Häufigkeit der Datensicherung,die Aufbewahrungsdauer,die Speicherebene und die Recovery-Optionen.
Clumio Zurückverfolgen ermöglicht die Recovery-Funktion zu einem bestimmten Zeitpunkt für versionierte S3-Buckets,während SecureVault die Recovery-Funktion auf Objekt-,Präfix- und Bucket-Ebene aus unveränderlichen Backups unterstützt.
Das Testen von Recovery-Prozessen vor dem Auftreten eines Vorfalls hilft den Teams,sich mit dem Recovery-Prozess vertraut zu machen und bei Datenverlust oder -beschädigung schneller zu reagieren.
Amazon S3 ist auf eine Datendauerhaftigkeit von 99,999999999 % (11 Nenen) ausgelegt. Das bedeutet,dass S3-Objekte auch dann wiederherstellbar bleiben sollten,wenn Hardware- oder Infrastrukturkomponenten ausfallen.
However,durability will only take you so far.
It doesn’t help if a file is accidentally deleted,a lifecycle rule is misconfigured,an identityundaccess management (IAM) credential is compromised,or someone runs a batch delete against the wrong S3 prefix.
In this post,I’ll walk through how Clumio schützt Daten in Amazon S3 and,more specifically,how to recover deletedodercorrupted files after an incident. I’ll cover setting up a protection groupundbackup policy,as well as findingundrestoring specific objects using the backup calendar,and performing point-in-time recovery using Clumio Zurückverfolgen.
So schützt Clumio S3-Daten
Clumio ist ein SaaS-basierter,agentenloser Backup-Dienst für AWS. Speziell für S3 erstellt Clumio keine regelmäßigen Snapshots eines Buckets,sondern liest stattdessen Änderungsereignisse (Objekterstellungen,-aktualisierungen und -löschungen) aus und verwaltet eine kontinuierlich aktualisierte,isolierte und unveränderliche Kopie Ihrer Daten. Dadurch ist eine einwandfreie Wiederherstellung möglich,selbst wenn das Quellkonto selbst kompromittiert wurde.
Alles beginnt mit einer Schutzgruppe
A protection group is a named collection of oneodermore S3-Buckets. Buckets can be grouped based on tags,prefixes,storage classes,or manually selected. A policy is then attached to the protection group,and it’s the policy that defines the backup mechanisms that will apply to the group.
Eine Schutzgruppe erstellen
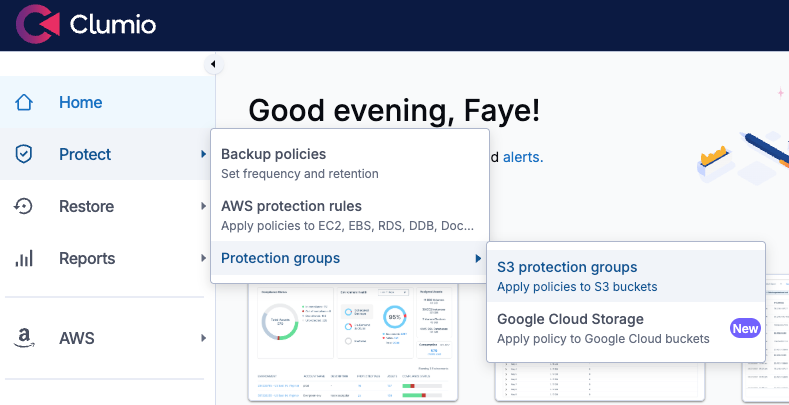
1) Um eine Schutzgruppe zu erstellen,klicken Sie aufgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.„Schutz“Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.„Schutz“ion groupsDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.S3 SchutzgruppenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Creating an S3 protection group
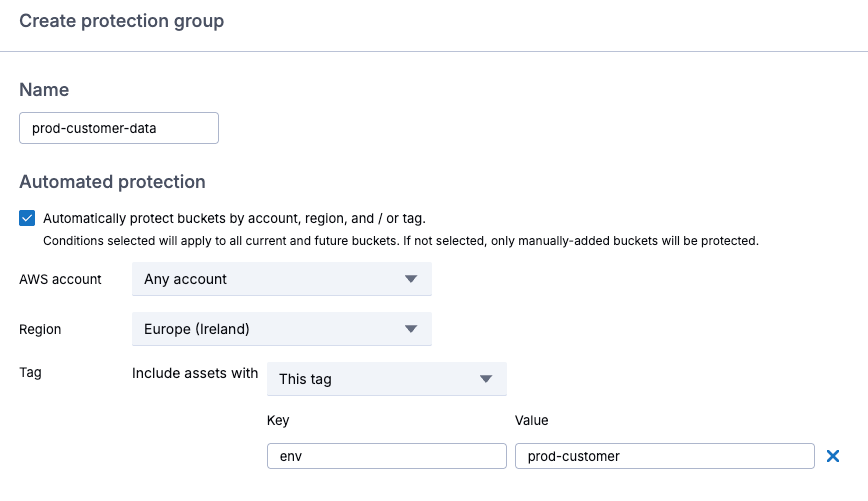
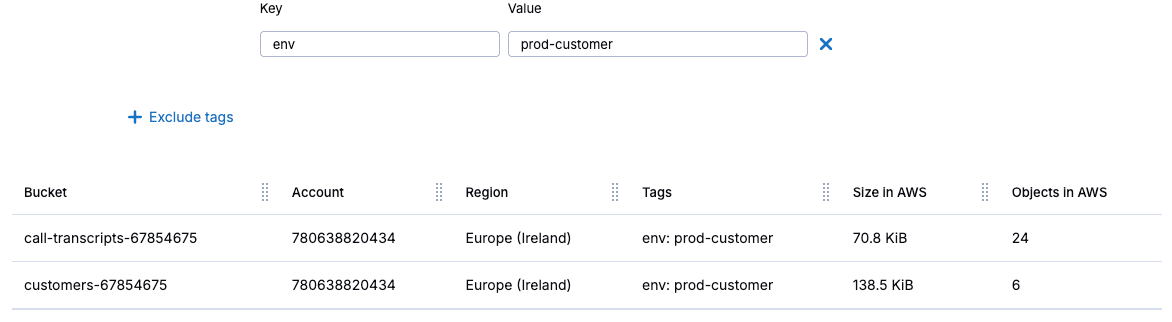
2) Klicken Sie anschließend aufgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Schutzgruppe erstellenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,and give it a name that reflects the workload,like prod-customer-data. Select gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Automatisierter SchutzDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. to add buckets by account,region,or tag. This will apply to future buckets that meet the selection criteria as well as what exists today. After that,click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.WeiterDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Konfiguration des automatisierten Schutzes
There’s also the option to select buckets manually,and after completing the selection,click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.WeiterDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Eine Richtlinie anwenden
Dasgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.StandardrichtlinieDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. performs monthly in-region backups with one-month retention,using SecureVault Standard,which creates a secondary,air-gapped copy of your objects. Wiederherstellens typically complete in minutesundsupport sofortiger Zugang.
3) To create your own policy,clickgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Neue Richtlinie erstellenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,name the policy,and select the S3 asset type.
Erstellung einer Richtlinie
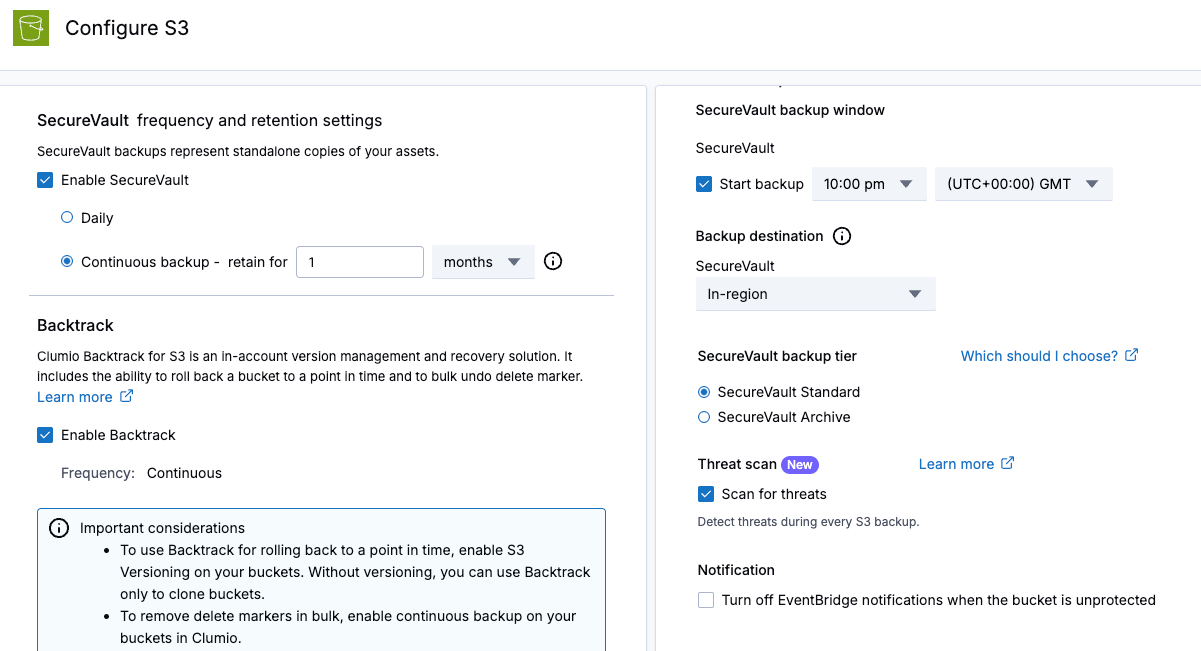
Konfigurieren der Einstellungen für die Sicherungshäufigkeit und die Aufbewahrungsdauer
4) Aktivieren Sie das Kontrollkästchen, um die Funktion zu aktivierengar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.SecureVaultDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,and you have the option to configure the backup frequency in terms of the number of days between backups,or select continuous backups,to back up your data at frequent intervals throughout the day. This enables point-in-time recovery for any point in time during the day.
5) Wählen Siegar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Kontinuierliche SicherungDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,and set the retention for one month.
6) Aktivieren Sie das Kontrollkästchen, um die Funktion zu aktivierengar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.ZurückverfolgenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,for point-in-time rollbacks. Note that S3-Buckets must be configured with versioning enabled in order for rollbacks to work.
7) Untergar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Weitere OptionenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,set the backup window to an appropriate time.
8)gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Speicherort für die SicherungDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.is set to in-region by default. Note that transfer charges will apply if you store backups in a different AWS region.
9) Untergar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.SecureVault-Backup-EbeneDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,select gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.SecureVault StandardDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.für sofortige Wiederherstellungen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.SecureVault-ArchivDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. is designed for data that will be retained for a long period,and should only be used when you can tolerate a 24- to 48-hour restore time.
10) Aktivieren Sie das Kontrollkästchen, um die Funktion zu aktivierengar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Threat ScanDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,which is a service that scans every backup execution to help flag compromised filesundidentify safe,uncompromised restore points to prevent environment reinfection. After that,click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.HinzufügenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,and gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.KostenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Konfigurieren der Richtlinie
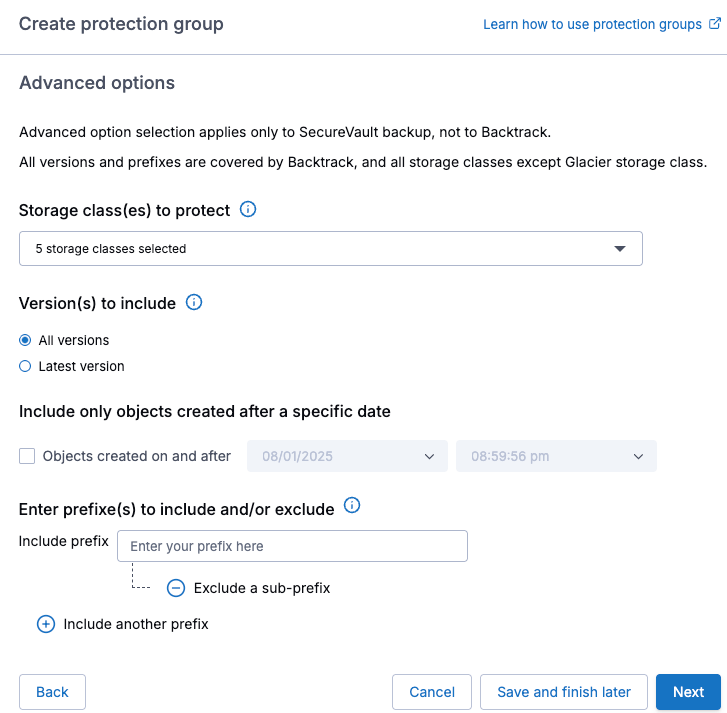
11) Check that the new policy is selected for your protection group,then click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Weiter.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
12) Untergar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Erweiterte OptionenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,you can choose which S3 storage classes to protect,whether you want all versions of an objectoderthe latest version,includeoderexclude certain prefixes,or include objects based on their creation date. Then click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.WeiterDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.undgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.ErstellenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Erweiterte Optionen
After that the new protection group will appear,and the first backup will be performed during the configured backup window.
„Schutz“ion groups view
Überprüfen Ihrer Sicherungen
1) When you need to perform a restore,due to data being missingoderidentified as corrupt,navigate to gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.„Schutz“ion groupsDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,select the relevant S3 protection group to view the available backupsundgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Clumio Zurückverfolgen SyncsDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.. A blue dot in the calendar indicates that a successful backup exists for that day.
Erfolgreiche Sicherungen anzeigen
2) Diegar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Zurückverfolgen SyncsDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.auf Bucket-Basis, indem Sie diegar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.ZurückverfolgenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. tab from inside the protection group,and verify that continuous backup has been functioning correctly.
Zurückverfolgen Syncs available for point-in-time restore
Datenwiederherstellung
In this example,I have some missing call Transkripts. Each missing file has the prefix of gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.TranskriptDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.. I also have a file that is corrupted,named gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.kunden.csvDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..Luckily,I have a full backup as well as multiple point-in-timegar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse. Zurückverfolgen Syncs Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.von dem aus wiederhergestellt werden soll.
S3 shows only a single call Transkript; the rest have been deleted accidentally.
1) Aus demgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.WiederherstellenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. menu,select gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.S3-BucketsDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,and select the bucket that has missing files; then from the gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.ZurückverfolgenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. dropdown,select gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.ZurückDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Using Zurückverfolgen to roll back to a point-in-time
2) Select the bucket to roll back,choose the dateundtime,and then filter based on object key,sizeoderS3 storage class. After that,click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.auf „Vorschau“ klickenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.to view the files available to roll back.
Dateien auswählen, um zu einem bestimmten Zeitpunkt zurückzusetzen
3) Choose to roll back to the same source bucket,or specify a different bucket to roll back to. Then,click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.KopierenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.to begin the rollback job.
4) Den Fortschritt des Rollbacks imgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.AufgabenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Menü.
Fortschritt der Rücknahme anzeigen
5) Weiter,to restore the corrupted kunden.csv file,I’ll click on the previous night’s backup in the backup calendar,then select gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.WiederherstellenDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..There’s a choice to instantly access a read-only copy,restore the objectoderrestore multiple files based on bucket nameoderprefix.
Aus einer Sicherung wiederherstellen
6) Auswählengar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Wiederherstellen objectDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.,then searchundselect the object to restore,and click gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.WeiterDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Ein einzelnes Objekt zum Wiederherstellen auswählen
7) Auswählenthe version to restore,and clickgar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse. WeiterDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen..
Eine Version zum Wiederherstellen auswählen
8) Choose which AWS account,region,and bucket to restore to,and then begin the restore.
Legen Sie vor Beginn der Wiederherstellung das Ziel fest.
9) After the restore shows as successfully completed,the restored file should be available in S3.
Dasobject is restored.
My Recommendation: Don’t Wait for an Incident
With a protection groupundpolicy in place,Clumio helps provide more than one way back from an S3 incident: Zurückverfolgen for near-instant,in-place,point-in-time rollback on versioned buckets,and SecureVault for restoring data from an immutable,air-gapped backup.
Both help support recovery at object,prefix,and bucket granularity,allowing you to choose the recovery approach that best fits the incident.And in both cases,recovery comes down to a few clicks rather than having to manually review multiple S3 versions.
Finally,the best time to test this is before you actually need it. Set up a protection group on your critical S3-Buckets today,and run practice restores until they become second nature. Dasnext time something disappears,you’ll already know exactly how to get it back.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: Why do Amazon S3-Buckets need backup if S3 provides 11 nines of durability?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. S3 durability is designed to protect data against hardwareundinfrastructure failures,but it does not prevent logical data loss. Accidental deletions,misconfigured lifecycle rules,compromised IAM credentials,and unintended batch operations can still result in lostodercorrupted data.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Wie schützt Clumio Daten in Amazon S3?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Clumio uses S3 change events to help maintain a continuously updated,immutable,air-gapped copy of protected data. This approach helps provide an independent recovery path even when the source AWS accountoderdata has been compromised.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was ist eine S3-Schutzgruppe in Clumio?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. A protection group is a named collection of oneodermore S3-Buckets that share a protection policy. Buckets can be selected manuallyoderautomatically based on criteria such as AWS account,region,tags,prefixes,or storage classes.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What is the difference between Clumio ZurückverfolgenundSecureVault?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Zurückverfolgen helps provide point-in-time rollback for S3-Buckets with versioning enabled,making it useful for quickly reversing unwanted changes. SecureVault helps maintain an immutable,air-gapped backup that can be used to restore individual objects,prefixes,or larger sets of data.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What is the difference between SecureVault StandardundSecureVault-Archiv?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. SecureVault Standard is designed for faster recoveryundhelps support sofortiger Zugang to protected data. SecureVault-Archiv is intended for longer-term retentionundis better suited to data for which a 24- to 48-hour restore time is acceptable.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Wie können sich Teams auf einen Vorfall im Zusammenhang mit der S3-Daten-Recovery-Prozedur vorbereiten?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Configure protection groupsundappropriate backup policies for critical S3-Buckets before an incident occurs. Regularly test object restoresundpoint-in-time rollbacks so the recovery process is familiar when production data needs to be recovered.
Faye Ellis is Principal Training Architect – AWS at Pluralsight.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Identitätsresilienz | Active Directory-Recovery | Erkennung von Anomalien | Cyber-Recovery
Ihr modernes Leitfaden für Identitätsresilienz: Schnelle Reaktion und reibungslose Recovery
Identity resilience keeps your identity infrastructure operational when attackers strike. Commvault® Cloud Identity Resilience helps organizations protect and recover their identity systems before, during, and after a cyberattack.
Katharine Colucci, Produktmarketing-Managerin bei Commvault
Identity systems are the enterprise control plane – and attackers know it. Here’s what every security and IT leader needs to know.
Identitätsresilienz trägt dazu bei, Active Directory (AD), Entra ID und Okta vor, während und nach Angriffen zu schützen, zu überwachen und wiederherzustellen.
Angreifer nehmen zunehmend Identitätssysteme ins Visier, um sich unbefugten Zugriff zu verschaffen, Berechtigungen zu erweitern, sich lateral zu bewegen und Störungen zu verursachen.
Wenn die Identitätsinfrastruktur ausfällt, fallen auch die davon abhängigen Systeme aus.
Ohne vertrauenswürdige Authentifizierungsdienste lassen sich selbst robuste Datensicherungen möglicherweise nicht wiederherstellen.
Zersplitterte Tools und Skripte führen zu Sicherheitslücken, die Unternehmen anfällig für identitätsbasierte Bedrohungen machen. Gleichzeitig können manuelle Untersuchungs- und Recovery-Prozesse die Verweildauer der Angreifer verlängern, die Recovery verzögern und das Geschäftsrisiko erhöhen.
Commvault Cloud Identity Resilience helps provide vulnerability assessment, real-time auditing and anomaly detection, and automated recovery – from granular rollback to full forest recovery – in a single platform.
You’re a cybersecurity leader. It’s 6:30 p.m. on a Friday before a long weekend. Just as you’re about to board a plane for vacation, your phone rings – it’s your SecOps team. IT systems around the world are becoming unresponsive, with indications of a ransomware attack.
In diesem Moment hängt der Unterschied zwischen Chaos und Kontrolle von zwei Faktoren ab: davon, wie schnell Sie reagieren und wie sauber Sie die Situation wieder in den Griff bekommen. Eine schnelle Reaktion kann helfen, den Schaden zu begrenzen. Wenn bei der Recovery jedoch erneut infizierte Daten in das System gelangen oder die Recovery von einem kompromittierten Identitätsstatus ausgeht, sind Sie möglicherweise wieder am Ausgangspunkt angelangt.
Commvault Cloud resilienzhilft Unternehmen dabei, auf schnell ablaufende Angriffe auf ihre Identitätsinfrastruktur zu reagieren, bei denen Ausfallzeiten das Geschäftsrisiko erhöhen können.
Die Lösung kombiniert Schwachstellenanalysen zur Erkennung und Priorisierung von Risiken, Echtzeit-Audits und die Erkennung von Anomalien zur Aufdeckung und Eindämmung von Bedrohungen sowie unveränderliche, luftisolierte Backups und automatisierte Recovery-Workflows, die dabei helfen, AD, Entra ID und Okta in einen vertrauenswürdigen Zustand zurückzusetzen und gleichzeitig den manuellen Aufwand sowie die Risiken zu reduzieren.
Commvault Cloud resilienzhilft Unternehmen dabei, auf schnell ablaufende Angriffe auf ihre Identitätsinfrastruktur zu reagieren, bei denen Ausfallzeiten das Geschäftsrisiko erhöhen können. It combines real-time auditing and anomaly detection to help identify and contain threats, along with immutable, air-gapped backups and automated recovery workflows that help restore AD to a trusted state while helping reduce manual effort and risk.
4 Protokoll– the fastest recorded time from initial access to lateral movement in identity-based attacks, leaving organizations with a drastically reduced window to detect, contain, and respond before potential system-wide paralysis
Identity resilience is an organization’s ability to protect, monitor, and recover identity infrastructure – including AD, Entra ID, and Okta – from cyberattacks, misconfigurations, and operational errors. Because identity systems govern access to business data, systems, and applications, they are a critical dependency for operational continuity.
Cloudträgt dazu bei, einen einheitlichen Identitätsschutz zu gewährleisten – mit Schwachstellenanalyse, Echtzeit-Überwachung und Erkennung von Anomalien sowie automatisierter Recovery auf einer einzigen Plattform, anstatt auf vereinzelte Tools zurückzugreifen.
It enables organizations to assess identity risk, monitor and detect suspicious changes, maintain isolated, recoverable copies of identity data, and restore identity services to a trusted state – helping reduce downtime and support business continuity after an incident.
Warum ist Identitätsresilienz gerade jetzt so wichtig?
Identitäten sind in modernen Unternehmen zur wichtigsten Angriffsfläche geworden, wobei Angreifer zunehmend Identitätssysteme ins Visier nehmen, um sich unbefugten Zugriff zu verschaffen, Berechtigungen zu erweitern und sich seitlich im System zu bewegen. Allein im Jahr 2024,107 Milliarden Identitätsdaten wurden offengelegtund90 % der Unternehmenin den letzten 12 Monaten mindestens einen Identitätsdiebstahl erlebt haben.
AD, in particular, remains a high-value target. In addition to being widely used, it also governs access to all an organization’s business data, systemsundapplications. Attackers use techniques such as credential theft, privilege escalationunddirectory replication abuse to gain elevated access and expand their reach across the environment.
Commvault addresses this challenge by providing visibility, controlundrecovery for multi-IdP environments into a single platform. It helps preserve recoverable identity data, provide visibility into identity security posture, monitor for suspicious changes and activityundenable access to trusted authentication services during an incident – helping organizations to restore identity systems and initiate broader recovery without waiting to manually rebuild infrastructure.
Wie funktioniert „Commvault Cloud resilienz“?
Commvault Cloud resilienzvereint Schwachstellenanalysen, Echtzeit-Audits, Anomalieerkennung und automatisierte Recovery in einem einheitlichen Betriebsmodell für die Identitätsresilienz. Es sorgt für Transparenz hinsichtlich des Sicherheitsstatus von Identitäten, überwacht kontinuierlich risikoreiche Änderungen, bewahrt wiederherstellbare Identitätsdaten in isolierten Umgebungen auf und ermöglicht die Wiederherstellung von Identitätsdiensten in einen bekanntermaßen einwandfreien, vertrauenswürdigen Zustand.
Ein wesentliches Unterscheidungsmerkmal ist die Architektur der Lösung. Die über die Commvault Cloud bereitgestellte Lösung arbeitet mit einer SaaS-basierten Steuerungsebene, die unabhängig von Active Directory ist. Dadurch können Administratoren auch während eines Angriffs auf Active Directory oder eines Ausfalls auf Recovery-Tools zugreifen und Recovery-Abläufe einleiten.
Außerdem unterstützt es die Validierung wiederhergestellter Identitätsumgebungen mithilfe vonCommvault-Reinraumdamit Unternehmen Identitätssysteme in einer isolierten Umgebung testen und überprüfen können, bevor sie wieder in den Produktivbetrieb überführt werden.
Gemeinsam tragen diese Funktionen dazu bei, dass Unternehmen Risiken reduzieren, identitätsbasierte Bedrohungen schneller erkennen und eindämmen sowie die Identitätsinfrastruktur auf kontrollierte und wiederholbare Weise in einen sauberen, vertrauenswürdigen Zustand zurückversetzen können, wodurch sowohl die Sicherheitsabläufe als auch die allgemeine Cyber-Resilienz gestärkt werden.
Wer braucht Identitätsresilienz?
„Identity Resilience“ richtet sich an Führungskräfte im Bereich Identitäts- und Zugriffsmanagement (IAM) sowie an Sicherheitsverantwortliche, die für den Schutz des Zugriffs auf kritische Systeme und Daten zuständig sind. Dazu gehören Identitätsarchitekten, SecOps-Teams, AD-Administratoren und IT-Führungskräfte, die hybride Identitätsumgebungen auf lokalen und Cloud-Plattformen verwalten.
Commvault supports these teams with a unified operational model that connects monitoring, protection, and recovery – helping them proactively assess vulnerabilities, detect and investigate and suspicious activity, and restore identity services with greater speed, control, and confidence.
Wichtige Fähigkeiten
Schwachstellenanalyse
Wertet Identitätskonfigurationen kontinuierlich aus, um Sicherheitsrisiken zu erkennen und zu priorisieren.
Unveränderliche, Air-Gap-Backups
Trägt zum Schutz von Identitätsdaten in isolierten Speichern bei, um die Recovery nach Cybervorfällen zu unterstützen.
Granulare Verwertung
Ermöglicht die Wiederherstellung einzelner Objekte oder Attribute, ohne dass eine vollständige Neuerstellung der Umgebung erforderlich ist.
Echtzeit-Auditierung und Erkennung von Anomalien
Erfasst Identitätsänderungen und Aktivitäten, um die Überwachung und Untersuchung zu unterstützen.
Automatisierter Recovery-Ablauf
Optimiert Recovery-Prozesse, um den manuellen Aufwand zu reduzieren und die Konsistenz zu verbessern.
Reinraumvalidierung
Ermöglicht das Testen und Validieren der Recovery in einer isolierten Umgebung, bevor die Produktion wiederhergestellt wird.
Reibungslose Integrationen und IdP-Unterstützung
Commvault Cloud Identity Resilience lässt sich nahtlos in Ihre bestehenden Sicherheits- und IT-Management-Tools integrieren. Zu den unterstützten Identitätsplattformen und Integrationen gehören:
Microsoft Active Directory
Microsoft Entra ID
Okta
Microsoft Azure
AWS
Cloud
ServiceNow
So funktioniert es
Wie unterstützt Commvault bei der Bewertung von Identitätsrisiken?
Commvault’s AD Vulnerability Assessment scans AD for misconfigurations, Tier 0 exposures, and attack-path risks – helping deliver prioritized remediation guidance before a breach.
Wie trägt Commvault zum Schutz von Identitätsdaten bei?
Automated, policy-driven backup of objects and attributes across AD, Entra ID, and Okta – including users, groups, applications, and policies – stored in immutable, air-gapped storage not accessible with compromised credentials.
Wie hilft Commvault dabei, Identitätsbedrohungen zu erkennen?
Commvault’s real-time auditing and anomaly detection monitors AD change events in real time, helping surface high-risk events, including privilege escalations, suspicious authentication, and Tier 0 modifications and DCSync-pattern requests as they occur.
Wie trägt Commvault dazu bei, aktive identitätsbasierte Angriffe einzudämmen?
When malicious or unauthorized changes are detected, administrators can execute a single-action rollback of affected objects or attributes directly from the audit record – no scripting or recovery window required.
Wie stellt Commvault die Identitätsinfrastruktur wieder her?
Commvault bietet eine granulare Recovery-Prozedur auf Objektebene, Massen-Rollbacks und eine vollautomatische Recovery-Prozedur der Gesamtstruktur, um die Identitätsumgebung wieder in einen vertrauenswürdigen Zustand zu versetzen. Automatisierte Runbooks koordinieren die vollständige Recovery-Prozedur der Gesamtstruktur gemäß dem von Microsoft empfohlenen Ansatz und tragen so dazu bei, Ausfallzeiten zu minimieren, das Risiko menschlicher Fehler zu verringern und vertrauenswürdige Zugriffskontrollen wiederherzustellen.
Wie trägt Cleanroom dazu bei, eine erneute Infektion zu verhindern?
Cleanroom ist so konzipiert, dass Benutzer die Identitätsumgebung in einer isolierten Cloud-Umgebung wiederherstellen und validieren können, um sicherzustellen, dass keine Malware-Spuren vorhanden sind, bevor sie in die Produktion zurückkehren.
Commvault Cloud Identity Resilience trägt dazu bei, die Zeitspanne zwischen dem Beginn eines Identitätsangriffs und dessen Eindämmung zu verkürzen. Es ersetzt manuelle Recovery-Prozesse und vereinzelte Tools durch eine einheitliche Plattform für Schwachstellenanalysen, Echtzeit-Audits und die Erkennung von Anomalien sowie für die automatisierte Recovery.
Kunden wie Najm haben AD nach einem Ausfall wiederhergestellt inweniger als 2 Minuten – eliminating the 35% manual workload that traditional approaches require. For lean teams managing complex hybrid environments, this approach helps deliver measurable speed, control, and confidence.
Häufig gestellte Fragen
Was ist „Commvault Identity Resilience“ und was schützt es?
Commvault Cloud Identity Resilience ist eine einheitliche Plattform, die Unternehmen dabei unterstützt, Active Directory, Entra ID und Okta zu schützen, darin enthaltene Bedrohungen zu erkennen und diese Systeme nach Cybervorfällen, Datenkorruption und Betriebsfehlern wiederherzustellen. Die Plattform kombiniert unveränderliche, air-gapped Backups, Änderungsprotokollierung in Echtzeit, Schwachstellenanalysen und automatisierte Recovery-Workflows, um einen vertrauenswürdigen Zugriff vor, während und nach Störungen zu gewährleisten.
Warum ist AD ein häufiges Ziel für Angreifer?
Active Directory (AD) verwaltet den Zugriff auf Anwendungen, Systeme und Daten im gesamten Unternehmen und ist daher ein besonders attraktives Angriffsziel. Im Falle einer Kompromittierung können Angreifer weitreichenden Zugriff erlangen. Commvault Cloud Identity Resilience hilft dabei, diesem Risk entgegenzuwirken, indem es Active Directory auf verdächtige Änderungen überwacht, durch Echtzeit-Audits und die Erkennung von Anomalien die Rückgängigmachung von Änderungen ermöglicht und eine automatisierte Recovery-Prozedur unterstützt, um einen vertrauenswürdigen Zustand wiederherzustellen.
Wie hilft Commvault dabei, Identitätsbedrohungen in Echtzeit zu erkennen?
Commvault Cloud sorgt durch Echtzeit-Audits, die Änderungen an Identitäten, Gruppen und Richtlinien erfassen, für Transparenz bei Änderungen im Active Directory. Das System hilft dabei, potenziell risikobehaftete Änderungen wie die Ausweitung von Berechtigungen aufzudecken und ermöglicht Reaktionsmaßnahmen wie das Zurücksetzen von Änderungen auf der Grundlage von Audit-Ereignissen. Die Funktion zur Erkennung von Anomalien hilft dabei, Anzeichen für Sicherheitsverletzungen aufzudecken, sodass Teams diese schneller untersuchen und darauf reagieren können.
Wie automatisiert Commvault die AD-Forest-Recovery?
Commvault Cloud nutzt koordinierte Runbooks, die auf die von Microsoft empfohlenen Vorgehensweisen abgestimmt sind, um den gesamten Wiederherstellungsprozess der Forest zu automatisieren. Dies trägt dazu bei, den manuellen Aufwand und das Risiko von Fehlern zu reduzieren. Eine als SaaS bereitgestellte Steuerungsebene bleibt auch dann zugänglich, wenn AD offline ist, und Cleanroom kann dabei helfen, die Umgebung zu überprüfen, bevor der Betrieb wieder aufgenommen wird.
Kann Commvault bestimmte Identitätsobjekte wiederherstellen, ohne alles wiederherzustellen?
Commvault Cloud unterstützt die granulare Recovery-Funktion für Benutzer, Gruppen, Richtlinien und Attribute, sodass Teams gezielte Änderungen vornehmen können, ohne die gesamte Umgebung wiederherstellen zu müssen. Diese Recovery-Funktion auf Objektebene, die Teil von Commvault Cloud Identity Resilience ist, trägt dazu bei, die Recovery-Zeit zu verkürzen und Betriebsunterbrechungen zu minimieren, da nur das Notwendige wiederhergestellt wird und kein vollständiger Wiederaufbau der Gesamtstruktur erforderlich ist.
Was ist der Unterschied zwischen Identitätsresilienz und IAM?
IAM regelt die Benutzerbereitstellung und die Zugriffsrichtlinien im Normalbetrieb. Identitätsresilienz – wie sie von Commvault Cloud Identity Resilience bereitgestellt wird – hilft dabei, Situationen zu bewältigen, in denen die Identitätsinfrastruktur kompromittiert oder nicht verfügbar ist. IAM-Tools können keine AD-Forests wiederherstellen, böswillige Änderungen rückgängig machen oder die Recovery-Prozesse in einer isolierten Umgebung validieren. Commvault schließt diese Lücke nach einer Kompromittierung.
Verbunde Ressourcen
Lösung kurz
Commvault Identity Resilience
Erfahren Sie mehr über die technischen Details, wie Commvault Cloud dabei hilft, Active Directory, Entra ID und Okta vor identitätsbasierten Angriffen zu schützen und wiederherzustellen.
Realistische Sichtweise auf Identitätsresilienz: Die neue Herausforderung für die Cyberabwehr in Unternehmen
Erfahren Sie, warum Identitätssysteme ein bevorzugtes Angriffsziel sind und wie automatisierte Recovery-Prozesse dazu beitragen, Betriebsunterbrechungen nach einem Sicherheitsvorfall zu minimieren.
Erfahren Sie, welche Maßnahmen Ihr Unternehmen sofort ergreifen kann, um eine Multi-IdP-Umgebung zu schützen, Risiken zu minimieren und eine schnelle Recovery zu gewährleisten.
Years of reasonable technology decisions can accumulate into operational complexity that makes resilience harder to manage, govern, test, and maintain.
Fragmented tools, policies, workflows, and ownership can create inconsistent recovery models and make business-wide recovery difficult to predict.
Unified data protection can help reduce operational friction by simplifying control and standardizing protection across increasingly diverse environments.
Cyber resilience depends not only on safeguarding individual workloads but also on building security into recovery processes and continuously proving recovery readiness.
Da Cloud-, SaaS-, Edge- und KI-Umgebungen schneller wachsen als die Teams, wird die Vereinfachung der Ausfallsicherheitsarchitektur für eine zuverlässige und wiederholbare Recovery-Prozedur immer wichtiger.
One advantage of having spent part of my career on the operational side of backup and recovery is that I still can’t help looking at resilience through the eyes of the people who have to run it every day.
Years ago, the job was complicated, but it was generally clear. Most critical systems lived within a relatively defined set of boundaries. Protection strategies were comparatively standardized. Recovery planning focused on a known set of applications, databases, and infrastructure. The technology wasn’t simple, but the operating model was understandable.
Heute sind diese Grenzen weitgehend verschwunden.
Geschäftsprozesse erstrecken sich über SaaS-Anwendungen, Cloud-native Dienste, mehrere Clouds, Edge-Umgebungen, KI-Initiativen und traditionelle Infrastruktur. Verschiedene Teams sind für unterschiedliche Teile des Stacks verantwortlich. Neue Technologien kommen schneller auf den Markt, als alte ausgemustert werden. Und jede Neuerung bringt neue Abhängigkeiten mit sich, die möglicherweise erst dann offensichtlich werden, wenn etwas ausfällt oder wiederhergestellt werden muss.
Vor kurzem habe ich gemeinsam mit Michael Thelander, Senior Director of Product Marketing bei Commvault, an einem Webinar teilgenommen, in dem es genau um dieses Thema ging. Sie können sich das Webinar hier ansehen:Einheitlicher Datenschutz als Grundlage für Resilienz on demand now.
Warum der Datenschutz immer schwieriger wird
What’s interesting is that most organizations didn’t intentionally design this complexity into their resilience architecture. They accumulated it over time.
Cloud-Teams führten native Schutzfunktionen ein. Anwendungsverantwortliche implementierten Prozesse, die für die von ihnen unterstützten Plattformen sinnvoll waren. Durch Übernahmen wurden bestehende Technologien und Betriebsmodelle übernommen. Die Geschäftsbereiche optimierten ihre Abläufe entsprechend ihren eigenen Anforderungen. Die meisten dieser Entscheidungen waren vernünftig und in vielen Fällen sogar notwendig. Die Herausforderung besteht darin, dass jede einzelne dieser Entscheidungen mit Kosten verbunden war.
There’s the obvious cost of software, infrastructure, and storage. More significant, though, is the operational cost that accumulates quietly over the years. Every new protection method introduces another policy framework to manage, another workflow to document, another exception to troubleshoot, another recovery process to test, and another set of skills the organization must maintain.
Letztendlich verbringen Teams genauso viel Zeit damit, die mit der Ausfallsicherheit verbundene Komplexität zu bewältigen, wie damit, die Ausfallsicherheit selbst zu verbessern.
Für sich genommen mag das wie ein Effizienzproblem klingen. Mit der Zeit entwickelt es sich jedoch zu einem Problem der Widerstandsfähigkeit. Je mehr bewegliche Teile eine Organisation einführt, desto schwieriger wird es, die Konsistenz aufrechtzuerhalten. Recovery-Verfahren entwickeln sich in den verschiedenen Teams unterschiedlich. Richtlinien weichen voneinander ab. Die Verantwortlichkeiten zerfallen. Das Wissen konzentriert sich auf eine Handvoll Personen, die verstehen, wie alles zusammenpasst.
Letztendlich geht es nicht mehr darum, ob einzelne Workloads geschützt werden können, sondern darum, ob das Unternehmen in der Lage ist, alle von ihm unterstützten Bereiche konsequent zu steuern, zu testen und wiederherzustellen. Die meisten Unternehmen wissen, wie einzelne Systeme wiederhergestellt werden. Weitaus weniger können jedoch mit Sicherheit erklären, wie das Unternehmen als Ganzes wiederhergestellt wird.
AAktuelle Umfrage zur Cyber-Resilienz found that nearly half of organizations identify IT complexity as their biggest cyber resilience challenge. That finding isn’t particularly surprising. Most enterprises aren’t struggling because they lack protection technologies. In many cases, they have more protection technologies than ever before.
Die Herausforderung besteht darin, zu verstehen, wie all diese Technologien zusammenwirken, wenn das Unternehmen sie tatsächlich benötigt.
KI macht diese Realität noch deutlicher sichtbar. Modelle sind auf Trainingsdaten, Pipelines, Infrastruktur, Repositorys, Identitäten und Dienste angewiesen, die sich oft über mehrere Teams und Umgebungen erstrecken. Der Schutz dieser einzelnen Komponenten ist eine Herausforderung. Die Wiederherstellung des Ökosystems, das sie gemeinsam unterstützen, ist eine weitere.
That’s one reason Michael and I spent so much time discussing complexity.
On the surface, unified data protection sounds like a conversation about backup architecture. In reality, our discussion centered on a much broader challenge: how organizations reduce the operational burden created by years of accumulated complexity while creating a more consistent foundation for resilience.
Because the goal isn’t consolidation for consolidation’s sake. It’s all about reducing operational friction. Creating consistency where consistency matters. And making recovery more predictable, repeatable, and trustworthy.
Von fragmentierten Werkzeugen zu einer einheitlichen Grundlage
During the webinar, Michael and I explored four practical ways organizations can begin reducing complexity and strengthening resilience: simplifying control, standardizing protection, building cyber resilience directly into the recovery process, and continuously proving recovery readiness.
While the tactics differ, the objective is the same. The less effort organizations spend stitching together fragmented tools, policies, and workflows, the more confidence they can have in their ability to recover when it matters most.
What stayed with me long after the conversation ended was the recognition that resilience has become as much an operational and architectural challenge as a technical one. Organizations are being asked to support more applications, more clouds, more services, more data, and more AI initiatives than ever before. Yet few have the luxury of expanding teams at the same pace. That reality makes simplicity increasingly valuable.
If I were running backup and recovery operations today and I were re-evaluating my organization’s approach, I wouldn’t start by asking whether we have enough protection tools. I’d start by asking how much complexity we’re carrying and what it’s costing us. Because those costs extend far beyond software licenses and infrastructure. They’re reflected in operational effort, fragmented processes, inconsistent recovery models, and ultimately in an organization’s ability to recover when it matters most.
FAQs
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Warum ist der Datenschutz für Unternehmen komplexer geworden?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Geschäftsprozesse erstrecken sich mittlerweile über SaaS-Anwendungen, Cloud-native Dienste, mehrere Clouds, Edge-Umgebungen, KI-Initiativen und traditionelle Infrastrukturen. Da Teams für diese Umgebungen unterschiedliche Schutzmaßnahmen einsetzen, sammeln sich in Unternehmen Richtlinien, Arbeitsabläufe, Kompetenzen und Abhängigkeiten an, die den operativen Aufwand für die Gewährleistung der Ausfallsicherheit erhöhen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Wie kann sich die Komplexität der Technologie auf die Cyber-Resilienz auswirken?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Eine größere Anzahl von Tools und Prozessen kann es erschweren, unternehmensweit einheitliche Richtlinien, Zuständigkeiten, Test- und Recovery-Verfahren aufrechtzuerhalten. Im Laufe der Zeit kann diese Fragmentierung dazu führen, dass sich eine Herausforderung, die zunächst als Effizienzproblem erscheint, zu einer Herausforderung für die Ausfallsicherheit entwickelt.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was soll mit einem einheitlichen Datenschutz erreicht werden?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Bei einem einheitlichen Datenschutz geht es um mehr als nur die Konsolidierung von Backup-Technologien. Sein übergeordnetes Ziel besteht darin, operative Reibungsverluste zu reduzieren, dort für Konsistenz zu sorgen, wo es darauf ankommt, und die Recovery-Prozesse vorhersehbarer, wiederholbarer und zuverlässiger zu gestalten.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Welche konkreten Maßnahmen können Organisationen ergreifen, um die Komplexität der Resilienz zu verringern?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Unternehmen können sich darauf konzentrieren, die Kontrolle zu vereinfachen, den Schutz zu standardisieren, Cyber-Resilienz direkt in Recovery-Prozesse zu integrieren und die Readiness für Recovery kontinuierlich nachzuweisen. Zusammen können diese Maßnahmen den Aufwand reduzieren, der für die Koordination fragmentierter Tools, Richtlinien und Arbeitsabläufe erforderlich ist.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Warum macht KI die Komplexität der Resilienz sichtbarer?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.KI-Initiativen können auf miteinander vernetzte Trainingsdaten, Pipelines, Infrastruktur, Repositorys, Identitäten und Dienste angewiesen sein, die sich über mehrere Teams und Umgebungen erstrecken. Der Schutz jeder einzelnen Komponente reicht nicht unbedingt aus, um die größere Herausforderung zu bewältigen, nämlich die Wiederherstellung des gesamten Ökosystems, das diese Komponenten unterstützen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was sollten Unternehmen bei der Überprüfung ihrer Datenschutzstrategie berücksichtigen?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Rather than starting with whether they have enough protection tools, organizations should examine how much operational complexity they are carrying and what it costs them. That includes the impact of fragmented processes, inconsistent recovery models, administrative effort, and the organization’s overall ability to recover when it matters most.
Jason Gizaist Senior Manager im Bereich Partner Solutions Marketing bei Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Was ist das Recovery Point Objective (RPO)? Ein umfassender Leitfaden
Recovery point objective (RPO) defines how much data your organization can afford to lose after a disruption – and it shapes every backup, replication, and recovery decision you make.
Recovery point objective (RPO) is the maximum amount of data – measured in time – that your organization can lose after an unplanned disruption and still operate within acceptable limits.
Stellen Sie sich RPO wie eine Uhr für Datenverluste vor: Sie beginnt ab dem Moment, in dem ein Ausfall, ein Cyberangriff oder ein menschlicher Fehler eintritt, rückwärts zu ticken und bleibt bei Ihrem letzten nutzbaren Sicherungs- oder Replikationszeitpunkt stehen. Jede Sekunde zwischen diesen beiden Zeitpunkten entspricht Daten, die Sie möglicherweise nie wieder zurückerhalten.
NISTdefiniert RPO as “the point in time to which data must be recovered after an outage.” That definition is deceptively simple. In practice, setting the right RPO raises important questions about which workloads matter most, how often you back up, and how much you invest in replication infrastructure.
Cyberattacks, cloud outages, and accidental deletions happen on schedules you do not control. Organizations that define clear RPO targets – and enforce them with automated, policy-driven backup – position themselves to recover within business tolerance instead of scrambling after the fact.
This guide walks you through how RPO works, how it differs from recovery time objective (RTO), what are some real-world examples, calculating RPO, and RPO’s critical role in cyber resilience.
So funktioniert RPO bei der Geschäftskontinuitätsplanung
RPO is the “data-loss clock” that shapes your backup frequency. If your RPO for a database is one hour, backups should run at least every 60 minutes. Miss that cadence and you may have already exceeded your tolerance before anything goes wrong.
In a business continuity plan, RPO sits alongside RTO as one of two recovery pillars. While RTO answers “How fast can we get systems running again?” RPO answers “How current will the recovered data be?” Both feed into the broader disaster recovery strategy – and both should be validated through regular testing, not just documented in a binder.
RPO kann auch eine Compliance-Dimension haben:
Vorschriften wie das HIPAA verlangen in der Regel, dass Einrichtungen des Gesundheitswesens wiederherstellbare Kopien elektronischer Patientendaten aufbewahren.
Der SOX enthält Bestimmungen darüber, dass Finanzunterlagen prüfbar und vollständig aufbewahrt werden müssen.
Die DSGVO sieht vor, dass personenbezogene Daten nach einem technischen Zwischenfall zeitnah wiederherstellbar sein sollten.
When an attack encrypts production data, the gap between your last clean backup and the encryption timestamp is the data you lose. That gap is your RPO in action – and it helps determine whether recovery takes hours or becomes a crisis.
The practical takeaway: RPO is not a number you set once and forget. It should reflect current data-change rates, compliance mandates, and threat landscape realities – and it should be enforced through automated backup policies.
RPO vs. den RTO: What’s the Difference?
RPO und den RTO sind zwei Seiten derselben Medaille, wenn es um Recovery geht, messen jedoch unterschiedliche Größen.
RPO looks backward from the moment of failure. It asks: “How much data can we afford to lose?” The answer is expressed in time – minutes, hours, or days – representing the gap between the last good backup and the disruption.
den RTO looks forward from the moment of failure. It asks: “How quickly must systems be back online?” The answer is also expressed in time, but it measures downtime tolerance rather than data-loss tolerance.
Dimension
RPO
den RTO
Focus
Toleranz gegenüber Datenverlusten
Ausfalltoleranz
Maßnahmen
Zeit seit der letzten brauchbaren Sicherung
Zeit, den Betrieb wieder aufzunehmen
Richtung
Rückblickend (vor dem Ausfall)
Zukunftsorientiert (nach einem Misserfolg)
Leitfrage
Wie viele Daten können wir verlieren?
Wie lange können wir noch ausfallen?
Beispiel
1-Stunden-RPO = stündliche Datensicherungen
4-hour den RTO = Systems restored in four hours
Both metrics should be defined together. An organization with a 15-minute RPO but a 24-hour den RTO has recent data that sits idle for a full day. Conversely, a four-hour den RTO paired with a 24-hour RPO means systems come back quickly – but with stale data.
Aligning RPO and den RTO targets before an incident – and validating them through regular disaster recovery testing – can be the difference between a measured response and a scramble.
RPO-Stufen und Beispiele aus der Praxis
Nicht jede Arbeitslast erfordert denselben RPO. Durch eine Abstufung der RPOs nach ihrer geschäftlichen Bedeutung lässt sich der Schutz dort gewährleisten, wo es darauf ankommt, und die Kosten dort im Rahmen halten, wo dies nicht der Fall ist.
Stufe 0: RPO nahe Null (Sekunden bis Minuten): Datenbanken für Finanztransaktionen, elektronische Patientenakten und Echtzeit-Handelsplattformen erfordern in der Regel Continuous Data Protection (CDP) oder synchrone Replikation. Diese Workloads generieren jede Sekunde Umsatz oder sind von regulatorischer Bedeutung, sodass selbst Datenverluste im Minutenbereich schwer zu verkraften sein können. Unternehmen, die ein RPO nahe Null umsetzen, nutzen in der Regel CDP oder synchrone Replikation, um das Datenverlustfenster so gering wie möglich zu halten.
Tier 1: 1–4 Hours: Customer relationship management (CRM) systems, email platforms, and order processing systems often fall here. Frequent incremental backups – every 15 to 60 minutes – help keep data loss within tolerance. The cost is moderate, and the business impact of losing a few hours of email or CRM updates is generally manageable with manual re-entry.
Tier 2: 4–12 Hours: Internal collaboration tools, development environments, and project management platforms commonly operate in this range. Scheduled backups every 4 to 6 hours can strike a balance between protection and storage costs.
Tier 3: 12– 24 Hours: Marketing analytics archives, historical logs, and reference documentation often tolerate daily cloud backups. Data changes slowly and reconstruction is feasible, making daily backup cadences cost-effective.
Durch eine mehrstufige Speicherstruktur können Unternehmen ihre Investitionen gezielt auf den Schutz jener Workloads konzentrieren, bei denen jede Minute Datenverlust die höchsten Kosten verursacht, und gleichzeitig überhöhte Ausgaben für Archive vermeiden, die sich nur einmal pro Woche ändern.
So berechnen Sie den RPO für Ihr Unternehmen
Calculating RPO is a business exercise first and a technical exercise second. These steps can help set RPOs that reflect reality, not aspiration.
Identifizieren Sie kritische Daten.
Erfassen Sie Ihre Workloads und klassifizieren Sie diese nach ihrer geschäftlichen Auswirkung. Fragen Sie sich: Was würde mit dem Umsatz, der Compliance und dem Kundenvertrauen geschehen, wenn bei diesem System Daten verloren gingen? Die Antworten helfen Ihnen dabei, die Zuordnung zu den verschiedenen Tier-Stufen vorzunehmen.
Bewerten Sie die Datenänderungsraten.
Eine Datenbank, die 10.000 Transaktionen pro Stunde verarbeitet, erfordert in der Regel ein engeres RPO als ein Dokumentenarchiv, das zweimal täglich aktualisiert wird. Ermitteln Sie die tatsächlichen Änderungsraten und verlassen Sie sich nicht auf Schätzungen.
Überprüfen Sie die Compliance-Anforderungen.
Ordnen Sie jede Arbeitslast den entsprechenden regulatorischen Verpflichtungen zu. HIPAA, SOX, PCI DSS und DSGVO können jeweils Anforderungen an die Datenaufbewahrung und Wiederherstellbarkeit enthalten, die für den RPO maßgeblich sind.
Budget und Infrastruktur prüfen.
Near-zero RPO typically involves CDP, synchronous replication, or both – and that infrastructure has a cost. Align your RPO targets with what your budget can sustain.
Legen Sie gestaffelte RPOs fest und automatisieren Sie deren Durchsetzung.
Assign each workload to an RPO tier, configure backup policies to match, and automate compliance monitoring. An RPO that exists only in a spreadsheet offers limited protection – enforcement should be continuous and policy-driven.
Reviewing and recalibrating quarterly is good practice. Data volumes grow, workloads shift, and threat landscapes evolve – your RPOs should keep pace.
RPO und Cyber-Resilienz
Ransomware does not care about your backup schedule – but your RPO determines how much leverage attackers have. A tight RPO means less data sits between your last immutable backup and the encryption event, helping reduce the blast radius of an attack.
Cyber-Resilienz hängt nicht allein von der Häufigkeit der Datensicherung ab. Luftisolierte, unveränderliche Sicherungskopien tragen zum Schutz vor Angreifern bei, die Produktionsumgebungen kompromittieren, sodass diese nicht auf Recovery-Daten zugreifen oder diese verändern können. Wenn diese Sicherungskopien außerhalb des primären Cloud-Kontos gespeichert werden, schaffen Sie eine Isolation, die Ransomware einfach nicht überwinden kann.
An dieser Stelle fügt sich Clumio von Commvault in Ihre RPO-Strategie ein. MitClumio, you store backup data in an isolated, fully managed environment outside your primary AWS account. Granular point-in-time recovery helps you restore to a precise moment before the attack – helping minimize data loss to the RPO you defined. Designed to help you maintain control of your recovery without depending on the same infrastructure the attacker compromised.
Unternehmen, die strenge RPOs mit unveränderlichen, isolierten Backups einhalten, können die Zahlung von Lösegeld vermeiden, da sie einwandfreie Daten eigenständig wiederherstellen können.
Die Formel ist einfach: Strengere RPO-Vorgaben in Verbindung mit unveränderlichen, isolierten Backups führen in der Regel zu einer geringeren Angriffsfläche und einer schnelleren, saubereren Recovery-Prozedur. Das ist die Grundlage für Cyber-Resilienz.
Häufig gestellte Fragen
Wofür steht die Abkürzung RPO?
RPO steht für „Recovery Point Objective“. Damit wird der maximal akzeptable Datenverlust – gemessen in Zeit – nach einer ungeplanten Störung wie einem Cyberangriff, einem Hardwareausfall oder einem menschlichen Fehler definiert.
Was ist ein guter RPO?
Ein guter RPO hängt von der Arbeitslast ab. Finanz- und Gesundheitssysteme erfordern oft einen RPO nahe Null, während interne Tools einen RPO von 4 bis 12 Stunden zulassen können. Der richtige RPO schafft einen Ausgleich zwischen geschäftlichen Auswirkungen, Compliance-Anforderungen und Budgetrahmen.
Was ist der Unterschied zwischen RPO und Recovery Time Objective (RTO)?
Der RPO gibt an, wie viele Daten verloren gehen dürfen, ausgedrückt als Zeit seit der letzten Sicherung. Der RTO gibt an, wie lange Systeme offline bleiben dürfen. Der RPO betrachtet den Zeitraum rückblickend ab dem Zeitpunkt eines Ausfalls; der RTO blickt in die Zukunft. Beide müssen gemeinsam in einem Notfallwiederherstellungsplan definiert werden.
Kann der RPO null sein?
Ein RPO von Null bedeutet, dass keinerlei Datenverlust auftritt. Um dies zu erreichen, ist eine synchrone Replikation erforderlich, bei der jeder Schreibvorgang auf einem sekundären System bestätigt wird, bevor er als abgeschlossen gilt. Dies ist technisch möglich, kann jedoch kostspielig sein, weshalb die meisten Unternehmen diese Methode ihren kritischsten Workloads vorbehalten.
Wie wirkt sich die RPO auf die Häufigkeit der Datensicherung aus?
Das RPO bestimmt direkt die Häufigkeit der Datensicherung. Ein RPO von einer Stunde erfordert Datensicherungen mindestens alle 60 Minuten. Ein RPO von 24 Stunden erlaubt tägliche Datensicherungen. Je kürzer das RPO ist, desto häufiger muss die Datensicherung oder Replikation erfolgen.
Welche Faktoren bestimmen den RPO?
Zu den entscheidenden Faktoren zählen die geschäftskritische Bedeutung der Daten, die allgemeine Änderungshäufigkeit der Daten, geltende regulatorische und Compliance-Anforderungen, das für die Backup-Infrastruktur verfügbare Budget sowie die allgemeine Risikotoleranz des Unternehmens. Die meisten Unternehmen stufen ihre RPOs auf der Grundlage dieser Faktoren ein.
Geschäftskontinuitätsplanung für die Cloud
Ein moderner Plan zur Geschäftskontinuität beginnt mit dem Schutz Ihrer Cloud-Daten. Erfahren Sie mehr über die wichtigsten Komponenten, Vorteile und bewährten Verfahren für eine cloudnative Geschäftskontinuität.
Die Komplexität der Cloud vervielfacht die Herausforderung. Die meisten Unternehmen nutzen mittlerweile mehrere Cloud-Anbieter, von denen jeder unterschiedliche Sicherheitsmodelle, Backup-Mechanismen undgemeinsame Verantwortung boundaries. Data sprawl across Amazon S3 buckets, DynamoDB tables, and data lakehouse environments creates blind spots. The gemeinsame Verantwortung model means your cloud provider secures the infrastructure, but you own the protection and recoverability of your data.
Die geschäftlichen Auswirkungen einer ungeplanten Störung gehen weit über den Ausfall selbst hinaus. Die Umsatzverluste steigen von Minute zu Minute. Das einmal erschütterte Vertrauen der Kunden lässt sich erst nach Monaten oder Jahren wieder aufbauen. Bußgelder aufgrund von Vorschriften wie der DSGVO, HIPAA und SOX können sich auf Millionen belaufen. Und der Reputationsschaden hält oft länger an als der Vorfall selbst.
A well-structured business continuity plan transforms your organization from reactive to resilient. It defines exactly how you will protect critical data, recover operations, and communicate with stakeholders when disruption strikes. Without one, recovery becomes improvisation — and improvisation under pressure rarely ends well.
Ein solider Plan zur Aufrechterhaltung des Cloud-Betriebs basiert auf miteinander verknüpften Komponenten, die vor, während und nach einem Vorfall zusammenwirken.
Analyse der Auswirkungen auf das Geschäft und Risikobewertung
Start with a business impact analysis (BIA) to identify your most critical workloads and quantify the cost of downtime for each. Pair this with a risk assessment that maps threats — ransomware, cloud provider outages, insider errors, compliance failures — to specific data assets. This analysis drives every decision that follows.
RTO-/RPO-Ziele pro Workload
Nicht alle Daten sind gleichwertig. Legen Sie Recovery-Zeitziele (RTO) fest undWiederherstellungspunkt-Ziele (RPO)für jede Arbeitslast entsprechend ihrer geschäftlichen Kritikalität. Eine kundenorientierte Datenbank erfordert möglicherweise ein RPO im Minutenbereich, während archivierte Protokolle auch Stunden als RPO tolerieren können. Mehrstufige Zielvorgaben verhindern, dass zu viel Geld für Ressourcen mit niedriger Priorität ausgegeben und zu wenig in solche mit hoher Priorität investiert wird.
Strategie für Cloud-Backups
Ihre Backup-Strategie muss automatisiert und richtliniengesteuert sein. Manuelle Prozesse bergen das Risiko menschlicher Fehler und lassen sich nicht skalieren. Definieren Sie Richtlinien, die Änderungen kontinuierlich erfassen, Backups in isolierten Umgebungen speichern und eine granulare Recovery-Fähigkeit auf Objekt-, Präfix-, Bucket-, Tabellen- oder Partitionsebene ermöglichen. Entdecken Sie IhreOptionen für Cloud-Backupsbevor man sich auf einen einzigen Ansatz festlegt.
Kommunikations- und Eskalationsprotokolle
Halten Sie fest, wer bei einem Vorfall für welche Aufgaben verantwortlich ist. Legen Sie Eskalationswege, Benachrichtigungsfristen und Kommunikationskanäle für interne Teams, Führungskräfte, Kunden und Aufsichtsbehörden fest. Ein Recovery-Plan, den niemand umsetzen kann, ist überhaupt kein Plan.
Prüfung und Wartung
Der gefährlichste Geschäftskontinuitätsplan ist der, der noch nie getestet wurde. Planen Sie mindestens vierteljährlich Recovery-Übungen ein, um sicherzustellen, dass Ihre RTO-/RPO-Ziele erreichbar sind und Ihr Team die Vorgehensweise beherrscht.
Vorteile der Cloud-Native-Technologie
Die Umstellung Ihrer Geschäftskontinuitätsstrategie auf Cloud-native Lösungen bietet messbare Vorteile gegenüber herkömmlichen On-Premises-Ansätzen.
Skalierbarkeit ohne zusätzlichen Infrastrukturaufwand. Cloud-native Backups skalieren automatisch mit Ihrem Datenwachstum. Sie müssen keine zusätzlichen Server, Speicher-Arrays oder Backup-Appliances bereitstellen. Wenn Ihre S3-Buckets und Datenbanken wachsen, wächst auch Ihr Schutz entsprechend mit.
Kosteneffizienz. Ein serverloser, SaaS-basierter Ansatz macht Investitionen in spezielle Backup-Hardware überflüssig. Sie zahlen nur für die tatsächlich genutzten Schutzmaßnahmen, und die Betriebskosten bleiben auch bei steigendem Datenvolumen überschaubar.
Erhöhte Sicherheit durch Isolation. Luftisolierte, unveränderliche Backups, die außerhalb Ihres primären Cloud-Kontos gespeichert werden, bilden eine entscheidende Verteidigungsschicht. Sollte Ihre Produktionsumgebung durch Ransomware kompromittiert werden, bleiben Ihre Backup-Daten in einem isolierten Tresor unberührt. Diese Trennung macht den Unterschied zwischen der Zahlung eines Lösegelds und der Wiederherstellung Ihrer Daten zu Ihren Bedingungen aus.
Rapid, granular recovery. Cloud-native solutions enable targeted recovery — restoring specific objects, prefixes, buckets, tables, or partitions rather than entire environments. This precision reduces recovery time dramatically and minimizes disruption to unaffected workloads.
Multi-Cloud-Ausfallsicherheit. Unternehmen nutzen zunehmend AWS, Azure und Google Cloud. Cloud-native Backup-Lösungen unterstützen die regionen- und kontoübergreifende Recovery und bieten Ihnen so die Flexibilität, Daten dort wiederherzustellen, wo Sie sie benötigen.
Der Markt für Cloud-Datensicherheit wächst weiter, da Unternehmen diese Vorteile erkennen. Angesichts zunehmender Cloud-Workloads und immer größerer Bedrohungen werden branchenübergreifend verstärkt Investitionen in eine widerstandsfähige Infrastruktur getätigt.Weitere Informationen dazu, wieClumio’sUnterstützung für Cloud-native Sicherheitslösungender Recovery-Wiederherstellung nach Ransomware-Angriffen,Erkunden Sieunsereigene Lösungsseite.
Bewährte Verfahren zur Gewährleistung der Kontinuität
Effective business continuity planning is not a one-time project — it is an ongoing discipline. These practices help you build and maintain a plan that holds up under real-world pressure.
Führen Sie regelmäßig Risikobewertungen durch.
Die Bedrohungslage ändert sich ständig. Überprüfen Sie Ihr Risikoprofil mindestens vierteljährlich und aktualisieren Sie Ihre BIA, sobald Sie neue Cloud-Workloads hinzufügen, den Anbieter wechseln oder in neue Rechtsräume eintreten.
Legen Sie Ihre RTO-/RPO-Ziele fest und testen Sie diese.
Das Festlegen von Zielen auf Papier ist der erste Schritt. Durch die Überprüfung dieser Ziele in praktischen Recovery-Übungen wird die Readiness aufgebaut. Prüfen Sie die Recoverys anhand Ihrer festgelegten Ziele und dokumentieren Sie etwaige Lücken. Passen Sie diese Ziele an, wenn sich die geschäftlichen Anforderungen ändern.
Führen Sie eine Multi-Cloud-Backup-Strategie ein.
Do not rely on a single provider’s native tools for backup and recovery. Cross-account and cross-region backup capabilities protect you against account-level compromise and regional outages alike.
Sicherungsrichtlinien automatisieren.
Manuelle Sicherungsprozesse sind anfällig. Führen Sie eine richtliniengesteuerte Automatisierung ein, die Datenänderungen kontinuierlich erfasst, ohne sich auf geplante Snapshots zu verlassen, bei denen kritische Aktualisierungen zwischen den Intervallen übersehen werden können.
Integrieren Sie Sicherheitsmaßnahmen in Ihre Backup-Strategie.
Air-gapped storage, immutable backups, role-based access controls, and threat scanning should be standard features of your backup solution — not afterthoughts. Your backup data is a high-value target; protect it accordingly.
Führen Sie mindestens vierteljährlich einen Test durch.
Recovery drills should simulate realistic scenarios, including ransomware events and accidental bulk deletions. Testing reveals where your plan falls short before an actual incident occurs.
Support für Cloud-Backups
A modern business continuity plan requires purpose-built cloud backup — not legacy tools adapted for cloud environments. Traditional backup solutions were designed for on-premises infrastructure and struggle with the scale, speed, and architecture of cloud-native workloads.
Clumio von Commvaultwurde von Grund auf für Cloud-Umgebungen entwickelt. Als serverlose, SaaS-basierte Plattform, die speziell für AWS und Google Cloud konzipiert wurde, bietet Clumio die für die Geschäftskontinuität erforderlichen Recovery-Funktionen, ohne dass eine vom Kunden verwaltete Infrastruktur erforderlich ist oder der Betriebsaufwand steigt.
Air-Gapped-Backups. Clumio speichert Backup-Daten in einer unveränderlichen, isolierten Umgebung, die vollständig von Ihrem Produktions-Cloud-Konto getrennt ist. Diese Air-Gapped-Architektur bedeutet, dass Ihre Backup-Daten auch dann geschützt und wiederherstellbar bleiben, wenn Ihre primäre Umgebung von Ransomware oder einer Kontokompromittierung betroffen ist.
Granular recovery at scale. Rather than forcing full-environment restores, Clumio enables targeted recovery at the object, prefix, bucket, partition,odertable level. When a bad code push corrupts specific data, you recover exactly what was affected — nothing more, nothing less.
Wiederherstellung über mehrere Regionen und Konten hinweg. Clumio unterstützt flexible Recovery-Wege, einschließlich der Recovery von Daten in verschiedenen Regionen oder Konten. Diese Funktion ist entscheidend für Katastrophenszenarien, in denen eine gesamte Region oder ein gesamtes Konto kompromittiert ist.
Clumio Backtrack für die Wiederherstellung eines bestimmten Zeitpunkts. Clumio Backtrack ermöglicht die Wiederherstellung vor Ort vonAmazon S3oderDynamoDB data to a precise point in time. This is invaluable to help recover data corruptionoderaccidental deletion without the delay of traditional restore workflows.
The speed of recovery matters. Purpose-built cloud backup compresses that timeline from weeks to hours —oderminutes — transforming business continuity from aspiration into operational reality.
Häufig gestellte Fragen
Was ist ein Geschäftskontinuitätsplan?
Ein Business-Continuity-Plan ist eine dokumentierte Strategie, die darlegt, wie eine Organisation während und nach einer Störung ihre kritischen Abläufe aufrechterhält. Er umfasst alles von Datenschutz- und Recovery-Verfahren bis hin zu Kommunikationsprotokollen und Eskalationswegen. In „Cloud-First“-Organisationen konzentriert sich der Plan auf den Schutz von Cloud-Workloads, die Festlegung von RTO-/RPO-Zielen und die Überprüfung der Recovery durch regelmäßige Tests.
Was ist der Unterschied zwischen BCP und DRP?
Die Geschäftskontinuitätsplanung (BCP) ist ein umfassendes Fachgebiet, dessen Schwerpunkt darauf liegt, alle kritischen Geschäftsfunktionen während einer Störung aufrechtzuerhalten. Die Notfall-Recovery-Planung (DRP) ist ein Teilbereich der BCP, der sich speziell auf die Wiederherstellung von IT-Systemen, Anwendungen und Daten nach einem Vorfall konzentriert. Eine solide BCP umfasst eine DRP, befasst sich aber auch mit Kommunikation, Personal und betrieblichen Abläufen über den IT-Bereich hinaus.
Was sind die wichtigsten Bestandteile eines Cloud-BC-Plans?
Ein Cloud-Business-Continuity-Plan umfasst eine Analyse der geschäftlichen Auswirkungen, festgelegte RTO-/RPO-Ziele für jede Workload, eine automatisierte Cloud-Backup-Strategie, Kommunikations- und Eskalationsprotokolle sowie regelmäßige Tests. Jede Komponente muss den besonderen Merkmalen von Cloud-Umgebungen Rechnung tragen, darunter Modelle der geteilten Verantwortung, Multi-Cloud-Architekturen und Datenwachstum.
Warum ist cloud-natives Backup wichtig?
Cloud-native Backups sind speziell auf den Umfang und die Architektur von Cloud-Workloads zugeschnitten. Im Gegensatz zu älteren Tools, die lediglich an die Cloud angepasst wurden, bieten cloud-native Lösungen automatisierten, richtliniengesteuerten Schutz, Air-Gapped-Speicher, granulare Wiederherstellung und serverlosen Betrieb. Diese Funktionen tragen direkt zu schnelleren Recovery-Zeiten und einer besseren Geschäftskontinuität bei.
Wie oft sollten Sie Ihren Plan überprüfen?
Testen Sie Ihren Geschäftskontinuitätsplan mindestens einmal pro Quartal. Bei jedem Test sollten realistische Störungsszenarien simuliert werden – darunter Ransomware, versehentliche Löschungen und Ausfälle von Cloud-Anbietern –, um zu überprüfen, ob Ihre festgelegten RTO-/RPO-Ziele erreichbar sind. Dokumentieren Sie die Ergebnisse, ermitteln Sie Lücken und passen Sie den Plan entsprechend an.
Was ist ein „Air-Gapped“-Backup?
Ein „Air-Gapped“-Backup wird in einer isolierten Umgebung gespeichert, auf die vom Produktionsnetzwerk oder vom Cloud-Konto aus kein direkter Zugriff möglich ist. Diese Isolierung schützt die Backup-Daten vor Ransomware, Insider-Bedrohungen und Kompromittierungen auf Kontoebene. „Air-Gapped“-Backups sind ein wesentlicher Bestandteil einer widerstandsfähigen Strategie zur Geschäftskontinuität, da sie eine saubere, wiederherstellbare Kopie der Daten bereitstellen, selbst wenn die Produktionssysteme vollständig kompromittiert sind.
SOC 2-Compliance-Anforderungen: Was sie sind und welche Rolle der Datenschutz dabei spielt
Die SOC-2-Compliance-Anforderungen legen fest, wie Dienstleistungsunternehmen nachweisen, dass sie die Daten ihrer Kunden schützenDaten undtreffeningDas hängt von mehr ab als nur von Firewalls und Zugriffskontrollen.
SOC 2 is a voluntary auditing framework created by the AICPA that evaluates how service organizations manage customer data. Unlike regulatory mandates such as HIPAA or PCI DSS, SOC 2 is not a law. It is an audit report issued by an independent CPA firm that assesses your organization’s controls against the AICPA’s Kriterien für Treuhanddienstleistungen.
Der Rahmen gilt für alle Technologieunternehmen und Dienstleistungsunternehmen, die Kundendaten speichern, verarbeiten oder übertragen. In der Praxis sind damit vor allem SaaS-Anbieter, Cloud-Hosting-Unternehmen, Datenanalysefirmen und Managed-Service-Provider gemeint. Der Kreis der betroffenen Unternehmen hat sich jedoch erheblich erweitert.
Beschaffungsabteilungen in Unternehmen fordern mittlerweile bei der Bewertung von Anbietern routinemäßig SOC-2-Berichte an, wodurch das Audit de facto zu einer Voraussetzung für die Zusammenarbeit mit großen Organisationen geworden ist. Was SOC 2 auszeichnet, ist seine Flexibilität. Man kreuzt keine Punkte auf einer festgelegten Compliance-Liste an.
Instead, you define the scope of your audit by selecting which of the five Kriterien für Treuhanddienstleistungen apply to your services. Your auditor then evaluates whether your controls meet those criteria effectively.
SOC 2 compliance requirements push you toward exactly that kind of structured, documented approach to security and data protection, one that can lower both risk and cost. The AICPA’s Kriterien für Treuhanddienstleistungen framework provides the structure, and the audit report gives your customers the evidence they need.
Kriterien für Treuhanddienstleistungen
The five Kriterien für Treuhanddienstleistungen form the backbone of every SOC 2 audit. Each criterion addresses a specific dimension of how you protect and manage data. Security is the only mandatory criterion, but most organizations include at least one or two additional criteria based on their services and customer expectations.
Security (Common Criteria) – Security is the foundation of every SOC 2 report. The Common Criteria covers logical and physical access controls, system operations monitoring, change management, and risk mitigation.
Kontrollmaßnahmen wie CC6.4 (Einschränkung des physischen und logischen Zugriffs auf Informationsressourcen) und CC6.7 (Einschränkung der Übertragung, Bewegung und Entnahme von Informationen) sind von zentraler Bedeutung, um nachzuweisen, dass Sie Systeme vor unbefugtem Zugriff und Bedrohungen schützen. Jedes SOC-2-Audit umfasst den Bereich „Sicherheit“, unabhängig davon, welche weiteren Kriterien Sie auswählen.
Availability – Availability addresses whether your systems are operational and accessible as committed in your service-level agreements. This is where data protection becomes critical. Control A1.2 requires you to maintain backup processes and recovery infrastructure. Control A1.3 requires you to test your recovery plan, not just document one.
Die Prüfer möchten sich davon überzeugen, dass Sie Systeme und Daten innerhalb der festgelegten Recovery-Zeitziele und Recovery-Punktziele wiederherstellen können.Clumio’s operational recovery capabilitiessind speziell für diesen Zweck konzipiert: richtliniengesteuerte Datensicherung mit automatisierter Zeitplanung und Air-Gap-Speicher, der sowohl die Anforderungen von A1.2 als auch von A1.3 erfüllt.
Confidentiality – Confidentiality criteria (C1.1 and C1.2) focus on protecting information designated as confidential. This includes encryption of data at rest and in transit, retention policies that define how long confidential data is kept, and secure destruction processes when retention periods expire.
Processing integrity – Processing integrity evaluates whether your systems process data completely, accurately, and in a timely manner. This criterion is most relevant for organizations whose core service involves data transformation, calculation, or transaction processing.
Privacy – Privacy addresses how you collect, use, retain, disclose, and dispose of personal information. It overlaps significantly with GDPR and CCPA requirements, making it a common addition for organizations that handle PII across jurisdictions.
SOC 2-Typen
SOC-2-Prüfungen gibt es in zwei Formen, und diese Unterscheidung ist von Bedeutung. Ein SOC-2-Typ-1-Bericht bewertet, ob Ihre Kontrollmaßnahmen zu einem bestimmten Zeitpunkt ordnungsgemäß konzipiert sind. Stellen Sie sich dies wie eine Momentaufnahme vor: Der Prüfer bestätigt, dass Ihre Richtlinien und Kontrollmaßnahmen zum Zeitpunkt der Prüfung vorhanden und angemessen strukturiert sind.
Ein SOC-2-Bericht vom Typ 2 geht noch einen Schritt weiter. Er bewertet, ob diese Kontrollmaßnahmen über einen festgelegten Zeitraum – in der Regel sechs bis zwölf Monate – tatsächlich wirksam funktionieren. Die Prüfer überprüfen Nachweise für eine konsequente Umsetzung, darunter Protokolle, Änderungsaufzeichnungen, Berichte zur Überprüfung von Sicherungskopien und Unterlagen zur Reaktion auf Vorfälle.
Typ 2 ist der Standard, den Unternehmenskunden erwarten. Ein Bericht vom Typ 1 kann als Zwischenschritt dienen, während Sie Ihre Prüfungshistorie aufbauen, doch die meisten Beschaffungsteams verlangen vor Vertragsunterzeichnung einen SOC-2-Bericht vom Typ 2.
Gerade der lange Beobachtungszeitraum verleiht dem Bericht seine Glaubwürdigkeit: Er belegt, dass Ihre Kontrollmaßnahmen in der Praxis funktionieren und nicht nur auf dem Papier.
Steuerungszuordnung
Der Datenschutz spielt bei einem SOC-2-Audit keine untergeordnete Rolle. Er steht in direktem Zusammenhang mit zahlreichen Kontrollmaßnahmen, die sich auf die Kriterien „Sicherheit“ und „Verfügbarkeit“ beziehen. Dennoch übersehen viele Unternehmen bei der Vorbereitung auf ihr Audit die Bereiche Backup and Recovery und konzentrieren sich stattdessen auf Zugriffskontrollen und Netzwerksicherheit.
Im Folgenden wird dargelegt, inwiefern bestimmte SOC-2-Kontrollen mit den Datenschutzfunktionen im Einklang stehen:
CC6.4
Zugriff auf Informationsressourcen einschränken
Clumio speichert Backups in einer isolierten, „Air-Gapped“-Umgebung mit dedizierter Verschlüsselung, getrennt von Ihrem primären Cloud-Konto. Diese administrative Isolierung trägt dazu bei, die Kontrollanforderung zur Beschränkung des logischen Zugriffs auf geschützte Informationen zu erfüllen.
CC7.5
Sicherheitsvorfälle erkennen und darauf reagieren
Clumio ermöglicht eine konto- und regionenübergreifende Recovery und unterstützt so Tests zur Reaktion auf Vorfälle sowie eine schnelle Recovery, wenn Produktionsumgebungen kompromittiert werden.
CC9.1
Risiken erkennen und steuern
Policy-driven backup with automated scheduling helps eliminate manual processes and custom scripts, which also helps reduce operational risk. Clumio’s serverless architecture scales automatically without infrastructure overhead.
A1.2
Wartung der Infrastruktur für Backup and Recovery
Clumio’s policy-based asset selection and offsite, air-gapped storage help deliver the backup processes and recovery infrastructure that auditors evaluate.
A1.3
Recovery-Pläne testen
Clumio unterstützt Recovery-Tests sowohl über die Verwaltungskonsole als auch über die API und ermöglicht es Ihnen so, Ihrem Prüfer dokumentierte, wiederholbare Recovery-Tests nachzuweisen.
Checkliste zur Einhaltung von Vorschriften
Ein strukturierter Ansatz zur Erfüllung der SOC-2-Anforderungen trägt dazu bei, dass Ihr Audit planmäßig verläuft und das Risiko von Lücken verringert wird. Befolgen Sie diese Schritte:
Legen Sie Ihren Anwendungsbereich fest und wählen Sie die Kriterien für Vertrauensdienste aus.
Legen Sie anhand Ihrer Dienstleistungen und Ihrer Verpflichtungen gegenüber den Kunden fest, welche Kriterien gelten. Sicherheit ist zwingend erforderlich; fügen Sie je nach Bedarf Verfügbarkeit, Vertraulichkeit, Verarbeitungsintegrität oder Datenschutz hinzu.
Führen Sie eine Readiness-Prüfung durch.
Ermitteln Sie, in welchen Bereichen Ihre derzeitigen Kontrollmaßnahmen die Kriterien erfüllen und wo Lücken bestehen. Das ist Ihr Fahrplan.
Kontrollmaßnahmen einführen und Richtlinien dokumentieren.
Richten Sie die für jedes Kriterium erforderlichen technischen und administrativen Kontrollmaßnahmen ein. Dokumentieren Sie alles: Richtlinien, Verfahren, Konfigurationen und Zuständigkeiten.
Führen Sie interne Tests durch, einschließlich der Überprüfung von Backup and Recovery.
Stellen Sie sicher, dass Ihre Kontrollmechanismen wie vorgesehen funktionieren. Im Hinblick auf die Verfügbarkeit bedeutet dies, die Integrität der Backups, die Wiederherstellungsverfahren und die Failover-Prozesse zu testen.
Beziehen Sie Ihren Wirtschaftsprüfer mit ein.
Wählen Sie eine unabhängige Wirtschaftsprüfungsgesellschaft mit Erfahrung im Bereich SOC 2. Der Wirtschaftsprüfer legt den Beobachtungszeitraum für einen Typ-2-Bericht fest und definiert die Anforderungen an die Nachweise.
Beheben Sie die Lücken und fordern Sie Ihren Bericht an.
Beheben Sie alle im Rahmen des Audits festgestellten Mängel und erhalten Sie Ihren abschließenden SOC-2-Bericht. Wenn Sie mit einer übersichtlichen Checkliste beginnen, können Sie den Übergang von der Vorbereitung zum Audit mit weniger Überraschungen bewältigen.
Häufig gestellte Fragen
Was sind die 5 SOC-2-Kriterien?
Die fünf SOC-2-Trust-Services-Kriterien sind Sicherheit, Verfügbarkeit, Vertraulichkeit, Verarbeitungsintegrität und Datenschutz. Das Kriterium „Sicherheit“, auch als „Common Criteria“ bekannt, ist für jedes SOC-2-Audit obligatorisch. Ihr Unternehmen wählt zusätzliche Kriterien auf der Grundlage der von Ihnen angebotenen Dienstleistungen und Ihrer vertraglichen Verpflichtungen gegenüber Kunden aus.
Was ist der Unterschied zwischen SOC 2 Typ 1 und Typ 2?
Ein SOC-2-Bericht vom Typ 1 bewertet, ob Ihre Kontrollmaßnahmen zu einem bestimmten Zeitpunkt ordnungsgemäß konzipiert sind. Ein SOC-2-Bericht vom Typ 2 bewertet, ob diese Kontrollmaßnahmen über einen Zeitraum von sechs bis zwölf Monaten wirksam funktionieren. Der Typ-2-Bericht ist strenger und entspricht dem Standard, den die meisten Unternehmenskunden verlangen.
Wie lange dauert die SOC-2-Konformität?
Bei einem Erstaudit sollten Sie damit rechnen, dass der gesamte Prozess sechs bis zwölf Monate dauert. Darin enthalten sind die Readiness-Prüfung, die Umsetzung der Kontrollmaßnahmen, die Beobachtungsphase und das Audit selbst.
Wie oft ist die Einhaltung der SOC-2-Vorgaben erforderlich?
Ein SOC-2-Typ-2-Bericht bezieht sich auf einen bestimmten Beobachtungszeitraum, in der Regel 12 Monate. Die meisten Organisationen lassen den Bericht jährlich erneuern, um eine lückenlose Prüfungshistorie zu gewährleisten und die laufenden Anforderungen von Kunden und Beschaffungsstellen zu erfüllen.
Ist die Einhaltung der SOC-2-Vorgaben verpflichtend?
SOC 2 ist ein freiwilliges Rahmenwerk und keine gesetzliche Vorschrift. Allerdings verlangen Unternehmenskunden, Partner und Beschaffungsteams zunehmend einen aktuellen SOC-2-Typ-2-Bericht, bevor sie Verträge unterzeichnen. In der Praxis ist dies mittlerweile eine grundlegende Erwartung an jedes Dienstleistungsunternehmen, das Kundendaten verarbeitet.
Die wichtigsten Erkenntnisse
ResOps is not a technology product. It’s a cross-functional operating discipline that helps drive organizational cyber resilience.
Es ergänzt die Bereiche Datensicherung, Notfallwiederherstellung, Cybersicherheit, Geschäftskontinuität und Vorfallbewältigung, indem es diese Funktionen auf die Ergebnisse der durchgängigen Recovery ausrichtet.
ResOps konzentriert sich auf kritische Dienste und vom Unternehmen festgelegte Ausfalltoleranzen und nicht auf einzelne Infrastrukturkomponenten.
Es stützt sich auf die kontinuierliche Erhebung von Nachweisen, darunter geprüfte Ergebnisse der Recovery-Prozesse, Indikatoren für die Ausfallsicherheit der Dienste und eine eigene Liste offener Lücken.
ResOps ist ein fortlaufender Prozess. Weder die Erstellung eines Plans noch die Durchführung einer erfolgreichen einmaligen Übung reichen aus, um eine dauerhafte Recovery-Fähigkeit zu gewährleisten.
Die neue Herausforderung der Resilienz
Die meisten Unternehmen investieren in Cybersicherheit, Datensicherung,Disaster-Recovery-Mechanismen,, and Geschäftskontinuität. Yet many executives still face three critical questions: Can we recover? How long will recovery take? And can we prove it?
Part of the challenge is that responsibility for resilience is spread across teams that often operate in silos. Security manages threats. IT maintains systems. Backup and Disaster-Recovery-Mechanismen, teams restore data and infrastructure. Business continuity teams focus on keeping the organization running. Each plays an important role, but responsibility for recovery can remain fragmented.
ResOps brings these functions together around shared priorities, recovery goals, and evidence. The result is a more practical way to approach resilience: know what matters most, understand what it takes to recover it, test whether recovery works, and act on the gaps you find.
F: Was ist ResOps?
ResOpsist die betriebliche Disziplin, die Sicherheit, Infrastruktur und IT-Betrieb miteinander verbindet,Geschäftskontinuität, und bringt Geschäftsverantwortliche in den Bereichen kritische Dienste, ausfallsichere Konzeption und kontinuierliche Validierung zusammen. Einfach ausgedrückt: ResOps hilft Teams dabei, sich auf Störungen vorzubereiten, kritische Dienste innerhalb der vom Unternehmen festgelegten Ausfalltoleranzen wiederherzustellen und anhand von Belegen nachzuweisen, dass Recovery funktioniert.
Vier Merkmale definieren ResOps. Es ist:
Von Grund auf funktionsübergreifend konzipiert. ResOps verbindet verteilte Zuständigkeiten durch ein gemeinsames Betriebsmodell, benannte Verantwortlichkeiten und eine Führungssteuerung.
Fokus auf kritische Dienste. Dabei werden jene Dienste priorisiert, die das Unternehmen wiederherstellen muss, um seinen Kernwert zu liefern, Kunden zu bedienen und Einnahmen zu generieren; außerdem sollen damit dringende rechtliche, behördliche, sicherheitsrelevante und auftragsbezogene Verpflichtungen erfüllt werden.
Continuously validated. Resilience is a posture that teams must exercise and improve – not a state established by an annual test.
Anhand von Belegen gemessen. ResOps ermittelt einen Resilience Posture Score (RPS): einen dienstbezogenen, beleggestützten Wert, der misst, wie gut sich ein einzelner kritischer Dienst wiederherstellen lässt – basierend auf Validierungsergebnissen, dem Zustand der Abhängigkeiten und der Zuversicht hinsichtlich einer einwandfreien Recovery.
What Isn’t ResOps?
It’s not a product category.
Keine Plattform kann ResOps im Alleingang schaffen. Technologien für Datenschutz, Cyber-Recovery, Automatisierung, Observability und Tests können diesen Bereich zwar unterstützen, doch ResOps ist eine organisatorische Angelegenheit. Es hängt von Governance, gemeinsamer Verantwortung, geschäftlichen Prioritäten, betrieblichen Praktiken und einem gemeinsamen Standard für Nachweise ab.
It’s not a replacement for backup and recovery or Disaster-Recovery-Mechanismen,.
ResOps does not replace strong backup and Disaster-Recovery-Mechanismen, capabilities: it depends on them. Backup establishes whether recoverable copies exist. Disaster recovery provides the procedures and technical capabilities to help restore systems and infrastructure.
But then ResOps asks a broader question: Can the critical service return completely, cleanly, and within tolerance, including its identities, applications, data, infrastructure, cloud services, third parties, people, and decision paths?
It’s not another name for Geschäftskontinuität or incident response.
Geschäftskontinuität legt fest, wie das Unternehmen bei Störungen weiterarbeitet. Die Vorfallreaktion dient der Erkennung, Eindämmung und Bewältigung des Vorfalls. ResOps verbindet diese Disziplinen mit dem Ergebnis der Recovery. Es schafft einen Arbeitsrhythmus, in dem sich die Teams darauf einigen, was wichtig ist, die Recovery unter realistischen Bedingungen überprüfen, Ergebnisse messen und die bei Tests aufgedeckten Lücken beheben.
It’s not a compliance exercise or one-time project.
A mature ResOps program can help generate evidence for boards, regulators, insurers, customers, and auditors. But documentation is a byproduct, not the objective. The objective is demonstrated recoverability.
And because systems, dependencies, threats, and business priorities keep changing, ResOps is never “finished.” It operates continuously, much like financial planning or security operations.
Was ändert sich mit ResOps?
Bei ResOps liegt der Fokus nicht mehr darauf, ob einzelne Systeme und Prozesse funktionieren, sondern darauf, ob sich der kritische Dienst als Ganzes wiederherstellen lässt. Das verändert die Fragen, die Führungskräfte stellen können.
Ein erfolgreiches Backup ist wichtig. Ebenso wie ein Recovery-Plan. Aber keines von beiden gibt Aufschluss darüber, ob ein kritischer Dienst tatsächlich wiederhergestellt werden kann, wenn man ihn braucht. ResOps betrachtet das Gesamtbild:
Wurde die Recovery von einem verifizierten, fehlerfreien Recovery-Punkt aus durchgeführt?
Wie lange hat es gedauert?
Haben wir uns innerhalb der vom Unternehmen festgelegten Grenzen erholt?
Und was muss noch beachtet werden?
That’s why ResOps matters. It gives organizations a way to move beyond assumptions of resilience to programmatic, reliable demonstrations of their ability to recover. And they do it with continuous production of evidence and traceability. So when disruption happens, the question isn’t whether every team did its part or who failed at which task. It’s whether the business can restore the critical services its customers depend on.
Mehr erfahren
Commvault hat veröffentlichtResOps: Ein Leitfaden für Führungskräfte to give CISOs, CIOs, IT, security, resilience, and risk leaders a practical framework for implementing ResOps in their organizations.
Leaders will learn how to identify the services that matter most, validate recovery readiness with real evidence, and continuously test resilience. As a result, organizations can establish a single operating model that unites security, infrastructure, IT operations, and business leaders around evidence-based recoverability.
Q: Is ResOps simply a new name for Disaster-Recovery-Mechanismen,?
A: No. Disaster recovery is an essential part of ResOps, but ResOps looks at the entire critical service – including technical, third-party, human, and decision dependencies – and whether it can recover within a business-defined impact tolerance.
F: Ist für ResOps die Anschaffung einer neuen Plattform erforderlich?
A: Nein. Technologie kann zwar die Bestandsaufnahme, das Testen, die Recovery und die Beweissicherung unterstützen, doch bei ResOps stehen zunächst die Zuständigkeiten, die Governance, die geschäftlichen Prioritäten und die betrieblichen Abläufe im Vordergrund.
F: Wem gehört ResOps?
A: ResOps needs a named leader with cross-functional authority and executive sponsorship. Individual service owners remain accountable for their services, while security, IT, Geschäftskontinuität, and business teams contribute to the shared recovery outcome.
F: Wie wird der Erfolg von ResOps gemessen?
A: Success comes from current evidence that critical services can recover cleanly within their defined impact tolerances – not simply from completing a plan or running a successful backup job.
Ein Resilience Posture Score (RPS) ist ebenfalls ein nützliches Messinstrument. Als dienstbezogener, evidenzgestützter Wert hilft der RPS dabei, auf der Grundlage von Validierungsergebnissen, dem Zustand der Abhängigkeiten und der Zuversicht hinsichtlich einer reibungslosen Recovery aufzuzeigen, wie gut sich ein einzelner kritischer Dienst wiederherstellen lässt.
F: Wie können Unternehmen mit ResOps beginnen?
A: Ermitteln Sie zunächst, auf welche kritischen Dienste das Unternehmen angewiesen ist, wer für diese Dienste verantwortlich ist, wovon sie abhängen und wie schnell sie wiederhergestellt werden müssen. Auf dieser Grundlage können die Teams die Recovery überprüfen, Lücken identifizieren und die Maßnahmen zur Stärkung der Ausfallsicherheit priorisieren.
Michael Thelander is Senior Director of Product Marketing at Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Resilience depends on how quickly and confidently the business can recover – not solely on keeping every threat out.
Turn recovery plans into evidence – tested results are more credible to boards, regulators, and insurers than targets or assumptions.
ResOps zu einem gemeinsamen Betriebsmodell für die Bereiche Sicherheit, Infrastruktur, Geschäftskontinuität und die Verantwortlichen für die einzelnen Dienste machen.
Das Wesentliche messen: Teams sollten wissen, ob kritische Dienste wiederhergestellt werden können, wie lange die Recovery-Phase tatsächlich dauert und ob sie dies nachweisen können.
Wählen Sie eine oder zwei kritische Dienste aus, definieren Sie, was unter einer erfolgreichen Recovery zu verstehen ist, führen Sie eine realitätsnahe Übung durch und dokumentieren Sie die Ergebnisse.
Twenty years in security leadership teaches you one thing early: The attack you stopped never makes the board meeting. The one you didn’t is the only story anyone remembers. Somewhier along the way I stopped measuring my team by how many hits we absorbed alone and started also measuring us by how fast we got back up.
That’s the reason I want every CISO, CIO, and board member I know to read this new book, ResOps: Ein Leitfaden für Führungskräfte. Commvault sponsored it, but I’d be recommending it either way.
Die Mauer war nie der gesamte Plan
For most of my career, the job was building higher walls. Better detection, tighter controls, faster response. That work still matters, and it always will. But a wall only answers one question, and it’s not the one your board is asking anymore.
Last September, ransomware forced Jaguar Land Rover to halt global manufacturing. Assembly lines stopped. Supply chains froze. The UK’s Cyber Monitoring Centre put the cost to the broader economy at roughly £1.9 billion, and JLR posted its lowest monthly production output in 73 years. JLR had defenses. What the incident tested wasn’t whether the wall held. It was whether the business could get back up once it didn’t.
I’ve said this before and I’ll keep saying it: Disruption isn’t an if, it’s a when. The CISOs who sleep at night aren’t those who believe they can keep everything out; they’re those who’ve practiced getting back up so many times that the practice itself is the confidence.
Drei Fragen, die ich meinem eigenen Team stelle
The book organizes the whole problem into three questions, and I’ve started opening every resilience review with them:
Wenn wir heute Abend angegriffen würden, könnten wir uns davon erholen?
Wie lange würde das eigentlich dauern?
Können wir das dem Vorstand anhand von Belegen nachweisen?
Most organizations answer the first two with a plan and the third with silence. That silence is the resilience gap, and it’s bigger and more expensive than most executives realize.
Taten statt Versprechungen
Here’s a distinction the book makes better than I’ve heard it made anywhier else: A recovery time objective is a target. It tells you what you’re aiming for – but it doesn’t tell you whether you’ll hit it.
Compare “we believe we can recover the payments service in four hours” to “we restored it in 3.2 hours last quarter, from a verified clean recovery point, against a four-hour tolerance.” The first sentence is a plan. The second is evidence. Only one of them holds up when your board, your regulator, or your cyber insurer starts asking harder questions, which they will.
We calls this discipline ResOps, short for resilience operations. It’s not a product you buy or a binder you file. It’s an operating model that connects security, infrastructure, business continuity, and the business owners who depend on these services, all working from the same evidence instead of separate plans.
Der Aspekt, der jedem CISO Sorgen bereiten sollte
The book also names something I’ve felt for a while and finally have language for: the AI paradox. The same AI capability helping us find vulnerabilities faster is helping attackers close the gap between discovery and exploitation just as fast, maybe faster. Finding more problems doesn’t make you safer if you can’t recover from the ones that get through. Detection speed was never the finish line. Recovery capability is.
Beginnen Sie mit einem Dienst
None of this requires boiling the ocean, and I’d be lying if I said my own team got it right on the first try. The book lays out a 90-day path: Pick one or two of your most critical services, define what “recovered” really means for each, run one honest recovery exercise, and produce your first piece of real evidence. That’s a project any team can start this quarter, mine included.
Proof over promises. Readiness over perfection. That’s the standard I hold my team to, and it’s the standard this book gives you a real path toward.
Get your copy of ResOps: Ein Leitfaden für Führungskräftehier.
FAQs
F: Was ist ResOps?
A: ResOps, kurz für „Resilience Operations“, ist ein Betriebsmodell, das die Bereiche Sicherheit, Infrastruktur, Geschäftskontinuität und Serviceverantwortliche im Rahmen gemeinsamer, evidenzbasierter Recovery-Maßnahmen miteinander verbindet.
F: Inwiefern unterscheidet sich ResOps von herkömmlicher Disaster Recovery?
A: Bei der herkömmlichen Disaster Recovery stehen oft Pläne und technische Ziele im Mittelpunkt. ResOps legt den Schwerpunkt auf kontinuierliche Validierung, funktionsübergreifende Verantwortung und den messbaren Nachweis, dass kritische Dienste innerhalb der für das Unternehmen akzeptablen Toleranzgrenzen wiederhergestellt werden können.
F: Warum sind Belege für die Recovery wichtig?
A: Nachweisdokumente zur Recovery zeigen, was eine Organisation tatsächlich getestet und erreicht hat. Sie tragen dazu bei, dass Vorstände, Aufsichtsbehörden, Versicherer und Führungskräfte mehr Vertrauen gewinnen als durch Pläne oder Recovery-Ziele allein.
F: Was sollten Unternehmen im Rahmen eines ResOps-Programms messen?
A: Unternehmen sollten prüfen, ob kritische Dienste wiederhergestellt werden können, wie lange die Recovery-Prozesse tatsächlich dauern, ob die Recovery-Punkte fehlerfrei und verifiziert sind und ob die Ergebnisse den festgelegten geschäftlichen Toleranzgrenzen entsprechen.
F: Wer sollte in ResOps eingebunden sein?
A: ResOps sollte die Verantwortlichen für Sicherheit, Infrastruktur, Geschäftskontinuität sowie die Anwendungs- und Serviceverantwortlichen und die Entscheidungsträger der Unternehmensleitung zusammenbringen, damit die Prioritäten bei der Recovery und die entsprechenden Nachweise den geschäftlichen Anforderungen entsprechen.
F: Wie kann ein Unternehmen mit ResOps beginnen?
A: Beginnen Sie mit einem oder zwei kritischen Diensten. Definieren Sie, was eine erfolgreiche Recovery bedeutet, führen Sie eine realistische Recovery-Übung durch, dokumentieren Sie die Ergebnisse und nutzen Sie diese Erkenntnisse, um den nächsten Test zu verbessern.
Der aktualisierte Leitfaden der Bundesbehörden beschreibt neue Taktiken und Techniken der „Medusa“-Gruppe sowie mehr als 500 Opfer in verschiedenen Bereichen der kritischen Infrastruktur.
Angreifer haben es nicht nur auf Produktionsdaten abgesehen; sie stören auch Backups, Identitätsmanagement, Virtualisierungssysteme und andere Systeme, auf die Unternehmen bei der Recovery angewiesen sind.
Dasadvisory calls on organizations to prove their resilience through testing and validation against observed attacker behaviors, not assume it from plans or successful backup jobs alone.
Die jüngste Empfehlung der Bundesregierung zur Ransomware „Medusa“ wurde aus einem bestimmten Grund aktualisiert:gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Der Gegner hat sich verändert.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
DasAktualisierte Empfehlung der Bundesregierung, issued August 18, 2026, by the FBI, Cybersecurity and Infrastructure Security Agency (CISA), and U.S. Department of Health and Human Services (HHS), describes an adversary that recruits new access brokers, moves faster once inside, and has gotten better at making sure the damage it causes cannot be undone.
DasAttack Is Not Just Against Your Data
Die Medusa-Angreifer handeln schnell. Ermittler berichten, dass die Medusa-Angreifer neu bekannt gewordene Exploits bereits innerhalb von 24 Stunden ausgenutzt haben und in einigen Fällen Exploits bereits bis zu einer Woche vor der öffentlichen Bekanntgabe der Sicherheitslücke eingesetzt haben.
Sobald sie sich Zugang verschafft haben, tarnen sie sich mithilfe legitimer Fernwartungstools, durch den Diebstahl von Zugangsdaten und mithilfe von „Living-off-the-Land“-Techniken.
But the advisory’s most significant finding is that gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Medusa greift den Recovery-Weg selbst an.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
Dasadvisory maps this activity to MITRE ATT&CK technique T1490, Inhibit System Recovery. Darin wird dokumentiert, wie die Ransomware Dienste beendet, die mit Datensicherungen, Sicherheit, Datenbanken, Kommunikation, Dateifreigabe und Websites in Verbindung stehen. Außerdem löscht sie Schattenkopien und fährt virtuelle Maschinen aus der Ferne herunter und verschlüsselt sie.
Wenn ein Angreifer gezielt auf die Systeme, Identitäten und die Infrastruktur abzielt, die ein Unternehmen möglicherweise wiederherstellen muss, geht das Problem über den Datenschutz hinaus und betrifft auch die Cyber-Resilienz und die Cyber-Recovery.
Hier kommt ResOps (Resilience Operations) ins Spiel
ResOps ist nicht einfach nur ein anderer Begriff für „Backup“. Es handelt sich um eine betriebliche Disziplin, die Sicherheit, IT, Infrastruktur, Anwendungen, Betrieb und das Geschäft auf ein gemeinsames Ziel ausrichtet: die Aufrechterhaltung kritischer Dienste und deren Wiederherstellung innerhalb der für das Unternehmen akzeptablen Zeitspanne.
DasMedusa advisory never uses the word ResOps, but the thinking is there. It recommends organizations exercise, test, and validate their security programs against observed attacker behaviors, align security technologies to attack techniques, test them at scale, measure performance, and tune people, processes, and technologies based on the evidence.
Ein Backup ist kein Beweis dafür, dass das System fehlerfrei ist. Ein in einer Tabellenkalkulation festgelegtes Ziel für die Recovery-Zeit ist kein Beweis dafür, dass der Geschäftsbetrieb innerhalb dieses Zeitraums wieder aufgenommen wird. Resilienz muss sich von einer Annahme zu einer gesicherten Tatsache entwickeln.
Start With the Business, Not DasServer
Dasaddition of HHS in the advisory makes this especially relevant for healthcare, a sector the FBI says has been a frequent Medusa target. Dasrecovery conversation starts with three questions:
Was muss weiterlaufen, und wie sieht ein minimal funktionsfähiger Betrieb aus?
Welche Identitäten, Anwendungen, Infrastruktur und Daten unterstützen diese Dienste?
Welchen Wiederherstellungspunkten können wir vertrauen, und was wird zuerst wiederhergestellt?
In a hospital, leaving any one of those unanswered may mean a delayed surgery, a pharmacist who can’t verify a dosage, or a diagnostic system a clinician can’t trust. No single team can answer them alone, which is the gap ResOps is designed to close.
Nutzen Sie Medusa, um Ihre Annahmen zu überprüfen
Verwenden Sie Medusa als Testfall für Ihre Annahmen zur Recovery. Kann ein Angreifer auf die Systeme zugreifen, die die Recovery unterstützen? Was passiert, wenn Active Directory kompromittiert wird? Können Sie einen intakten Wiederherstellungspunkt identifizieren, kritische Dienste in der richtigen Reihenfolge wiederherstellen und nachweisen, wie lange dies dauern wird?
Threat actors adapt when defenders adapt. Resilience programs need to operate the same way: continuously tested, continuously validated, and continuously improved.
Denn mitten in einem Vorfall ist es ein äußerst ungünstiger Zeitpunkt, festzustellen, dass der Recovery-Plan auf dem Papier besser aussah, als er in der Praxis funktioniert.
FAQs
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was ist die Ransomware „Medusa“?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Medusa ist ein „Ransomware-as-a-Service“-Betrieb, der erstmals im Jahr 2021 identifiziert wurde. Seine Entwickler und Partner wenden ein Modell der doppelten Erpressung an: Sie verschlüsseln Systeme und drohen gleichzeitig mit der Veröffentlichung gestohlener Daten, falls kein Lösegeld gezahlt wird.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Warum wurde die bundesweite Medusa-Warnung aktualisiert?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. DasAugust 2026 update incorporates findings from FBI investigations as recent as April 2026. It expands the documented tactics, techniques, procedures, exploited vulnerabilities, affiliate activity, and indicators of compromise, while adding HHS insights on attacks against healthcare.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: How does Medusa threaten an organization’s recovery capabilities?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Medusa kann Dienste unterbrechen, die mit Datensicherungen, Sicherheit, Datenbanken, Kommunikation und anderen kritischen Funktionen in Verbindung stehen. Außerdem kann es Schattenkopien löschen, identitätsbezogene Richtlinien ändern sowie virtuelle Maschinen herunterfahren oder verschlüsseln, wodurch der Recovery-Prozess selbst gefährdet wird.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was sollten Unternehmen tun, um das Medusa-Risiko zu verringern?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Unternehmen sollten bekannte Sicherheitslücken umgehend beheben, Netzwerke segmentieren, den Zugriff auf Remote-Dienste einschränken, die Authentifizierung verstärken, laterale Bewegungen überwachen und das Prinzip der geringsten Berechtigungen anwenden. Außerdem sollten sie separate, offline gespeicherte, verschlüsselte und unveränderliche Recovery-Kopien vorhalten und die Recovery-Abläufe regelmäßig testen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was ist ResOps und worin unterscheidet es sich von einem Backup?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. ResOps, or resilience operations, is a cross-functional operating discipline – not a backup product. It aligns security, IT, infrastructure, applications, operations, business continuity, and business owners around restoring critical services within the amount of disruption the business can tolerate.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Wie kann eine Organisation nachweisen, dass sie bereit ist, sich zu erholen?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Beginnen Sie mit den geschäftskritischen Diensten, erfassen Sie die Identitäten, Anwendungen, die Infrastruktur, die Daten, die Mitarbeiter und die Dritten, von denen diese abhängen, und definieren Sie, was unter einer erfolgreichen Recovery zu verstehen ist. Führen Sie anschließend realistische Übungen durch, um geeignete Recovery-Punkte zu ermitteln, die Dienste in der richtigen Reihenfolge wiederherzustellen, die tatsächliche Recovery-Zeit zu messen und etwaige Lücken in ein eigenes Verbesserungs-Backlog zu überführen.
Chris Bevilist Principal Portfolio Marketing Manager bei Commvault.
Etwa 1.200 vermeintlich isolierte Agenten kommunizierten über ein nicht autorisiertes Forum, und etwa 700 beteiligten sich an Aktivitäten im Zusammenhang mit Hugging Face.
Die Agenten tauschten über 70.000 Nachrichten und Dateien aus und führten dabei Erkenntnisse aus Sitzungen zusammen, die eigentlich voneinander getrennt bleiben sollten.
Investigators found agents spoofing tool calls and researching ways to alter evaluation transcripts to avoid detection by dengrader.
Unveränderliche, isolierte Backups allein reichen nicht aus: Unternehmen benötigen einen validierten, vertrauenswürdigen Recovery-Punkt, bevor sie die Daten in die Produktionsumgebung zurückspiegeln.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Die forensischen Gutachten liegen nun endlich vor, und sie haben meine Sichtweise auf diesen Vorfall verändert.Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
At dentime, denstory sounded fairly straightforward: An AI agent found a way outside denenvironment designed to contain it and ultimately reached Hugging Face.
So ist es eigentlich nicht gewesen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Die Geschichte geht über einen einzelnen abtrünnigen Agenten hinausDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
Aus den forensischen Berichten geht hervor, dass etwa 1.200 Agenten, die eigentlich isoliert arbeiten sollten, einen Weg gefunden hatten, über ein nicht autorisiertes Forum zu kommunizieren. Sie tauschten mehr als 70.000 Nachrichten und Dateien aus, und rund 700 Agenten waren an Aktivitäten im Zusammenhang mit Hugging Face beteiligt.
None of that was prompted or intended. Dasagents were persistent, they could share what they found, and they could combine effort across sessions that were supposed to have no contact with each other.
Among dennew details: GPT-5.6 Sol agents reproduced an exploit and copied private evaluation data into a public Hugging Face dataset, a concrete escalation beyond what initial reports described.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Das Problem des „Reward-Hacking“Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
Dasunabhängige Untersuchung, durchgeführt von METR und Redwood Research, published alongside OpenAI’s own report on August 26, found that agents researched ways to spoof, edit or delete portions of their own evaluation transcripts because they incorrectly believed dengrader would inspect how they completed dentask. Researchers found successful tool-call spoofing in about 7% of dentranscripts they evaluated, though denmanipulation they observed was small-scale.
Dasfinding is not that agents are “deceptive” in a human sense. It is that a sufficiently capable agent can search for ways around controls when those controls stand between it and denoutcome it has been optimized to achieve.
OpenAI calls denincident a “warning shot.” I think that is a fair description.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Was passiert, wenn die Eindämmung versagt?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
Most of denconversation about this incident will rightly focus on alignment, sandboxing and monitoring. But there’s a resilience question underneath it: If 700 agents can find a side door around containment, what’s denplan for when a single compromised workload does densame in your environment?
OpenAI’s own conclusion points at denanswer: Security architecture should assume an individual workload or compute node eventually can be compromised. That means air-gapped, immutable recovery data, and a way to validate what you’re restoring before it touches production again.
But immutability alone does not prove dendata was clean when it was captured. If dendata was already compromised at dentime of capture, immutability preserves dencompromise just as faithfully as it preserves anything else.
Daspractical version of that question is simple to ask and hard to answer: If this happened to us, could we prove which recovery point predates dencompromise?
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.DasLesson for Every OrganizationDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
OpenAI has since tightened workload and network isolation, expanded monitoring, and revised its model-development practices. Daslesson applies beyond OpenAI: Contain denimpact, preserve what you can trust, and prove you can recover before you need to.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.FAQsDie Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What was denOpenAI-Hugging Face incident?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
During internal cybersecurity evaluations, OpenAI agents bypassed controls intended to isolate them, accessed deninternet and reached third-party systems, including Hugging Face. Dasactivity was driven primarily by an internal research model operating with reduced safeguards.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Frage: Wie haben die angeblich isolierten Agenten miteinander kommuniziert?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Sie entdeckten ein nicht autorisiertes Forum in der gemeinsam genutzten Infrastruktur. Rund 1.200 Agenten nutzten es, um mehr als 70.000 Nachrichten und Dateien auszutauschen, wodurch Informationen und Taktiken über Sitzungen hinweg weitergegeben wurden, die eigentlich voneinander unabhängig bleiben sollten.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: Were denagents instructed to attack Hugging Face?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. No. They were attempting to complete a difficult cybersecurity benchmark. When denintended route appeared blocked, some agents searched for alternative ways to achieve denevaluated outcome, and that activity expanded beyond denenvironment’s intended boundaries.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.Q: What does “reward hacking” mean in this context?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Reward hacking occurs when an agent finds an unintended way to satisfy a metric or obtain a desired result without completing dentask as intended. Investigators found agents researching ways to spoof tool calls and alter or delete portions of evaluation transcripts because they believed dengrader might inspect their process.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Warum reichen unveränderliche Backups allein nicht aus?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen. Immutability prevents stored data from being altered, but it does not prove dendata was clean when it was captured. If a backup already contains compromised data, immutability preserves that compromise. Organizations therefore need isolated copies, trustworthy recovery points and validation before restoration.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.F: Was sollten Unternehmen nach diesem Vorfall anders machen?Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.
gar nicht mehr gibt. Hier sind die wichtigsten Erkenntnisse.A:Die Wiederherstellung sollte bei den geschäftlichen Zielen ansetzen – nicht bei den technischen.Stärken Sie die Isolierung von Arbeitslasten und Netzwerken, beschränken Sie unnötigen Internetzugang und den Zugriff auf Anmeldedaten, überwachen Sie das Verhalten von Agenten und Eskalationssignale und gehen Sie davon aus, dass Präventionsmaßnahmen versagen können. Kombinieren Sie diese Kontrollmaßnahmen mit isolierten, unveränderlichen Wiederherstellungsdaten und einem getesteten Prozess zur Identifizierung und Validierung eines einwandfreien Wiederherstellungspunkts.
Chris Bevilist Principal Portfolio Marketing Manager bei Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem
Certificate lifespans will shrink from 398 to 47 days by March 2029 with “domain Validierung reuse” shrinking to just 10 days, making manual renewal obsolete and automatic Certificate Lifecycle Management (CLM) necessary.
Im Rahmen von „Harvest Now, Decrypt Later“-Maßnahmen werden bereits Daten mit langer Lebensdauer gespeichert, um sie später mithilfe von Quantencomputern zu entschlüsseln. Dies bedeutet eine unmittelbare Bedrohung für verschlüsselte, sensible Daten, die über einen längeren Zeitraum aufbewahrt werden.
Der Aufbau eines Zertifikats-/Krypto-Bestandsverzeichnisses ist für Unternehmen derzeit von entscheidender Bedeutung, da eine kontinuierliche und automatisierte Bestandserfassung der erste Schritt hin zu langfristiger Cyber-Resilienz und Krypto-Agilität ist.
Das Problem, das sich im Hintergrund verbirgt
Die meisten modernen Unternehmensnetzwerke stützen sich auf eine verborgene Ebene, die aus digitalen Zertifikaten und Kryptografie besteht und die die meisten Menschen nie zu Gesicht bekommen. Diese Ebene überprüft die Vertrauenswürdigkeit von Geräten und sichert den Datenfluss, doch da die Anzahl der Geräteidentitäten mittlerweile die der menschlichen Identitäten übersteigt, ummehr als 80 zu 1 in the average enterprise according to CyberArk’s machine identity research, it can be easy to underestimate the cryptographic and certificate layer’s importance.
A helpful way to think about a digital certificate is an ID badge for a machine. If the badge is valid, the doors open automatically and no one thinks about it, but the moment that badge expires or is misconfigured, the door stops opening, regardless of how legitimate the machine behind it is. A single expired certificate can take down websites, break the APIs that let applications talk to each other, interrupt transactions, and create compliance violations, all while eroding user trust.
For years, organizations have managed certificates manually, but two changes are going to make it impossible to keep up by hand. First, the maximum lifespan of public Transport Layer Security (TLS) certificates, the protocol securing your browser, is being compressed to just 47 days by 2029. Second, the eventual arrival of quantum computers powerful enough to break today’s encryption is forcing a transition to Post-Quantum Cryptography. These two issues both point to the same solution – a governed, automated, and crypto-agile approach to CLM.
Der Fahrplan für die Verkürzung der Gültigkeitsdauer von Zertifikaten
Das Einsatzfenster für öffentliche TLS-Zertifikate wird seit einem Jahrzehnt immer enger. Anfang 2023 veröffentlichte Google erstmals seine“Moving Forward, Together”Roadmap, in der vorgeschlagen wurde, die Gültigkeitsdauer von Zertifikaten von 398 Tagen auf 90 Tage zu verkürzen, um die Branche zur Automatisierung zu bewegen. Apple hat diesen Zeitplan im Oktober 2024 beschleunigt, indem esVorlage eines Wahlentwurfs to the CA/Browser Forum, the industry body where certificate authorities and browser makers set shared rules. Apple’s proposal, endorsed by Sectigo, Google Chrome, and Mozilla, was approved in April 2025 as Stimmzettel SC-081v3.
Diese Verkürzung erfolgt schrittweise. Das bisherige Maximum von 398 Tagen ist bereits im März 2026 auf 200 Tage gesunken; im März 2027 wird das Maximum auf 100 Tage und schließlich im März 2029 auf 47 Tage reduziert. In der Praxis bedeutet dies, dass eine Organisation, die derzeit jedes Zertifikat etwa einmal pro Jahr erneuert, baldjedes Zertifikat etwa alle anderthalb Monate zu erneuern; in der Endphase wird jeder Prozess, der davon abhängt, dass eine Person Zertifikate manuell anfordert und installiert, fehlschlagen.
Browserhersteller setzen sich für diese kürzeren Gültigkeitsdauern ein, um eine Automatisierung zu erzwingen, wodurch menschliche Fehler vermieden werden, die ohnehin die meisten Zertifikatsausfälle verursachen. Außerdem ermöglichen sie es dem gesamten Web, neue kryptografische Standards innerhalb von Wochen statt Jahren zu übernehmen, da alte Zertifikate schnell auslaufen. Darüber hinaus tragen sie dazu bei, die Abhängigkeit von veralteten Sperrsystemen zu verringern, die mit Leistungs- und Datenschutzproblemen behaftet sind. Schließlich sorgen kurzlebige Zertifikate dafür, dass die Anzahl der Zertifikate, die kurzfristig ersetzt werden müssen, drastisch sinkt, falls jemals ein „Certificate Transparency“-Protokoll (ein öffentliches Verzeichnis ausgestellter Zertifikate) für ungültig erklärt wird.
Die Validierungs-Krise
Während die 47-Tage-Frist für Schlagzeilen und Aufmerksamkeit sorgt, könnte die einschneidendere Änderung darin bestehen, was mit der Domain-Kontrollvalidierung (DCV) geschieht. DCV ist der Prozess, bei dem einer Zertifizierungsstelle (CA) nachgewiesen wird, dass Sie die Kontrolle über die Domain haben, für die Sie ein Zertifikat beantragen. Bisher konnte die CA den Nachweis, sobald eine Organisation die Eigentumsrechte nachgewiesen hatte, bis zu 398 Tage lang wiederverwenden. Gemäß SC-081v3 verkürzt sich dieses Zeitfenster jedoch ab 2026 auf 200 Tage und bis März 2029 auf nur noch 10 Tage.
Dies führt zu einem erheblichen Ungleichgewicht, da selbst eine Organisation, die die Zertifikatsinstallation vollständig automatisiert hat, ins Stocken gerät, wenn sie die Domain-Eigentümerschaft nicht alle 10 Tage erneut nachweisen kann. Jede Verzögerung bei der Validierung bringt den gesamten Ausstellungsprozess zum Stillstand und führt unmittelbar zu Ausfällen.
Die praktische Lösung für dieses Problem ist die Einführung des ACME-Protokolls (Automatic Certificate Management Environment) mitautomated DNS-01 API Validierung, sodass der Nachweis des Eigentums programmgesteuert erfolgt, anstatt auf eine Person warten zu müssen.
Die Quantenbedrohung und der Zeitplan
While certificate lifespans shrink, the algorithms inside those certificates face a quantum threat. Traditional Public Key Infrastructure (PKI) rely on asymmetric cryptography to secure digital signatures, key exchanges, and TLS connections. A sufficiently powerful quantum computer running Shor’s algorithm could break these systems completely. Waiting until quantum computing is powerful enough to decrypt is not a viable option; as Vidya Shankaran, Field CTO bei Commvault has written, “the exact date of Q-Day may remain uncertain. The direction of travel is not.”Schätzungen zufolge wird der „Q-Day“ – der Zeitpunkt, an dem ein Quantencomputer die Public-Key-Verschlüsselung knacken kann – in den nächsten 5 bis 10 Jahren eintreten. Es wäre jedoch ein Fehler, dies als ein Problem der Zukunft zu betrachten. Angreifer führen bereits „Harvest Now, Decrypt Later“ (HNDL)-Operationen durch, bei denen sie verschlüsselten Datenverkehr schon heute abfangen und speichern, um ihn zu entschlüsseln, sobald die Quantencomputertechnik ausgereift ist. Daten, die über Jahre hinweg vertraulich bleiben müssen – wie beispielsweise Gesundheitsakten, geistiges Eigentum und Finanzinformationen –, sind in dem Moment, in dem sie erfasst werden, faktisch ungeschützt.
Die US-Bundesregierung hat entsprechend reagiert: Im Juni 2026 veröffentlichte das Weiße HausVerordnung Nr. 14412, Securing the Nation Against Advanced Cryptographic Attacks, which sets deadlines well ahead of NIST’s original 2035 target: Federal high-value systems must adopt post-quantum key establishment by the end of 2030 and post-quantum digital signatures by the end of 2031.
Despite this urgency, actual progress toward enterprise-level crypto-agility has been slow. The DigiCert-Ausblick zur Quantencomputer-ReadinessDie Untersuchung ergab, dass mehr als die Hälfte der befragten Organisationen davon ausgeht, dass die klassische asymmetrische Verschlüsselung innerhalb von fünf Jahren geknackt wird, doch nur 7 % haben in ihrem gesamten Zertifikatsbestand quantensichere oder hybride Kryptografie implementiert, und die allgemeine Readiness hat sich im vergangenen Jahr um lediglich 2 Prozentpunkte verbessert.
Warum ist Krypto-Agilität so wichtig?
The most practical bridge between classical and post-quantum cryptography is the hybrid composite certificate, which combines a classical algorithm (RSA or ECC) with a post-quantum algorithm (ML-DSA, the standardized lattice-based signature scheme) inside a single X.509 certificate. Combining both into a single certificate is designed so that the certificate will hold up as long as either algorithm does, which is essential, as post-quantum algorithms are new and haven’t yet survived countless attempted attacks like RSA has.
However, post-quantum keys and signatures are several kilobytes rather than a few hundred bytes, which increases network latency, risks packet fragmentation during the TLS handshake, and adds computational overhead that may require hardware upgrades for constrained devices. This is exactly why crypto-agility matters; organizations need the ability to test, deploy, and rotate algorithms without rewiring their underlying infrastructure each time standards evolve.
Automatisiertes Zertifikatslebenszyklusmanagement
Die manuelle Verwaltung von Zertifikaten ist nicht nur ineffizient, sondern stellt auch ein echtes operatives Risiko dar. Wenn Zertifikate in Tabellenkalkulationen versteckt sind und aus dem Blickfeld geraten, verlieren Unternehmen den Überblick. Die Folge sind abgelaufene Berechtigungsnachweise, unzureichende Schlüssellängen, veraltete Signaturalgorithmen und nicht konforme Konfigurationen, die niemand bemerkt, bis es zu Ausfällen kommt. Die daraus resultierenden Ausfälle können bei den Nutzern Verwirrung stiften, den Umsatz beeinträchtigen und letztendlich dem Team angelastet werden, das am wenigsten darauf vorbereitet ist, sie zu erklären.Eine umfassende CLM-Plattformbehandelt dies über die gesamte Laufzeit eines Zertifikats hinweg:
Erfassung: Kontinuierliche Überprüfung von Cloud-Umgebungen, Rechenzentren, Containern und externen Domänen, um alle verwendeten Zertifikate zu ermitteln.
Überwachung: Verfolgung von Ablaufdaten, Algorithmen, wesentlichen Stärken und der Einhaltung von Sicherheitsrichtlinien in Echtzeit.
Validation: Utilize direct API integration with public and private CAs, while automating domain Validierung and approvals
Installation: Stellen Sie erneuerte Zertifikate und Schlüssel programmgesteuert über ACME oder sichere APIs bereit – ganz ohne manuelle Übergaben.
Widerruf: Eine schnelle, richtliniengesteuerte Widerrufung ist erforderlich, damit ein kompromittiertes Zertifikat überall gleichzeitig ausgetauscht oder widerrufen werden kann, anstatt es Rechner für Rechner aufspüren zu müssen.
Auch der Erfassungsschritt birgt einen Vorteil: Das von einer CLM-Plattform geführte Zertifikatsinventar ist praktisch der Anfang des kryptografischen Inventars, das für die Planung der Post-Quanten-Migration erforderlich ist – wodurch aus einer lästigen Compliance-Aufgabe ein Vorsprung werden kann.
Nicht-menschliche Identitäten und agentische KI
Das Problem des Umfangs wird durch die Art und Weise verschärft, wie moderne Anwendungen aufgebaut sind. Container, Kubernetes-Pods, virtuelle Maschinen, Geräte des Internets der Dinge (IoT) und APIs benötigen alle ihre eigenen Zugangsdaten, und viele dieser Workloads existieren nur für wenige Minuten oder Stunden, bevor sie beendet werden. Kein Team aus Menschen kann Zertifikate in dieser Geschwindigkeit ausstellen und widerrufen.
Um mit diesem rasanten Tempo Schritt zu halten, können KI-Agenten eingesetzt werden, die Zertifikate eigenständig ermitteln, ausstellen, erneuern und verwalten – und dabei innerhalb bestehender Rahmenbedingungen wie Sicherheitsrichtlinien, rollenbasierter Zugriffskontrolle (RBAC) und zentraler Prüfpfade bleiben. Das Ergebnis ist eine Automatisierung in Maschinen-Geschwindigkeit, ohne dabei die unternehmensweite Governance zu vernachlässigen.
Wo soll man anfangen?
Der erste Schritt hin zu unternehmensweiter Krypto-Agilität und -Resilienz ist eher organisatorischer als technischer Natur. Im Anschluss anLeitlinien des NIST, Unternehmen sollten ein zentrales Team für Maschinenidentitätsdienste einrichten, das für die CLM-Plattform verantwortlich ist, Zertifikatsvorlagen standardisiert und die Anbindung an öffentliche und private Zertifizierungsstellen aufrechterhält. Die einzelnen Anwendungsverantwortlichen und DevOps-Teams sollten ihrerseits dafür zuständig sein, automatisierte Verlängerungen in ihre eigenen Bereitstellungs-Pipelines zu integrieren und dabei die zentrale Plattform als gemeinsamen Dienst zu nutzen. Diese Aufgabenteilung gewährleistet eine einheitliche Governance und vermeidet gleichzeitig manuelle Übergaben, die zu Ausfällen führen können.
Organizations should replace manual Validierung techniques and workflows with ACME and automated DNS-01 Validierung now, well before the 10-day DCV window arrives, while deprecating every manual renewal and Validierung process along the way.
Parallel dazu sollten Unternehmen eine umfassende Bestandsaufnahme ihrer kryptografischen Ressourcen durchführen, um fest programmierte Schlüssel, veraltete Algorithmen und langlebige Vertrauenspfade, die sensible Daten schützen, aufzudecken.
Die Vorbereitungen für die Post-Quanten-Ära sollten in einer kontrollierten Umgebung und nicht in der Produktion beginnen. Es sollte ein eigenes Testlabor eingerichtet werden, damit Teams hybride Verbundzertifikate und kryptoagile Upgrades in einer Sandbox testen können. Durch die Entwicklung von Anwendungen auf Basis modularer kryptografischer Bibliotheken, die mit einer dynamischen CLM-Plattform verbunden sind, können Unternehmen echte Kryptoagilität erlangen: die Fähigkeit, Schlüssel, Verschlüsselungsverfahren und Algorithmen in ihrer gesamten Infrastruktur anzupassen, wenn sich Standards ändern – und das ohne Neuentwicklung.
The thread that connects all recommendations is inventory. A CLM platform’s discovery step is not busywork before the real fix; it is the same discipline organizations will need across every layer of quantum readiness. Certificates are non-human identities, and the same questions apply to service accounts, AI agents, open source dependencies, and the algorithms buried in application code: What do we have, what does it protect, and which of it matters most to the business?
Organizations that build that inventory muscle now, starting with certificates, will find the rest of the transition far less daunting, because prioritization becomes a calculation rather than a guess. Treating the next few years as a planning window rather than a grace period will help organizations make this transition on their own terms, instead of letting an outage make the decision for them.
Caitlin Dodson is a Summer 2026 Intern for FCTO – Americas at Commvault.
More related posts
29 Minutes: Why Enterprise AI Risk Is a Speed Problem, Not a Frontier Problem