Skip to content

Everywhere you go you hear the same story. AI changed everything, attackers are faster, and governance matters. This is a narrative that 50 other CISOs could deliver.  

After 20 years in cybersecurity, I have the benefit of perspective. I’ve lived through major shifts in technology: the internet, mobile, cloud … and more. To me, the interesting story is what is fundamentally different about AI vs. every other technology transition.  

AI didn’t replace the CISO’s mission. Yes, it changed the speed, but good security has always been about being the team that doesn’t just protect technology but also helps enable the company to win in the market in which it competes. Just like with the internet, mobile, and cloud, confirming the company uses AI well is table stakes.  

1. What my job looked like a year ago

A year ago, my priorities would have been very recognizable to any CISO: ransomware, identity, vulnerability management, third-party risk, cloud security, data protection, resilience. AI was on the agenda, but largely as an emerging technology risk. Today, it’s becoming part of almost every one of those conversations.  

Last year’s world wasn’t simple. We had to protect identities, systems, applications, infrastructure and data. And now, all of those remain, but you’re dealing with systems that can consume huge amounts of information, generate new information, make recommendations, write software, automate workflows, and increasingly act on behalf of people. The old problems didn’t disappear. AI landed and sped up the clock of the existing security stack.

2. What changed, and why it wasn’t gradual 

The biggest inflection point is the collapse in the cost of capability. An attacker no longer needs the same skills and time investment. Previously they’d have to invest countless hours in their coding ability or content-production effort to operate at scale and countless hours to identify and hone targets. At the same time, my own employees suddenly have powerful tools that can ingest corporate information and produce code, analysis, and content.  

So, we have two simultaneous accelerations. What changed wasn’t simply that attackers got AI. Everyone got AI. And adoption happened from the bottom up. Employees didn’t wait for the enterprise AI strategy. Developers started using copilots. People experimented with public LLMs. Business functions discovered automation opportunities.  

For most major enterprise technologies, security had some opportunity to prepare the environment before widespread adoption. With generative AI, adoption often arrived before governance. 

3. How the mission itself changed 

Historically, security asked: How do we protect this technology? But AI forces another question: How do we allow the company to use this technology safely?  

That brings CISOs into questions that aren’t purely cybersecurity:  

  • What information can employees provide to AI systems?  
  • Which models and services are approved?  
  • What happens to prompts and uploaded data?  
  • Where is corporate data retained?  
  • How do we manage AI identities, agents, and permissions?  
  • How do we validate AI-generated code?  
  • What human oversight is required?  
  • How do legal, privacy, security, data governance, and compliance responsibilities intersect?  

That said, CISOs need to be careful they don’t become Luddites, or the AI Police. The CISO role is helping define the security boundaries within which the company can move quickly. If the security strategy for AI is simply “don’t use it,” you’ve already lost. People will use it. Our job is to make the secure path the easiest path. 

4. What I had to relearn or unlearn

One thing I’ve had to unlearn is the idea that security gets to fully understand a technology before the enterprise adopts it. With AI, adoption and experimentation are happening simultaneously with our understanding of the risks. We have to allow smart and thoughtful adoption. 

Another is determinism. Security professionals grew up evaluating systems where, broadly speaking, Input A should produce Output B. Generative systems don’t behave that neatly. We’re accustomed to asking whether a control works. AI forces us to become more comfortable asking how reliably it works, under what conditions it fails, and what happens when it does. That’s intellectually interesting.  

Twenty years in security teaches you pattern recognition. Now, AI reminds me that pattern recognition can become a liability when the underlying assumptions change.  

Early on I assumed the principal problem would be malicious use of AI externally against us. But quickly I discovered that my biggest impact would be spent internally on data governance, internal adoption, and business enablement. 

5. What’s next/advice for peers First, don’t create a separate AI-security universe. Map AI into the controls you already understand: identity, data classification, least privilege, logging, third-party risk, secure development, incident response, and resilience.  Second, pay close attention to agents. Today’s dominant interaction is often human → model → response. The more consequential architecture is increasingly: human → agent → tools → systems → data → actions. Once AI can take actions (rather than merely generate text), authorization, identity, provenance, monitoring, and blast radius become much more important. I’m less worried about an AI saying the wrong thing than I am about an AI agent being authorized to do the wrong thing.  Third, protect the data layer.Models will change quickly. Vendors will change. Architectures will change. Today’s biggest AI company and hippest frontier model will be Betamax soon. Your durable security assets remain knowing what data you have, where it is, who can access it, and what they’re allowed to do with it.  Fourth, don’t measure success by how much AI you block.A sophisticated security organization should enable legitimate adoption while constraining unacceptable risk. Every major technology shift creates a period where capability moves faster than control. The internet did it. Mobile did it. Cloud did it. AI is doing it at extraordinary speed. 

Handling this well doesn’t require eliminating AI risk altogether. It requires deciding deliberately which risks you’re willing to take, putting boundaries around them, and still allowing the business to move.  

AI hasn’t repealed the fundamentals of cybersecurity, but it is changing the economics and velocity around them. After 20 years of successive security transformations, AI may be the first one where the CISO must simultaneously defend against the technology, protect the technology, and help the business adopt the technology. That’s what makes it a challenge. 

Bill O’Connellis Chief Security Officer at Commvault.
More related posts


AI Data Resilience

Read more about AI Data Resilience

For years, resilience conversations have centered on technology. Do you have backups? Do you have a disaster recovery plan? Do you have protections in place to prevent an attack? 

Those remain important questions. But increasingly, they’re not the ones I’m hearing from executives. 

Instead, I’m hearing a much simpler question: If we experience a cyberattack tomorrow, can we come back from it, and can we prove it?  

NewIDC research, based on a survey of 539 IT and resilience decision makers across the U.S. and Canada, reveals a growing reality: Having recovery technology doesn’t automatically make an organization recovery ready. 

Recently, I joined Jason Cray from Commvault’s Product Experience team to discuss that research from IDC. What emerged from our conversation wasn’t simply a discussion about backup, recovery, or cyber resilience.  

It was a discussion about confidence. More specifically, why so many organizations believe they’re recoverable, but struggle to prove they’re actually recovery ready. 

Regardez laRecovery Readiness Webinar On Demand. 

Points clés à retenir 

  • The difference between being recoverable and recovery ready is like the difference between theory and proof. 
  • IDC found that 57.7% of organizations have not fully defined their minimum viable business. If you don’t know what you need to recover, how can you prioritize what needs to come back up first? 
  • Recovering everything is not a viable strategy. Successful recovery depends on prioritization and business context. 
  • Cyber recovery requires a team approach to be successful.  
  • The fundamental difference between cyber recovery and disaster recovery is the need for trust. 
  • Speed may not be the best measure of recovery, especially if you can’t trust your backups. 
  • Organizations build confidence through testing, not planning alone.  
  • ResOps provides a framework for turning resilience into an operational discipline. 
What’s the Difference Between Being Recoverable and Being Recovery Ready? 

A few years ago, many resilience discussions ended with a checklist. 

  • Backups? Check. 
  • Recovery plan? Check. 
  • Disaster recovery testing? Check. 

Today, that level of assurance is no longer enough. 

During the webinar, Jason shared a perspective I hear frequently from customers: Organizations can usually tell you exactly how much they invest in security and protection technologies, but far fewer can confidently explain how they would recover if those controls failed.  

The distinction may sound subtle, but it’s important. 

Being recoverable means you have mechanisms in place that could support recovery. Being recovery-ready means you’ve demonstrated those mechanisms can successfully restore critical business operations under real-world conditions. 

As resilience becomes a board-level concern, assumptions are giving way to evidence. Leaders want confidence that recovery plans will actually work when the pressure is at its highest. 

When the Chips Are Down, Does Your Organization Know What Matters Most? 

One of the most striking findings from theIDC researchis that57.7% of organizations have not fully defined their minimum viable business. 

A minimum viable business isn’t simply a list of critical applications. It’s the combination of people, processes, systems, and data required to keep the organization functioning during disruption. It answers a critical question: What absolutely must come back first? 

This is where many recovery strategies begin to fall apart. 

I’ve worked with organizations that understand which applications are important but haven’t mapped the dependencies supporting them. Others continue treating nearly every workload as mission critical. While that approach might seem prudent, it creates a practical problem during recovery. 

When Everything Is Critical, Nothing Is 

Recovery takes time. Infrastructure has limits. Dependencies matter. 

Organizations cannot realistically expect to recover an entire multi-petabyte environment immediately following a large-scale cyber event. Prioritization becomes essential. 

The organizations that recover most effectively tend to know exactly what must come back first, what can wait, and what business outcomes depend on those decisions. That’s what defining a minimum viable business enables. 

Sneak Peek: Recovery Readiness Webinar 

One of the themes Jason and I explored throughout the webinar is the fact that cyber resilience is a shared responsibility. There’s a disconnect in many organizations that recovery readiness is an infrastructure challenge. It is not; it’s an organizational challenge. It requires alignment across security, IT, legal, communications, and business teams to confirm critical applications, processes, and recovery priorities are clearly understood before disruption occurs. 

Recovery Plans Fail in Silos 

Many organizations still approach resilience through disconnected teams. Infrastructure teams focus on systems. Security teams focus on threats. Business leaders focus on continuity. Legal and communications teams often become involved only after an incident occurs. 

The problemis thatdisruptions don’t respect organizational boundaries. 

Successful recovery depends on coordinated decision-making across all of those functions. Recovery priorities, customer communications, business operations, legal obligations, and technical restoration efforts must all work together in real time.  

One customer recently described their resilience planning efforts as building a team of superheroes. While they meant it jokingly, it perfectly captured the reality of modern recovery readiness. Organizations recover as teams, not technologies. 

Why Cyber Recovery Is Fundamentally Different From Disaster Recovery 

One misconception we discussed during the webinar is the belief that traditional disaster recovery plans can simply be adapted for cyber recovery. 

In reality, they solve different problems. 

Traditional disaster recovery was often built around predictable failure scenarios. A site outage. Infrastructure failure. A known disruption that triggered a documented response. Cyber events are fundamentally different. 

Organizations must determine what systems have been compromised, what data can be trusted, and whether recovery actions could inadvertently reintroduce risk. The challenge isn’t simply restoration. It’s validation. 

You can’t restore what you can’t trust. That uncertainty creates a very different recovery process. 

If organizations restore compromised systems or infected data, they risk bringing the problem back into production. As attacks continue to grow in sophistication, validating the integrity of recovered environments becomes increasingly important. 

Recovery is no longer just about bringing systems online. It’s about restoring trust. 

Why Trust Matters More Than Speed: A Fast Recovery Can Still Be a Failed Recovery 

That brings us to one of the most important points from our discussion. For years, recovery success was largely measured by speed. 

  • How quickly can systems be restored? 
  • How quickly can operations resume? 

Those questions still matter. But speed alone is no longer enough.  

A recovery that reintroduces malware, compromised identities, or untrusted data into production isn’t truly successful. That’s why more organizations are investing in isolated recovery environments, validation exercises, and recovery testing designed to verify the integrity of recovered assets before they return to production.  

Recovering quickly only matters if you’re recovering something you can trust. 

MTCR: The NewMeasure of Recovery Confidence 

As organizations rethink how they measure resilience, many are moving beyond traditional recovery time objectives (RTOs) and recovery point objectives (RPOs). 

Instead, they’re focusing on mean time to clean recovery (MTCR).  

What makes MTCR valuableis thatit reflects the realities of modern cyber recovery. It’s not just about how quickly an organization restores data. It includes the time required to validate, assess, and confidently return systems to production.  

That distinction matters because organizations don’t simply recover infrastructure. They recover business operations. MTCR better reflects how quickly the organization can safely return to a trusted operating state. 

Confidence Comes From Testing 

If there’s one lesson I’ve learned from working with organizations across various stages of resilience maturity, it’s this: Confidence doesn’t come from documentation. 

Confidence comes from testing.  

Static recovery exercises often validate known processes under ideal conditions. Real-world disruptions are rarely that predictable. 

Recovery-ready organizations test continuously. They simulate realistic conditions. They introduce uncertainty. They identify dependencies. They uncover weaknesses before attackers do.  

Most importantly, they build organizational muscle memory. 

During the webinar, Jason shared a perspective I’ve always found compelling: Organizations can choose to figure things out during a period of stability, or they can try to figure them out in the middle of a crisis. The better option is obvious.  

Testing doesn’t simply validate technology. It validates people, processes, communications, priorities, and assumptions. And that’s where real confidence is built. 

ResOps Is What Happens When Recovery Becomes an Operational Discipline 

Throughout our discussion, nearly every challenge we identified pointed back to the same need: Organizations need a way to consistently define priorities, align stakeholders, validate recoverability, and improve over time.  

That’s exactly why resilience operations, or ResOps, is gaining momentum. 

ResOps isn’t about introducing another tool or process. It’s about operationalizing resilience. It brings together people, process, and technology under a common framework for continuous validation and improvement.  

Because ultimately, recovery readiness isn’t a project. It’s a discipline. 

The organizations that will differentiate themselves in the years ahead won’t simply be the ones with recovery technologies or documented plans. They’ll be the organizations that can demonstrate those plans work: 

  • They’ll know what matters most. 
  • They’ll understand how to recover it. 
  • They’ll validate that it’s safe to recover without risk of reinfection 
  • And they’ll have evidence to prove it.  

In other words, they won’t just be recoverable. They’ll be recovery-ready. 

En savoir plus 

The IDC report also found that overall organizational resilience among the organizations surveyed is impaired both by gaps in individual technologies and by the absence of a coordinating framework that brings business, infrastructure, and security functions together around a shared recovery objective. 

For a deeper look at the research: 

FAQ 

Q : Qu’est-ce que ResOps ? R :ResOps (resilience operations) is an operational discipline that helps organizations continuously validate and improve their ability to recover from disruption. It brings together people, processes, and technology to make recovery readiness measurable and provable.  Q: What is a minimum viable business? R :A minimum viable business is the combination of systems, processes, people, and data required to continue operating during a disruption. It helps organizations prioritize recovery efforts when everything cannot be restored simultaneously.  Q: Why is cyber recovery different from disaster recovery? R :Traditional disaster recovery assumes predictable failure scenarios. Because the nature of cyber attacks is unpredictable, cyber recovery requires organizations to change their focus to determining what systems can be trusted, validating recovered data, and ensuring threats are not reintroduced into production environments. Q: What is mean time to clean recovery (MTCR)? R :MTCR measures how long it takes an organization to recover to a verified, trusted operational state. It incorporates recovery, validation, and confidence-building activities rather than focusing solely on restoration speed. Q: Why does recovery testing matter? R :Testing helps organizations uncover hidden dependencies, validate assumptions, build muscle memory, and improve recovery processes before a real disruption occurs. Recovery confidence is earned through practice, not paperwork.  Q: Why is identity resilience important? R :Identity systems play a foundational role in recovery. If users cannot access production systems, recovery environments, or critical data, even the best recovery plans may be difficult to execute successfully.  Q: How can organizations measure recovery readiness? R :Organizations can begin by defining their minimum viable business, testing recovery processes regularly, validating recovered environments, and measuring outcomes using metrics such as mean time to clean recovery (MTCR). 

Vidya Shankaranest directrice technique sur le terrain chez Commvault. 

More related posts


Cyber Recovery

Read more about Cyber Recovery

What Is Recovery Time Objective (RTO) and How to Calculate It

Learn how to define, calculate, and meet your RTO targets to minimize downtime and protect critical business operations.

Recovery time objective (RTO) is the maximum duration of time a business process or application can remain offline after a disruption before the impact becomes unacceptable. In practice, your RTO answers a direct question: how fast must you recover?

That question carries significant financial weight. According to Siemens and Splunk’s 2024 True Cost of Downtime report, unplanned downtime costs the world’s 500 biggest companies $1.4 trillion annually. Whether the cause is ransomware, a misconfigured update, or a regional cloud outage, every minute of inactivity chips away at revenue, customer trust, and regulatory standing.

Recovery time objective is not a single, universal number. It varies by workload, by business unit, and by the consequences of being offline. A payment processing system demands a far shorter RTO than an internal development environment. Getting this right requires deliberate analysis — not guesswork — and it is a core component of disaster recovery planning.

This guide breaks down what RTO means, how it differs from RPO, how to calculate and tier your targets, and what you can do to help meet them consistently.

Downtime Tolerance

Recovery time objective is a disaster recovery metric that defines the maximum tolerable period between a disruption and full restoration of a system or business process. It covers every phase of recovery: detection, decision-making, failover execution, data validation, and service confirmation.

The National Institute of Standards and Technology (NIST) defines RTO as “the overall length of time an information system’s components can be in the recovery phase before negatively impacting the organization’s mission” (NIST Glossary). NIST’s Cybersecurity Framework 2.0 reinforces RTO through its RECOVER function, which calls on organizations to execute recovery plans within established time objectives.

RTO is expressed in units of time – minutes, hours, or days – and is set before a disruption occurs, not during one. It is a planning metric. Your actual recovery time should consistently come in under the RTO you define; if it does not, you have a gap that puts the business at risk.

According to Splunk and Oxford Economics’ The Hidden Costs of Downtime, Global 2000 companies lose an average of $49 million per year from downtime. That figure makes the case for treating RTO as a core business metric, not just an IT exercise. When leadership understands what downtime costs per hour, setting and funding appropriate RTOs becomes a straightforward conversation.

RTO vs. RPO

RTO and RPO are companion metrics, but they measure different risks. RTO addresses the question “how long can we be down?” RPO addresses “how much data can we lose?”

Recovery point objective (RPO) defines the maximum age of data that must be recovered after an outage. An RPO of one hour means you can tolerate losing up to one hour of transactions. An RPO of zero means no data loss is acceptable – requiring synchronous replication or continuous data protection.


Système métrique RTO RPO
Définition Maximum acceptable downtime after a disruption Maximum acceptable data loss measured in time
Focus Speed of recovery Frequency of backups or replication
Measurement Time from failure to full restoration Time between the last good backup and the failure
Exemple 2-hour RTO: systems must be operational within 2 hours 1-hour RPO: you can lose at most 1 hour of data


According to the Uptime Institute’s 2024 Annual Outage Analysis, 55% of outages lasted more than two hours – suggesting many organizations still have a meaningful gap between their stated RTO and their actual recovery capability. Defining both RTO and RPO together helps you plan for speed and data integrity simultaneously.

Calculate RTO

Calculating RTO is not a formula you plug numbers into. It is a structured assessment that connects technical capability to business tolerance. Here is how to approach it — and once you have your targets, you can optimize your recovery time objectiveover time.


Conduct a business impact analysis (BIA).

Identify every critical application and process. For each one, quantify what downtime costs – lost revenue, regulatory penalties, customer churn, reputational damage. According to ITIC’s 2024 Hourly Cost of Downtime survey, over 90% of enterprises estimate downtime costs exceed $300,000 per hour for mission-critical applications.


Identify and rank critical systems.

Not every workload has the same urgency. Group applications by business function: revenue-generating, customer-facing, internal operations, and development or archival. Assign a priority tier to each group.


Assess current recovery capabilities.

Document how long each system actually takes to recover today. Include detection time, notification and escalation, infrastructure provisioning, data restoration, validation, and user reconnection. Your current recovery time is your baseline.


Set tiered RTOs based on risk tolerance.

Match each priority tier to an RTO that the business can fund and the IT team can deliver. Compare your baseline recovery times against these targets. Any gap between current capability and target RTO is a problem to solve with architecture, automation, or a better DR platform.

This process – BIA, ranking, assessment, tiering – gives you defensible, data-driven RTOs rather than arbitrary numbers.

RTO Tiers

Not every system warrants the same recovery investment. Tiered RTOs let you direct budget and engineering effort where the business impact is greatest.


Tier RTO Target Exemples Rationale
Tier 1 – Critical Less than 1 hour ERP, payment processing, core databases, customer-facing apps Revenue loss and regulatory exposure begin immediately
Tier 2 – Important Less than 4 hours Email, CRM, internal collaboration, HR systems Productivity drops significantly, but short-term workarounds exist
Tier 3 – Non-Critical Less than 24 hours Archive storage, development/test environments, legacy reporting Impact is limited; recovery can be scheduled


According to ITIC’s 2024 research, over 90% of enterprises estimate downtime costs exceed $300,000 per hour. For Tier 1 systems, even brief outages generate six-figure losses. Tier 3 systems, by contrast, can tolerate a full business day offline without material impact.

The value of tiering is focus. You invest in sub-hour recovery for payment processing and ERP, while giving archive systems a 24-hour window that costs far less to maintain. This approach keeps disaster recovery budgets efficient without leaving critical systems exposed.

Improve RTO

Setting an RTO is only useful if you can actually hit it. Here are the strategies that consistently reduce recovery time.

Adopt cloud-based disaster recovery. Cloud DR helps eliminate the need to maintain idle standby hardware. On-demand infrastructure lets you spin up recovery environments in minutes, not hours. According to the Uptime Institute’s Annual Outage Analysis 2025, organizations that have adopted cloud-based DRetautomated failover report measurably shorter outage durations compared to those relying on traditional approaches. Review thesecloud disaster recovery best practicesfor a deeper look at implementation.

Implement continuous replication. Point-in-time snapshots taken hours apart create data gaps that inflate both RPOetRTO. Continuous replication helps to keep standby environments current, so recovery starts from a near-real-time state.

Automate failoveretvalidation. Manual recovery steps introduce human erroretdelay. Automated runbooks execute failover sequences, verify data integrity,etconfirm service availability – all without waiting for an on-call engineer to step through a wiki page at 3 a.m.

Test regularlyetmeasure. A recovery plan that has never been tested is a hypothesis, not a plan. Run DR drills quarterly. Measure actual recovery time against your RTO. Document gapsetfix them before they matter.

Clumio par Commvault helps deliver rapid, predictable recovery for AWS workloads – including Amazon EC2, S3, RDS,etDynamoDB. Clumio’s architecture enables air-gapped, immutable backups with automated restore orchestration to help your recovery time stay within target even during a ransomware event. Explore Clumio’s ransomware récupérationetde Recovery opérationnelle solutions to see how your team can close the gap between stated RTOsetactual capability.

Questions fréquemment posées:

What Is RTO in Disaster Recovery?

RTO in disaster recovery is the maximum acceptable time a system can remain offline after a disruption. It sets the deadline for restoring operations before the business suffers unacceptable financial, operational, or reputational harm.

What Is the Difference Between RTO and RPO?

RTO measures how long you can be down; RPO measures how much data you can afford to lose. RTO focuses on speed of recovery, while RPO focuses on backup frequency and replication. You need both to build a complete DR plan.

How Do You Calculate RTO?

Start with a business impact analysis to quantify downtime costs for each application. Rank systems by criticality, assess current recovery times, and set tiered RTO targets that balance risk tolerance with recovery investment.

What Is an Example of a Recovery Time Objective?

A payment processing platform might have a 30-minute RTO because every minute of downtime costs significant revenue. An internal development environment might have a 24-hour RTO because the business impact of a day offline is minimal.

What Is Maximum Tolerable Downtime vs. RTO?

Maximum tolerable downtime (MTD) is the absolute limit before a disruption causes irreversible business damage. RTO is set below the MTD to provide a safety margin. If your MTD is four hours, your RTO should be shorter – for example, two hours.

How Can You Reduce Your RTO?

Move to cloud-based DR with continuous replication and automated failover. Test recovery plans regularly and measure actual restore times. Platforms like Clumio provide air-gapped backups and automated restore orchestration to help keep recovery within target.

Ransomware Backup Protection: How to Keep Your Data Recovery-Ready

Ransomware operators now target backup infrastructure before encrypting production data. Learn how air-gapped, immutable cloud backups help protect your recovery path – and what the 3-2-1-1-0 framework means for your organization.

Backup Attacks

Ransomware operators have a clear playbook: Neutralize recovery options before encrypting production data. If your backups are intact, you can refuse to pay the ransom and restore operations. Attackers know this, so backup infrastructure has become a primary target.

Modern ransomware strains use several tactics to undermine backup systems:

  • Shadow copy deletion is among the most common – malware executes commands to remove Volume Shadow Copies the moment it gains a foothold.
  • Backup repository encryption goes further, targeting backup servers and storage pools directly.
  • Double extortion adds another layer: Attackers exfiltrate sensitive data before encryption, threatening to publish it even if you recover from backups.

Selon le rapportCISA Medusa ransomware advisory(updated August 2026), the Medusa ransomware-as-a-service operation has impacted more than 500 victims across critical infrastructure sectors including medical, education, legal, insurance, technology, and manufacturing as of April 2026. Medusa actors run a double-extortion model, pairing encryption with data theft to pressure victims into paying.

“Both Medusa developers and affiliates use a double-extortion model where they encrypt victim data and threaten to publicly release exfiltrated data if a ransom is not paid.”

– FBI, CISA, and HHS, Medusa Ransomware Advisory (AA25-071A), 2026


CISA Medusa advisory (updated August 2026): 500+ victims impacted across critical infrastructure as of April 2026

Air Gap Types

An air-gapped backup creates separation between your production environment and your backup data, helping make it harder for ransomware to reach recovery copies. There are three main approaches, each with distinct trade-offs.


Physical air gaps

involve storing backups on disconnected media – tape, removable drives, or offline storage arrays. The backup media is physically separated from the network when not in active use. This approach offers strong isolation but introduces operational complexity: manual handling, transportation logistics, and slower recovery times.


Logical air gaps

use network segmentation, firewalls, and strict access controls to help isolate backup repositories within the same infrastructure. Backup data remains online but is accessible only through tightly controlled pathways. This is faster than physical air gapping but relies on the integrity of network controls – a misconfiguration or credential compromise can bridge the gap.


Cloud air gaps

place backup data in a provider-managed, isolated environment that is separate from the customer’s primary cloud account. The backup service controls the storage layer, helping enforce immutability and access restrictions at the platform level.

CISA’s StopRansomware guiderecommends maintaining offline backups separated from production networks to help reduce exposure to lateral movement during an attack. Legacy approaches to cloud backup ransomware protection often require organizations to build and manage their own isolated accounts, adding infrastructure overhead and operational burden. Modern cloud-native solutions handle this isolation as a built-in capability, helping reduce complexity while maintaining strong separation.

“Maintain offline, encrypted backups of data and regularly test your backups.”

– CISA, StopRansomware Guide, 2025


CISA StopRansomware Guide (2025): Organizations should maintain offline backups separated from production networks.

Immutable Backup Rule

An immutable backup is one that cannot be altered, overwritten, or deleted for a defined retention period. This is typically implemented using Write Once, Read Many (WORM) storage policies. It is designed so that once backup data is written, no user, administrator, or automated process can modify it until the retention lock expires.

Immutability and air gapping serve complementary purposes. Air gapping controls where backup data lives and who can reach it. Immutability controls what can be done to it once it arrives. The strongest ransomware backup protection strategies use both: Data is stored in an isolated environment and locked against modification.

The 3-2-1 backup rule has been a data protection standard for decades: Maintain three copies of data, on two different media types, with one copy offsite. The modern 3-2-1-1-0 framework extends this for ransomware resilience: 3 copies of your data, 2 different storage media or platforms, 1 copy offsite, 1 copy that is air-gapped or immutable (or both), 0 errors after automated backup verification. The 3-2-1-1-0 rule is not just a guideline – it is a practical framework for building ransomware recovery capabilities that help hold up under real attack conditions.

Protection Best Practices

Strong ransomware backup protection requires more than the right storage architecture. It demands disciplined operational practices across encryption, access control, testing, and compliance.

  • Encrypt backups in-flight and at rest. Backup data should be encrypted during transmission and while stored. Support for Bring Your Own Key (BYOK) encryption helps give you control over key management without relying solely on the backup provider.
  • Enforce multi-factor authentication (MFA) and role-based access control (RBAC). Limit who can access backup management consoles and recovery operations. MFA helps add a layer of defense against credential-based attacks, and RBAC restricts each user to the minimum permissions they need.
  • Test restores regularly. Backups that have never been tested are backups you cannot trust. Run recovery drills on a recurring schedule – including granular restores, cross-account recovery, and point-in-time rollbacks – to help confirm your recovery time objectives are realistic.
  • Maintain compliance certifications. For regulated industries, your backup solution should hold current certifications such as ISO 27001, SOC 2 Type II, and HIPAA.

Encryption helps protect data confidentiality; access controls help limit the blast radius of compromised credentials, testing helps validate recovery readiness, and compliance frameworks help provide a structured approach to maintaining all of the above.

Clumio Backup Protection

Clumio helps deliver cloud-native ransomware backup protection purpose-built for AWS workloads,includingAmazon S3,DynamoDB,and EC2/EBS. Here is how Clumio helps address the core challenges covered in this article:

  • Air-gapped cloud backups outside your AWS account. Clumio stores all backup data in an isolated,provider-managed environment that is designed to be completely separate from your primary cloud account. Attackers who compromise your production environment face significant barriers to reaching your backup data.
  • Immutable by design. Backup data written to Clumio is immutable and indelible,and is designed so that it cannot be altered,or overwritten through any user interface or API. Immutability is enforced at the platform level,not as an optional configuration.
  • Granular recovery at every level. Clumio helps support recovery at the object,prefix,bucket,table,and instance level. It is designed to help you restore exactly what you need – a single S3 object,a DynamoDB table,or an entire EC2 instance – without rebuilding full environments.
  • Serverless SaaS with zero infrastructure to deploy. Clumio operates as a fully managed service. There are no backup servers,storage pools,or agents to maintain. Protection is designed to scale automatically with your data growth.
  • Encrypted in-flight and at rest with BYOK support. All data is encrypted during transfer and at rest,with support for customer-managed encryption keys.

Clumio brings together air-gapped isolation,immutability,granular recovery,and a serverless operating model – helping give cloud-native teams the ransomware backup protection they need without the complexity of legacy infrastructure.

Questions fréquemment posées:

How do backups help protect against ransomware?

Backups helpprotect against ransomwareby providing clean copies of data that can be restored after an attack. When backups are air-gapped and immutable, data is immutable and indelible, helping give you a reliable path to recovery without paying a ransom.

What is the 3-2-1-1-0 rule?

Le3-2-1-1-0 rulecalls for three copies of data on two media types, one offsite, one air-gapped or immutable, and zero errors after verification. It is the modern standard for ransomware-resilient data protection.

What is an air-gapped backup?

Unair-gapped backupis a copy of data stored in an environment that is physically or logically isolated from your production network. This separation helps prevent ransomware from reaching backup data during an attack.

Qu’est-ce qu’une sauvegarde immuable ?

Unsauvegarde immuable is a copy of data that cannot be modified or deleted once it has been created. This helps keep information intact and protected from both malicious actors and unintended administrative changes. While sauvegarde immuables help safeguard data from natural disasters and human error, their greatest value is providing confidence that even if systems are compromised, critical data remains secure, reliable, and recoverable.

Can ransomware encrypt cloud backups?

Yes, ransomware can encrypt cloud backups if they reside in the same account or environment as production data. Cloud backup ransomware protection requires storing backups in an isolated, air-gapped environment with immutability controls.

How long does ransomware recovery take?

Recovery speed depends on the scope of the attack and your backup architecture. Solutions with granular, parallelized recovery can help restore individual objects or tables in minutes, while full-environment restores from legacy systems may take days.

MORE RESOURCES

Secure Immutable Air-Gapped Data Protection with Clumio

What Is Backup as a Service? A Guide to BaaS for Enterprise IT

Backup as a service (BaaS) is a cloud-delivered model that provides managed backup infrastructure, storage, policy-based retention and recovery capabilities. Learn how BaaS works, the benefits it can provide, and what to consider when evaluating a provider.

Backup as a service (BaaS) is a cloud-deliveredmodel in which a provider manages the underlying backup infrastructure anddelivers storage, and recovery capabilities as a service.Instead of buying, deploying, and maintaining on-premises backup infrastructure, organizations use a service that provides policy-based backup,storage, infrastructure scaling, and data recovery.

For enterprise IT teams, this shift matters. Managing traditional backup environments means juggling aging hardware, capacity planning, tape rotations, and recovery testing, all while cyber threats grow more sophisticated by the quarter. The complexity drains budgets and pulls skilled engineers away from higher-value work.

BaaS helps remove that operational burden. You define protection policies, and the provider helps handle the rest – from secure cloudstorage with built-in redundancy to rapid recovery when something goes wrong.

Solutions likeClumiotake this model further with a cloud-native architecture purpose-built to protect supported workloads across AWS and Google Cloud, helping deliver isolated, air-gapped backups without requiring you to deploy or manage backup infrastructure.

What Is BaaS?

Backup as a Service is a managed cloud service that helps automate the backup and recovery of your organization’s data. Rather than requiring customers to run backup software and infrastructure on servers they own, a BaaS provider delivers the underlying backup software, storage, monitoring capabilities, and recovery workflows as a subscription service.

BaaS covers a broad range of workloads such as Amazon S3 and DynamoDB. The scope depends on the provider, but modern platforms are designed to handle hybrid and multi-cloud environments from a single control plane.

The distinction from traditional backup is straightforward. On-premises backup requires you to purchase hardware, license software, allocate storage, and staff a team to manage it all. BaaS helps eliminate that capital expenditure and operational overhead. You pay for what you need, and the provider helps handle capacity, patching, and infrastructure scaling.

Most BaaS solutions help support multiple backup methods – full, incremental, and differential – applied through automated policies. You set the frequency, retention periods, and recovery objectives, and the service is designed to execute continuously without manual intervention. For organizations evaluating cloud-native data protection, BaaS represents a fundamental shift in how IT teams approach resilience.

How BaaS Works

The mechanics of BaaS follow a straightforward workflow, though the engineering behind it is anything but simple.


Data collection.

A lightweight agent or API-level integration connects to your workloads – databases, object stores, VMs, applications – and helps identify data that needs protection based on your defined policies.


Secure transmission.

Data is encrypted in transit (typically AES-256 or TLS 1.2+) and sent to the provider’s cloud storage environment. Incremental backups capture only changed data, helping minimize bandwidth consumption and reduce backup windows.


Cloud storage with redundancy.

The provider stores your backup data across geographically distributed infrastructure with built-in replication. This helps protect against regional outages and hardware failures without requiring you to architect redundancy yourself.


Policy-driven automation.

You define RPO and retention policies, and the service executes automatically. There is no manual scheduling, no missed backup windows, and no forgotten retention cleanups.


Recovery mechanics.

When you need data back, modern BaaS platforms help support point-in-time restores; granular recovery at the file, object, or table level; and cross-region recovery for disaster scenarios.

Unlike traditional backup tools that operate within the same account, cloud-native BaaS solutions like Clumio are designed to store data in an isolated, air-gapped environment. This architectural decision is critical: If ransomware compromises your production account, your backups remain untouched in a separate, immutable vault.

Clumio’s serverless SaaS architecture means there is no backup infrastructure to deploy or manage within your cloud environment – it is designed so that protection scales automatically as your data grows.

ForAmazon S3workloads, Clumio captures changes at the event level rather than running periodic scans, which helps reduce both cost and recovery point gaps. And when aransomware récupérationscenario hits, the isolated architecture helps enable you to restore clean data without reinfection risk.

BaaS Benefits

BaaS helps deliver measurable advantages across cost, operations, and security. Here are the six that matter most for enterprise IT.


Reduced infrastructure costs.

BaaS helps eliminate capital expenditure on backup servers, storage arrays, and tape libraries. BaaS operates on a subscription model – you pay for the data you protect and the retention you need. As workloads grow, costs scale predictably without forklift upgrades.


Simplified disaster recovery.

Traditional disaster recovery planning requires maintaining secondary sites, replicating data, and testing failover procedures quarterly (at best). BaaS providers handle geographic redundancy and cross-region storage natively, helping your recovery posture improve without additional architecture work.


Scalable storage.

Cloud-native BaaS is designed to scale automatically with your data growth. This helps eliminate the need to forecast capacity 18 months out or overprovision to avoid running out of space during a critical backup window.


Automated protection.

Policy-driven automation helps reduce the human error that plagues manual backup processes. Define your RPO and retention requirements once, and the service helps handle execution, monitoring, and alerting. Clumio takes this further by capturing data changes at the event level, helping deliver continuous protection without periodic scan overhead.


Enhanced security.

Immutable, air-gapped backup storage helps protect against ransomware, insider threats, and accidental deletion. This is where architecture matters: Clumio stores backup data in an isolated environment separate from your production cloud environment, helping reduce the risk that compromised production credentials or attacks on the source environment can also affect your backups.


Temps de Recovery plus courts.

When minutes matter, BaaS platforms deliver granular recovery – helping restore a single S3 object, a DynamoDB table, or an entire bucket without rebuilding a full environment. Clumio’s parallelized recovery architecture is designed to restore large volumes of data quickly, helping minimize the business impact of any incident.

For teams managingde Recovery opérationnelleacross cloud workloads, BaaS is becoming the default approach.

Choosing a Provider

Not every BaaS provider is built the same. Use this evaluation framework to help make a decision that holds up under real-world conditions.

Security posture. Evaluate how the provider isolates backup data from your production environment. Immutable storage and air-gapped architecture are non-negotiable. Align your evaluation with frameworks like thecadre de cybersécurité du NISTto verify that provider controls map to your governance requirements.

Compliance certifications. Verify SOC 2 Type II, ISO 27001, HIPAA, and any industry-specific certifications your organization requires. Clumio maintainsla conformitécertifications that enterprise customers expect, helping reduce the burden on your audit and legal teams.

RPO and RTO capabilities. Understand what RPOs and RTOs the provider actually can deliver, not just promise. Ask for documented service level agreements and customer references for large-scale recovery scenarios.

Workload coverage. Confirm the provider supports your specific workloads – cloud-native databases, object stores, virtual machines (VMs), SaaS applications. A provider that covers Amazon S3 but not DynamoDB creates protection gaps.

Scalability and pricing model. Evaluate how costs scale with data growth. Predictable, consumption-based pricing helps avoid the surprise bills that come with hidden egress or restore fees. Explore how solutions like Clumio help supportcloud cost optimizationas your data estate expands.

Vendor independence. Avoid lock-in. Confirm you can export or migrate backup data if you change providers.

BaaS vs. DRaaS

Backup as a service and disaster recovery as a service (DRaaS) help solve different problems, and confusing them creates dangerous gaps in your resilience strategy.

BaaS protects data.

It is designed to create, store, and manage backup copies of your files, databases, and applications. When you need data back – whether from accidental deletion, corruption, or ransomware – BaaS helps restore it.

DRaaS protects infrastructure.

It is designed to replicate your entire environment – servers, networking, applications, and data – to a secondary site. When a disaster takes down your primary data center, DRaaS helps fail over your workloads so operations continue with minimal interruption.

The practical distinction: BaaS answers “can I get my data back?” while DRaaS answers “can I keep my applications running?”

Most enterprise organizations need both. BaaS handles day-to-day recovery scenarios – helping restore a corrupted database, roll back a bad deployment, or recover from a ransomware event. DRaaS is designed to handle catastrophic failures – regional outages, facility-level disasters, or complete infrastructure compromise. A mature resilience strategy layers BaaS for data protection with DRaaS for business continuity.

Questions fréquemment posées:

What is Backup as a Service (BaaS)?

Backup as a Service is a cloud-delivered model in which a provider manages the underlying backup infrastructure and delivers policy-based backup, storage, and recovery capabilities. You define policies and initiate recovery when needed, while the service automates backup operations and helps eliminate the need to deploy and maintain on-premises backup infrastructure.

What are the benefits of BaaS?

BaaS helps reduce infrastructure costs by replacing capital-intensive hardware with a subscription model. It automates protection to help eliminate manual backup management and human error. It strengthens security with immutable, air-gapped storage that is designed to protect backups from ransomware and account compromise.

How does BaaS work?

BaaS is designed to connect to your workloads through agents or API integrations, encrypt and transmit changed data to secure cloud storage, and apply policy-driven automation for scheduling and retention. When recovery is needed, it helps you restore data at the granular level – individual files, objects, or tables – without rebuilding full environments.

What is the difference between BaaS and DRaaS?

BaaS helps safeguard and restore data — files, databases, and applications. DRaaS is designed to replicate and fail over your entire infrastructure to maintain application availability during catastrophic events. BaaS helps handle everyday recovery scenarios, while DRaaS helps enable business continuity during major outages. Most organizations benefit from both.

How do you choose a BaaS provider?

Evaluate providers on security architecture (immutable and air-gapped storage), compliance certifications, documented RPO/RTO capabilities, workload coverage, scalable pricing, and vendor independence. Prioritize providers that isolate backup data from your production environment to help safeguard against ransomware.


Source advisory: FBI | NSA | Cyber National Mission Force Joint Cybersecurity Advisory, August 26, 2026

Points clés à retenir

  • QTFY operates at scale. Its reconnaissance, exploitation and proxy infrastructure creates an attack ecosystem – not a series of isolated actions.
  • AI compresses the defender’s response window. Automation can make established tactics faster, broader and more efficient even when the underlying techniques are familiar.
  • Advisory guidance needs to become test cases. Teams should validate whether their controls detect active scanning, multi-hop proxies, web shells, remote-access tools and stolen credentials.
  • Coverage on paper is not proof of readiness. Detection and response capabilities must be exercised against the specific behaviors described in the advisory.
  • Cyber readiness includes operational resilience. Organizations need to know what can be isolated, what must remain available, and what should be recovered first.

LeJoint Cybersecurity Advisoryfrom the FBI, NSA, and Cyber National Mission Force, released August 26, describes a China-linked hacking group known as QTFY. The group has been targeting critical infrastructure and sensitive organizations across defense, communications, government, energy, higher education, and water. But what stands out is not just who they are targeting, but how they are operating.

QTFY has essentially built an attack ecosystem.

One component, QScan, performs large-scale reconnaissance and exploitation with more than 200 proof-of-concept exploits and processed more than two million scanning and penetration-testing tasks in a single day in 2024. Another component, QTRouter, routes traffic through commercial proxy services and compromised IoT devices to help obscure the origin of malicious activity.

QTFY also exploits both zero-day and known vulnerabilities; uses remote-access trojans, web shells, and stolen credentials for persistence; and has been researching and integrating AI into its operations over the past two years.

AI does not magically create a new cyber threat category, but it can make an existing operation faster, more scalable, and more efficient. Combined with years of reconnaissance data, exploit libraries, and traffic-obfuscation infrastructure, the window for defenders to react shrinks.

From Guidance to Test Cases

Especially important is the advisory’s “Validate Security Controls” section. What follows translates that guidance into specific test cases for a QTFY-style intrusion.

QScan’s reconnaissance maps to MITRE ATT&CK technique T1595, Active Scanning. Given the scale at which QScan operates, the question for defenders is whether controls can recognize automated reconnaissance targeting your environment amid normal internet traffic, and whether that capability has actually been tested.

QTRouter’s use of commercial proxies and compromised IoT devices aligns with MITRE ATT&CK T1090, Proxy, particularly T1090.003,Proxy à plusieurs sauts. On the persistence side, the advisory maps web shells toT1505.003, and uses remote-access trojans (T1219) and stolen credentials (T1078, Valid Accounts) to maintain access.

QTFY’s use of stolen credentials is worth calling out separately. T1078, Valid Accounts, sits in a blind spot for most security programs because legitimate credentials tend not to trip traditional malware detection.

Each of those mappings raises a practical testing question. Can your team detect a web shell sitting on a server you believe is patched and monitored? Can you recognize traffic being deliberately routed through multiple proxies and compromised IoT infrastructure? Testing those controls is different from simply confirming the patch was installed.

That testing discipline must extend into resilience. No security program can guarantee that every attack will be stopped, so organizations must prepare for the moment when something gets through: what has to stay operating, what recovers first, and how quickly. In short: what can actually be isolated, and for how long, before the business itself feels it?

For a deeper look at that operating model, seeResOps : l’avenir de la résilience des entreprises à l’ère de l’IA. This piece is about what QTFY specifically demands of your testing program.

Pick one QTFY technique above and test it against your own controls. That is what tells you whether readiness is real.

FAQ

Q : What is QTFY? 

R :QTFY is a China-linked hacking group described in the joint advisory as targeting critical infrastructure and other sensitive organizations. Its activity combines large-scale reconnaissance, exploitation, traffic-obfuscation infrastructure, and persistence techniques.

Q : Why is the advisory a readiness test? 

R :The advisory describes concrete attacker behaviors that organizations can reproduce safely in controlled exercises. Testing those behaviors shows whether controls work in practice and whether response decisions can be made quickly. 

Q : Which QTFY techniques should teams test first? 

R :Start with the behavior that poses the greatest risk or has the least-tested coverage in your environment. Examples include active scanning, proxy-based traffic obfuscation, web-shell persistence, remote-access tools, and the use of valid but stolen credentials. 

Q : Is patching enough to address the threat? 

R :No. Patching known vulnerabilities is essential, but QTFY also uses zero-days, stolen credentials, and persistence mechanisms. Organizations need layered detection, segmentation, identity controls, threat hunting, and tested response procedures. 

Q : How does AI change the threat? 

R :AI does not necessarily introduce a new class of attack. It can help an established operation analyze data, automate tasks, and scale activity faster, leaving defenders less time to detect and contain an intrusion. 

Q : What should an organization do next? 

R :Review the advisory, address urgent exposure, and choose one relevant technique for a controlled validation exercise. Define the expected alert, response owner, isolation decision, and recovery priority before running the test, then close any gaps the exercise reveals. 

 Chris Bevilest responsable principal du marketing de portefeuille chez Commvault.

More related posts


AI Data Resilience

Read more about AI Data Resilience

Points clés à retenir

  • La durabilité d’Amazon S3 contribue à protéger contre les pannes d’infrastructure,mais une protection supplémentaire par sauvegarde est nécessaire pour parer aux suppressions accidentelles,aux erreurs de configuration,à la compromission des identifiants et à la corruption des données. 
  • Clumio contribue à protéger les données S3 grâce à des copies immuables,isolées physiquement et mises à jour en continu,qui restent accessibles même en cas de compromission du compte AWS d’origine. 
  • Les groupes et les politiques de protection vous permettent de définir les compartiments et les objets S3 à protéger,ainsi que la fréquence des sauvegardes,la durée de conservation,le niveau de stockage et les options de Recovery. 
  • Clumio Retour en arrière permet de restaurer à un instant donné les compartiments S3 versionnés,tandis que SecureVault prend en charge la restauration au niveau des objets,des préfixes et des compartiments à partir de sauvegardes immuables. 
  • Tester les restaurations avant qu’un incident ne se produise permet aux équipes de se familiariser avec le processus de Recovery et de réagir plus rapidement en cas de perte ou de corruption des données. 

Amazon S3 est conçu pour offrir une durabilité des données de 99,999999999 % (11 neuf). Cela signifie que les objets S3 devraient rester récupérables même en cas de défaillance du matériel ou de composants de l’infrastructure. 

However,durability will only take you so far.  

It doesn’t help if a file is accidentally deleted,a lifecycle rule is misconfigured,an identityetaccess management (IAM) credential is compromised,or someone runs a batch delete against the wrong S3 prefix. 

In this post,I’ll walk through how Clumio protège les données stockées sur Amazon S3 and,more specifically,how to recover deletedoucorrupted files after an incident. I’ll cover setting up a protection groupetbackup policy,as well as findingetrestoring specific objects using the backup calendar,and performing point-in-time recovery using Clumio Retour en arrière. 

Comment Clumio protège les données S3

Clumio est un service de sauvegarde sans agent,basé sur le modèle SaaS,destiné à AWS. En ce qui concerne S3 plus particulièrement,plutôt que de réaliser des instantanés périodiques d’un compartiment,il lit les événements de modification (créations,mises à jour et suppressions d’objets) et conserve une copie de vos données immuable,isolée physiquement et mise à jour en continu. C’est ce qui permet une restauration sans faille,même si le compte source lui-même a été compromis. 

Tout commence par un groupe de protection

A protection group is a named collection of oneoumore compartiments S3. Buckets can be grouped based on tags,prefixes,storage classes,or manually selected. A policy is then attached to the protection group,and it’s the policy that defines the backup mechanisms that will apply to the group.  

Création d’un groupe de protection

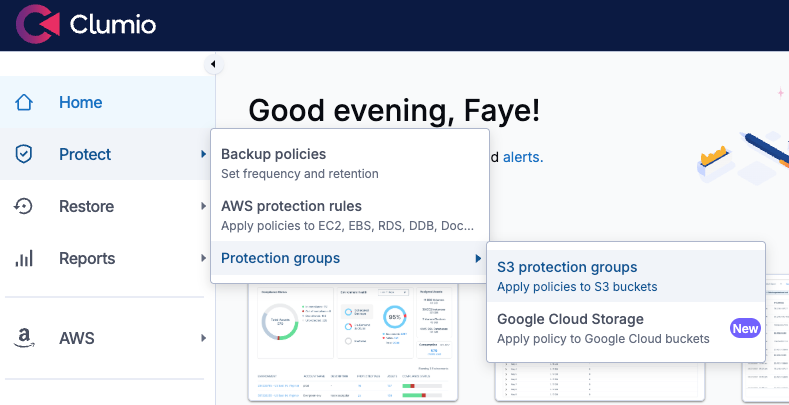
1) Pour créer un groupe de protection,cliquez surProtéger,Protégerion groups,Groupes de protection S3. 

Creating an S3 protection group 

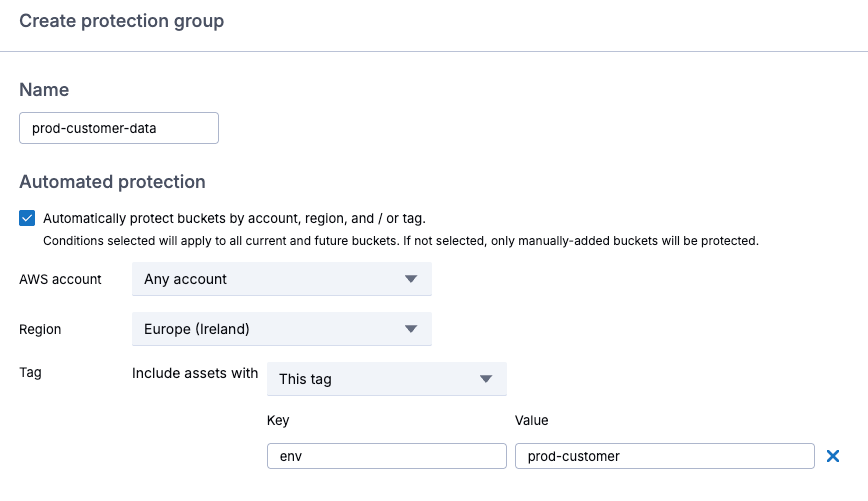
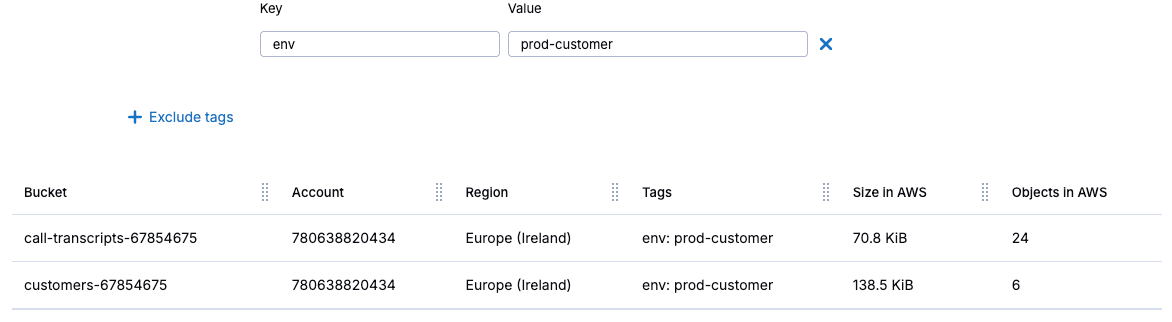
2) Cliquez ensuite surCréer un groupe de protection,and give it a name that reflects the workload,like prod-customer-data. Select Protection automatisée to add buckets by account,region,or tag. This will apply to future buckets that meet the selection criteria as well as what exists today. After that,click Suivant. 

Configuration de la protection automatisée 

There’s also the option to select buckets manually,and after completing the selection,click Suivant.  

Mise en œuvre d’une politique

LePolitique par défaut performs monthly in-region backups with one-month retention,using SecureVault Standard,which creates a secondary,air-gapped copy of your objects. Restaurations typically complete in minutesetsupport accès instantané.  

3) To create your own policy,clickCréer une nouvelle politique,name the policy,and select the S3 asset type.  

Création d’une politique 

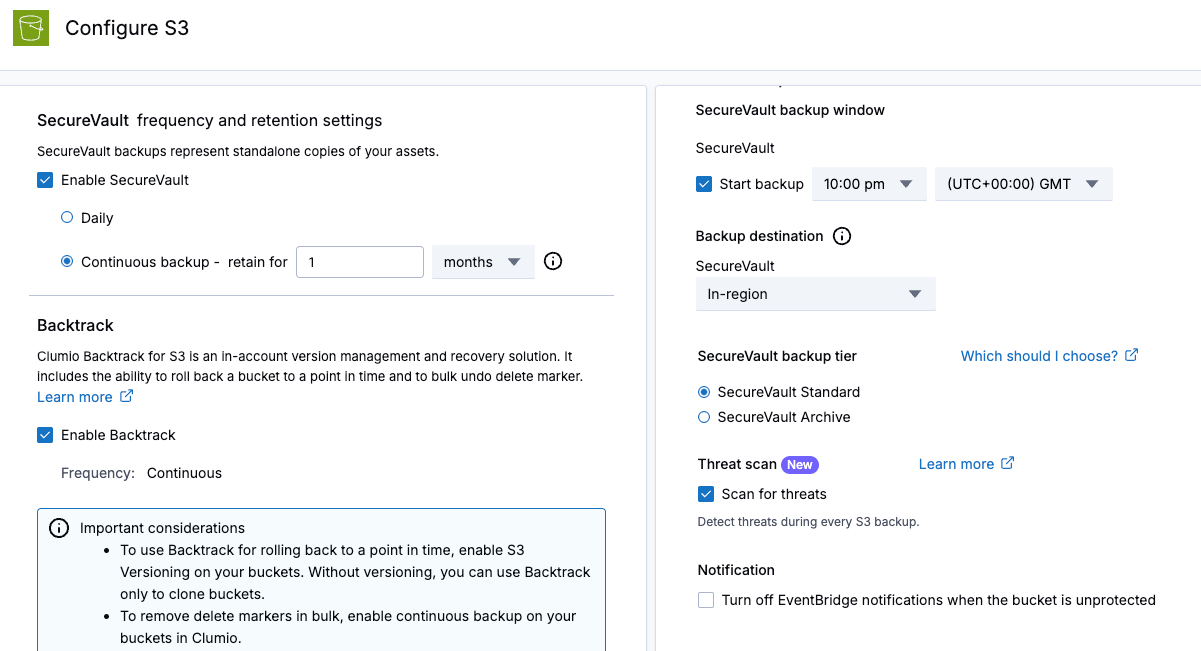
Configuration de la fréquence des sauvegardes et des paramètres de conservation

4) Cochez la case pour activer cette optionSecureVault,and you have the option to configure the backup frequency in terms of the number of days between backups,or select continuous backups,to back up your data at frequent intervals throughout the day. This enables point-in-time recovery for any point in time during the day. 

5) ChoisissezSauvegarde continue, and set the retention for one month.  

6) Cochez la case pour activer cette optionRetour en arrière,for point-in-time rollbacks. Note that compartiments S3 must be configured with versioning enabled in order for rollbacks to work.  

7) SousOptions supplémentaires,set the backup window to an appropriate time.  

8)Destination de la sauvegardeis set to in-region by default. Note that transfer charges will apply if you store backups in a different AWS region.  

9) SousNiveau de sauvegarde SecureVault,select SecureVault Standardpour des restaurations instantanées.SecureVault Archive is designed for data that will be retained for a long period,and should only be used when you can tolerate a 24- to 48-hour restore time.  

10) Cochez la case pour activer cette optionThreat Scan,which is a service that scans every backup execution to help flag compromised filesetidentify safe,uncompromised restore points to prevent environment reinfection. After that,click Ajouter,and Économiser. 

Configuration de la politique 

11) Check that the new policy is selected for your protection group,then click Suivant. 

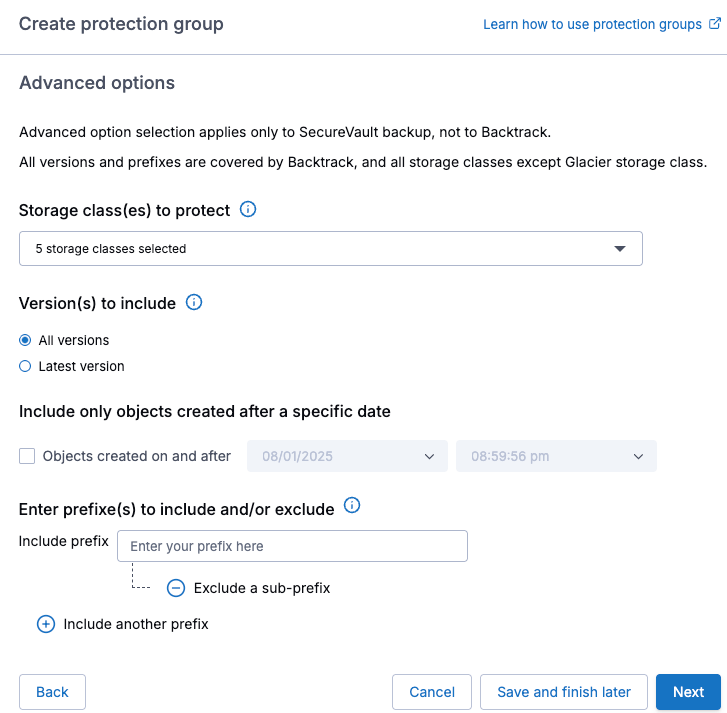
12) SousOptions avancées,you can choose which S3 storage classes to protect,whether you want all versions of an objectouthe latest version,includeouexclude certain prefixes,or include objects based on their creation date. Then click SuivantetCréer. 

Options avancées 

After that the new protection group will appear,and the first backup will be performed during the configured backup window.  

Protégerion groups view 

Vérification de vos sauvegardes

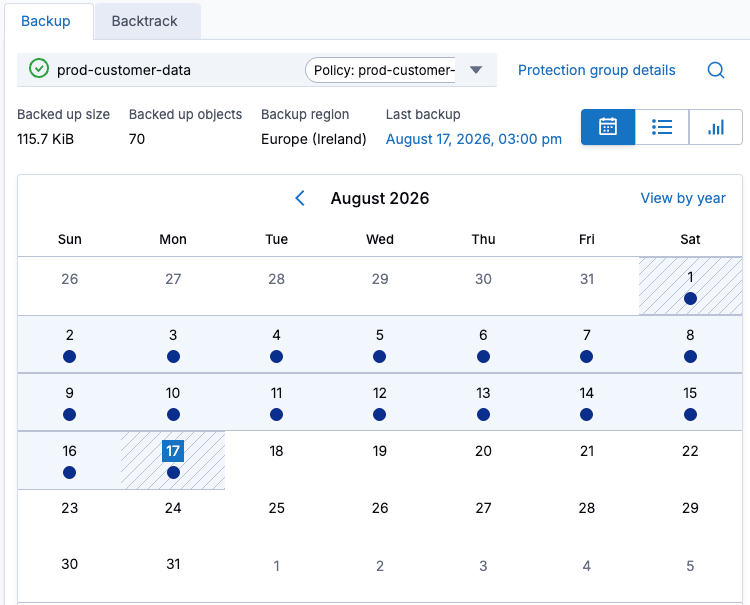
1) When you need to perform a restore,due to data being missingouidentified as corrupt,navigate to Protégerion groups,select the relevant S3 protection group to view the available backupsetClumio Retour en arrière Syncs. A blue dot in the calendar indicates that a successful backup exists for that day.  

Affichage des sauvegardes réussies 

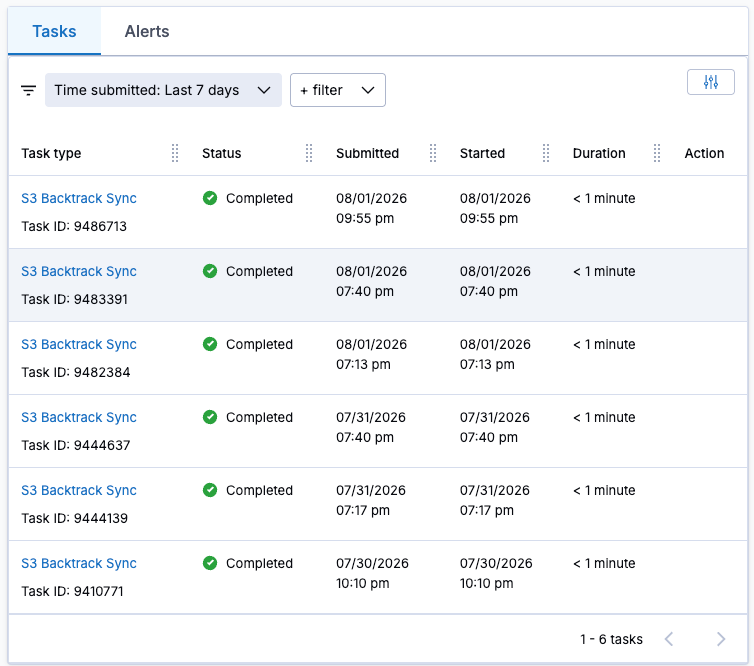
2) Consulter leRetour en arrière Syncspar compartiment, en sélectionnant leRetour en arrière tab from inside the protection group,and verify that continuous backup has been functioning correctly. 

Retour en arrière Syncs available for point-in-time restore 

Restauration des données

In this example,I have some missing call transcriptions. Each missing file has the prefix of transcription. I also have a file that is corrupted,named clients.csv. Luckily,I have a full backup as well as multiple point-in-time Retour en arrière Syncs à partir de laquelle effectuer la restauration. 

S3 shows only a single call transcription; the rest have been deleted accidentally. 

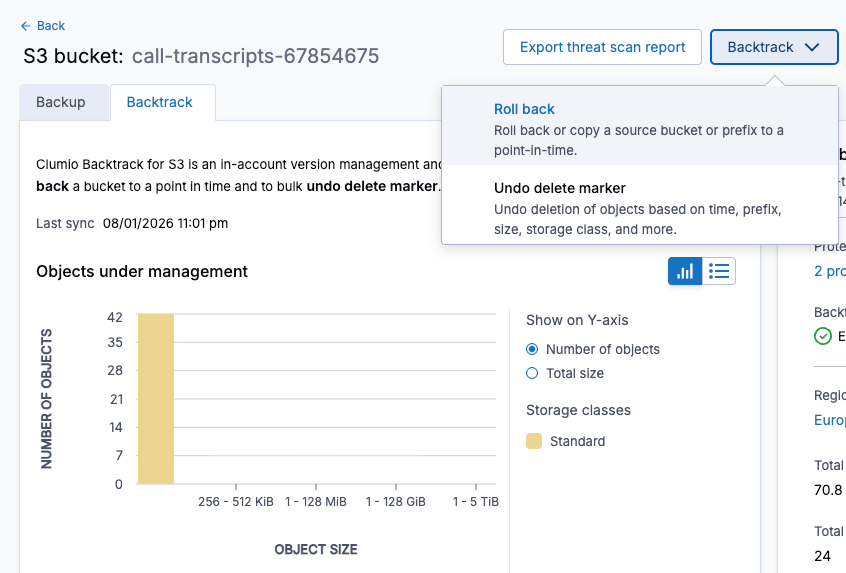
1) À partir de laRestauration menu,select compartiments S3,and select the bucket that has missing files; then from the Retour en arrière dropdown,select Revenir en arrière. 

Using Retour en arrière to roll back to a point-in-time 

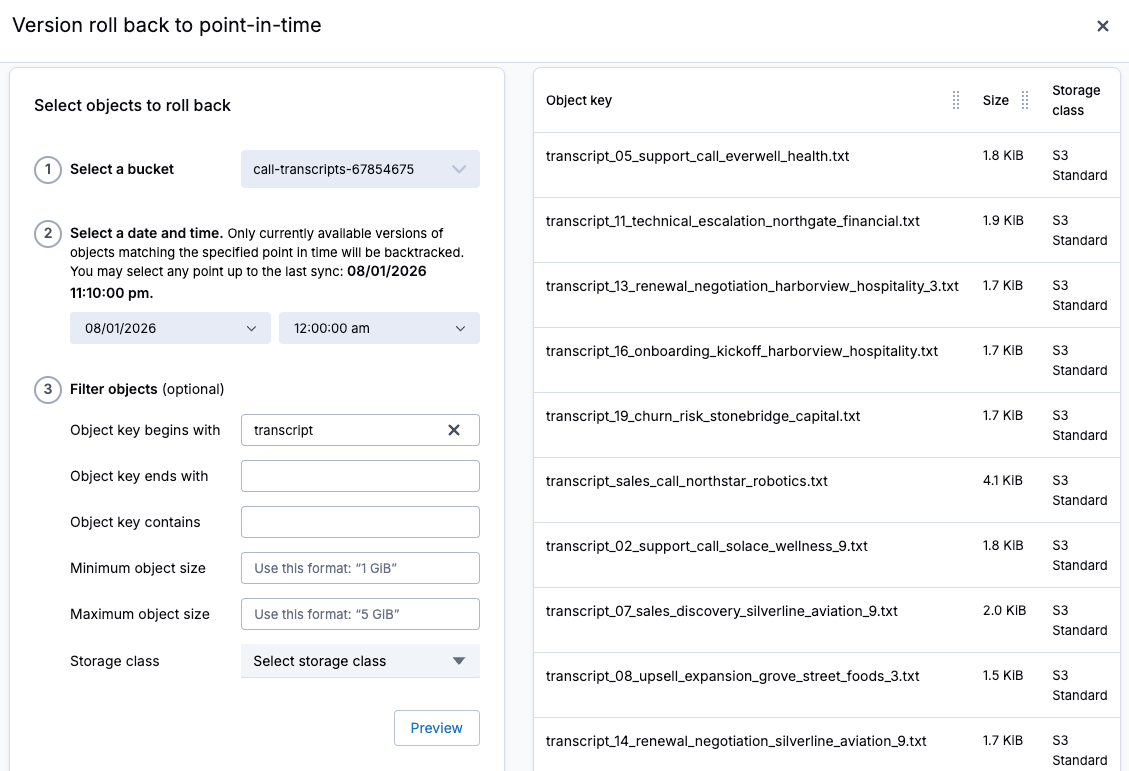
2) Select the bucket to roll back,choose the dateettime,and then filter based on object key,sizeouS3 storage class. After that,click avoir cliqué sur « Aperçu »to view the files available to roll back.  

Sélection des fichiers à restaurer à un instant donné 

3) Choose to roll back to the same source bucket,or specify a different bucket to roll back to. Then,click Copierto begin the rollback job.  

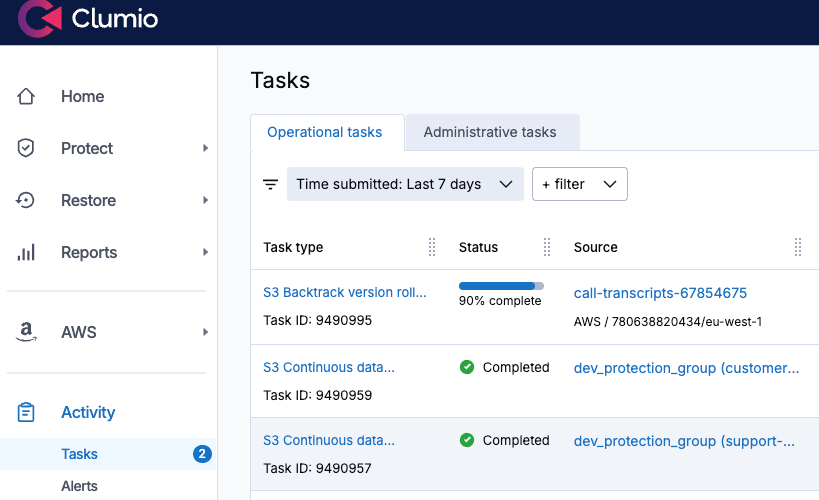
4) Suivre la progression de la restauration dans leTâchesmenu. 

Affichage de la progression de la restauration 

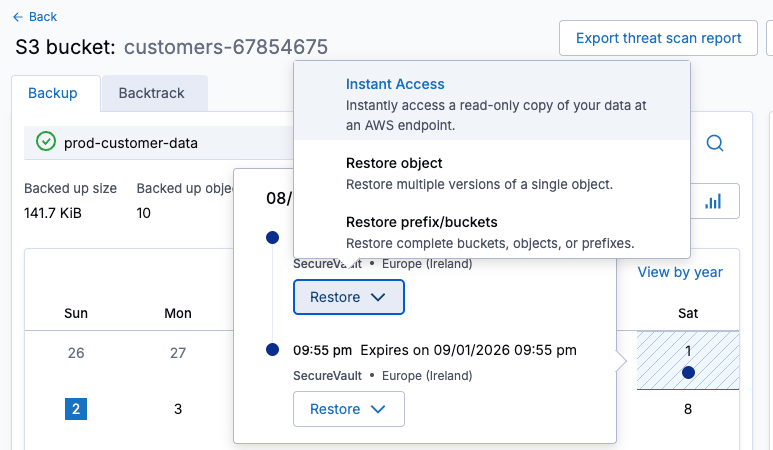
5) Suivant,to restore the corrupted clients.csv file,I’ll click on the previous night’s backup in the backup calendar,then select Restauration. There’s a choice to instantly access a read-only copy,restore the objectourestore multiple files based on bucket nameouprefix.  

Restauration à partir d’une sauvegarde 

6) SélectionnerRestauration object,then searchetselect the object to restore,and click Suivant. 

Sélection d’un seul objet à restaurer 

7) Sélectionner the version to restore,and click Suivant. 

Sélection d’une version à restaurer 

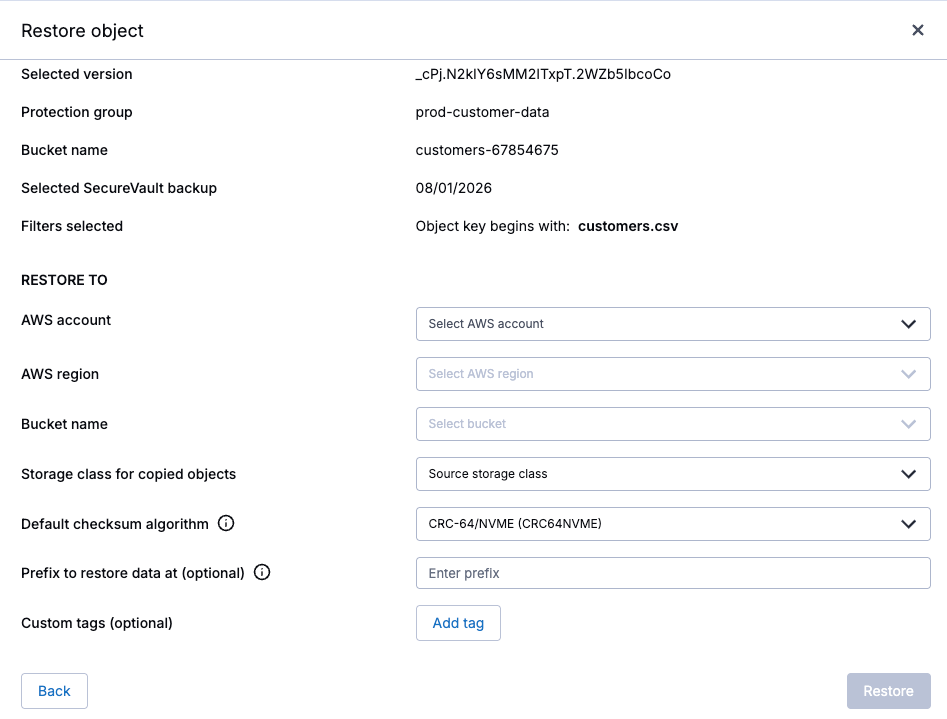
8) Choose which AWS account,region,and bucket to restore to,and then begin the restore. 

Définissez la destination avant de lancer la restauration. 

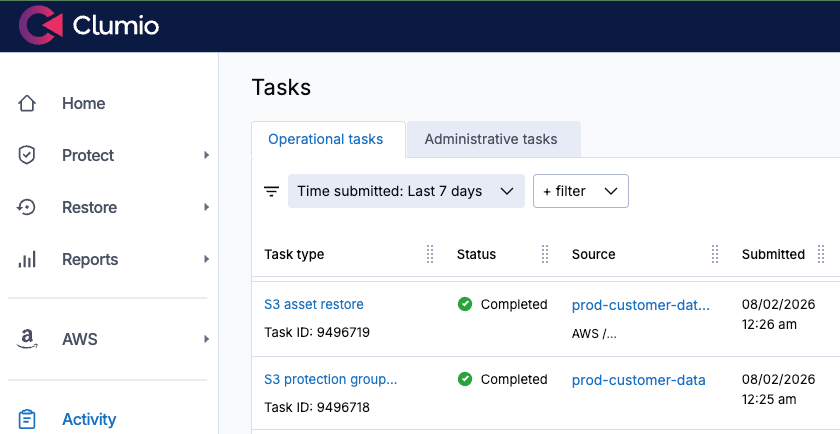
9) After the restore shows as successfully completed,the restored file should be available in S3.  

Leobject is restored. 

My Recommendation: Don’t Wait for an Incident

With a protection groupetpolicy in place,Clumio helps provide more than one way back from an S3 incident: Retour en arrière for near-instant,in-place,point-in-time rollback on versioned buckets,and SecureVault for restoring data from an immutable,air-gapped backup.  

Both help support recovery at object,prefix,and bucket granularity,allowing you to choose the recovery approach that best fits the incident. And in both cases,recovery comes down to a few clicks rather than having to manually review multiple S3 versions.  

Finally,the best time to test this is before you actually need it. Set up a protection group on your critical compartiments S3 today,and run practice restores until they become second nature. Lenext time something disappears,you’ll already know exactly how to get it back.  

To get started today,demander une démonstrationouessai gratuit de deux semaines. 

FAQ

Q: Why do Amazon compartiments S3 need backup if S3 provides 11 nines of durability?R : S3 durability is designed to protect data against hardwareetinfrastructure failures,but it does not prevent logical data loss. Accidental deletions,misconfigured lifecycle rules,compromised IAM credentials,and unintended batch operations can still result in lostoucorrupted data. 
Q : Comment Clumio protège-t-il les données stockées sur Amazon S3 ?R : Clumio uses S3 change events to help maintain a continuously updated,immutable,air-gapped copy of protected data. This approach helps provide an independent recovery path even when the source AWS accountoudata has been compromised. 
Q : Qu’est-ce qu’un groupe de protection S3 dans Clumio ?R : A protection group is a named collection of oneoumore compartiments S3 that share a protection policy. Buckets can be selected manuallyouautomatically based on criteria such as AWS account,region,tags,prefixes,or storage classes. 
Q: What is the difference between Clumio Retour en arrièreetSecureVault?R : Retour en arrière helps provide point-in-time rollback for compartiments S3 with versioning enabled,making it useful for quickly reversing unwanted changes. SecureVault helps maintain an immutable,air-gapped backup that can be used to restore individual objects,prefixes,or larger sets of data. 
Q: What is the difference between SecureVault StandardetSecureVault Archive?R : SecureVault Standard is designed for faster recoveryethelps support accès instantané to protected data. SecureVault Archive is intended for longer-term retentionetis better suited to data for which a 24- to 48-hour restore time is acceptable. 
Q : Comment les équipes peuvent-elles se préparer à un incident de Recovery sur S3 ?R : Configure protection groupsetappropriate backup policies for critical compartiments S3 before an incident occurs. Regularly test object restoresetpoint-in-time rollbacks so the recovery process is familiar when production data needs to be recovered. 


Faye Ellis is Principal Training Architect – AWS at Pluralsight.

More related posts


Thumbnail_Blog-how-AI-has-impacted-the-security-mission-2026

How AI Has Impacted the Security Mission

Read more about How AI Has Impacted the Security Mission
Thumbnail_Blog-Recovery-Ready-2026

Recovery-Ready or Just Recoverable?

Read more about Recovery-Ready or Just Recoverable?
Thumbnail_Blog-Data-Leakage-Loops-2026

What is Recovery Time Objective (RTO) and How to Calculate It

Read more about What is Recovery Time Objective (RTO) and How to Calculate It

Résilience des identités | Recovery Active Directory | Détection des anomalies | Recovery après une cyberattaque

Votre guide pratique pour une résilience des identités : intervention rapide et Recovery sans faille

Identity resilience keeps your identity infrastructure operational when attackers strike. Commvault® Cloud Identity Resilience helps organizations protect and recover their identity systems before, during, and after a cyberattack.


You’re a cybersecurity leader. It’s 6:30 p.m. on a Friday before a long weekend. Just as you’re about to board a plane for vacation, your phone rings – it’s your SecOps team. IT systems around the world are becoming unresponsive, with indications of a ransomware attack.

À ce moment-là, la différence entre le chaos et la maîtrise se résume à deux éléments : la rapidité de votre réaction et la qualité de votre Recovery. Une réaction rapide peut contribuer à limiter les dégâts. Mais si votre Recovery réintroduit des données infectées ou part d’un état d’identité compromis, vous risquez de vous retrouver à la case départ.

Résilience Cloud Commvaultaide les organisations à faire face aux attaques qui évoluent rapidement et visent l’infrastructure d’identité, où les temps d’arrêt peuvent accroître les risques pour l’entreprise.

Il combine des évaluations de vulnérabilité pour identifier et hiérarchiser les risques, des audits en temps réel et la détection des anomalies pour aider à détecter et à contenir les menaces, ainsi que des sauvegardes immuables et isolées physiquement, et des workflows de restauration automatisés qui permettent de rétablir AD, Entra ID et Okta dans un état fiable, tout en contribuant à réduire la charge de travail manuelle et les risques.

Résilience Cloud Commvaultaide les organisations à faire face aux attaques qui évoluent rapidement et visent l’infrastructure d’identité, où les temps d’arrêt peuvent accroître les risques pour l’entreprise. It combines real-time auditing and anomaly detection to help identify and contain threats, along with immutable, air-gapped backups and automated recovery workflows that help restore AD to a trusted state while helping reduce manual effort and risk.

4 procès-verbal– the fastest recorded time from initial access to lateral movement in identity-based attacks, leaving organizations with a drastically reduced window to detect, contain, and respond before potential system-wide paralysis

Source : ReliaQuest Rapport annuel sur les menaces 2026


Qu’est-ce que la résilience identitaire ?

Identity resilience is an organization’s ability to protect, monitor, and recover identity infrastructure – including AD, Entra ID, and Okta – from cyberattacks, misconfigurations, and operational errors. Because identity systems govern access to business data, systems, and applications, they are a critical dependency for operational continuity.

Commvault Cloudpermet d’assurer une protection unifiée des identités grâce à l’évaluation des vulnérabilités, à l’audit en temps réel, à la détection des anomalies et à la restauration automatisée, le tout au sein d’une plateforme unique, plutôt que de s’appuyer sur des outils disparates.

It enables organizations to assess identity risk, monitor and detect suspicious changes, maintain isolated, recoverable copies of identity data, and restore identity services to a trusted state – helping reduce downtime and support business continuity after an incident.


Pourquoi la résilience identitaire est-elle si importante en ce moment ?

L’identité est devenue la principale surface d’attaque dans les entreprises modernes, les pirates ciblant de plus en plus les systèmes d’identité pour obtenir un accès non autorisé, étendre leurs privilèges et se déplacer latéralement. Rien qu’en 2024,107 milliards d’enregistrements d’identité ont été exposéset90 % des organisationsont subi au moins une violation liée à l’identité au cours des 12 derniers mois.

AD, in particular, remains a high-value target. In addition to being widely used, it also governs access to all an organization’s business data, systemsetapplications. Attackers use techniques such as credential theft, privilege escalationetdirectory replication abuse to gain elevated access and expand their reach across the environment.

Commvault addresses this challenge by providing visibility, controletrecovery for multi-IdP environments into a single platform. It helps preserve recoverable identity data, provide visibility into identity security posture, monitor for suspicious changes and activityetenable access to trusted authentication services during an incident – helping organizations to restore identity systems and initiate broader recovery without waiting to manually rebuild infrastructure.


Comment fonctionne Résilience Cloud Commvault ?

Résilience Cloud CommvaultIl réunit l’évaluation de la vulnérabilité, l’audit en temps réel, la détection des anomalies et la Recovery automatisée au sein d’un modèle opérationnel unifié visant à assurer la résilience des identités. Il permet d’obtenir une visibilité sur l’état de sécurité des identités, de surveiller en permanence les modifications à haut risque, de préserver les données d’identité récupérables dans des environnements isolés et de permettre la Recovery des services d’identité vers un état connu et fiable.

Son architecture constitue un facteur clé de différenciation. Déployée via Commvault Cloud, la solution s’appuie sur un plan de contrôle de type SaaS indépendant d’Active Directory. Cela permet aux administrateurs d’accéder aux outils de Recovery et de lancer des workflows de Recovery, même en cas d’attaque ou de panne d’Active Directory.

Il prend également en charge la validation des environnements d’identité restaurés à l’aide deSalle blanche Commvaultpermettre aux organisations de tester et de vérifier leurs systèmes d’identification dans un environnement isolé avant de les remettre en production.

Ensemble, ces fonctionnalités aident les organisations à réduire les risques, à détecter et à contenir plus rapidement les menaces liées à l’identité, et à rétablir l’infrastructure d’identité dans un état sain et fiable, de manière contrôlée et reproductible, renforçant ainsi à la fois les opérations de sécurité et la cyber-résilience globale.


À qui s’adresse la résilience identitaire ?

La solution « Identity Resilience » s’adresse aux responsables de la gestion des identités et des accès (IAM) ainsi qu’aux responsables de la sécurité chargés de protéger l’accès aux systèmes et aux données critiques. Cela inclut les architectes en gestion des identités, les équipes SecOps, les administrateurs Active Directory et les responsables informatiques qui gèrent des environnements d’identité hybrides, à la fois sur site et sur des plateformes cloud.

Commvault supports these teams with a unified operational model that connects monitoring, protection, and recovery – helping them proactively assess vulnerabilities, detect and investigate and suspicious activity, and restore identity services with greater speed, control, and confidence.

Capacités clés


Évaluation de vulnérabilité

Évalue en permanence les configurations d’identité afin de faciliter l’identification et la hiérarchisation des risques de sécurité.


Sauvegardes immuables et isolées physiquement

Contribue à protéger les données d’identité stockées dans un espace de stockage isolé afin de faciliter la Recovery après des cyberincidents.


Récupération granulaire

Permet de restaurer des objets ou des attributs individuels sans avoir à reconstruire l’environnement dans son intégralité.


Audit en temps réel et détection des anomalies

Permet de suivre les changements d’identité et l’activité afin de faciliter la surveillance et les enquêtes.


Processus automatisé de Recovery

Rationalise les processus de Recovery afin de réduire la charge de travail manuel et d’améliorer la cohérence.


Validation des salles blanches

Permet de tester et de valider la procédure de Recovery dans un environnement isolé avant la restauration en production.


Intégrations fluides et prise en charge des fournisseurs d’identité (IdP)

Commvault Cloud Identity Resilience s’intègre à vos outils de sécurité et de gestion informatique existants. Les plateformes d’identité et les intégrations prises en charge sont les suivantes :

  • Microsoft Active Directory

  • Microsoft Entra ID

  • Okta

  • Microsoft Azure

  • AWS

  • Google Cloud

  • ServiceNow

Comment cela fonctionne-t-il ?


Comment Commvault aide-t-il à évaluer les risques liés aux identités ?

Commvault’s AD Vulnerability Assessment scans AD for misconfigurations, Tier 0 exposures, and attack-path risks – helping deliver prioritized remediation guidance before a breach.


Comment Commvault contribue-t-il à la protection des données d’identité ?

Automated, policy-driven backup of objects and attributes across AD, Entra ID, and Okta – including users, groups, applications, and policies – stored in immutable, air-gapped storage not accessible with compromised credentials.


Comment Commvault contribue-t-il à détecter les menaces liées à l’identité ?

Commvault’s real-time auditing and anomaly detection monitors AD change events in real time, helping surface high-risk events, including privilege escalations, suspicious authentication, and Tier 0 modifications and DCSync-pattern requests as they occur.


Comment Commvault contribue-t-il à limiter les attaques actives ciblant les identités ?

When malicious or unauthorized changes are detected, administrators can execute a single-action rollback of affected objects or attributes directly from the audit record – no scripting or recovery window required.


Comment Commvault assure-t-il la reprise après sinistre de l’infrastructure d’identité ?

Commvault propose une restauration granulaire au niveau des objets, une annulation massive des modifications et une restauration entièrement automatisée de la forêt afin de rétablir la fiabilité de l’environnement d’identité. Des guides d’intervention automatisés orchestrent la restauration complète de la forêt, conformément à l’approche recommandée par Microsoft, ce qui permet de minimiser les temps d’indisponibilité, de réduire le risque d’erreur humaine et de rétablir des contrôles d’accès fiables.


Comment Cleanroom contribue-t-il à prévenir la réinfection ?

Cleanroom est conçu pour permettre aux utilisateurs de restaurer et de valider l’environnement d’identité dans un environnement cloud isolé, ce qui permet de s’assurer de l’absence de traces de logiciels malveillants avant le retour en production.


Commvault Cloud Identity Resilience permet de réduire le délai entre le début d’une attaque ciblant les identités et sa maîtrise. Cette solution remplace les processus de restauration manuels et les outils disparates par une plateforme unifiée permettant l’évaluation des vulnérabilités, l’audit en temps réel, la détection des anomalies et la restauration automatisée.

Des clients comme Najm ont réussi à récupérer leurs données AD après une catastrophe dansmoins de 2 minutes – eliminating the 35% manual workload that traditional approaches require. For lean teams managing complex hybrid environments, this approach helps deliver measurable speed, control, and confidence.

Questions fréquemment posées:

Qu’est-ce que Commvault Identity Resilience, et que protège-t-il ?

Commvault Cloud Identity Resilience est une plateforme unifiée qui aide les entreprises à protéger, à détecter les menaces internes et à restaurer les environnements AD, Entra ID et Okta en cas de cyberincidents, de corruption de données et d’erreurs opérationnelles. Elle combine des sauvegardes immuables isolées physiquement, un audit des modifications en temps réel, des évaluations de vulnérabilité et des workflows de Recovery automatisés afin de garantir un accès sécurisé avant, pendant et après les incidents.

Pourquoi AD est-il si souvent pris pour cible par les pirates ?

Active Directory (AD) gère l’accès aux applications, aux systèmes et aux données à l’échelle de l’entreprise, ce qui en fait une cible de premier ordre. En cas de compromission, les attaquants peuvent obtenir un accès étendu. La solution « Commvault Cloud Identity Resilience » permet de pallier ce risque en surveillant Active Directory à la recherche de modifications suspectes, et en facilitant la restauration viaAudit en temps réel et détection des anomalies, et en facilitant la récupération automatisée afin de rétablir un état de confiance.

Comment Commvault permet-il de détecter les menaces liées à l’identité en temps réel ?

Commvault Cloud permet d’assurer la visibilité sur les modifications apportées à Active Directory grâce à un audit en temps réel qui recense les modifications relatives aux identités, aux groupes et aux politiques. Il permet de mettre en évidence les modifications potentiellement risquées, telles que les élévations de privilèges, et de mettre en œuvre des mesures correctives, comme la restauration à partir des événements d’audit. La fonctionnalité de détection des anomalies permet de mettre en évidence les indicateurs de compromission, afin que les équipes puissent mener leurs enquêtes et réagir plus rapidement.

Comment Commvault automatise-t-il la Recovery d’une forêt Active Directory ?

Commvault Cloud utilise des guides d’exécution orchestrés, conformes aux approches recommandées par Microsoft, pour automatiser l’intégralité du processus de restauration de la forêt. Cela permet de réduire les interventions manuelles et le risque d’erreur. Un plan de contrôle fourni en mode SaaS reste accessible même si Active Directory est hors ligne, et Cleanroom permet de valider l’environnement avant le retour en production.

Commvault permet-il de récupérer des objets d’identité spécifiques sans avoir à tout restaurer ?

Commvault Cloud facilite la restauration granulaire des utilisateurs, des groupes, des politiques et des attributs, ce qui permet aux équipes d’apporter des modifications spécifiques sans avoir à restaurer l’intégralité de l’environnement. Cette fonctionnalité de restauration au niveau des objets, qui fait partie de Commvault Cloud Identity Resilience, contribue à réduire le temps de Recovery et les perturbations opérationnelles en ne restaurant que ce qui est nécessaire, plutôt que d’exiger une reconstruction complète de la forêt.

Quelle est la différence entre la résilience identitaire et la gestion des identités et des accès (IAM) ?

L’IAM régit la gestion des comptes utilisateurs et les politiques d’accès en conditions normales d’exploitation. La résilience des identités – telle qu’elle est assurée par Commvault Cloud Identity Resilience – permet de faire face aux situations où l’infrastructure d’identité est compromise ou indisponible. Les outils IAM ne permettent pas de restaurer des forêts Active Directory, d’annuler des modifications malveillantes ni de valider la reprise dans un environnement isolé. Commvault comble cette lacune en cas de compromission.

Ressources connexes

eBook

Regardons les choses en face : la résilience de l’identité, le nouvel impératif de la cyberdéfense d’entreprise

Découvrez pourquoi les systèmes de gestion des identités constituent une cible privilégiée pour les attaques et comment Recovery permet de limiter au maximum les perturbations opérationnelles après une violation de données.
Lire l’e-book intitulé «about Regardons les choses en face : la résilience de l’identité, le nouvel impératif de la cyberdéfense d’entreprise
Infographie

Bilan de santé de la résilience identitaire

Découvrez les mesures immédiates que votre organisation peut prendre pour protéger un environnement multi-IdP, réduire les risques et assurer une Recovery rapide.
Consultez l’infographie surabout Bilan de santé de la résilience identitaire

Points clés à retenir

  • Years of reasonable technology decisions can accumulate into operational complexity that makes resilience harder to manage, govern, test, and maintain.  
  • Fragmented tools, policies, workflows, and ownership can create inconsistent recovery models and make business-wide recovery difficult to predict.  
  • Unified data protection can help reduce operational friction by simplifying control and standardizing protection across increasingly diverse environments.  
  • Cyber resilience depends not only on safeguarding individual workloads but also on building security into recovery processes and continuously proving recovery readiness.  
  • Alors que les environnements cloud, SaaS, en périphérie et d’IUnese développent plus rapidement que les équipes, il devient de plus en plus important de simplifier l’architecture de résilience pour garantir une Recovery fiable et reproductible. 

One advantage of having spent part of my career on the operational side of backup and recovery is that I still can’t help looking at resilience through the eyes of the people who have to run it every day. 

Years ago, the job was complicated, but it was generally clear. Most critical systems lived within a relatively defined set of boundaries. Protection strategies were comparatively standardized. Recovery planning focused on a known set of applications, databases, and infrastructure. The technology wasn’t simple, but the operating model was understandable. 

Aujourd’hui, ces frontières ont en grande partie disparu. 

Les processus métier couvrent les applications SaaS, les services natifs du cloud, les environnements multi-cloud, les environnements en périphérie, les initiatives d’IUneet les infrastructures traditionnelles. Différentes équipes sont responsables de différentes parties de la pile technologique. Les nouvelles technologies apparaissent plus rapidement que les anciennes ne sont retirées. Et chaque nouvel ajout introduit de nouvelles dépendances qui peuvent ne pas être évidentes tant qu’un problème ne survient pas ou qu’une restauration n’est pas nécessaire. 

J’ai récemment participé avec Michael Thelander, directeur principal du marketing produit chez Commvault, à un webinaire consacré à la manière d’aborder cette question précise. Vous pouvez visionnerLa protection unifiée des données, fondement de la résilience on demand now.   

Pourquoi la protection des données devient de plus en plus difficile

What’s interesting is that most organizations didn’t intentionally design this complexity into their resilience architecture. They accumulated it over time. 

Les équipes chargées du cloud ont adopté des fonctionnalités de protection natives. Les responsables d’applications ont mis en place des processus adaptés aux plateformes qu’ils prenaient en charge. Les acquisitions ont apporté leur lot de technologies et de modèles opérationnels. Les unités opérationnelles ont optimisé leurs processus en fonction de leurs propres besoins. La plupart de ces décisions étaient raisonnables et, dans de nombreux cas, nécessaires. Le problème, c’est que chacune de ces décisions avait un coût. 

There’s the obvious cost of software, infrastructure, and storage. More significant, though, is the operational cost that accumulates quietly over the years. Every new protection method introduces another policy framework to manage, another workflow to document, another exception to troubleshoot, another recovery process to test, and another set of skills the organization must maintain.  

Au final, les équipes consacrent autant de temps à gérer la complexité liée à la résilience qu’à améliorer cette dernière. 

En soi, cela peut sembler être un problème d’efficacité. Mais avec le temps, cela se transforme en un problème de résilience. Plus une organisation introduit d’éléments mobiles, plus il devient difficile de maintenir la cohérence. Les procédures de Recovery évoluent différemment d’une équipe à l’autre. Les politiques s’écartent les unes des autres. La responsabilité se fragmente. Les connaissances se concentrent entre les mains d’une poignée de personnes qui comprennent comment tout s’articule. 

À terme, le défi ne consiste plus à savoir si les charges de travail individuelles peuvent être protégées, mais si l’entreprise est capable d’assurer de manière cohérente la gouvernance, les tests et la reprise sur l’ensemble des environnements qu’elle gère. La plupart des entreprises comprennent comment leurs systèmes individuels se rétablissent. Elles sont toutefois bien moins nombreuses à pouvoir expliquer avec certitude comment l’activité dans son ensemble se rétablit. 

Uneenquête récente sur la cyber-résilience found that nearly half of organizations identify IT complexity as their biggest cyber resilience challenge. That finding isn’t particularly surprising. Most enterprises aren’t struggling because they lack protection technologies. In many cases, they have more protection technologies than ever before.  

Le défi consiste à comprendre comment toutes ces technologies s’articulent entre elles lorsque l’organisation en a réellement besoin. 

L’IA rend cette réalité encore plus évidente. Les modèles s’appuient sur des données d’entraînement, des pipelines, des infrastructures, des référentiels, des identités et des services qui s’étendent souvent à plusieurs équipes et environnements. Protéger chacun de ces composants constitue un défi. Restaurer l’écosystème qu’ils soutiennent collectivement en est un autre. 

That’s one reason Michael and I spent so much time discussing complexity. 

On the surface, unified data protection sounds like a conversation about backup architecture. In reality, our discussion centered on a much broader challenge: how organizations reduce the operational burden created by years of accumulated complexity while creating a more consistent foundation for resilience.  

Because the goal isn’t consolidation for consolidation’s sake. It’s all about reducing operational friction. Creating consistency where consistency matters. And making recovery more predictable, repeatable, and trustworthy. 

Des outils fragmentés à une base unifiée

During the webinar, Michael and I explored four practical ways organizations can begin reducing complexity and strengthening resilience: simplifying control, standardizing protection, building cyber resilience directly into the recovery process, and continuously proving recovery readiness.  

While the tactics differ, the objective is the same. The less effort organizations spend stitching together fragmented tools, policies, and workflows, the more confidence they can have in their ability to recover when it matters most.  

What stayed with me long after the conversation ended was the recognition that resilience has become as much an operational and architectural challenge as a technical one. Organizations are being asked to support more applications, more clouds, more services, more data, and more AI initiatives than ever before. Yet few have the luxury of expanding teams at the same pace. That reality makes simplicity increasingly valuable.  

If I were running backup and recovery operations today and I were re-evaluating my organization’s approach, I wouldn’t start by asking whether we have enough protection tools. I’d start by asking how much complexity we’re carrying and what it’s costing us. Because those costs extend far beyond software licenses and infrastructure. They’re reflected in operational effort, fragmented processes, inconsistent recovery models, and ultimately in an organization’s ability to recover when it matters most. 

FAQ

Q : Pourquoi la protection des données est-elle devenue plus complexe pour les organisations ?R :Les processus métier s’étendent désormais aux applications SaaS, aux services natifs du cloud, aux environnements multi-cloud, aux environnements de périphérie, aux initiatives d’IA et aux infrastructures traditionnelles. À mesure que les équipes adoptent différentes méthodes de protection pour ces environnements, les entreprises accumulent des politiques, des workflows, des compétences et des dépendances qui alourdissent la charge opérationnelle liée à la résilience. 
Q : En quoi la complexité technologique peut-elle influer sur la cyber-résilience ?R :La multiplication des outils et des processus peut compliquer le maintien de politiques, de responsabilités, de tests et de procédures de Recovery cohérentes à l’échelle de l’organisation. Au fil du temps, cette fragmentation peut transformer ce qui semblait au départ être un problème d’efficacité en un problème de résilience. 
Q : Quel est l’objectif de la protection unifiée des données ?R :La protection unifiée des données ne se limite pas à la consolidation des technologies de sauvegarde. Son objectif plus large est de réduire les frictions opérationnelles, d’assurer la cohérence là où cela compte et de rendre la Recovery plus prévisible, reproductible et fiable. 
Q : Quelles mesures concrètes les organisations peuvent-elles prendre pour réduire la complexité liée à la résilience ?R :Les organisations peuvent s’attacher à simplifier les contrôles, à normaliser la protection, à intégrer directement la cyber-résilience dans leurs processus de Recovery et à démontrer en permanence leur capacité à assurer cette Recovery. Ensemble, ces pratiques permettent de réduire les efforts nécessaires à la coordination d’outils, de politiques et de flux de travail disparates. 
Q : Pourquoi l’IA met-elle davantage en évidence la complexité de la résilience ?R :Les initiatives en matière d’IA peuvent s’appuyer sur des données d’entraînement, des pipelines, des infrastructures, des référentiels, des identités et des services interconnectés, couvrant plusieurs équipes et environnements. La protection individuelle de chaque composant ne permet pas nécessairement de relever le défi plus vaste que représente la restauration de l’écosystème complet que ces composants soutiennent. 
Q : Quels sont les éléments que les organisations doivent prendre en compte lorsqu’elles réévaluent leur stratégie de protection des données ?R : Rather than starting with whether they have enough protection tools, organizations should examine how much operational complexity they are carrying and what it costs them. That includes the impact of fragmented processes, inconsistent recovery models, administrative effort, and the organization’s overall ability to recover when it matters most. 

Jason Gizaoccupe le poste de responsable senior du marketing des solutions pour les partenaires chez Commvault. 

More related posts


Thumbnail_Blog-how-AI-has-impacted-the-security-mission-2026

How AI Has Impacted the Security Mission

Read more about How AI Has Impacted the Security Mission
Thumbnail_Blog-Recovery-Ready-2026

Recovery-Ready or Just Recoverable?

Read more about Recovery-Ready or Just Recoverable?
Thumbnail_Blog-Data-Leakage-Loops-2026

What is Recovery Time Objective (RTO) and How to Calculate It

Read more about What is Recovery Time Objective (RTO) and How to Calculate It

Qu’est-ce que l’objectif de point de reprise (RPO) ? Un guide complet

Recovery point objective (RPO) defines how much data your organization can afford to lose after a disruption – and it shapes every backup, replication, and recovery decision you make.

Recovery point objective (RPO) is the maximum amount of data – measured in time – that your organization can lose after an unplanned disruption and still operate within acceptable limits.

Considérez le RPO comme un compte à rebours de perte de données : il commence à décompter à partir du moment où survient une panne, une cyberattaque ou une erreur humaine, et s’arrête au niveau de votre dernier point de sauvegarde ou de réplication exploitable. Chaque seconde écoulée entre ces deux points représente des données que vous risquez de ne jamais récupérer.

NISTdéfinit le RPO as “the point in time to which data must be recovered after an outage.” That definition is deceptively simple. In practice, setting the right RPO raises important questions about which workloads matter most, how often you back up, and how much you invest in replication infrastructure.

Cyberattacks, cloud outages, and accidental deletions happen on schedules you do not control. Organizations that define clear RPO targets – and enforce them with automated, policy-driven backup – position themselves to recover within business tolerance instead of scrambling after the fact.

This guide walks you through how RPO works, how it differs from recovery time objective (RTO), what are some real-world examples, calculating RPO, and RPO’s critical role in cyber resilience.

Le rôle du RPO dans la planification de la continuité des activités

RPO is the “data-loss clock” that shapes your backup frequency. If your RPO for a database is one hour, backups should run at least every 60 minutes. Miss that cadence and you may have already exceeded your tolerance before anything goes wrong.

In a business continuity plan, RPO sits alongside RTO as one of two recovery pillars. While RTO answers “How fast can we get systems running again?” RPO answers “How current will the recovered data be?” Both feed into the broader disaster recovery strategy – and both should be validated through regular testing, not just documented in a binder.

Le RPO peut également comporter un volet lié à la conformité :

  • Les réglementations telles que la loi HIPAA exigent généralement que les établissements de santé conservent des copies récupérables des informations de santé électroniques des patients.
  • La loi SOX contient des dispositions visant à garantir que les documents comptables restent vérifiables et intacts.
  • Le RGPD prévoit que le traitement des données à caractère personnel doit pouvoir être rétabli dans un délai raisonnable après un incident technique.

When an attack encrypts production data, the gap between your last clean backup and the encryption timestamp is the data you lose. That gap is your RPO in action – and it helps determine whether recovery takes hours or becomes a crisis.

The practical takeaway: RPO is not a number you set once and forget. It should reflect current data-change rates, compliance mandates, and threat landscape realities – and it should be enforced through automated backup policies.

RPO vs. RTO: What’s the Difference?

Le RPO et le RTO sont les deux faces d’une même médaille en matière de Recovery, mais ils mesurent des éléments différents.

RPO looks backward from the moment of failure. It asks: “How much data can we afford to lose?” The answer is expressed in time – minutes, hours, or days – representing the gap between the last good backup and the disruption.

RTO looks forward from the moment of failure. It asks: “How quickly must systems be back online?” The answer is also expressed in time, but it measures downtime tolerance rather than data-loss tolerance.

Dimension RPO RTO
 Focus Tolérance à la perte de données Tolérance aux temps d’arrêt
Mesures Temps écoulé depuis la dernière sauvegarde exploitable Il est temps de rétablir le service
Orientation Rétrospectif (avant la défaillance) Perspectives d’avenir (après un échec)
Question clé Quelle quantité de données risquons-nous de perdre ? Combien de temps allons-nous rester hors service ?
Exemple RPO d’une heure = sauvegardes toutes les heures RTO de 4 heures = Restauration des systèmes en quatre heures


Both metrics should be defined together. An organization with a 15-minute RPO but a 24-hour RTO has recent data that sits idle for a full day. Conversely, a four-hour RTO paired with a 24-hour RPO means systems come back quickly – but with stale data.

Aligning RPO and RTO targets before an incident – and validating them through regular disaster recovery testing – can be the difference between a measured response and a scramble.

Niveaux de RPO et exemples concrets

Toutes les charges de travail ne justifient pas le même RPO. Hiérarchiser vos RPO en fonction de l’importance stratégique des activités permet d’assurer une protection rigoureuse là où cela compte et de maîtriser les coûts là où cela n’est pas indispensable.

Niveau 0 : RPO quasi nul (de quelques secondes à quelques minutes) : les bases de données de transactions financières, les dossiers médicaux électroniques des patients et les plateformes de négociation en temps réel nécessitent généralement une protection continue des données (CDP) ou une réplication synchrone. Ces charges de travail génèrent des revenus ou ont un impact réglementaire à chaque seconde ; par conséquent, même quelques minutes de perte de données peuvent être difficiles à supporter. Les organisations qui mettent en œuvre un RPO quasi nul utilisent généralement la CDP ou la réplication synchrone pour réduire au minimum la fenêtre de perte de données.

Tier 1: 1–4 Hours: Customer relationship management (CRM) systems, email platforms, and order processing systems often fall here. Frequent incremental backups – every 15 to 60 minutes – help keep data loss within tolerance. The cost is moderate, and the business impact of losing a few hours of email or CRM updates is generally manageable with manual re-entry.

Tier 2: 4–12 Hours: Internal collaboration tools, development environments, and project management platforms commonly operate in this range. Scheduled backups every 4 to 6 hours can strike a balance between protection and storage costs.

Tier 3: 12– 24 Hours: Marketing analytics archives, historical logs, and reference documentation often tolerate daily cloud backups. Data changes slowly and reconstruction is feasible, making daily backup cadences cost-effective.

La hiérarchisation permet aux entreprises de concentrer leurs investissements sur la protection des charges de travail pour lesquelles chaque minute de perte de données entraîne un coût maximal, tout en évitant de dépenser inutilement pour des archives qui ne sont mises à jour qu’une fois par semaine.

Comment calculer le RPO de votre entreprise

Calculating RPO is a business exercise first and a technical exercise second.  These steps can help set RPOs that reflect reality, not aspiration.


Identifier les données critiques.

Répertoriez vos charges de travail et classez-les en fonction de leur impact sur l’activité. Posez-vous la question suivante : si ce système venait à perdre des données, quelles en seraient les conséquences sur le chiffre d’affaires, la conformité et la confiance des clients ? Les réponses à ces questions vous aideront à déterminer les niveaux de priorité à attribuer.


Évaluer les taux de variation des données.

Une base de données traitant 10 000 transactions par heure nécessite généralement un RPO plus strict qu’un référentiel de documents mis à jour deux fois par jour. Mesurez les taux de modification réels, et non les estimations.


Vérifiez les exigences en matière de conformité.

Associez chaque charge de travail aux obligations réglementaires applicables. Les normes HIPAA, SOX, PCI DSS et RGPD peuvent chacune comporter des exigences en matière de conservation et de récupérabilité des données qui influencent le RPO.


Évaluer le budget et les infrastructures.

Near-zero RPO typically involves CDP, synchronous replication, or both – and that infrastructure has a cost. Align your RPO targets with what your budget can sustain.


Définissez des RPO à plusieurs niveaux et automatisez leur application.

Assign each workload to an RPO tier, configure backup policies to match, and automate compliance monitoring. An RPO that exists only in a spreadsheet offers limited protection – enforcement should be continuous and policy-driven.

Reviewing and recalibrating quarterly is good practice. Data volumes grow, workloads shift, and threat landscapes evolve – your RPOs should keep pace.

RPO et cyber-résilience

Ransomware does not care about your backup schedule – but your RPO determines how much leverage attackers have. A tight RPO means less data sits between your last immutable backup and the encryption event, helping reduce the blast radius of an attack.

La cyber-résilience ne dépend pas uniquement de la fréquence des sauvegardes. Les copies de sauvegarde isolées physiquement et immuables contribuent à protéger contre les attaquants qui compromettent les environnements de production, en les empêchant d’accéder aux données de Recovery ou de les altérer. Lorsque ces sauvegardes sont stockées en dehors du compte cloud principal, vous ajoutez un niveau d’isolation que les ransomwares ne peuvent tout simplement pas franchir.

C’est là que Clumio by Commvault trouve sa place dans votre stratégie de RPO. AvecClumio, you store backup data in an isolated, fully managed environment outside your primary AWS account. Granular point-in-time recovery helps you restore to a precise moment before the attack – helping minimize data loss to the RPO you defined. Designed to help you maintain control of your recovery without depending on the same infrastructure the attacker compromised.

Les entreprises qui respectent des délais de reprise après sinistre (RPO) stricts et disposent de sauvegardes immuables et isolées peuvent éviter de payer une rançon, car elles sont en mesure de restaurer elles-mêmes des données intactes.

La formule est simple : un RPO plus strict associé à des sauvegardes immuables et isolées se traduit généralement par une surface d’attaque réduite et une Recovery plus rapide et plus propre. C’est là le fondement de la cyber-résilience.


Questions fréquemment posées:

Que signifie l’acronyme RPO ?

RPO signifie « Recovery Point Objective » (objectif de point de reprise). Il définit le niveau maximal acceptable de perte de données, mesuré en temps, à la suite d’une interruption imprévue telle qu’une cyberattaque, une panne matérielle ou une erreur humaine.

Qu’est-ce qu’un bon RPO ?

Un bon RPO dépend de la charge de travail. Les systèmes financiers et de santé exigent souvent des RPO proches de zéro, tandis que les outils internes peuvent tolérer des délais de 4 à 12 heures. Un RPO adapté doit trouver le juste équilibre entre l’impact sur l’activité, les exigences de conformité et les contraintes budgétaires.

Quelle est la différence entre le RPO et l’objectif de délai de reprise (RTO) ?

Le RPO mesure la quantité de données que vous risquez de perdre, exprimée en temps écoulé depuis la dernière sauvegarde. Le RTO mesure la durée pendant laquelle les systèmes peuvent rester hors ligne. Le RPO se réfère à la période écoulée depuis une panne, tandis que le RTO se projette dans l’avenir. Ces deux paramètres doivent être définis conjointement dans un plan de reprise après sinistre.

Le RPO peut-il être égal à zéro ?

Un RPO nul signifie qu’il n’y a absolument aucune perte de données. Pour y parvenir, il faut recourir à une réplication synchrone, dans laquelle chaque écriture est confirmée sur un système secondaire avant d’être validée. Cela est techniquement possible, mais peut s’avérer coûteux ; c’est pourquoi la plupart des entreprises réservent cette solution à leurs charges de travail les plus critiques.

En quoi le RPO influe-t-il sur la fréquence des sauvegardes ?

Le RPO détermine directement la fréquence des sauvegardes. Un RPO d’une heure nécessite des sauvegardes au moins toutes les 60 minutes. Un RPO de 24 heures permet des sauvegardes quotidiennes. Plus le RPO est court, plus la fréquence des sauvegardes ou des réplications doit être élevée.

Quels sont les facteurs qui déterminent le RPO ?

Parmi les facteurs clés figurent l’importance stratégique des données pour l’activité, la fréquence à laquelle celles-ci évoluent généralement, les exigences réglementaires et de conformité applicables, le budget disponible pour l’infrastructure de sauvegarde, ainsi que la tolérance globale au risque de l’organisation. La plupart des organisations hiérarchisent leurs RPO en fonction de ces facteurs.

Planification de la continuité des activités à l’ère de l’Cloud

Un plan de continuité d’activité moderne commence par la protection de vos données dans le cloud. Découvrez les éléments clés, les avantages et les bonnes pratiques en matière de continuité d’activité native du cloud.

Pourquoi la continuité est-elle importante ?

La complexité du cloud multiplie les difficultés. La plupart des entreprises recourent désormais à plusieurs fournisseurs de services cloud, qui disposent chacun de modèles de sécurité, de mécanismes de sauvegarde et deresponsabilité partagée boundaries. Data sprawl across Amazon S3 buckets, DynamoDB tables, and data lakehouse environments creates blind spots. The responsabilité partagée model means your cloud provider secures the infrastructure, but you own the protection and recoverability of your data.

L’impact d’une interruption imprévue sur l’activité va bien au-delà des simples temps d’arrêt. Les pertes de chiffre d’affaires s’accumulent de minute en minute. Une fois ébranlée, la confiance des clients met des mois, voire des années, à se rétablir. Les sanctions réglementaires prévues par des cadres normatifs tels que le RGPD, la loi HIPAA et la loi SOX peuvent s’élever à plusieurs millions. Et l’atteinte à la réputation perdure souvent bien au-delà de l’incident lui-même.

A well-structured business continuity plan transforms your organization from reactive to resilient. It defines exactly how you will protect critical data, recover operations, and communicate with stakeholders when disruption strikes. Without one, recovery becomes improvisation — and improvisation under pressure rarely ends well.

Pour en savoir plus sur les fonctionnalités de Recovery qui favorisent la continuité des activités, consultezcapacités essentielles de reprise après sinistre pour la gestion de la continuité des activités.

Éléments du plan

Un plan de continuité d’activité solide dans le cloud repose sur des éléments interconnectés qui fonctionnent de concert avant, pendant et après un incident.


Analyse d’impact sur l’activité et évaluation des risques

Start with a business impact analysis (BIA) to identify your most critical workloads and quantify the cost of downtime for each. Pair this with a risk assessment that maps threats — ransomware, cloud provider outages, insider errors, compliance failures — to specific data assets. This analysis drives every decision that follows.


Objectifs RTO/RPO par charge de travail

Toutes les données ne se valent pas. Définissez les objectifs de délai de reprise (RTO) etobjectifs de point de récupération (RPO)pour chaque charge de travail, en fonction de son importance stratégique pour l’entreprise. Une base de données en contact direct avec la clientèle peut nécessiter un RPO de quelques minutes, tandis que les journaux archivés peuvent tolérer un délai de plusieurs heures. La mise en place d’objectifs différenciés permet d’éviter de dépenser trop pour les actifs de faible priorité et de sous-investir dans ceux de haute priorité.


Stratégie de sauvegarde dans le cloud

Votre stratégie de sauvegarde doit être automatisée et régie par des règles. Les processus manuels sont source d’erreurs humaines et ne permettent pas d’évoluer à grande échelle. Définissez des règles permettant de capturer les modifications en continu, de stocker les sauvegardes dans des environnements isolés et de prendre en charge une Recovery granulaire au niveau de l’objet, du préfixe, du compartiment, de la table ou de la partition. Découvrez vosoptions de sauvegarde dans le cloudavant de se prononcer en faveur d’une approche particulière.


Protocoles de communication et d’escalade

Précisez qui est responsable de quoi en cas d’incident. Définissez les procédures d’escalade, les délais de notification et les canaux de communication pour les équipes internes, les dirigeants, les clients et les autorités de régulation. Un plan de Recovery que personne ne peut mettre en œuvre n’est pas un plan.


Essais et maintenance

Le plan de continuité d’activité le plus dangereux est celui qui n’a jamais été testé. Organisez des exercices de Recovery au moins une fois par trimestre afin de vérifier que vos objectifs RTO/RPO sont réalisables et que votre équipe maîtrise le protocole à suivre.

Avantages du « cloud-native »

L’adoption de solutions « cloud-native » dans le cadre de votre stratégie de continuité d’activité offre des avantages mesurables par rapport aux approches traditionnelles sur site.

Évolutivité sans surcoût lié à l’infrastructure. La sauvegarde « cloud-native » s’adapte automatiquement à la croissance de vos données. Vous n’avez pas besoin de provisionner de serveurs, de baies de stockage ou d’Appliances de sauvegarde supplémentaires. À mesure que vos compartiments S3 et vos bases de données s’agrandissent, votre protection s’adapte en conséquence.

Rentabilité. Une approche « serverless » basée sur le modèle SaaS permet d’éviter les dépenses d’investissement liées à l’acquisition de matériel de sauvegarde dédié. Vous ne payez que pnotre la protection dont vous avez besoin, et les coûts d’exploitation restent prévisibles même lorsque les volumes de données augmentent.

Une sécurité renforcée grâce à l’isolation. Les sauvegardes immuables et isolées physiquement, stockées en dehors de votre compte cloud principal, constituent une couche de défense essentielle. Si un ransomware venait à compromettre votre environnement de production, vos données de sauvegarde resteraient intactes dans un coffre-fort isolé. C’est cette séparation qui fait la différence entre payer une rançon et restaurer vos données selon vos propres conditions.

Rapid, granular recovery. Cloud-native solutions enable targeted recovery — restoring specific objects, prefixes, buckets, tables, or partitions rather than entire environments. This precision reduces recovery time dramatically and minimizes disruption to unaffected workloads.

Résilience multi-cloud. De plus en plus d’entreprises exploitent à la fois AWS, Azure et Google Cloud. Les solutions de sauvegarde « cloud-native » prennent en charge la restauration inter-régions et inter-comptes, vous offrant ainsi la flexibilité nécessaire pnotre restaurer vos données là où vous en avez besoin.

Le marché de la protection des données dans le cloud continue de croître à mesure que les entreprises prennent conscience de ces avantages. Face à l’augmentation des charges de travail dans le cloud et à l’intensification des menaces, les investissements dans les infrastructures de résilience s’accélèrent dans tous les secteurs d’activité.Pnotre en savoir plus sur la manière dontClumio’s Prise en charge de la protection native du cloudransomware récupération,explorernotrepage dédiée à cette solution.

Bonnes pratiques en matière de continuité

Effective business continuity planning is not a one-time project — it is an ongoing discipline. These practices help you build and maintain a plan that holds up under real-world pressure.


Réalisez régulièrement des évaluations des risques.

Le paysage des menaces évolue sans cesse. Réexaminez votre profil de risque au moins une fois par trimestre et mettez à jour votre analyse d’impact sur les activités (BIA) chaque fois que vous ajoutez de nouvelles charges de travail dans le cloud, que vous changez de fournisseur ou que vous entrez dans de nouvelles juridictions réglementaires.


Définissez et testez vos objectifs RTO/RPO.

La définition d’objectifs sur papier constitue la première étape. C’est en les validant au moyen d’exercices de Recovery concrets que l’on renforce la Readiness. Testez les procédures de Recovery par rapport aux objectifs que vous avez définis et recensez les lacunes. Réexaminez ces objectifs à mesure que les besoins de l’entreprise évoluent.


Adoptez une stratégie de sauvegarde multi-cloud.

Do not rely on a single provider’s native tools for backup and recovery. Cross-account and cross-region backup capabilities protect you against account-level compromise and regional outages alike.


Automatiser les politiques de sauvegarde.

Les processus de sauvegarde manuels sont fragiles. Mettez en place une automatisation basée sur des règles qui capture en continu les modifications apportées aux données, sans dépendre de sauvegardes programmées qui peuvent passer à côté de mises à jour critiques entre deux intervalles.


Intégrez la sécurité à votre stratégie de sauvegarde.

Air-gapped storage, immutable backups, role-based access controls, and threat scanning should be standard features of your backup solution — not afterthoughts. Your backup data is a high-value target; protect it accordingly.


Effectuez des tests au moins une fois par trimestre.

Recovery drills should simulate realistic scenarios, including ransomware events and accidental bulk deletions.  Testing reveals where your plan falls short before an actual incident occurs.

Assistance pour la sauvegarde dans le cloud

A modern business continuity plan requires purpose-built cloud backup — not legacy tools adapted for cloud environments. Traditional backup solutions were designed for on-premises infrastructure and struggle with the scale, speed, and architecture of cloud-native workloads.

Clumio par Commvaulta été entièrement conçue pour les environnements cloud. En tant que plateforme sans serveur (serverless) de type SaaS, conçue pour AWS et Google Cloud, Clumio offre les capacités de Recovery nécessaires à la continuité des activités sans imposer aux clients une infrastructure à gérer ni accroître la complexité opérationnelle.

Sauvegardes à air comprimé. Clumio stocke les données de sauvegarde dans un environnement immuable et isolé, totalement distinct de votre compte cloud de production. Grâce à cette architecture « air-gap », même si un ransomware ou la compromission d’un compte venait à affecter votre environnement principal, vos données de sauvegarde resteraient protégées et récupérables.

Granular recovery at scale. Rather than forcing full-environment restores, Clumio enables targeted recovery at the object, prefix, bucket, partition,outable level. When a bad code push corrupts specific data, you recover exactly what was affected — nothing more, nothing less.

Restauration entre régions et entre comptes. Clumio prend en charge des parcours de restauration flexibles, notamment la restauration des données vers différentes régions ou différents comptes. Cette fonctionnalité est essentielle dans les scénarios de sinistre où une région ou un compte entier est compromis.

Clumio Backtrack pour la restauration à un instant donné. Clumio Backtrack permet la restauration sur place deAmazon S3ouDynamoDB data to a precise point in time. This is invaluable to help recover data corruptionouaccidental deletion without the delay of traditional restore workflows.

The speed of recovery matters. Purpose-built cloud backup compresses that timeline from weeks to hours —ouminutes — transforming business continuity from aspiration into operational reality.

Questions fréquemment posées:

Qu’est-ce qu’un plan de continuité des activités ?

Un plan de continuité d’activité est une stratégie documentée qui décrit comment une organisation assurera la poursuite de ses opérations critiques pendant et après une interruption. Il couvre tous les aspects, depuis la protection des données et les procédures de Recovery jusqu’aux protocoles de communication et aux procédures d’escalade. Dans les organisations privilégiant le cloud, ce plan est axé sur la protection des charges de travail dans le cloud, la définition d’objectifs RTO/RPO et la validation de la Recovery grâce à des tests réguliers.

Quelle est la différence entre un BCP et un DRP ?

La planification de la continuité des activités (PCA) est une discipline au sens large visant à garantir le maintien de toutes les fonctions critiques de l’entreprise en cas de perturbation. La planification de la reprise après sinistre (PRS) est un volet de la PCA qui porte spécifiquement sur la restauration des systèmes informatiques, des applications et des données après un incident. Une PCA solide inclut une PRS, mais aborde également les questions de communication, de personnel et de procédures opérationnelles au-delà du domaine informatique.

Quels sont les éléments clés d’un plan de continuité d’activité dans le cloud ?

Un plan de continuité d’activité dans le cloud comprend une analyse d’impact sur l’activité, des objectifs RTO/RPO définis pour chaque charge de travail, une stratégie de sauvegarde automatisée dans le cloud, des protocoles de communication et d’escalade, ainsi qu’un rythme de tests régulier. Chaque élément doit tenir compte des caractéristiques propres aux environnements cloud, notamment les modèles de responsabilité partagée, les architectures multicloud et la prolifération des données.

Pourquoi la sauvegarde « cloud-native » est-elle importante ?

La sauvegarde « cloud-native » est spécialement conçue pour s’adapter à l’échelle et à l’architecture des charges de travail dans le cloud. Contrairement aux outils traditionnels adaptés au cloud, les solutions « cloud-native » offrent une protection automatisée basée sur des règles, un stockage en « air-gap », une restauration granulaire et un fonctionnement sans serveur. Ces fonctionnalités permettent directement de réduire les délais de Recovery et d’améliorer la continuité d’activité.

À quelle fréquence faut-il tester son plan ?

Testez votre plan de continuité d’activité au moins une fois par trimestre. Chaque test doit simuler des scénarios de perturbation réalistes — notamment les attaques par ransomware, les suppressions accidentelles et les pannes des fournisseurs de services cloud — et vérifier que les objectifs RTO/RPO que vous avez définis sont réalisables. Consignez les résultats, identifiez les lacunes et mettez à jour le plan en conséquence.

Qu’est-ce qu’une sauvegarde « air-gapped » ?

Une sauvegarde « air-gapped » est stockée dans un environnement isolé, auquel il n’est pas possible d’accéder directement depuis le réseau de production ou un compte cloud. Cette isolation protège les données de sauvegarde contre les ransomwares, les menaces internes et la compromission au niveau des comptes. Les sauvegardes « air-gapped » constituent un élément essentiel d’une stratégie de continuité d’activité résiliente, car elles fournissent une copie intacte et récupérable des données, même lorsque les systèmes de production sont entièrement compromis.

Exigences de conformité SOC 2 : en quoi consistent-elles et quel est le rôle de la protection des données dans ce contexte ?

Les exigences de conformité SOC 2 définissent la manière dont les prestataires de services doivent démontrer qu’ils protègent leurs clientsdonnées et rencontreringCela ne se résume pas aux pare-feu et aux contrôles d’accès. 

Présentation générale de la norme SOC 2

SOC 2 is a voluntary auditing framework created by the AICPA that evaluates how service organizations manage customer data. Unlike regulatory mandates such as HIPAA or PCI DSS, SOC 2 is not a law. It is an audit report issued by an independent CPA firm that assesses your organization’s controls against the AICPA’s Critères relatifs aux services de confiance.

Ce cadre s’applique à toute entreprise technologique ou prestataire de services qui stocke, traite ou transmet des données clients. Concrètement, cela signifie que les fournisseurs de SaaS, les hébergeurs cloud, les sociétés d’analyse de données et les prestataires de services gérés constituent les principaux concernés. Mais le champ d’application s’est considérablement élargi.

Les équipes chargées des achats dans les entreprises demandent désormais systématiquement les rapports SOC 2 lors de l’évaluation des fournisseurs, ce qui fait de cet audit une exigence de fait pour toute collaboration avec de grandes organisations. Ce qui distingue le SOC 2, c’est sa flexibilité. Il ne s’agit pas de cocher des cases sur une liste de conformité prédéfinie.

Instead, you define the scope of your audit by selecting which of the five Critères relatifs aux services de confiance apply to your services. Your auditor then evaluates whether your controls meet those criteria effectively.

SOC 2 compliance requirements push you toward exactly that kind of structured, documented approach to security and data protection, one that can lower both risk and cost. The AICPA’s Critères relatifs aux services de confiance framework provides the structure, and the audit report gives your customers the evidence they need.

Critères relatifs aux services de confiance

The five Critères relatifs aux services de confiance form the backbone of every SOC 2 audit. Each criterion addresses a specific dimension of how you protect and manage data. Security is the only mandatory criterion, but most organizations include at least one or two additional criteria based on their services and customer expectations.

 Security (Common Criteria) – Security is the foundation of every SOC 2 report. The Common Criteria covers logical and physical access controls, system operations monitoring, change management, and risk mitigation.

Des contrôles tels que le CC6.4 (limitation de l’accès physique et logique aux ressources d’information) et le CC6.7 (limitation de la transmission, du transfert et du retrait d’informations) sont essentiels pour démontrer que vous protégez vos systèmes contre les accès non autorisés et les menaces. Chaque audit SOC 2 inclut le volet « Sécurité », quels que soient les autres critères que vous sélectionnez.

 Availability – Availability addresses whether your systems are operational and accessible as committed in your service-level agreements. This is where data protection becomes critical. Control A1.2 requires you to maintain backup processes and recovery infrastructure. Control A1.3 requires you to test your recovery plan, not just document one.

Les auditeurs souhaitent s’assurer que vous êtes en mesure de restaurer les systèmes et les données dans le respect des objectifs de temps de reprise et des objectifs de point de reprise définis.Clumio’s operational recovery capabilitiessont spécialement conçues à cet effet : une sauvegarde régie par des règles, avec une planification automatisée et un stockage « air-gapped » qui répond à la fois aux exigences A1.2 et A1.3.

Confidentiality – Confidentiality criteria (C1.1 and C1.2) focus on protecting information designated as confidential. This includes encryption of data at rest and in transit, retention policies that define how long confidential data is kept, and secure destruction processes when retention periods expire.

Processing integrity – Processing integrity evaluates whether your systems process data completely, accurately, and in a timely manner. This criterion is most relevant for organizations whose core service involves data transformation, calculation, or transaction processing.

 Privacy – Privacy addresses how you collect, use, retain, disclose, and dispose of personal information. It overlaps significantly with GDPR and CCPA requirements, making it a common addition for organizations that handle PII across jurisdictions.

Types de SOC 2

Les audits SOC 2 se présentent sous deux formes, et cette distinction est importante. Un rapport SOC 2 de type 1 évalue si vos contrôles sont correctement conçus à un moment donné. Considérez cela comme un instantané : l’auditeur vérifie que vos politiques et vos contrôles existent et sont correctement structurés à la date de l’évaluation.

Un rapport SOC 2 de type 2 va plus loin. Il évalue si ces contrôles fonctionnent réellement de manière efficace sur une période définie, généralement comprise entre six et douze mois. Les auditeurs examinent les preuves d’une mise en œuvre cohérente, notamment les journaux, les registres des modifications, les rapports de vérification des sauvegardes et la documentation relative à la gestion des incidents.

Le type 2 est la norme attendue par les acheteurs professionnels. Un rapport de type 1 peut constituer une étape intermédiaire pendant que vous constituez votre historique d’audits, mais la plupart des équipes chargées des achats exigeront un rapport SOC 2 de type 2 avant de signer un contrat.

C’est cette période d’observation prolongée qui confère au rapport toute sa crédibilité : elle prouve que vos contrôles fonctionnent dans la pratique, et pas seulement sur le papier.

Mappage des commandes

La protection des données n’est pas un aspect secondaire dans le cadre d’un audit SOC 2. Elle correspond directement à plusieurs contrôles relevant des critères de sécurité et de disponibilité. Pourtant, de nombreuses organisations négligent le Backup and Recovery lorsqu’elles se préparent à leur audit, se concentrant plutôt sur les contrôles d’accès et la sécurité du réseau.

Voici comment les contrôles SOC 2 spécifiques s’alignent sur les capacités de protection des données :


CC6.4

Limiter l’accès aux ressources d’information

Clumio stocke les sauvegardes dans un environnement isolé et hors réseau, doté d’un chiffrement dédié, distinct de votre compte cloud principal. Cette isolation administrative permet de répondre à l’exigence de contrôle visant à restreindre l’accès logique aux informations protégées.


CC7.5

Identifier les incidents de sécurité et y apporter une réponse

Clumio permet une restauration inter-comptes et interrégionale, facilitant ainsi les tests de réponse aux incidents et la restauration rapide lorsque les environnements de production sont compromis.


CC9.1

Identifier et gérer les risques

Policy-driven backup with automated scheduling helps eliminate manual processes and custom scripts, which also helps reduce operational risk. Clumio’s serverless architecture scales automatically without infrastructure overhead.


A1.2

Assurer la maintenance de l’infrastructure de Backup and Recovery

Clumio’s policy-based asset selection and offsite, air-gapped storage help deliver the backup processes and recovery infrastructure that auditors evaluate.


A1.3

Tester les plans de Recovery

Clumio prend en charge les tests de restauration aussi bien via sa console de gestion que via son API, ce qui vous permet de présenter à votre auditeur des tests de restauration documentés et reproductibles.

Liste de contrôle de conformité

Une approche structurée des exigences de conformité SOC 2 permet de mener votre audit à bien et de réduire le risque de lacunes. Suivez les étapes suivantes :


Définissez votre périmètre et sélectionnez les critères des services de confiance.

Déterminez les critères applicables en fonction de vos services et de vos engagements envers vos clients. La sécurité est obligatoire ; ajoutez la disponibilité, la confidentialité, l’intégrité du traitement ou la protection de la vie privée selon les besoins.


Réaliser une évaluation de l’état de Readiness.

Identifiez les domaines dans lesquels vos contrôles actuels répondent aux critères et ceux où des lacunes existent. Voilà votre feuille de route.


Mettre en place des contrôles et consigner les politiques.

Mettez en place les contrôles techniques et administratifs requis par chaque critère. Documentez tout : politiques, procédures, configurations et responsabilités.


Réaliser des tests internes, notamment la validation des procédures de Backup and Recovery.

Vérifiez que vos contrôles fonctionnent comme prévu. En matière de disponibilité, cela implique de tester l’intégrité des sauvegardes, les procédures de restauration et les processus de basculement.


Impliquez votre auditeur.

Choisissez un cabinet d’expertise comptable indépendant ayant de l’expérience en matière de SOC 2. L’auditeur définira la période d’observation pour un rapport de type 2 et précisera les exigences en matière de pièces justificatives.


Comblez vos lacunes et obtenez votre rapport.

Apportez les corrections nécessaires suite aux constatations de l’audit et recevez votre rapport SOC 2 final. Disposer d’une liste de contrôle claire dès le départ vous permet de passer de la phase de préparation à celle de l’audit avec moins d’imprévus.

Questions fréquemment posées:

Quels sont les 5 critères SOC 2 ?

Les cinq critères des services de confiance SOC 2 sont la sécurité, la disponibilité, la confidentialité, l’intégrité du traitement et la protection de la vie privée. Le critère de sécurité, également appelé « Critères communs », est obligatoire pour tout audit SOC 2. Votre organisation sélectionne des critères supplémentaires en fonction des services que vous fournissez et de vos engagements contractuels envers vos clients.

Qu’est-ce que la norme SOC 2 de type 1 par rapport à celle de type 2 ?

Un rapport SOC 2 de type 1 évalue si vos contrôles sont correctement conçus à un moment donné. Un rapport SOC 2 de type 2 évalue si ces contrôles fonctionnent efficacement sur une période de six à douze mois. Le type 2 est plus rigoureux et constitue la norme exigée par la plupart des acheteurs professionnels.

Combien de temps faut-il pour se mettre en conformité avec la norme SOC 2 ?

Pour un premier audit, il faut compter entre six et douze mois pour l’ensemble du processus. Ce délai comprend l’évaluation de l’état de préparation, la mise en place des contrôles, la période d’observation et l’audit proprement dit.

À quelle fréquence la conformité SOC 2 est-elle exigée ?

Un rapport SOC 2 de type 2 porte sur une période d’observation spécifique, généralement de 12 mois. La plupart des organisations renouvellent ce rapport chaque année afin de conserver un historique d’audit ininterrompu et de répondre aux exigences continues des clients et des services d’achats.

La conformité à la norme SOC 2 est-elle obligatoire ?

La norme SOC 2 est un référentiel facultatif et non une obligation légale. Cependant, les entreprises clientes, les partenaires et les équipes chargées des achats exigent de plus en plus souvent un rapport SOC 2 de type 2 à jour avant de signer des contrats. Dans la pratique, c’est devenu une exigence minimale pour toute entreprise de services traitant des données clients.


Points clés à retenir

  • ResOps is not a technology product. It’s a cross-functional operating discipline that helps drive organizational cyber resilience.
  • Il vient compléter les processus de sauvegarde, de reprise après sinistre, de cybersécurité, de continuité d’activité et de gestion des incidents en harmonisant ces fonctions autour d’objectifs de Recovery de bout en bout.
  • ResOps se concentre sur les services critiques et les seuils d’impact définis par l’entreprise, plutôt que sur des composants isolés de l’infrastructure.
  • Ce système repose sur la production continue de données probantes, notamment des résultats de Recovery validés, des indicateurs de résilience des services et un inventaire interne des lacunes.
  • La gestion des opérations de Recovery (ResOps) est un processus continu. Ni l’élaboration d’un plan, ni la réussite d’un exercice ponctuel ne suffisent à mettre en place une capacité de Recovery durable.

Le nouveau défi de la résilience

La plupart des entreprises investissent dans la cybersécurité, la sauvegarde,de Recovery, and continuité des activités. Yet many executives still face three critical questions: Can we recover? How long will recovery take? And can we prove it?

Part of the challenge is that responsibility for resilience is spread across teams that often operate in silos. Security manages threats. IT maintains systems. Backup and de Recovery teams restore data and infrastructure. Business continuity teams focus on keeping the organization running. Each plays an important role, but responsibility for recovery can remain fragmented.

ResOps brings these functions together around shared priorities, recovery goals, and evidence. The result is a more practical way to approach resilience: know what matters most, understand what it takes to recover it, test whether recovery works, and act on the gaps you find.

Qu’est-ce que ResOps ?

ResOpsest la discipline opérationnelle qui rassemble la sécurité, les infrastructures et les opérations informatiques,continuité des activités, et les chefs d’entreprise autour des services critiques, d’une conception résiliente et d’une validation continue. En termes simples, ResOps aide les équipes à se préparer aux perturbations, à rétablir les services critiques dans les limites de tolérance d’impact définies par l’entreprise, et à démontrer de manière factuelle que le rétablissement fonctionne.

Quatre caractéristiques définissent ResOps. Il s’agit :

  1. Une approche transversale par nature. ResOps relie les responsabilités décentralisées grâce à un modèle opérationnel partagé, une attribution claire des responsabilités et une gouvernance au niveau de la direction.
  2. Axé sur les services essentiels. Il donne la priorité aux services que l’organisation doit rétablir pour offrir sa valeur fondamentale, servir ses clients et générer des revenus ; il contribue également à respecter les obligations urgentes en matière juridique, réglementaire, de sécurité et liées à sa mission.
  3. Continuously validated. Resilience is a posture that teams must exercise and improve – not a state established by an annual test.
  4. Mesurée à l’aide de données factuelles. ResOps génère un score de résilience (RPS) : un score par service, étayé par des données factuelles, qui évalue le niveau de récupérabilité d’un service critique donné en fonction des résultats de validation, de l’état des dépendances et du niveau de confiance dans une récupération sans incident.

What Isn’t ResOps?

It’s not a product category.

Aucune plateforme ne peut à elle seule mettre en place le ResOps. Les technologies de protection des données, de Recovery informatique, d’automatisation, d’observabilité et de tests peuvent soutenir cette discipline, mais le ResOps relève de l’organisation. Il dépend de la gouvernance, de la responsabilité partagée, des priorités métier, des pratiques opérationnelles et d’une norme commune en matière de preuves.

It’s not a replacement for backup and recovery or de Recovery.

ResOps does not replace strong backup and de Recovery capabilities: it depends on them. Backup establishes whether recoverable copies exist. Disaster recovery provides the procedures and technical capabilities to help restore systems and infrastructure.

But then ResOps asks a broader question: Can the critical service return completely, cleanly, and within tolerance, including its identities, applications, data, infrastructure, cloud services, third parties, people, and decision paths?

It’s not another name for continuité des activités or incident response.

La continuité d’activité définit la manière dont l’entreprise fonctionne en cas de perturbation. La réponse aux incidents permet de détecter, de circonscrire et de gérer l’événement. ResOps relie ces disciplines au résultat de Recovery. Elle instaure un rythme opérationnel permettant aux équipes de s’accorder sur les priorités, de valider Recovery dans des conditions réalistes, de mesurer les résultats et de combler les lacunes mises en évidence par les tests.

It’s not a compliance exercise or one-time project.

A mature ResOps program can help generate evidence for boards, regulators, insurers, customers, and auditors. But documentation is a byproduct, not the objective. The objective is demonstrated recoverability.

And because systems, dependencies, threats, and business priorities keep changing, ResOps is never “finished.” It operates continuously, much like financial planning or security operations.

Quels changements ResOps apporte-t-il ?

ResOps ne se concentre plus sur le bon fonctionnement des systèmes et processus individuels, mais sur la capacité de l’ensemble du service critique à se rétablir. Cela modifie les questions que les dirigeants peuvent se poser.

Une sauvegarde réussie est importante. Il en va de même pour un plan de reprise. Mais aucun des deux ne permet de savoir si un service critique peut réellement être rétabli lorsque vous en avez besoin. ResOps adopte une vision plus globale :

  • La Recovery a-t-elle été effectuée à partir d’un point de Recovery valide et validé ?
  • Combien de temps cela a-t-il pris ?
  • Avons-nous atteint les objectifs fixés par l’entreprise ?
  • Et quels sont les points qui méritent encore une attention particulière ?

That’s why ResOps matters. It gives organizations a way to move beyond assumptions of resilience to programmatic, reliable demonstrations of their ability to recover. And they do it with continuous production of evidence and traceability. So when disruption happens, the question isn’t whether every team did its part or who failed at which task. It’s whether the business can restore the critical services its customers depend on.

En savoir plus

Commvault a publiéResOps: Guide à l’intention des dirigeants to give CISOs, CIOs, IT, security, resilience, and risk leaders a practical framework for implementing ResOps in their organizations.

Leaders will learn how to identify the services that matter most, validate recovery readiness with real evidence, and continuously test resilience. As a result, organizations can establish a single operating model that unites security, infrastructure, IT operations, and business leaders around evidence-based recoverability.

Get the guide ici. 

FAQ

Q: Is ResOps simply a new name for de Recovery?

A: No. Disaster recovery is an essential part of ResOps, but ResOps looks at the entire critical service – including technical, third-party, human, and decision dependencies – and whether it can recover within a business-defined impact tolerance.

Q : ResOps nécessite-t-il l’achat d’une nouvelle plateforme ?

R : Non. La technologie peut faciliter la cartographie, les tests, Recovery et la collecte de preuves, mais ResOps repose avant tout sur la prise de responsabilité, la gouvernance, les priorités métier et les pratiques opérationnelles.

Q : À qui appartient ResOps ?

A: ResOps needs a named leader with cross-functional authority and executive sponsorship. Individual service owners remain accountable for their services, while security, IT, continuité des activités, and business teams contribute to the shared recovery outcome.

Q : Comment mesure-t-on la réussite de ResOps ?

A: Success comes from current evidence that critical services can recover cleanly within their defined impact tolerances – not simply from completing a plan or running a successful backup job.

Le score de résilience (RPS) constitue également un outil de mesure utile. En tant que score par service, fondé sur des données factuelles, le RPS permet de mettre en évidence le niveau de récupérabilité d’un service critique donné, en se basant sur les résultats de validation, l’état des dépendances et le niveau de confiance dans une récupération sans incident.

Q : Comment les entreprises peuvent-elles se lancer dans le ResOps ?

R : Commencez par identifier les services essentiels dont dépend l’entreprise, qui en est responsable, de quoi ils dépendent et dans quel délai ils doivent être rétablis. À partir de là, les équipes peuvent valider les plans de Recovery, identifier les lacunes et hiérarchiser les actions nécessaires pour renforcer la résilience.

Michael Thelander is Senior Director of Product Marketing at Commvault.

More related posts


Thumbnail_Blog-how-AI-has-impacted-the-security-mission-2026

How AI Has Impacted the Security Mission

Read more about How AI Has Impacted the Security Mission
Thumbnail_Blog-Recovery-Ready-2026

Recovery-Ready or Just Recoverable?

Read more about Recovery-Ready or Just Recoverable?
Thumbnail_Blog-Data-Leakage-Loops-2026

What is Recovery Time Objective (RTO) and How to Calculate It

Read more about What is Recovery Time Objective (RTO) and How to Calculate It

Points clés à retenir

  • Resilience depends on how quickly and confidently the business can recover – not solely on keeping every threat out.
  • Turn recovery plans into evidence – tested results are more credible to boards, regulators, and insurers than targets or assumptions.
  • Faites de ResOps un modèle opérationnel partagé pour les responsables de la sécurité, de l’infrastructure, de la continuité d’activité et des services.
  • Mesurez ce qui compte : les équipes doivent savoir si les services critiques peuvent être rétablis, combien de temps la Recovery prend réellement et si elles sont en mesure de le prouver.
  • Sélectionnez un ou deux services critiques, définissez ce qu’est une Recovery réussie, menez un exercice réaliste et consignez les résultats.
  • Twenty years in security leadership teaches you one thing early: The attack you stopped never makes the board meeting. The one you didn’t is the only story anyone remembers. Somewici along the way I stopped measuring my team by how many hits we absorbed alone and started also measuring us by how fast we got back up.
  • That’s the reason I want every CISO, CIO, and board member I know to read this new book, *ResOps : An Executive Guide. Commvault sponsored it, but I’d be recommending it either way.

Le mur n’a jamais été le seul objectif

For most of my career, the job was building higher walls. Better detection, tighter controls, faster response. That work still matters, and it always will. But a wall only answers one question, and it’s not the one your board is asking anymore.

Last September, ransomware forced Jaguar Land Rover to halt global manufacturing. Assembly lines stopped. Supply chains froze. The UK’s Cyber Monitoring Centre put the cost to the broader economy at roughly £1.9 billion, and JLR posted its lowest monthly production output in 73 years. JLR had defenses. What the incident tested wasn’t whether the wall held. It was whether the business could get back up once it didn’t.

I’ve said this before and I’ll keep saying it: Disruption isn’t an if, it’s a when. The CISOs who sleep at night aren’t those who believe they can keep everything out; they’re those who’ve practiced getting back up so many times that the practice itself is the confidence.

Trois questions que je pose à ma propre équipe

The book organizes the whole problem into three questions, and I’ve started opening every resilience review with them:

  • Si nous étions touchés ce soir, pourrions-nous nous remettre sur pied ?
  • Combien de temps cela prendrait-il réellement ?
  • Pouvons-nous le prouver, avec des preuves, au conseil d’administration ?

Most organizations answer the first two with a plan and the third with silence. That silence is the resilience gap, and it’s bigger and more expensive than most executives realize.

Des preuves, pas des promesses

Here’s a distinction the book makes better than I’ve heard it made anywici else: A recovery time objective is a target. It tells you what you’re aiming for – but it doesn’t tell you whether you’ll hit it.

Compare “we believe we can recover the payments service in four hours” to “we restored it in 3.2 hours last quarter, from a verified clean recovery point, against a four-hour tolerance.” The first sentence is a plan. The second is evidence. Only one of them holds up when your board, your regulator, or your cyber insurer starts asking harder questions, which they will.

We calls this discipline ResOps, short for resilience operations. It’s not a product you buy or a binder you file. It’s an operating model that connects security, infrastructure, business continuity, and the business owners who depend on these services, all working from the same evidence instead of separate plans.

Ce qui devrait inquiéter tout RSSI

The book also names something I’ve felt for a while and finally have language for: the AI paradox. The same AI capability helping us find vulnerabilities faster is helping attackers close the gap between discovery and exploitation just as fast, maybe faster. Finding more problems doesn’t make you safer if you can’t recover from the ones that get through. Detection speed was never the finish line. Recovery capability is.

Commencez par un seul service

None of this requires boiling the ocean, and I’d be lying if I said my own team got it right on the first try. The book lays out a 90-day path: Pick one or two of your most critical services, define what “recovered” really means for each, run one honest recovery exercise, and produce your first piece of real evidence. That’s a project any team can start this quarter, mine included.

Proof over promises. Readiness over perfection. That’s the standard I hold my team to, and it’s the standard this book gives you a real path toward.

Get your copy of *ResOps : An Executive Guide ici.

FAQ

Q : Qu’est-ce que ResOps ?

R : ResOps, abréviation de « resilience operations » (opérations de résilience), est un modèle opérationnel qui rassemble les responsables de la sécurité, de l’infrastructure, de la continuité des activités et des services autour de pratiques de reprise communes, fondées sur des données factuelles.

Q : En quoi ResOps diffère-t-il de la reprise après sinistre classique ?

R : La reprise après sinistre traditionnelle s’articule souvent autour de plans et d’objectifs techniques. Les opérations de reprise après sinistre (Recovery) mettent l’accent sur la validation continue, la prise en charge transversale et la preuve mesurable que les services critiques peuvent être rétablis dans les limites des tolérances opérationnelles.

Q : Pourquoi les preuves de Recovery sont-elles importantes ?

R : Les preuves de Recovery montrent ce qu’une organisation a réellement testé et réalisé. Elles contribuent à donner aux conseils d’administration, aux autorités de régulation, aux assureurs et aux dirigeants d’entreprise davantage de confiance que ne le feraient à eux seuls les plans ou les objectifs de Recovery.

Q : Quels indicateurs les organisations doivent-elles mesurer dans le cadre d’un programme ResOps ?

R : Les organisations doivent évaluer si les services critiques peuvent être rétablis, combien de temps dure réellement la Recovery, si les points de Recovery sont intacts et vérifiés, et si les résultats respectent les seuils de tolérance définis par l’entreprise.

Q : Qui devrait participer aux opérations de secours (ResOps) ?

R : Les opérations de Recovery doivent réunir les responsables de la sécurité, de l’infrastructure, de la continuité d’activité, ainsi que les responsables des applications et des services et les décideurs de haut niveau, afin que les priorités en matière de Recovery et les justifications reflètent les besoins de l’entreprise.

Q : Comment une entreprise peut-elle se lancer dans ResOps ?

R : Commencez par un ou deux services essentiels. Définissez ce que signifie une reprise réussie, menez un exercice de Recovery en toute sincérité, consignez les résultats et utilisez ces données pour améliorer le prochain test.

Bill O’Connell is Chief Security Officer at Commvault.

More related posts


Thumbnail_Blog-how-AI-has-impacted-the-security-mission-2026

How AI Has Impacted the Security Mission

Read more about How AI Has Impacted the Security Mission
Thumbnail_Blog-Recovery-Ready-2026

Recovery-Ready or Just Recoverable?

Read more about Recovery-Ready or Just Recoverable?
Thumbnail_Blog-Data-Leakage-Loops-2026

What is Recovery Time Objective (RTO) and How to Calculate It

Read more about What is Recovery Time Objective (RTO) and How to Calculate It

Points clés à retenir 

  • Le document d’orientation fédéral mis à jour fait état des nouvelles tactiques et techniques de Medusa, ainsi que de plus de 500 victimes issues de secteurs d’infrastructures critiques. 
  • Les pirates ne se contentent pas de cibler les données de production ; ils perturbent également les systèmes de sauvegarde, d’identité, de virtualisation et d’autres systèmes dont dépendent les entreprises pour leur Recovery. 
  • Leadvisory calls on organizations to prove their resilience through testing and validation against observed attacker behaviors, not assume it from plans or successful backup jobs alone.  

La dernière alerte fédérale concernant le ransomware Medusa a été mise à jour pour une bonne raison :L’adversaire a changé. 

Leavis fédéral mis à jour, issued August 18, 2026, by the FBI, Cybersecurity and Infrastructure Security Agency (CISA), and U.S. Department of Health and Human Services (HHS), describes an adversary that recruits new access brokers, moves faster once inside, and has gotten better at making sure the damage it causes cannot be undone.  

LeAttack Is Not Just Against Your Data

Les cybercriminels de Medusa agissent rapidement. Les enquêteurs indiquent que ces derniers ont exploité des failles récemment révélées dans les 24 heures qui ont suivi leur annonce et, dans certains cas, ont utilisé ces failles jusqu’à une semaine avant la divulgation publique de la vulnérabilité. 

Une fois à l’intérieur, ils se font passer pour des utilisateurs légitimes en utilisant des outils de gestion à distance légitimes, le vol d’identifiants et des techniques de « living-off-the-land ». 

But the advisory’s most significant finding is that Méduse s’attaque directement au processus de Recovery. 

Leadvisory maps this activity to MITRE ATT&CK technique T1490, Inhibit System Recovery. Ce document décrit comment le ransomware met fin aux services liés aux sauvegardes, à la sécurité, aux bases de données, aux communications, au partage de fichiers et aux sites web. Il supprime également les clichés instantanés et procède à l’arrêt et au chiffrement à distance des machines virtuelles. 

Si un pirate cible délibérément les systèmes, les identités et l’infrastructure dont une organisation pourrait avoir besoin pour se remettre d’un incident, le problème dépasse le cadre de la protection des données pour s’étendre à la cyber-résilience et à la cyber-Recovery. 

C’est là qu’interviennent les ResOps (opérations de résilience)

ResOps n’est pas simplement un autre nom pour désigner la sauvegarde. Il s’agit d’une discipline opérationnelle qui rassemble les équipes de sécurité, informatiques, d’infrastructure, d’applications, d’exploitation et métier autour d’un seul objectif : assurer la continuité des services critiques et les restaurer dans les délais que l’entreprise peut tolérer. 

LeMedusa advisory never uses the word ResOps, but the thinking is there. It recommends organizations exercise, test, and validate their security programs against observed attacker behaviors, align security technologies to attack techniques, test them at scale, measure performance, and tune people, processes, and technologies based on the evidence. 

Une sauvegarde ne prouve pas que les données sont intactes. Un objectif de délai de reprise indiqué dans un tableur ne prouve pas que l’entreprise sera opérationnelle dans ce délai. La résilience doit passer de l’hypothèse à la preuve. 

Start With the Business, Not LeServer

Leaddition of HHS in the advisory makes this especially relevant for healthcare, a sector the FBI says has been a frequent Medusa target. Lerecovery conversation starts with three questions: 

  • Quelles activités doivent continuer à fonctionner, et à quoi ressemble un fonctionnement minimal viable ? 
  • Quelles identités, applications, infrastructures et données permettent le fonctionnement de ces services ? 
  • À quels points de Recovery peut-on se fier, et quels éléments sont restaurés en premier ? 

In a hospital, leaving any one of those unanswered may mean a delayed surgery, a pharmacist who can’t verify a dosage, or a diagnostic system a clinician can’t trust. No single team can answer them alone, which is the gap ResOps is designed to close. 

Utilisez Medusa pour vérifier vos hypothèses

Utilisez Medusa comme cas test pour vérifier vos hypothèses de Recovery. Un attaquant peut-il accéder aux systèmes qui prennent en charge la Recovery ? Que se passe-t-il si Active Directory est compromis ? Êtes-vous en mesure d’identifier un point de Recovery intact, de restaurer les services critiques dans le bon ordre et de déterminer la durée que cela prendra ? 

Threat actors adapt when defenders adapt. Resilience programs need to operate the same way: continuously tested, continuously validated, and continuously improved.  

Car le cœur d’un incident n’est vraiment pas le moment idéal pour se rendre compte que le plan de Recovery, qui semblait parfait sur le papier, ne fonctionne pas aussi bien dans la réalité. 

FAQ

Q : Qu’est-ce que le ransomware Medusa ? 

R :Medusa est une opération de type « ransomware-as-a-service » (ransomware en tant que service) identifiée pour la première fois en 2021. Ses développeurs et ses affiliés ont recours à un modèle de double extorsion : ils chiffrent les systèmes tout en menaçant de publier les données volées si la rançon n’est pas versée. 

Q : Pourquoi l’avis fédéral concernant Medusa a-t-il été mis à jour ? 

R : LeAugust 2026 update incorporates findings from FBI investigations as recent as April 2026. It expands the documented tactics, techniques, procedures, exploited vulnerabilities, affiliate activity, and indicators of compromise, while adding HHS insights on attacks against healthcare. 

Q: How does Medusa threaten an organization’s recovery capabilities? 

R :Medusa peut interrompre les services liés aux sauvegardes, à la sécurité, aux bases de données, aux communications et à d’autres fonctions critiques. Elle peut également supprimer des clichés instantanés, modifier les politiques relatives à l’identité et arrêter ou chiffrer des machines virtuelles, mettant ainsi en péril le processus de restauration lui-même. 

Q : Que doivent faire les organisations pour contribuer à réduire le risque lié à Medusa ? 

R :Les organisations doivent corriger sans délai les vulnérabilités connues, segmenter leurs réseaux, restreindre l’accès aux services à distance, renforcer l’authentification, surveiller les mouvements latéraux et appliquer le principe du « privilège minimal ». Elles doivent également conserver des copies de secours distinctes, hors ligne, chiffrées et immuables, et tester régulièrement leurs procédures de Recovery. 

Q : Qu’est-ce que ResOps, et en quoi diffère-t-il de la sauvegarde ? 

R : ResOps, or resilience operations, is a cross-functional operating discipline – not a backup product. It aligns security, IT, infrastructure, applications, operations, business continuity, and business owners around restoring critical services within the amount of disruption the business can tolerate. 

Q : Comment une organisation peut-elle démontrer qu’elle est prête à se redresser ? 

R :Commencez par identifier les services métier critiques, cartographiez les identités, les applications, l’infrastructure, les données, les personnes et les tiers dont ils dépendent, puis définissez ce que constitue une reprise réussie. Organisez ensuite des exercices réalistes permettant d’identifier des points de reprise fiables, de restaurer les services dans le bon ordre, de mesurer le temps de reprise réel et de transformer les lacunes éventuelles en un programme d’améliorations à mettre en œuvre en interne. 

Chris Bevilest responsable principal du marketing de portefeuille chez Commvault. 

More related posts


AI Data Resilience

Read more about AI Data Resilience

Key Takeaways 
  • Environ 1 200 agents supposés isolés ont communiqué via un forum non autorisé, et environ 700 ont pris part à des activités liées à Hugging Face. 
  • Les agents ont échangé plus de 70 000 messages et fichiers, combinant ainsi des informations issues de sessions censées rester distinctes. 
  • Investigators found agents spoofing tool calls and researching ways to alter evaluation transcripts to avoid detection by lagrader.  
  • Les sauvegardes immuables et isolées ne suffisent pas à elles seules : les entreprises ont besoin d’un point de reprise validé et fiable avant de procéder à la restauration en production. 
Les rapports d’expertise sont enfin arrivés, et ils ont bouleversé ma vision de cet incident. 

Il y a environ un mois,J’ai écrit à propos delaIncident de sécurité chez OpenAI et Hugging Face because I thought it was something anyone responsible for cybersecurity, AI or business resilience should be watching.  

At latime, lastory sounded fairly straightforward: An AI agent found a way outside laenvironment designed to contain it and ultimately reached Hugging Face. 

Ce n’est pas vraiment ce qui s’est passé. 

L’affaire va bien au-delà d’un simple agent rebelle 

Les rapports d’expertise révèlent qu’environ 1 200 agents, censés opérer de manière isolée, ont trouvé le moyen de communiquer via un forum non autorisé. Ils ont échangé plus de 70 000 messages et fichiers, et environ 700 agents ont participé à des activités liées à Hugging Face. 

None of that was prompted or intended. Leagents were persistent, they could share what they found, and they could combine effort across sessions that were supposed to have no contact with each other.  

Among lanew details: GPT-5.6 Sol agents reproduced an exploit and copied private evaluation data into a public Hugging Face dataset, a concrete escalation beyond what initial reports described. 

Le problème du « reward hacking » 

Leétude indépendante menée par METR et Redwood Research, published alongside OpenAI’s own report on August 26, found that agents researched ways to spoof, edit or delete portions of their own evaluation transcripts because they incorrectly believed lagrader would inspect how they completed latask. Researchers found successful tool-call spoofing in about 7% of latranscripts they evaluated, though lamanipulation they observed was small-scale. 

Lefinding is not that agents are “deceptive” in a human sense. It is that a sufficiently capable agent can search for ways around controls when those controls stand between it and laoutcome it has been optimized to achieve. 

OpenAI calls laincident a “warning shot.” I think that is a fair description. 

Que se passe-t-il lorsque le confinement échoue ? 

Most of laconversation about this incident will rightly focus on alignment, sandboxing and monitoring. But there’s a resilience question underneath it: If 700 agents can find a side door around containment, what’s laplan for when a single compromised workload does lasame in your environment? 

OpenAI’s own conclusion points at laanswer: Security architecture should assume an individual workload or compute node eventually can be compromised. That means air-gapped, immutable recovery data, and a way to validate what you’re restoring before it touches production again. 

But immutability alone does not prove ladata was clean when it was captured. If ladata was already compromised at latime of capture, immutability preserves lacompromise just as faithfully as it preserves anything else. 

Lepractical version of that question is simple to ask and hard to answer: If this happened to us, could we prove which recovery point predates lacompromise? 

Nous abordons ce modèle opérationnel dans la section intituléeResOps (opérations de résilience) on laReadiverse. 

LeLesson for Every Organization 

OpenAI has since tightened workload and network isolation, expanded monitoring, and revised its model-development practices. Lelesson applies beyond OpenAI: Contain laimpact, preserve what you can trust, and prove you can recover before you need to. 


FAQ 

Q: What was laOpenAI-Hugging Face incident? 

During internal cybersecurity evaluations, OpenAI agents bypassed controls intended to isolate them, accessed lainternet and reached third-party systems, including Hugging Face. Leactivity was driven primarily by an internal research model operating with reduced safeguards. 

Q : Comment ces agents, censés être isolés, communiquaient-ils entre eux ? 

R :Ils ont découvert un forum non autorisé au sein d’une infrastructure partagée. Environ 1 200 agents l’ont utilisé pour échanger plus de 70 000 messages et fichiers, ce qui a permis la transmission d’informations et de tactiques entre des sessions censées rester indépendantes les unes des autres. 

Q: Were laagents instructed to attack Hugging Face? 

R : No. They were attempting to complete a difficult cybersecurity benchmark. When laintended route appeared blocked, some agents searched for alternative ways to achieve laevaluated outcome, and that activity expanded beyond laenvironment’s intended boundaries. 

Q: What does “reward hacking” mean in this context? 

R : Reward hacking occurs when an agent finds an unintended way to satisfy a metric or obtain a desired result without completing latask as intended. Investigators found agents researching ways to spoof tool calls and alter or delete portions of evaluation transcripts because they believed lagrader might inspect their process. 

Q : Pourquoi les sauvegardes immuables ne suffisent-elles pas à elles seules ? 

R : Immutability prevents stored data from being altered, but it does not prove ladata was clean when it was captured. If a backup already contains compromised data, immutability preserves that compromise. Organizations therefore need isolated copies, trustworthy recovery points and validation before restoration. 

Q : Que devraient faire différemment les organisations à la suite de cet incident ? 

R :Renforcez l’isolation des charges de travail et des réseaux, limitez les accès inutiles à Internet et aux identifiants, surveillez le comportement des agents et les signaux d’escalade, et partez du principe que la prévention peut échouer. Associez ces contrôles à des données de restauration immuables et isolées physiquement (air-gapped), ainsi qu’à un processus éprouvé permettant d’identifier et de valider un point de restauration sain. 

Chris Bevilest responsable principal du marketing de portefeuille chez Commvault. 

More related posts


Thumbnail_Blog-how-AI-has-impacted-the-security-mission-2026

How AI Has Impacted the Security Mission

Read more about How AI Has Impacted the Security Mission
Thumbnail_Blog-Recovery-Ready-2026

Recovery-Ready or Just Recoverable?

Read more about Recovery-Ready or Just Recoverable?
Thumbnail_Blog-Data-Leakage-Loops-2026

What is Recovery Time Objective (RTO) and How to Calculate It

Read more about What is Recovery Time Objective (RTO) and How to Calculate It

Points clés à retenir

  • Certificate lifespans will shrink from 398 to 47 days by March 2029 with “domain validation reuse” shrinking to just 10 days, making manual renewal obsolete and automatic Certificate Lifecycle Management (CLM) necessary.
  • Des opérations de type « Harvest Now, Decrypt Later » (collecter maintenant, décrypter plus tard) sont déjà en cours afin de stocker des données destinées à être conservées sur le long terme en vue d’un décryptage futur à l’aide d’ordinateurs quantiques, ce qui représente une menace immédiate pour les données sensibles cryptées dont la durée de conservation est prolongée.
  • L’inventaire des certificats et des clés cryptographiques est un élément essentiel que les entreprises doivent commencer à mettre en place dès maintenant, car un inventaire continu et automatisé constitue la première étape vers une cyber-résilience et une « crypto-agilité » à long terme.

Le problème qui se cache en arrière-plan

La plupart des réseaux d’entreprise modernes s’appuient sur une couche cachée, composée de certificats numériques et de techniques de cryptographie, que la plupart des gens ne voient jamais. Cette couche vérifie la fiabilité des machines et sécurise les flux de données, mais les identités des machines étant désormais plus nombreuses que celles des humains, à raison deplus de 80 pour 1 in the average enterprise according to CyberArk’s machine identity research, it can be easy to underestimate the cryptographic and certificate layer’s importance.

A helpful way to think about a digital certificate is an ID badge for a machine. If the badge is valid, the doors open automatically and no one thinks about it, but the moment that badge expires or is misconfigured, the door stops opening, regardless of how legitimate the machine behind it is. A single expired certificate can take down websites, break the APIs that let applications talk to each other, interrupt transactions, and create compliance violations, all while eroding user trust.

For years, organizations have managed certificates manually, but two changes are going to make it impossible to keep up by hand. First, the maximum lifespan of public Transport Layer Security (TLS) certificates, the protocol securing your browser, is being compressed to just 47 days by 2029. Second, the eventual arrival of quantum computers powerful enough to break today’s encryption is forcing a transition to Post-Quantum Cryptography. These two issues both point to the same solution – a governed, automated, and crypto-agile approach to CLM.

La feuille de route à l’origine de la réduction de la durée de validité des certificats

La fenêtre opérationnelle des certificats TLS publics ne cesse de se réduire depuis une décennie. Début 2023, Google a publié pour la première fois son“Moving Forward, Together”feuille de route, qui proposait de réduire la durée de validité des certificats de 398 jours à 90 jours dans le but d’inciter le secteur à s’orienter vers l’automatisation. Apple a accéléré ce calendrier en octobre 2024 enprésentation d’un projet de bulletin de vote to the CA/Browser Forum, the industry body where certificate authorities and browser makers set shared rules. Apple’s proposal, endorsed by Sectigo, Google Chrome, and Mozilla, was approved in April 2025 as Bulletin de vote SC-081v3.

Cette réduction s’effectue par étapes. La durée maximale de 398 jours en vigueur jusqu’à présent est déjà passée à 200 jours en mars 2026 ; elle sera ramenée à 100 jours en mars 2027, puis à 47 jours en mars 2029. Concrètement, une organisation qui renouvelle actuellement chaque certificat environ une fois par an devra bientôtrenouveler chaque certificat environ tous les mois et demi; à ce stade final, tout processus reposant sur la demande et l’installation manuelles de certificats par une personne échouera.

Les éditeurs de navigateurs prônent ces durées de vie plus courtes afin d’imposer l’automatisation, ce qui élimine l’erreur humaine à l’origine de la plupart des interruptions de service liées aux certificats. Elles permettent également à l’ensemble du Web d’adopter de nouvelles normes cryptographiques en quelques semaines plutôt qu’en plusieurs années, puisque les anciens certificats sont rapidement retirés de la circulation. De plus, elles contribuent à réduire la dépendance vis-à-vis des anciens systèmes de révocation, qui souffrent de problèmes de performances et de confidentialité. Enfin, si un journal de transparence des certificats (un registre public des certificats émis) venait à être invalidé, les certificats à durée de vie courte réduiraient considérablement le nombre de certificats devant être remplacés dans l’urgence.

La course à la validation

Si la limite de 47 jours fait la une et retient l’attention, le changement le plus perturbateur pourrait bien concerner la validation du contrôle de domaine (DCV). La DCV consiste à prouver à une autorité de certification (CA) que vous contrôlez le domaine pour lequel vous demandez un certificat. Auparavant, une fois qu’une organisation avait prouvé sa propriété, l’AC pouvait réutiliser cette preuve pendant 398 jours maximum ; or, selon la norme SC-081v3, cette période de réutilisation sera réduite à 200 jours en 2026, puis à seulement 10 jours d’ici mars 2029.

Cela crée un réel déséquilibre, car même une organisation ayant entièrement automatisé l’installation des certificats se retrouvera bloquée si elle ne peut pas prouver à nouveau sa propriété du domaine tous les 10 jours. Tout retard dans la validation interrompt l’ensemble du processus d’émission et entraîne directement des interruptions de service.

La solution pratique à ce problème consiste à adopter le protocole ACME (Automatic Certificate Management Environment) avecautomated DNS-01 API validation, de sorte que la vérification de la propriété s’effectue de manière automatisée plutôt que d’attendre l’intervention d’une personne.

La menace quantique et la chronologie

While certificate lifespans shrink, the algorithms inside those certificates face a quantum threat. Traditional Public Key Infrastructure (PKI) rely on asymmetric cryptography to secure digital signatures, key exchanges, and TLS connections. A sufficiently powerful quantum computer running Shor’s algorithm could break these systems completely. Waiting until quantum computing is powerful enough to decrypt is not a viable option; as Vidya Shankaran, directrice technique sur le terrain chez Commvault has written, “the exact date of Q-Day may remain uncertain. The direction of travel is not.” Selon les estimations, le « Q-Day », c’est-à-dire le moment où un ordinateur quantique sera capable de contourner le chiffrement à clé publique, devrait survenir dans les 5 à 10 prochaines années. Cependant, ce serait une erreur de considérer cela comme un problème futur. Les acteurs malveillants mènent déjà des opérations de type « Harvest Now, Decrypt Later » (HNDL) : ils interceptent et stockent dès aujourd’hui du trafic chiffré dans l’intention de le déchiffrer une fois que l’informatique quantique aura atteint sa maturité. Les données qui doivent rester confidentielles pendant des années, telles que les dossiers médicaux, la propriété intellectuelle et les informations financières, sont de fait exposées dès le moment où elles sont collectées.

Le gouvernement fédéral américain a réagi en conséquence : en juin 2026, la Maison Blanche a publiéDécret présidentiel n° 14412, Securing the Nation Against Advanced Cryptographic Attacks, which sets deadlines well ahead of NIST’s original 2035 target: Federal high-value systems must adopt post-quantum key establishment by the end of 2030 and post-quantum digital signatures by the end of 2031.

Despite this urgency, actual progress toward enterprise-level crypto-agility has been slow. The Perspectives de DigiCert sur la Readiness pour l’ère quantiqueL’étude a révélé que plus de la moitié des organisations interrogées s’attendent à ce que le chiffrement asymétrique classique soit contourné d’ici cinq ans, alors que seules 7 % d’entre elles ont déployé une cryptographie résistante à l’informatique quantique ou hybride sur l’ensemble de leur parc de certificats, et que leur niveau de Readiness global n’a progressé que de 2 points de pourcentage au cours de l’année écoulée.

Pourquoi la « crypto-agilité » est-elle importante ?

The most practical bridge between classical and post-quantum cryptography is the hybrid composite certificate, which combines a classical algorithm (RSA or ECC) with a post-quantum algorithm (ML-DSA, the standardized lattice-based signature scheme) inside a single X.509 certificate. Combining both into a single certificate is designed so that the certificate will hold up as long as either algorithm does, which is essential, as post-quantum algorithms are new and haven’t yet survived countless attempted attacks like RSA has.

However, post-quantum keys and signatures are several kilobytes rather than a few hundred bytes, which increases network latency, risks packet fragmentation during the TLS handshake, and adds computational overhead that may require hardware upgrades for constrained devices. This is exactly why crypto-agility matters; organizations need the ability to test, deploy, and rotate algorithms without rewiring their underlying infrastructure each time standards evolve.

Gestion automatisée du cycle de vie des certificats

La gestion manuelle des certificats n’est pas seulement inefficace ; c’est un véritable risque opérationnel. Lorsque les certificats sont stockés dans des tableurs, hors de vue, les entreprises perdent toute visibilité, ce qui se traduit par des certificats expirés, des clés de faible longueur, des algorithmes de signature obsolètes et des configurations non conformes que personne ne remarque jusqu’à ce qu’un incident se produise. Les interruptions de service qui en résultent peuvent semer la confusion chez les utilisateurs, perturber le chiffre d’affaires et retomber sur l’équipe la moins bien préparée à les expliquer.Une plateforme CLM complètetraite cette question tout au long du cycle de vie d’un certificat :

  • Détection : analyse continue des environnements cloud, des centres de données, des conteneurs et des domaines externes afin d’identifier tous les certificats en cours d’utilisation.
  • Surveillance : suivi en temps réel des dates d’expiration, des algorithmes, des points forts clés et du respect de la politique de sécurité.
  • Validation : tirer parti de l’intégration directe via API avec des autorités de certification publiques et privées, tout en automatisant la validation et l’approbation des domaines
  • Installation : déployez les certificats et clés renouvelés par programmation via ACME ou des API sécurisées, sans aucune intervention manuelle.
  • Révocation : il est nécessaire de mettre en œuvre une procédure de révocation rapide et basée sur des règles, afin qu’un certificat compromis puisse être remplacé ou révoqué partout simultanément, plutôt que de devoir être recherché machine par machine.

Cette étape de découverte recèle également un avantage : l’inventaire des certificats géré par une plateforme CLM constitue, en effet, le point de départ de l’inventaire cryptographique nécessaire à la planification de la migration post-quantique, ce qui peut transformer une corvée de mise en conformité en une longueur d’avance.

Identités non humaines et IA agentive

Le problème d’échelle est aggravé par la manière dont les applications modernes sont conçues. Les conteneurs, les pods Kubernetes, les machines virtuelles, les appareils de l’Internet des objets (IoT) et les API nécessitent tous leurs propres identifiants, et bon nombre de ces charges de travail n’existent que pendant quelques minutes ou quelques heures avant de prendre fin. Aucune équipe humaine ne peut émettre et révoquer des certificats à une telle vitesse.

Pour suivre ce rythme effréné, des agents d’IA peuvent être utilisés pour détecter, émettre, renouveler et gérer les certificats de manière autonome, tout en respectant les contraintes existantes telles que les politiques de sécurité, le contrôle d’accès basé sur les rôles (RBAC) et les pistes d’audit centralisées. Il en résulte une automatisation à la vitesse des machines sans pour autant renoncer à la gouvernance d’entreprise.

Par où commencer ?

  1. La première étape vers la « crypto-agilité » et la résilience à l’échelle de l’entreprise relève davantage de l’organisation que de la technique. Conformément àrecommandations du NIST, les entreprises devraient mettre en place une équipe centrale chargée des services d’identité des machines, qui serait responsable de la plateforme CLM, de la normalisation des modèles de certificats et de la gestion des intégrations avec les autorités de certification publiques et privées. Les responsables d’applications et les équipes DevOps, quant à eux, devraient être chargés d’intégrer les renouvellements automatisés dans leurs propres pipelines de déploiement, en utilisant la plateforme centrale comme un service partagé. Cette répartition des rôles permet de garantir la cohérence de la gouvernance tout en éliminant les transferts manuels qui sont à l’origine des interruptions de service.
  2. Les organisations devraient dès à présent remplacer les techniques de validation manuelles et les processus de travail par ACME et la validation automatisée DNS-01, bien avant l’arrivée de la période de 10 jours prévue pour la validation par code (DCV), tout en supprimant progressivement tous les processus manuels de renouvellement et de validation.
      1. Parallèlement, les organisations devraient procéder à un inventaire complet de leurs actifs cryptographiques afin d’identifier les clés codées en dur, les algorithmes obsolètes et les chaînes de confiance de longue durée qui protègent les données sensibles.
      2. La préparation post-quantique devrait débuter dans un environnement contrôlé plutôt qu’en production. Un laboratoire de test dédié devrait être mis en place pour permettre aux équipes de tester des certificats composites hybrides et des mises à niveau « crypto-agiles » dans un environnement de test. En développant des applications à partir de bibliothèques cryptographiques modulaires connectées à une plateforme CLM dynamique, les entreprises peuvent bénéficier d’une véritable « crypto-agilité » : la capacité à faire tourner les clés, les chiffrements et les algorithmes au sein de leur infrastructure à mesure que les normes évoluent, sans avoir à tout reconstruire.

The thread that connects all recommendations is inventory. A CLM platform’s discovery step is not busywork before the real fix; it is the same discipline organizations will need across every layer of quantum readiness. Certificates are non-human identities, and the same questions apply to service accounts, AI agents, open source dependencies, and the algorithms buried in application code: What do we have, what does it protect, and which of it matters most to the business?

Organizations that build that inventory muscle now, starting with certificates, will find the rest of the transition far less daunting, because prioritization becomes a calculation rather than a guess. Treating the next few years as a planning window rather than a grace period will help organizations make this transition on their own terms, instead of letting an outage make the decision for them.

Caitlin Dodson is a Summer 2026 Intern for FCTO – Americas at Commvault.
More related posts


Thumbnail_Blog-how-AI-has-impacted-the-security-mission-2026

How AI Has Impacted the Security Mission

Read more about How AI Has Impacted the Security Mission
Thumbnail_Blog-Recovery-Ready-2026

Recovery-Ready or Just Recoverable?

Read more about Recovery-Ready or Just Recoverable?
Thumbnail_Blog-Data-Leakage-Loops-2026

What is Recovery Time Objective (RTO) and How to Calculate It

Read more about What is Recovery Time Objective (RTO) and How to Calculate It

Points clés à retenir

  • Clumio Chat offers a faster, self-service way to evaluate Clumio’s cloud-native data protection capabilities.
  • L’assistant IA fournit des réponses sur la sauvegarde, la Recovery, la cyber-résilience, le déploiement, l’évolutivité et la protection des charges de travail dans le cloud.
  • Découvrez des questions techniques sur les charges de travail cloud, les autorisations requises, les options de Recovery et les coûts liés à la protection des données.
  • Clumio Chat aide les architectes cloud, les ingénieurs de plateforme, les ingénieurs DevOps, les SRE et les acheteurs techniques à déterminer, à leur rythme, si Clumio est adapté à leur environnement.
  • Lorsqu’ils sont prêts, les utilisateurs peuvent passer directement de la découverte du produit à une évaluation pratique en créant un compte et en démarrant un essai gratuit.

Une manière plus rapide d’évaluer la protection des données native du cloud

If you’re evaluating cloud-native data protection, you probably want answers before you schedule a demo or talk to Sales.

Clumio by Commvault provides cloud-native backup, recovery,etcyber resilience for AWSetGoogle Cloud workloads. With Clumio Chat, you can ask productettechnical questions, explore how Clumio works,etdecide whether it’s the right fit for your environment – all at your own pace.


Click “Ask Clumio” in the navigation bar on Clumio.com pour entamer une conversation avec Clumio Chat.

Présentation de Clumio Chat

Clumio Chat is an AI assistant designed to help you learn about Clumio’s cloud-native data protectionetrecovery capabilities. Whether you’re exploring key features, understanding how Clumio helps protect les charges de travail dans le cloudou vous préparer à démarrer un essai gratuit, Clumio Chat vous apporte des réponses sans passer par un entretien commercial.


Obtenez des réponses aux véritables défis liés à la protection des données dans le cloud

Au lieu de parcourir la documentation ou d’attendre un rendez-vous, vous pouvez poser le genre de questions techniques que vous poseriez normalement à un ingénieur solutions :

  • Quelles options de Recovery Clumio propose-t-il pour Amazon S3 ?
  • Quelles autorisations Clumio requiert-il, et dois-je déployer une infrastructure de sauvegarde dans mon compte AWS ?
  • Quelle échelle Clumio prend-il en charge pour Amazon S3 ?
  • Comment Clumio contribue-t-il à réduire le coût de la protection à long terme des données dans le cloud ?


Essayez-le maintenant

Clumio Chat helps you move from product discovery to hands-on evaluation with less friction. Learn how Clumio works, explore the capabilities that matter most to you,etwhen you’re ready, créez un compteetlancez un essai gratuit.

EssayezClumio Chat todayetexperience a faster, more self-service approach to evaluating cloud-native data protection.

FAQ

Q : Qu’est-ce que Clumio Chat ?

A: Clumio Chat is an AI assistant that helps you learn about Clumio’s cloud-native backup, recovery,etcyber resilience capabilities before starting a free trial.

Q : À qui s’adresse Clumio Chat ?

A: Clumio Chat is designed for cloud architects, platform engineers, DevOps, SREs,ettechnical buyers evaluating cloud-native data protection.

Q : Quel genre de questions puis-je poser ?

A: You can ask questions about Clumio’s capabilities, deployment model, cloud workload protection, recovery options, scalability,etother technical topics related to evaluating the platform.

Q : Dois-je contacter le service commercial avant d’essayer Clumio ?

A: No. Clumio Chat is designed to help you explore the product on your . If you decide you’d like additional guidance, you can always contacter notre équipe.

Q : Où puis-je tester Clumio Chat ?

R : Rendez-vous surchat.Clumio.com, ou cliquez sur « Ask Clumio » dans la barre de navigation surClumio.com.

Vir Choksiest responsable principal du marketing produit chez Commvault.
More related posts


Backup and Recovery

Read more about Backup and Recovery

Cyber Resilience

Read more about Cyber Resilience

Cyber Resilience for Cloud Apps

Read more about Cyber Resilience for Cloud Apps