Imagine your business has just been hit by a disastrous event – be it a natural disaster, cyber-attack, or even human error, and all your company’s critical data is either lost or inaccessible. The clock is ticking, and each second of downtime spells potential financial losses and irreparable damage to your organization’s reputation. This nightmarish scenario is precisely why understanding de temps de reprise (RTO) (RTO) and accurately calculating it is crucial for businesses of all sizes. In this post, we’ll demystify RTO, guide you on determining the optimal target for your business, and share how to calculate it effectively to limit the impact of data loss, avoid catastrophe, and give you peace of mind.
A Recovery Time Objective (RTO) is the maximum amount of time that an organization can tolerate for restoring its critical systems, applications, and data after a disruption or outage. It is a indicateur clé utilisé dans la planification de la reprise après sinistre and helps organizations determine how quickly their business operations need to be resumed after a major incident. RTO can be calculated by performing a business impact analysis (BIA) and determining the recovery time needed for each application, service, system, or data component based on its criticality and loss tolerance.
Comprendre l’objectif de délai de reprise (RTO)
Lorsqu’un sinistre imprévu, tel qu’une cyberattaque ou une catastrophe naturelle, survient, les systèmes informatiques d’une organisation peuvent tomber en panne. Le processus de reprise visant à remettre ces systèmes en état de fonctionnement doit être mené à bien dans un délai précis. C’est là qu’intervient la notion d’objectif de temps de reprise (RTO). Le RTO est défini comme la durée maximale acceptable avant qu’une organisation puisse reprendre ses activités normales après une perturbation majeure.
To understand RTO better, consider the analogy of a hospital’s emergency room. In case of any life-threatening injury, it is essential to provide medical attention to the patient within a certain time frame. This time frame or duration is known as the ‘Golden Hour.’ If doctors and staff fail to provide medical aid within this hour, there are chances that the injury turns fatal, causing long-term damage. In the same way, for an organization, if critical applications and systems are not resumed within the RTO period, there could be financial and reputational damage that will hurt the business’s interests.
In today’s world, businesses rely heavily on technology systems to conduct their day-to-day activities. Any downtime or delay in resuming those critical services can lead to severe losses, including revenue, missed opportunities, unplanned expenses, decreased customer satisfaction and loss of market share. Therefore, having proper RTO planning in place is essential for swift disaster recovery.
Il arrive parfois que les organisations privilégient les coûts plutôt que la restauration rapide des services en cas de panne ou de sinistre. Or, les temps d’arrêt peuvent s’avérer bien plus coûteux que d’investir dès le départ dans des solutions de planification RTO adaptées.
Now let’s delve deeper into why RTO is important and how it can benefit your organization.
- Selon un rapport du groupe Aberdeen, 93 % des entreprises ayant subi une interruption de service de leur centre de données pendant plus de dix jours ont déposé le bilan dans l’année qui a suivi.
- Une étude menée par Gartner a révélé que le coût moyen d’une interruption informatique s’élève à 5 600 dollars par minute, ce qui souligne l’importance de disposer d’un objectif de temps de reprise (RTO) clairement défini.
- Dans une enquête menée par le Conseil de préparation à la reprise après sinistre, près des trois quarts (73 %) des entreprises ont déclaré ne pas disposer d’un délai de reprise des activités (RTO) adéquat, ce qui souligne la nécessité pour les organisations de donner la priorité à la planification de la reprise après sinistre.
Importance du RTO dans les plans de Recovery après sinistre
Le RTO joue un rôle crucial pour garantir que votre organisation puisse reprendre ses activités normales aussi rapidement que possible en cas de perturbation. Voici quelques exemples illustrant l’importance du RTO dans les plans de Recovery après sinistre :
Tout d’abord, le RTO contribue à réduire les pertes de chiffre d’affaires, l’atteinte à la réputation et les autres conséquences liées à des temps d’arrêt prolongés. Les temps d’arrêt entraînent des coûts tangibles immédiats, tels que la perte de chiffre d’affaires, ainsi que des coûts intangibles, comme la perte de confiance des clients.
Secondly, let’s consider a scenario where an accounting application is down for several days. This application is vital to the business’ operations since it takes care of all accounting activities. In this situation, failure to restore the application within the RTO duration will lead to late payments and incorrect balances that could result in loss of significant amounts of money or gradual fallbacks.
To understand how important RTO is to organizations, imagine being without your mobile phone for one day during an important project; inevitably, you’ll lose valuable time and work behind schedule on delivery deadlines.
Troisièmement, la définition du RTO aide une entreprise à identifier les systèmes informatiques critiques dont la défaillance est susceptible d’avoir l’impact le plus grave sur l’activité. L’identification claire de ces systèmes et des valeurs de RTO qui leur sont associées facilite la hiérarchisation des priorités pour les équipes informatiques lors de la restauration des systèmes, car elle permet de déterminer quels services doivent être rétablis en premier afin de maintenir la continuité des opérations.
Enfin, négliger ou mal gérer la planification du RTO peut vous induire en erreur lors du choix des technologies de reprise après sinistre adaptées à la restauration des données et applications vitales.
Comprendre à quel point les planificateurs de RTO sont essentiels dans la planification de la reprise après sinistre devrait nous inciter à réfléchir à la manière de les calculer.
RTO et Objectif de point de récupération (RPO)
Recovery time objective (RTO) and recovery point objective (RPO) are often considered together as the two most important parameters of a data protection or disaster recovery plan. While both concepts are related to data recovery in the event of a disaster, they differ in their focus.
Le RTO (temps de reprise des activités) concerne la rapidité avec laquelle une organisation peut reprendre ses activités normales après un incident majeur ayant entraîné une interruption. Le RPO (objectif de perte de données), quant à lui, se concentre sur la quantité maximale de données pouvant être perdues pendant cette période avant que cela ne devienne inacceptable.
Pour illustrer la différence entre le RTO et le RPO, imaginons une entreprise dont les activités reposent sur diverses applications et bases de données critiques. Ces applications traitent les commandes des clients, gèrent les niveaux de stock et gèrent les transactions financières. Si l’une de ces applications venait à tomber en panne en raison d’une défaillance matérielle ou d’une catastrophe naturelle, pendant combien de temps l’entreprise pourrait-elle se permettre de ne pas disposer de cette application ? Cette durée correspondrait au RTO de cette application.
Now consider what happens if there is a backup system in place but it is not able to recover all of the latest transaction data since its last backup was taken 24 hours ago. The entire day’s worth of work would be lost, leading to significant financial losses and other negative consequences. The acceptable limit for such data loss would be defined by the RPO.
Calcul du RTO pour votre organisation
The first step in calculating your organization’s RTO is to conduct a business impact analysis (BIA). This helps you identify critical systems and applications that require the highest level of availability and assess how much downtime each system can tolerate before operational disruptions negatively impact your business.
Imaginons, par exemple, une compagnie d’assurance dont l’application de traitement des sinistres tombe en panne. L’entreprise pourrait s’en sortir si l’application était hors service pendant quelques heures en dehors des heures de pointe, mais elle risquerait de subir des pertes financières importantes et une atteinte à sa réputation si elle était indisponible pendant les heures de pointe. Par conséquent, les heures de pointe pourraient être définies comme la période pendant laquelle l’objectif de temps de reprise (RTO) doit être respecté.
Une autre analogie à prendre en compte est similaire à la manière dont les hôpitaux se préparent aux catastrophes naturelles. Ils disposent d’un plan qui décrit les mesures à prendre en cas d’afflux de patients suite à un tremblement de terre ou à un ouragan. Dans le cadre de ce plan, ils définissent le délai maximal nécessaire pour rétablir le fonctionnement normal en cas d’incident perturbateur. Un hôpital ayant programmé des interventions chirurgicales critiques ce jour-là aurait des délais de RTO différents de ceux d’un hôpital n’ayant aucune intervention prévue.
Once you have identified critical systems and applications, you need to determine how quickly they need to be restored after a disaster has occurred. When calculating RTO, it’s essential to consider factors such as backup frequency, location, transport mechanism, security measures, staff capabilities, and end-user requirements.
Réalisation d’une analyse d’impact sur l’activité (BIA)
Before calculating RTO for your organization, it is important to conduct a business impact analysis (BIA). The BIA involves evaluating the potential effects of a disaster or system failure on critical business functions. It is important to note that BIA is separate from the disaster recovery planning process as it instead focuses on understanding the potential impact of disruptions on key business functions.
Par exemple, mi-2020, de nombreuses entreprises ont été prises au dépourvu par le passage rapide au télétravail en raison de la COVID-19. Les entreprises qui s’appuyaient auparavant sur des solutions sur site ont eu du mal à adapter leurs systèmes pour prendre en charge un personnel travaillant à distance. Afin d’éviter de tels problèmes à l’avenir et de mieux comprendre les risques associés à ce type de perturbation, les entreprises devraient envisager de réaliser une BIA.
Pour entamer le processus d’analyse, les organisations doivent identifier les principales parties prenantes issues de l’ensemble des services et des domaines fonctionnels. Cette équipe doit recueillir des informations sur chaque fonction métier critique et déterminer pendant combien de temps chacune d’entre elles peut être perturbée avant de causer un préjudice significatif aux opérations.
Il est également important que les organisations prennent en compte à la fois les répercussions directes et indirectes d’une perturbation. Les répercussions directes peuvent notamment se traduire par un arrêt de la production, tandis que les répercussions indirectes peuvent inclure une perte de chiffre d’affaires due à des problèmes liés à la chaîne d’approvisionnement. La prise en compte de ces différents types de répercussions peut permettre d’acquérir une vision globale des répercussions potentielles.
Comparing a business to a building with multiple levels can help visualize this process. Each level represents different aspects of business functions and processes, such as finance or supply chain management. You must diligently map every floor’s contents within your business context and determine what happens if you remove specific parts partially or completely.
Once you’ve completed your BIA and identified all critical business functions, you’re ready to move on to the next step: identifying critical systems and applications.
Identification des systèmes et applications critiques
L’identification des systèmes et applications critiques est essentielle à l’élaboration d’un plan de reprise après sinistre. Ce processus d’identification doit consister à déterminer quels systèmes et applications informatiques sont indispensables au bon fonctionnement des activités identifiées dans l’analyse d’impact sur les activités (BIA).
Par exemple, un fabricant serait susceptible de considérer ses systèmes de production comme des applications d’importance vitale, tandis qu’un établissement financier pourrait se concentrer sur ses applications de négociation ou ses applications bancaires de base. Dans tous les cas, cependant, toute application indispensable au bon fonctionnement des opérations critiques doit être répertoriée et analysée.
Once you’ve identified your critical applications, it’s also essential to examine dependencies between them. This includes examining the infrastructure and hardware components required for each application’s proper functioning.
Il est recommandé d’étendre le suivi des dépendances au-delà des couches principales, car une modification au deuxième niveau des dépendances peut encore avoir des répercussions secondaires susceptibles de se répercuter en cascade sur des applications critiques.
Pour approfondir l’étude de ces dépendances, les analystes système ont souvent recours à des organigrammes afin de détailler le flux de travail prévu ou les transferts de données entre les applications. La visualisation des interconnexions entre les différents systèmes permet de hiérarchiser plus facilement les procédures de reprise et de mettre en œuvre des mesures de résilience plus complètes.
After carefully analyzing your organization’s critical systems and dependencies between them, you’ll be well-prepared to select suitable disaster recovery technologies in our next section.
Mise en œuvre et amélioration des stratégies RTO
Once you have calculated your organization’s Recovery Time Objective (RTO), it is crucial to implement and improve strategies that will help you achieve the desired recovery time. One of the key components of implementing an efficient RTO strategy is ensuring that all stakeholders understand their respective roles during a disaster or crisis.
Il est indispensable d’organiser des formations continues à l’intention tant des employés que du personnel informatique sur les procédures et les plans de reprise après sinistre. Des simulations peuvent être organisées périodiquement afin de s’assurer que chacun comprend les procédures, mais aussi pour tester l’efficacité des systèmes, des technologies et du personnel.
De plus, l’évaluation régulière de l’efficacité des stratégies RTO permet d’identifier les domaines nécessitant des améliorations. Il est essentiel de toujours rechercher des moyens de s’améliorer et de proposer des solutions de sauvegarde plus efficaces. Cela peut impliquer un changement de technologie, la mise à jour de logiciels ou la réalisation de mises à niveau régulières du matériel.
One company based in New York City learned this lesson after storms caused severe flooding of data centers within their region. Power outages resulted in catastrophic data loss, including losing our clients’ vital information stored in storage devices.
En réponse, nous avons renforcé nos services d’infrastructure dans le cloud, garantissant ainsi à nos clients un accès continu et à distance aux sauvegardes de leurs données en cas de problème. Grâce au respect rigoureux par notre équipe d’experts des politiques de confidentialité et des exigences de conformité en matière de réglementation du stockage, nous avons offert à nos clients la tranquillité d’esprit, en leur garantissant la sécurité de leurs opérations métier critiques.
Evaluating backup data can also give insight into additional improvements required on top of existing strategies. If specific applications are taking too long to back up regularly, upgrading them using modern infrastructure with higher capacity might be necessary.
Une autre façon d’améliorer votre stratégie RTO consisterait à mettre en place des outils d’automatisation permettant aux équipes informatiques de réagir rapidement et efficacement aux situations d’urgence sans perturber la productivité quotidienne. De plus, l’automatisation des tâches répétitives ou prévisibles peut permettre aux professionnels de l’informatique de consacrer davantage de temps à des aspects plus complexes, tels que la surveillance des performances des logiciels et la réalisation d’exercices réguliers.
Choix des technologies adaptées à la reprise après sinistre
Il est essentiel de choisir les technologies de reprise après sinistre les mieux adaptées aux besoins spécifiques de votre entreprise. Les applications critiques pour l’activité exigent un objectif de temps de reprise (RTO) favorisant une reprise rapide, tandis que d’autres applications non critiques peuvent se permettre un RTO plus élevé.
When looking for the perfect disaster recovery technology, you’ll need to consider aspects such as security, costs, scalability, and your organization’s technological capabilities. Cloud-based services are increasingly popular due to their accessibility, scalability, and low capital investment costs.
Amazon Web Services (AWS) est l’un des fournisseurs de services cloud utilisés par plusieurs grandes entreprises telles qu’Airbnb et Netflix. Grâce à AWS, les organisations peuvent déployer des plans de Recovery dans plusieurs zones et régions afin d’assurer une redondance en cas de sinistre ou de perte de données.
Une autre option technologique disponible est la réplication synchrone entre sites. Cela nécessite de disposer de centres de données répliqués, associés à des paramètres de basculement qui minimisent les perturbations en cas de crise sociétale. Les réseaux WAN (Wide Area Networking) définis par logiciel et les connexions par fibre optique constituent tous deux des options viables pour synchroniser les centres de données répliqués afin de garantir des délais de rétablissement (RTO) quasi nuls.
Un débat important porte sur le choix entre des sites de secours « chauds » ou « froids » en cas de basculement d’une application essentielle suite à une catastrophe. Un site « chaud » désigne un centre de secours prêt à l’emploi qui reproduit à l’identique tant les opérations de données que l’infrastructure ; il permet une reprise immédiate des opérations normales, mais peut entraîner des coûts plus élevés. Un site « froid », en revanche, nécessite davantage de préparation avant que la bascule puisse avoir lieu, mais son coût est moindre.
En identifiant les applications essentielles et en procédant à une sélection rigoureuse des zones et des régions au sein de différents centres de données, le choix de technologies de reprise après sinistre adaptées s’avérera globalement bénéfique, quelle que soit la solution retenue.
- Il est essentiel de choisir les meilleures technologies de reprise après sinistre adaptées aux besoins spécifiques de votre entreprise, et plusieurs options s’offrent à vous pour répondre à différents objectifs de délai de reprise (RTO). Les services basés sur le cloud, tels qu’AWS, offrent accessibilité, évolutivité et faibles coûts d’investissement. La réplication synchrone entre sites peut minimiser les perturbations en cas de crise sociétale, tandis que les réseaux WAN définis par logiciel et les connexions par fibre optique peuvent garantir des délais de reprise (RTO) quasi nuls. Le choix entre des sites de secours « à chaud » ou « à froid » dépend du niveau de préparation et de considérations de coût. Globalement, l’identification des applications critiques et la sélection rigoureuse de technologies de reprise après sinistre adaptées dans divers centres de données peuvent apporter des avantages significatifs à toute organisation.
Suivi et ajustement du RTO au fil du temps
Une fois que vous aurez calculé votre objectif de délai de reprise (RTO) et mis en œuvre les stratégies nécessaires pour l’atteindre, votre travail ne sera pas encore terminé. Le suivi et l’ajustement de votre RTO vous permettront de vous assurer qu’il reste pertinent et efficace pour atténuer les effets de sinistres ou de pannes imprévus.
Let’s say that a few months after calculating your RTO and implementing recovery strategies, you experience a major data breach that takes down your critical systems for several hours. This incident could reveal weaknesses in your RTO plan and requirements, leading to necessary adjustments for future readiness. By analyzing the data from the incident, you can determine if the RTO needs to be adjusted based on factors like the severity of the disaster or failure or if new technologies would better facilitate data restoration.
À mesure que la technologie évolue constamment, il en va de même pour les outils disponibles pour la restauration des données critiques. Par conséquent, les services informatiques doivent se tenir informés des nouvelles alternatives ou des versions améliorées des technologies existantes susceptibles de combler les lacunes potentielles de leur plan RTO actuel. Un excellent moyen de suivre les avancées dans ce secteur consiste à participer à des conférences technologiques ou à des webinaires qui expliquent les tendances émergentes et offrent aux organisations l’occasion de nouer des contacts avec des experts du secteur.
D’un autre côté, certaines organisations pourraient faire valoir qu’il n’est pas nécessaire de surveiller les délais de reprise des activités (RTO), tant que leurs calculs initiaux sont suffisamment solides pour faire face à toutes les éventualités. Cependant, cet argument néglige la nature évolutive des systèmes technologiques, où les choses peuvent changer aussi rapidement qu’une mise à jour logicielle effectuée du jour au lendemain ou l’apparition d’un outil de piratage dans les milieux criminels.
Monitoring and adjusting your RTO is similar to driving a car. Once you set out on the road, you don’t just settle down and forget about caution altogether because you believe everything went well at the start. A vigilant driver continuously monitors their environment by regularly checking mirrors and avoiding hazards as they appear along their path. Any sudden changes on the road like a blown tire or engine trouble will require quick thinking and new strategies, much like how IT organizations must adapt quickly to emerging security threats or IT failures.
So there you have it, monitoring and adjusting RTO over time is crucial for all organizations’ disaster recovery plans. By being vigilant in paying attention to potential threats and keeping track of technological advancements, you can ensure that your system remains robust and effective in the long run. Remember, recovery does not end after the implementation phase, for an efficient plan should account for any dynamic changes that might occur in an ever-evolving technological landscape.
Quel rôle jouent la technologie et les infrastructures dans la réalisation des RTO souhaités ?
La technologie et l’infrastructure constituent des éléments essentiels pour atteindre les objectifs de temps de reprise (RTO) souhaités. Une technologie et une infrastructure adaptées peuvent aider les entreprises à se remettre plus rapidement d’une éventuelle interruption d’activité, réduisant ainsi l’impact négatif sur leurs opérations, leurs clients et leurs résultats financiers.
For instance, implementing a robust backup and recovery system that leverages cloud computing technologies can enable organizations to restore important data or applications in a matter of minutes. Additionally, having a resilient IT infrastructure with redundant systems, automated failover processes, and disaster recovery plans can significantly reduce RTOs.
Selon une étude récente menée par Veeam Software, 84 % des entreprises ont déclaré avoir subi des incidents entraînant des temps d’arrêt au cours de l’année écoulée. Parmi celles-ci, 33 % ont perdu l’accès à leurs systèmes critiques pendant une heure ou plus. De plus, des études indiquent que les temps d’arrêt imprévus peuvent coûter aux entreprises jusqu’à 5 600 dollars par minute.
En conclusion, la technologie et les infrastructures jouent un rôle essentiel non seulement pour respecter les délais de reprise d’activité (RTO) visés, mais aussi pour minimiser les risques opérationnels liés aux incidents entraînant des temps d’arrêt. En investissant dans les outils technologiques et les solutions d’infrastructure adaptés, les entreprises peuvent considérablement améliorer leur résilience opérationnelle et réduire au minimum les pertes financières potentielles causées par des pannes imprévues.
En quoi le RTO diffère-t-il de l’objectif de point de reprise (RPO) ?
L’objectif de délai de reprise (RTO) et l’objectif de point de reprise (RPO) sont deux indicateurs essentiels dont les organisations doivent tenir compte lors de l’élaboration de leurs plans de reprise après sinistre. Bien que certains puissent utiliser ces termes de manière interchangeable, ils ne désignent pas la même chose.
En résumé, le RTO définit la durée pendant laquelle une organisation peut se passer d’un système ou d’une application donnée avant de commencer à subir des pertes financières importantes ou d’autres conséquences négatives. D’autre part, le RPO (Recovery Point Objective) précise la quantité maximale de données qu’une organisation peut se permettre de perdre à la suite d’une interruption avant de subir des dommages importants.
For example, if a company has an RTO of two hours, it means that it can only tolerate up to two hours of downtime before suffering severe consequences such as losing customers or revenue. On the other hand, if an organization has an RPO of one hour, it implies that it can only afford to lose up to one hour’s worth of data before experiencing significant damage.
Pour mettre les choses en perspective : selon une étude menée par IBM, chaque minute d’indisponibilité imprévue coûte en moyenne environ 8 851 dollars aux entreprises. De plus, une étude d’IDC suggère que le coût moyen d’une indisponibilité pour les applications critiques s’élève à environ 100 000 dollars par heure.
Il est donc essentiel de définir des RTO et des RPO réalistes pour votre organisation afin de réduire au minimum les temps d’arrêt et d’éviter les pertes financières. Gardez toutefois à l’esprit que ces indicateurs doivent également s’aligner sur vos objectifs et vos besoins métier, car des objectifs trop ambitieux pourraient s’avérer difficiles à atteindre et à maintenir sans surcharger vos ressources.
Quels sont les facteurs qui déterminent le RTO approprié pour une entreprise ou une organisation ?
Pour définir un objectif de délai de reprise (RTO) adapté à une entreprise ou à une organisation, il convient de prendre en compte plusieurs facteurs. Le RTO doit être déterminé en fonction de l’impact potentiel d’une interruption de service et de la rapidité avec laquelle l’organisation doit reprendre ses activités. Parmi les facteurs qui déterminent un RTO adapté, on peut citer :
- Business Impact Analysis (BIA) – A BIA helps identify critical systems, data, and applications that are essential for business continuity. By prioritizing these aspects, organizations can develop recovery plans with specific RTOs that align with their importance.
- Industry Standards – Certain industries such as healthcare or financial services have stricter regulatory requirements that dictate specific RTOs for protecting sensitive data and ensuring uninterrupted operation.
- Financial Implications – According to a study by the Ponemon Institute, the average cost of data center downtime has risen to $9,000 per minute in 2021. Therefore, an organization’s financial situation plays a significant role in determining an appropriate RTO as it impacts both short-term revenue loss and long-term reputation damage.
- Technology Infrastructure – The RTO should be based on the organization’s technological capabilities, including hardware, software, and network infrastructure. This includes assessing redundancy levels of IT systems and ensuring backup solutions are available to minimize recovery time.
In summary, determining an appropriate RTO requires understanding the potential impact of system downtime on your business operations, analyzing your critical systems and data, and balancing financial implications with technology infrastructure capabilities. By taking a proactive approach towards disaster recovery planning, businesses can minimize downtime while ensuring seamless business continuity during unexpected failures or disruptions.
Quelles sont les erreurs courantes commises par les entreprises lors de la mise en place de centres de reprise d’activité (RTO), et comment peut-on les éviter ?
La définition d’un objectif de délai de reprise (RTO) est essentielle pour permettre aux entreprises de planifier et de se préparer aux catastrophes, aux cyberattaques et à d’autres perturbations potentielles. Cependant, les entreprises commettent souvent certaines erreurs courantes lorsqu’elles déterminent leurs RTO.
L’une des erreurs les plus graves consiste à fixer un RTO irréaliste. Selon une enquête menée par IDG, 28 % des professionnels de l’informatique admettent avoir fixé des RTO irréalisables. Fixer un RTO sans tenir compte des ressources disponibles ni tester le plan peut entraîner des temps d’arrêt, une perte de chiffre d’affaires et une atteinte à la réputation.
Une autre erreur courante consiste à ne pas revoir ni mettre à jour régulièrement le RTO. À mesure que les entreprises se développent et que les technologies évoluent, les risques potentiels et les solutions requises changent également. Le Disaster Recovery Preparedness Council indique que 60 % des organisations n’ont pas mis à jour leurs plans de reprise après sinistre depuis plus d’un an, ce qui se traduit par des plans obsolètes et inefficaces.
To avoid these mistakes, businesses need to conduct risk assessments, test their disaster recovery plans regularly and consult with experts in business continuity planning. It’s essential to establish an achievable RTO based on the needs and capabilities of your organization. A realistic plan will allow you to recover quickly while minimizing costs.
En résumé, pour éviter les erreurs courantes consistant à fixer des délais de reprise d’activité (RTO) irréalistes ou à ne pas les mettre à jour régulièrement, il est nécessaire de s’engager dans un processus continu de préparation, de planification et de consultation avec les experts en reprise après sinistre au sein des organisations.
Comment les entreprises peuvent-elles réduire au minimum leur délai de reprise des activités (RTO) en cas de sinistre ou de panne ?
Les entreprises peuvent réduire au minimum leur objectif de délai de Recovery (RTO) en mettant en œuvre les stratégies suivantes :
- Mettre en place un plan complet de reprise après sinistre : un plan bien documenté permet d’éviter la confusion et facilite la remise en service rapide des systèmes. Selon une étude de Gartner, seules 35 % des petites et moyennes entreprises disposent d’un plan de reprise après sinistre.
- Investir dans des infrastructures résilientes : une infrastructure informatique robuste, dotée de redondances multiples, de groupes électrogènes de secours et de sources d’alimentation alternatives, garantit la continuité des activités même en cas de panne.
- Effectuez régulièrement des sauvegardes : grâce à des sauvegardes régulières, vos données sont toujours à jour et disponibles en cas de besoin. 60 % des petites entreprises ferment leurs portes dans les six mois suivant une perte importante de données, faute de solutions de sauvegarde adéquates.
- Adopter des solutions basées sur le cloud : les solutions basées sur le cloud offrent une flexibilité et une évolutivité dont les solutions traditionnelles sur site sont dépourvues, ce qui permet des temps de Recovery plus courts, selon 95 % des professionnels de l’informatique interrogés.
- En mettant en œuvre ces mesures, ainsi que d’autres adaptées à leur secteur d’activité et à leurs besoins spécifiques, les entreprises peuvent garantir des délais de reprise d’activité (RTO) minimaux en cas de sinistre ou d’interruption de service, limitant ainsi au maximum les pertes potentielles tant en termes de chiffre d’affaires que de réputation.
Respectez ou dépassez vos objectifs de temps de reprise (RTO) grâce à Clumio
Disaster recovery planning is essential for enterprises of all sizes looking to ensure business continuity during malicious attacks, downtime, and disruptions to infrastructure. Good data backups and a well-defined recovery process are critical elements of this planning.
Having a viable RTO—and the ability to meet or exceed the RTO—is a vital component to protecting both your business and its customers.
As a cloud-native data protection backup-as-a-service platform, Clumio’s industry-leading rapid recovery capabilities provide enterprises with quick and reliable data restores to help ensure business continuity in the face of downtime to critical infrastructure.
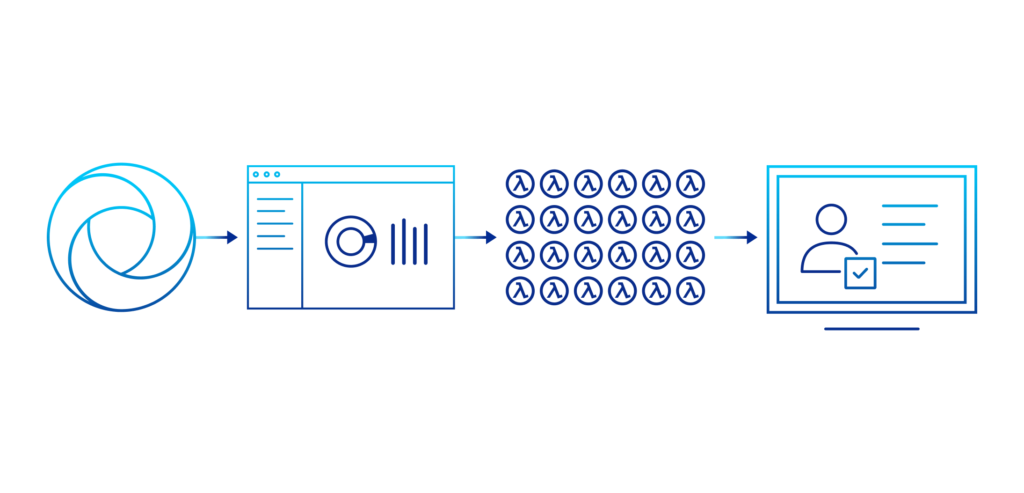
En offrant un moyen simple de restaurer une instance dans son intégralité, mais aussi de récupérer de manière granulaire des fichiers, des enregistrements ou des boîtes aux lettres individuels, Clumio optimise la récupération des données afin de respecter facilement, voire de dépasser, vos RTO actuels.
Sujets connexes :
L’essentiel de la protection des données : RTO vs. RPO
Découvrez les principes fondamentaux de la protection des données : la différence entre le RTO (objectif de délai de reprise) et le RPO (objectif de point de reprise) pour un Backup and Recovery efficace.
Qu’est-ce que le RPO ? L’importance de l’objectif de point de récupération (RPO) dans votre plan de continuité des activités
Learn why Recovery Point Objective is vital to an enterprise’s business continuity plan in today’s risk-filled environment where threats like malware and ransomware are now commonplace. Implementing effective data backups and setting recovery objectives will help secure your business’s future.
Explorer les options de sauvegarde Cloud : Une liste de points à prendre en compte
Examine your available options for cloud backup and learn why a cloud-native solution specifically designed for the cloud is the best choice for everything from ransomware protection to faster data recovery and easier compliance. This is particularly important for businesses and organizations with complex network environments and specific requirements.
Le rôle de la reprise après sinistre dans un plan de continuité d’activité destiné aux entreprises et aux organisations
Read about the key role disaster recovery plays in a business continuity plan and learn why your choice of cloud backup can affect the speed of recovery.
Comment une solution de sauvegarde dans le cloud adaptée permet une reprise après sinistre plus rapide dans divers environnements réseau
When a disaster event (such as a ransomware attack) strikes, disaster recovery planning is paramount for businesses and organizations operating in various network environments. Learn about the key capabilities a cloud backup solution should provide to enable faster disaster recovery.
Qu’est-ce qu’une politique de conservation des données ?
Apprenez les bases de la politique de conservation des données et découvrez comment la sauvegarde cloud appropriée peut simplifier votre conformité tout en sécurisant les données de sauvegarde, en répondant aux besoins distincts des entreprises et des organisations dans différents secteurs d’activité.