Imagine your business has just been hit by a disastrous event – be it a natural disaster, cyber-attack, or even human error, and all your company’s critical data is either lost or inaccessible. The clock is ticking, and each second of downtime spells potential financial losses and irreparable damage to your organization’s reputation. This nightmarish scenario is precisely why understanding il Recovery Time Objective (RTO) and accurately calculating it is crucial for businesses of all sizes. In this post, we’ll demystify RTO, guide you on determining the optimal target for your business, and share how to calculate it effectively to limit the impact of data loss, avoid catastrophe, and give you peace of mind.
A Recovery Time Objective (RTO) is the maximum amount of time that an organization can tolerate for restoring its critical systems, applications, and data after a disruption or outage. It is a indicatore chiave utilizzato nella pianificazione del ripristino di emergenza and helps organizations determine how quickly their business operations need to be resumed after a major incident. RTO can be calculated by performing a business impact analysis (BIA) and determining the recovery time needed for each application, service, system, or data component based on its criticality and loss tolerance.
Comprendere l’obiettivo di tempo di Recovery (RTO)
Quando si verifica un evento imprevisto, come un attacco informatico o una calamità naturale, i sistemi IT di un’organizzazione potrebbero subire un’interruzione. Il processo di ripristino necessario a riportare tali sistemi in funzione dovrà essere completato entro un determinato lasso di tempo. È qui che entra in gioco il concetto di Recovery Time Objective (RTO). L’RTO è definito come il periodo di tempo massimo accettabile prima che un’organizzazione possa riprendere le normali operazioni aziendali a seguito di un’interruzione significativa.
To understand RTO better, consider the analogy of a hospital’s emergency room. In case of any life-threatening injury, it is essential to provide medical attention to the patient within a certain time frame. This time frame or duration is known as the ‘Golden Hour.’ If doctors and staff fail to provide medical aid within this hour, there are chances that the injury turns fatal, causing long-term damage. In the same way, for an organization, if critical applications and systems are not resumed within the RTO period, there could be financial and reputational damage that will hurt the business’s interests.
In today’s world, businesses rely heavily on technology systems to conduct their day-to-day activities. Any downtime or delay in resuming those critical services can lead to severe losses, including revenue, missed opportunities, unplanned expenses, decreased customer satisfaction and loss of market share. Therefore, having proper RTO planning in place is essential for swift disaster recovery.
A volte le organizzazioni danno la priorità ai costi rispetto al rapido ripristino del servizio in caso di guasto o disastro. Tuttavia, i tempi di inattività potrebbero rivelarsi molto più costosi rispetto all’investimento in adeguate opzioni di pianificazione dell’RTO sin dall’inizio.
Now let’s delve deeper into why RTO is important and how it can benefit your organization.
- Secondo un rapporto dell’Aberdeen Group, il 93% delle aziende che hanno subito un’interruzione dell’attività del data center per più di dieci giorni ha presentato istanza di fallimento entro un anno.
- Uno studio condotto da Gartner ha rivelato che il costo medio dei tempi di inattività dei sistemi IT è pari a 5.600 dollari al minuto, sottolineando l’importanza di disporre di un Recovery Time Objective (RTO) ben definito.
- In un sondaggio condotto dal Disaster Recovery Preparedness Council, quasi tre quarti (73%) delle aziende hanno dichiarato di non disporre di un RTO adeguato, evidenziando la necessità che le organizzazioni diano priorità alla pianificazione del ripristino di emergenza.
L’importanza dell’RTO nei piani di Recovery in caso di calamità
L’RTO svolge un ruolo fondamentale nel garantire che la vostra organizzazione possa riprendere le normali operazioni il più rapidamente possibile in caso di interruzione. Di seguito sono riportati alcuni esempi che illustrano l’importanza dell’RTO nei piani di Recovery:
In primo luogo, l’RTO contribuisce a ridurre la perdita di ricavi, il danno alla reputazione e altre conseguenze causate da tempi di inattività prolungati. I tempi di inattività comportano costi tangibili immediati, come la perdita di ricavi, e costi intangibili, quali la perdita di fiducia da parte dei clienti.
Secondly, let’s consider a scenario where an accounting application is down for several days. This application is vital to the business’ operations since it takes care of all accounting activities. In this situation, failure to restore the application within the RTO duration will lead to late payments and incorrect balances that could result in loss of significant amounts of money or gradual fallbacks.
To understand how important RTO is to organizations, imagine being without your mobile phone for one day during an important project; inevitably, you’ll lose valuable time and work behind schedule on delivery deadlines.
In terzo luogo, definire l’RTO aiuta un’azienda a identificare i sistemi IT critici che, in caso di guasto, potrebbero causare l’impatto più grave sull’attività. Una chiara identificazione di questi sistemi e dei relativi valori di RTO facilita il lavoro dei team IT nella definizione delle priorità durante il ripristino dei sistemi, poiché determina quali servizi devono essere ripristinati per primi per mantenere la continuità operativa.
Infine, ignorare o gestire in modo errato la pianificazione dell’RTO può portare a scelte sbagliate nel determinare quali tecnologie di Disaster Recovery siano adatte al ripristino di dati e applicazioni vitali.
Comprendere quanto siano cruciali i pianificatori dell’RTO nella pianificazione del Disaster Recovery dovrebbe spingerci a riflettere su come calcolarli.
RTO e Obiettivo del punto di recupero (RPO)
Recovery time objective (RTO) and recovery point objective (RPO) are often considered together as the two most important parameters of a data protection or disaster recovery plan. While both concepts are related to data recovery in the event of a disaster, they differ in their focus.
L’RTO riguarda la rapidità con cui un’organizzazione è in grado di riprendere le normali operazioni aziendali dopo il verificarsi di un incidente grave che abbia causato un’interruzione. L’RPO, invece, si concentra sulla quantità massima di dati che può andare persa durante questo periodo prima che la perdita diventi inaccettabile.
Per illustrare la differenza tra RTO e RPO, immaginiamo un’azienda che svolge la propria attività avvalendosi di varie applicazioni e database critici. Queste applicazioni elaborano gli ordini dei clienti, gestiscono i livelli delle scorte e si occupano delle transazioni finanziarie. Se una di queste applicazioni smettesse di funzionare a causa di un guasto hardware o di un disastro naturale, per quanto tempo l’azienda potrebbe permettersi che l’applicazione rimanesse indisponibile? Tale durata rappresenterebbe l’RTO per quell’applicazione.
Now consider what happens if there is a backup system in place but it is not able to recover all of the latest transaction data since its last backup was taken 24 hours ago. The entire day’s worth of work would be lost, leading to significant financial losses and other negative consequences. The acceptable limit for such data loss would be defined by the RPO.
Come calcolare l’RTO per la propria organizzazione
The first step in calculating your organization’s RTO is to conduct a business impact analysis (BIA). This helps you identify critical systems and applications that require the highest level of availability and assess how much downtime each system can tolerate before operational disruptions negatively impact your business.
Ad esempio, immaginiamo una compagnia assicurativa il cui sistema di gestione dei sinistri smetta di funzionare. L’azienda potrebbe riuscire a sopravvivere se il sistema rimanesse offline per alcune ore durante le fasce orarie di minor traffico, ma potrebbe subire perdite finanziarie significative e danni alla propria reputazione se non fosse disponibile durante le ore di punta. Pertanto, le ore di punta potrebbero essere definite come il periodo durante il quale deve essere rispettato l’RTO.
Un’altra analogia da considerare è simile al modo in cui gli ospedali si preparano alle catastrofi naturali. Dispongono infatti di un piano che delinea le azioni da intraprendere in caso di afflusso massiccio di pazienti a seguito di un terremoto o di un uragano. All’interno di questo piano, definiscono il tempo massimo necessario per ripristinare la piena operatività nel caso in cui si verifichi un evento che ne comprometta il funzionamento. Un ospedale con interventi chirurgici critici in programma quel giorno avrebbe tempistiche di RTO diverse rispetto a uno in cui non sono previsti interventi.
Once you have identified critical systems and applications, you need to determine how quickly they need to be restored after a disaster has occurred. When calculating RTO, it’s essential to consider factors such as backup frequency, location, transport mechanism, security measures, staff capabilities, and end-user requirements.
Come condurre un’analisi dell’impatto aziendale (BIA)
Before calculating RTO for your organization, it is important to conduct a business impact analysis (BIA). The BIA involves evaluating the potential effects of a disaster or system failure on critical business functions. It is important to note that BIA is separate from the disaster recovery planning process as it instead focuses on understanding the potential impact of disruptions on key business functions.
Ad esempio, a metà del 2020, molte organizzazioni sono state colte alla sprovvista dal rapido passaggio al lavoro da remoto a causa del COVID-19. Le aziende che in precedenza facevano affidamento su soluzioni on-premise hanno faticato ad adattare i propri sistemi per supportare una forza lavoro in remoto. Per prevenire tali problemi in futuro e comprendere meglio i rischi associati a questo tipo di interruzione, le aziende dovrebbero prendere in considerazione la conduzione di una BIA.
Per avviare il processo di analisi, le organizzazioni dovrebbero identificare le principali parti interessate provenienti da tutti i reparti e le aree funzionali. Questo team dovrebbe raccogliere informazioni su ogni funzione aziendale critica e determinare per quanto tempo ciascuna di esse possa subire un’interruzione prima di causare un danno significativo alle operazioni.
È inoltre importante che le organizzazioni prendano in considerazione sia gli impatti diretti che quelli indiretti delle interruzioni. Gli impatti diretti potrebbero includere l’interruzione della produzione, mentre gli effetti indiretti potrebbero comprendere la perdita di vendite dovuta a problemi nella catena di approvvigionamento. Tenere conto di questi diversi tipi di effetti può aiutare a comprendere in modo completo i potenziali impatti.
Comparing a business to a building with multiple levels can help visualize this process. Each level represents different aspects of business functions and processes, such as finance or supply chain management. You must diligently map every floor’s contents within your business context and determine what happens if you remove specific parts partially or completely.
Once you’ve completed your BIA and identified all critical business functions, you’re ready to move on to the next step: identifying critical systems and applications.
Identificazione dei sistemi e delle applicazioni critici
L’identificazione dei sistemi e delle applicazioni critici è fondamentale per l’elaborazione di un piano di Recovery di emergenza. Il processo di identificazione dovrebbe prevedere un’analisi approfondita dei sistemi e delle applicazioni IT essenziali per supportare le funzioni aziendali individuate nella valutazione dell’impatto sul business (BIA).
Ad esempio, un produttore identificherebbe probabilmente i sistemi di produzione come un’applicazione di importanza cruciale, mentre un istituto finanziario potrebbe concentrarsi sulle proprie applicazioni di trading o bancarie di base. In ogni caso, tuttavia, qualsiasi applicazione che sia fondamentale per supportare le operazioni critiche deve essere documentata e analizzata.
Once you’ve identified your critical applications, it’s also essential to examine dependencies between them. This includes examining the infrastructure and hardware components required for each application’s proper functioning.
Si raccomanda di prendere in considerazione il monitoraggio delle dipendenze anche al di là dei livelli primari, poiché una modifica al secondo livello delle dipendenze può comunque avere effetti secondari in grado di propagarsi a cascata fino alle applicazioni critiche.
Per approfondire l’analisi di queste dipendenze, gli analisti di sistema ricorrevano spesso a diagrammi di flusso per illustrare in dettaglio il flusso di lavoro previsto o i movimenti dei dati tra le applicazioni. Visualizzando l’interconnessione tra i diversi sistemi, diventa più facile stabilire le priorità delle procedure di Recovery e implementare misure di resilienza più complete.
After carefully analyzing your organization’s critical systems and dependencies between them, you’ll be well-prepared to select suitable disaster recovery technologies in our next section.
Attuazione e miglioramento delle strategie RTO
Once you have calculated your organization’s Recovery Time Objective (RTO), it is crucial to implement and improve strategies that will help you achieve the desired recovery time. One of the key components of implementing an efficient RTO strategy is ensuring that all stakeholders understand their respective roles during a disaster or crisis.
È essenziale garantire una formazione continua sia ai dipendenti che al personale IT sulle procedure e sui piani di ripristino in caso di disastro. È possibile condurre simulazioni periodiche per garantire che tutti comprendano le procedure, nonché per testare l’efficacia dei sistemi, delle tecnologie e del personale.
Inoltre, la verifica periodica dell’efficacia delle strategie RTO può mettere in luce le aree che necessitano di miglioramenti. È essenziale cercare sempre modi per migliorare e rendere disponibili soluzioni di backup più efficaci. Ciò potrebbe comportare un cambiamento della tecnologia esistente, l’aggiornamento del software o l’esecuzione di aggiornamenti periodici dell’hardware.
One company based in New York City learned this lesson after storms caused severe flooding of data centers within their region. Power outages resulted in catastrophic data loss, including losing our clients’ vital information stored in storage devices.
In risposta, abbiamo potenziato i nostri servizi di infrastruttura basati sul cloud, garantendo ai nostri clienti la possibilità di accedere continuamente ai backup dei dati da remoto in caso di problemi. Grazie alle rigorose politiche sulla privacy e ai requisiti di conformità alle normative sull’archiviazione rispettati dal nostro team di esperti, abbiamo offerto ai nostri clienti la tranquillità di sapere che le loro operazioni aziendali critiche erano al sicuro.
Evaluating backup data can also give insight into additional improvements required on top of existing strategies. If specific applications are taking too long to back up regularly, upgrading them using modern infrastructure with higher capacity might be necessary.
Un altro modo per migliorare la propria strategia RTO consiste nell’implementare strumenti di automazione che consentano ai team IT di rispondere in modo rapido ed efficiente alle emergenze senza interrompere la normale produttività. Inoltre, l’automazione delle attività ripetitive o prevedibili può consentire ai professionisti IT di dedicare più tempo ad aspetti più complessi, come il monitoraggio delle prestazioni del software e lo svolgimento di esercitazioni periodiche.
Scelta delle tecnologie adeguate per il Recovery di emergenza
È fondamentale scegliere le migliori tecnologie di disaster recovery in base alle esigenze specifiche della propria azienda. Le applicazioni business-critical richiedono un obiettivo di tempo di ripristino (RTO) che garantisca una rapida operatività, mentre altre applicazioni non critiche potrebbero avere un RTO più elevato.
When looking for the perfect disaster recovery technology, you’ll need to consider aspects such as security, costs, scalability, and your organization’s technological capabilities. Cloud-based services are increasingly popular due to their accessibility, scalability, and low capital investment costs.
Amazon Web Services (AWS) è un provider cloud utilizzato da diverse grandi aziende, come Airbnb e Netflix. Con AWS, le organizzazioni possono implementare piani di Recovery in più zone e regioni per garantire la ridondanza in caso di disastri o interruzioni dei dati.
Un’altra opzione tecnologica disponibile è la replica sincrona tra siti. Ciò richiede la presenza di data center replicati abbinati a impostazioni di failover che riducano al minimo le interruzioni durante un collasso sociale. Sia le WAN (Wide Area Networking) definite dal software che le connessioni in fibra ottica sono opzioni valide per sincronizzare i data center replicati e garantire tempi di RTO (Recovery Time Objective) quasi pari a zero.
Un dibattito importante verte sulla scelta tra siti di standby “hot” o “cold” in vista di un failover delle applicazioni essenziali in caso di disastro. Un sito “hot” è un centro di backup pronto all’uso che rispecchia sia le operazioni sui dati sia l’infrastruttura; consente la ripresa immediata delle normali operazioni, ma potrebbe comportare costi più elevati. Un sito “cold”, invece, richiede una maggiore preparazione prima che possa avvenire il passaggio, ma comporta minori spese.
Identificando le applicazioni fondamentali e procedendo a un’attenta selezione delle zone e delle regioni nei vari data center, la scelta di tecnologie adeguate per il Disaster Recovery si rivelerà complessivamente vantaggiosa, indipendentemente dalla soluzione scelta.
- La scelta delle migliori tecnologie di disaster recovery per le vostre specifiche esigenze aziendali è fondamentale, e sono disponibili diverse opzioni per soddisfare diversi obiettivi di tempo di ripristino (RTO). I servizi basati sul cloud, come AWS, offrono accessibilità, scalabilità e bassi costi di investimento. La replica sincrona tra i siti può ridurre al minimo le interruzioni durante un’emergenza, mentre le WAN definite dal software e le connessioni in fibra ottica possono garantire tempi di ripristino (RTO) quasi pari a zero. La scelta tra siti di standby “hot” o “cold” dipende dal livello di preparazione e da considerazioni di costo. Nel complesso, identificare le applicazioni critiche e selezionare con cura le tecnologie di Disaster Recovery adeguate tra diversi data center può apportare notevoli vantaggi a qualsiasi organizzazione.
Monitoraggio e adeguamento dell’RTO nel tempo
Una volta calcolato il Recovery Time Objective (RTO) e messe in atto le strategie per raggiungerlo, il lavoro non è ancora finito. Il monitoraggio e l’adeguamento del RTO garantiranno che esso rimanga pertinente ed efficace nel mitigare gli effetti di disastri o guasti imprevisti.
Let’s say that a few months after calculating your RTO and implementing recovery strategies, you experience a major data breach that takes down your critical systems for several hours. This incident could reveal weaknesses in your RTO plan and requirements, leading to necessary adjustments for future readiness. By analyzing the data from the incident, you can determine if the RTO needs to be adjusted based on factors like the severity of the disaster or failure or if new technologies would better facilitate data restoration.
Poiché la tecnologia è in continua evoluzione, lo stesso vale per gli strumenti disponibili per il ripristino dei dati critici. Di conseguenza, i reparti IT devono tenersi aggiornati sulle alternative più recenti o sulle versioni migliorate delle tecnologie esistenti che potrebbero colmare le potenziali lacune nel loro attuale piano RTO. Un ottimo modo per monitorare i progressi in questo settore è partecipare a conferenze tecnologiche o webinar che illustrano le tendenze emergenti e offrono alle organizzazioni l’opportunità di entrare in contatto con esperti del settore.
D’altra parte, alcune organizzazioni potrebbero sostenere che il monitoraggio degli RTO non sia necessario fintantoché i loro calcoli iniziali siano sufficientemente solidi da tenere conto di ogni eventualità. Tuttavia, questa argomentazione trascura la natura mutevole dei sistemi tecnologici, in cui le cose potrebbero cambiare con la stessa rapidità con cui viene effettuato un aggiornamento software durante la notte o con cui emerge uno strumento di hacking negli ambienti criminali.
Monitoring and adjusting your RTO is similar to driving a car. Once you set out on the road, you don’t just settle down and forget about caution altogether because you believe everything went well at the start. A vigilant driver continuously monitors their environment by regularly checking mirrors and avoiding hazards as they appear along their path. Any sudden changes on the road like a blown tire or engine trouble will require quick thinking and new strategies, much like how IT organizations must adapt quickly to emerging security threats or IT failures.
So there you have it, monitoring and adjusting RTO over time is crucial for all organizations’ disaster recovery plans. By being vigilant in paying attention to potential threats and keeping track of technological advancements, you can ensure that your system remains robust and effective in the long run. Remember, recovery does not end after the implementation phase, for an efficient plan should account for any dynamic changes that might occur in an ever-evolving technological landscape.
Che ruolo svolgono la tecnologia e le infrastrutture nel raggiungimento degli RTO desiderati?
La tecnologia e le infrastrutture sono aspetti fondamentali per il raggiungimento degli RTO desiderati. La tecnologia e le infrastrutture adeguate possono aiutare le aziende a riprendersi più rapidamente da eventuali interruzioni dell’attività, riducendo l’impatto negativo sulle loro operazioni, sui clienti e sui profitti.
For instance, implementing a robust backup and recovery system that leverages cloud computing technologies can enable organizations to restore important data or applications in a matter of minutes. Additionally, having a resilient IT infrastructure with redundant systems, automated failover processes, and disaster recovery plans can significantly reduce RTOs.
Secondo un recente studio condotto da Veeam Software, l’84% delle aziende ha dichiarato di aver subito interruzioni di servizio nell’ultimo anno. Tra quelle che hanno subito tali interruzioni, il 33% ha perso l’accesso ai propri sistemi critici per un’ora o più. Inoltre, la ricerca suggerisce che le interruzioni non pianificate possono costare alle aziende fino a 5.600 dollari al minuto.
In conclusione, la tecnologia e le infrastrutture svolgono un ruolo essenziale non solo nel raggiungimento degli RTO desiderati, ma anche nel ridurre al minimo i rischi aziendali associati agli eventi di inattività. Investendo negli strumenti tecnologici e nelle soluzioni infrastrutturali adeguati, le aziende possono migliorare notevolmente la propria resilienza operativa e ridurre al minimo le potenziali perdite finanziarie causate da interruzioni non pianificate.
In che modo l’RTO differisce dall’obiettivo di punto di Recovery (RPO)?
Il Recovery Time Objective (RTO) e il Recovery Point Objective (RPO) sono due parametri fondamentali che le organizzazioni devono tenere in considerazione nella definizione dei propri piani di ripristino di emergenza. Sebbene alcuni possano usare questi termini in modo intercambiabile, non si tratta della stessa cosa.
In sintesi, l’RTO definisce il periodo di tempo durante il quale un’organizzazione può permettersi di rimanere senza un determinato sistema o applicazione prima di iniziare a subire perdite finanziarie significative o altre conseguenze negative. D’altra parte, l’RPO specifica la quantità massima di dati che un’organizzazione può permettersi di perdere a seguito di un’interruzione prima di subire danni significativi.
For example, if a company has an RTO of two hours, it means that it can only tolerate up to two hours of downtime before suffering severe consequences such as losing customers or revenue. On the other hand, if an organization has an RPO of one hour, it implies that it can only afford to lose up to one hour’s worth of data before experiencing significant damage.
Per mettere le cose in prospettiva: secondo uno studio condotto da IBM, ogni minuto di inattività non pianificata costa alle imprese in media circa 8.851 dollari. Inoltre, una ricerca di IDC suggerisce che il costo medio dei tempi di inattività per le applicazioni critiche è di circa 100.000 dollari all’ora.
Pertanto, definire RTO e RPO realistici per la propria organizzazione è fondamentale per ridurre al minimo i tempi di inattività ed evitare perdite finanziarie. Tuttavia, è bene tenere presente che questi indicatori devono anche essere in linea con gli obiettivi e le esigenze aziendali, poiché obiettivi eccessivamente ambiziosi potrebbero risultare difficili da raggiungere e mantenere senza sovraccaricare le risorse disponibili.
Quali fattori determinano un RTO adeguato per un’azienda o un’organizzazione?
Per stabilire un Recovery Time Objective (RTO) adeguato per un’azienda o un’organizzazione è necessario prendere in considerazione diversi fattori. L’RTO dovrebbe essere determinato in base al potenziale impatto dei tempi di inattività del sistema e alla rapidità con cui l’organizzazione deve riprendere le operazioni. Tra i fattori che determinano un RTO adeguato figurano:
- Business Impact Analysis (BIA) – A BIA helps identify critical systems, data, and applications that are essential for business continuity. By prioritizing these aspects, organizations can develop recovery plans with specific RTOs that align with their importance.
- Industry Standards – Certain industries such as healthcare or financial services have stricter regulatory requirements that dictate specific RTOs for protecting sensitive data and ensuring uninterrupted operation.
- Financial Implications – According to a study by the Ponemon Institute, the average cost of data center downtime has risen to $9,000 per minute in 2021. Therefore, an organization’s financial situation plays a significant role in determining an appropriate RTO as it impacts both short-term revenue loss and long-term reputation damage.
- Technology Infrastructure – The RTO should be based on the organization’s technological capabilities, including hardware, software, and network infrastructure. This includes assessing redundancy levels of IT systems and ensuring backup solutions are available to minimize recovery time.
In summary, determining an appropriate RTO requires understanding the potential impact of system downtime on your business operations, analyzing your critical systems and data, and balancing financial implications with technology infrastructure capabilities. By taking a proactive approach towards disaster recovery planning, businesses can minimize downtime while ensuring seamless business continuity during unexpected failures or disruptions.
Quali sono alcuni errori comuni che le aziende commettono quando definiscono gli RTO e come è possibile evitarli?
La definizione di un obiettivo di tempo di ripristino (RTO) è fondamentale affinché le aziende possano pianificare e prepararsi ad affrontare disastri, attacchi informatici e altre potenziali interruzioni dell’attività. Tuttavia, esistono alcuni errori comuni che le aziende commettono nel determinare i propri RTO.
Uno degli errori più gravi è quello di fissare un RTO non realistico. Secondo un sondaggio condotto da IDG, il 28% dei professionisti IT ammette di aver fissato RTO irraggiungibili. Fissare un RTO senza considerare le risorse disponibili o senza testare il piano può portare a tempi di inattività, perdita di ricavi e danni alla reputazione.
Un altro errore comune è quello di non rivedere o aggiornare regolarmente l’RTO. Man mano che le aziende crescono e la tecnologia evolve, cambiano anche i potenziali rischi e le soluzioni necessarie. Il Disaster Recovery Preparedness Council riferisce che il 60% delle organizzazioni non ha aggiornato i propri piani di disaster recovery da oltre un anno, il che porta a piani obsoleti e inefficaci.
To avoid these mistakes, businesses need to conduct risk assessments, test their disaster recovery plans regularly and consult with experts in business continuity planning. It’s essential to establish an achievable RTO based on the needs and capabilities of your organization. A realistic plan will allow you to recover quickly while minimizing costs.
In sintesi, per evitare gli errori più comuni, quali la definizione di RTO non realistici o la mancata aggiornamento periodico degli stessi, è necessario un impegno costante in termini di preparazione, pianificazione e consultazione con gli esperti di disaster recovery all’interno delle organizzazioni.
In che modo le aziende possono ridurre al minimo il proprio RTO in caso di disastro o interruzione dell’attività?
Le aziende possono ridurre al minimo il proprio Recovery Time Objective (RTO) attuando le seguenti strategie:
- Elaborare un piano completo di ripristino di emergenza: un piano ben documentato riduce la confusione e contribuisce a ripristinare rapidamente i sistemi. Secondo uno studio condotto da Gartner, solo il 35% delle piccole e medie imprese dispone di un piano di ripristino di emergenza.
- Investire in infrastrutture resilienti: un’infrastruttura IT solida, dotata di ridondanze multiple, generatori di riserva e fonti di alimentazione alternative, garantisce la continuità operativa anche in caso di interruzione di corrente.
- Eseguite backup regolari: i backup regolari garantiscono che i dati siano sempre aggiornati e disponibili quando necessario. Il 60% delle piccole imprese chiude i battenti entro sei mesi dal verificarsi di una perdita significativa di dati, in assenza di adeguate soluzioni di backup
- Adottare soluzioni basate sul cloud: le soluzioni basate sul cloud offrono flessibilità e scalabilità che mancano alle tradizionali soluzioni on-premise, garantendo tempi di Recovery più rapidi secondo il 95% dei professionisti IT intervistati.
- Adottando queste misure, insieme ad altre su misura per il proprio settore e le proprie esigenze aziendali, le aziende possono garantire tempi di ripristino (RTO) minimi in caso di disastri o interruzioni dell’attività, riducendo al minimo le potenziali perdite sia in termini di fatturato che di reputazione.
Raggiungi o supera i tuoi RTO con Clumio
Disaster recovery planning is essential for enterprises of all sizes looking to ensure business continuity during malicious attacks, downtime, and disruptions to infrastructure. Good data backups and a well-defined recovery process are critical elements of this planning.
Having a viable RTO—and the ability to meet or exceed the RTO—is a vital component to protecting both your business and its customers.
As a cloud-native data protection backup-as-a-service platform, Clumio’s industry-leading rapid recovery capabilities provide enterprises with quick and reliable data restores to help ensure business continuity in the face of downtime to critical infrastructure.
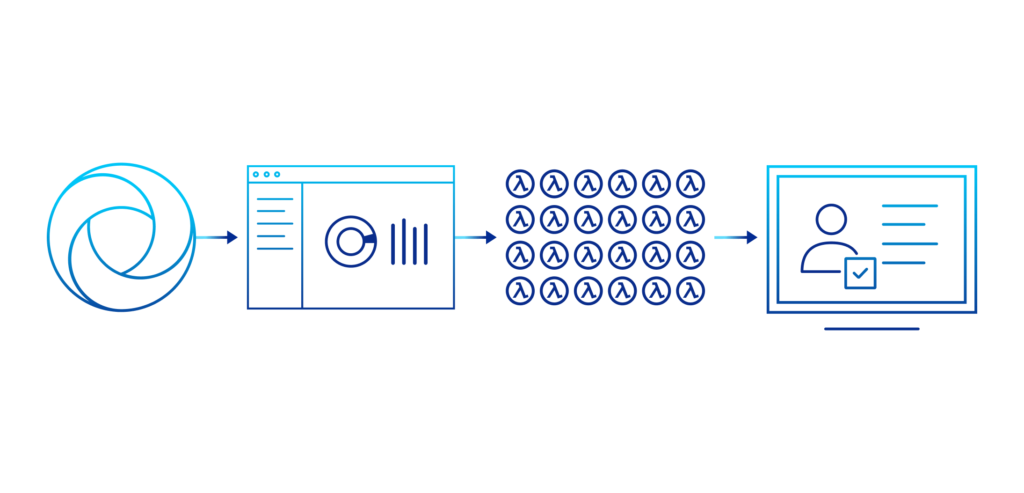
Offrendo una soluzione semplice e intuitiva per il ripristino completo di un’istanza, nonché per il recupero granulare di singoli file, record o caselle di posta, Clumio ottimizza il recupero dei dati per soddisfare o addirittura superare facilmente i vostri RTO attuali.
Argomenti correlati:
Elementi essenziali della protezione dei dati: RTO vs. RPO
Scopri le nozioni fondamentali sulla protezione dei dati: la differenza tra RTO (Recovery Time Objective) e RPO (Recovery Point Objective) per un Backup and Recovery efficace.
Che cos’è l’RPO? L’importanza del Recovery Point Objective nel piano di continuità aziendale
Learn why Recovery Point Objective is vital to an enterprise’s business continuity plan in today’s risk-filled environment where threats like malware and ransomware are now commonplace. Implementing effective data backups and setting recovery objectives will help secure your business’s future.
Esplorare le opzioni di backup Cloud : Un elenco di considerazioni
Examine your available options for cloud backup and learn why a cloud-native solution specifically designed for the cloud is the best choice for everything from ransomware protection to faster data recovery and easier compliance. This is particularly important for businesses and organizations with complex network environments and specific requirements.
Il ruolo del Recovery in un piano di continuità operativa per aziende e organizzazioni
Read about the key role disaster recovery plays in a business continuity plan and learn why your choice of cloud backup can affect the speed of recovery.
In che modo la giusta soluzione di backup su cloud consente un Recovery di emergenza più rapido in diversi ambienti di rete
When a disaster event (such as a ransomware attack) strikes, disaster recovery planning is paramount for businesses and organizations operating in various network environments. Learn about the key capabilities a cloud backup solution should provide to enable faster disaster recovery.
Che cos’è una politica di conservazione dei dati?
Scopri le nozioni di base sulla politica di conservazione dei dati e scopri come un backup su cloud adeguato possa semplificare la tua conformità, garantendo al contempo la sicurezza dei dati di backup e rispondendo alle esigenze specifiche delle aziende e delle organizzazioni operanti in diversi settori.